

Bună ziua! Mă numesc Danil Lipovoy, echipa noastră de la Sbertech a început să folosească HBase ca stocare pentru datele operaționale. În timpul studierii sale, am acumulat experiență pe care am dorit să o sistematizăm și să o descriem (sperăm că va fi utilă multora). Toate experimentele de mai jos au fost efectuate cu versiunile HBase 1.2.0-cdh5.14.2 și 2.0.0-cdh6.0.0-beta1.
- Arhitectura generală
- Scrierea datelor în HBASE
- Citirea datelor din HBASE
- Cache-ul de date
- Procesarea în lot a datelor MultiGet/MultiPut
- Strategia de fragmentare a tabelelor în regiuni (splitting)
- Toleranța la erori, compactarea și localitatea datelor
- Configurări și performanță
- Testare de încărcare
- Conclusions
1. Arhitectura generală
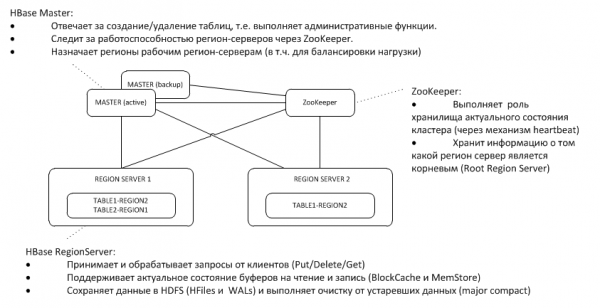
Masterul de rezervă ascultă heartbeat-ul masterului activ pe nodul ZooKeeper și, în cazul dispariției acestuia, preia funcțiile masterului.
2. Scrierea datelor în HBASE
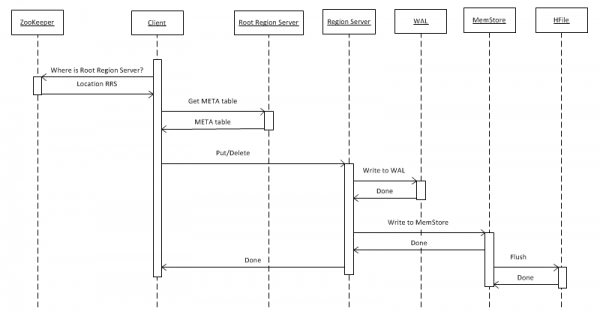
Mai întâi, să luăm în considerare cel mai simplu caz – scrierea unui obiect cheie-valoare într-o anumită tabelă folosind put(rowkey). Clientul trebuie să afle mai întâi unde se află serverul de regiune rădăcină (Root Region Server — RRS), care stochează tabela hbase:meta. Informația aceasta o obține de la ZooKeeper. Apoi se adresează RRS-ului și citește tabela hbase:meta, din care extrage informația despre care RegionServer (RS) este responsabil pentru stocarea datelor pentru cheia rowkey dată în tabela care îl interesează. În scopul utilizării ulterioare, tabela meta este cached de către client și, prin urmare, apelurile următoare se desfășoară mai rapid, direct către RS.
Apoi, RS-ul, primind cererea, mai întâi o scrie în WriteAheadLog (WAL), ceea ce este necesar pentru recuperare în caz de cădere. Apoi, datele sunt salvate în MemStore. Acesta este un buffer în memorie care conține un set ordonat de chei ale acestei regiuni. Tabela poate fi divizată în regiuni (partiții), fiecare având un set de chei neîncrucișat. Acest lucru permite ca, plasând regiunile pe servere diferite, să se obțină o performanță mai bună. Cu toate acestea, în ciuda evidenței acestei afirmații, vom vedea mai departe că nu funcționează în toate cazurile.
După ce înregistrarea a fost plasată în MemStore, clientului i se returnează un răspuns că înregistrarea a fost salvată cu succes. Aceasta este, de fapt, stocată doar în buffer și va ajunge pe disc doar după ce va trece un anumit interval de timp sau când va fi umplut cu date noi.
At the execution of the 'Delete' operation, physical data deletion does not occur. They are simply marked as deleted, while the actual destruction takes place at the moment the major compact function is called, which is described in detail in section 7.
Files in HFile format accumulate in HDFS, and from time to time, a minor compact process is triggered, which merely merges small files into larger ones without deleting anything. Over time, this turns into a problem that only manifests during data reading (we will return to this shortly).
In addition to the loading process mentioned above, there is a much more efficient procedure, which arguably represents the strongest aspect of this database – BulkLoad. This involves manually creating HFiles and placing them on the disk, which allows for excellent scalability and achieving quite impressive speeds. Essentially, the limitation here is not HBase, but the hardware capabilities. Below are the loading results on a cluster consisting of 16 RegionServers and 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads), HBase version 1.2.0-cdh5.14.2.
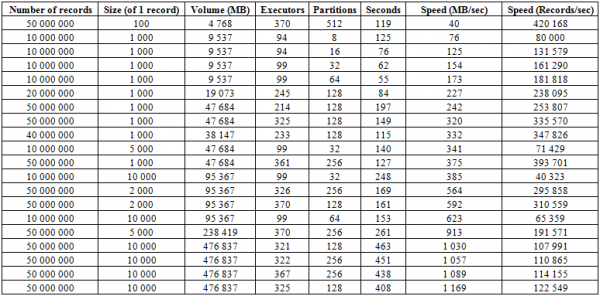
Here, it is evident that increasing the number of partitions (regions) in the table, as well as Spark executors, results in an increase in loading speed. Speed also depends on the volume of the write operation. Large blocks yield increases measured in MB/sec, while small ones increase the number of inserted records per unit of time, with other factors being equal.
It is also possible to initiate loading into two tables simultaneously, which can double the speed. Below it is shown that writing 10 KB blocks simultaneously into two tables occurs at a speed of around 600 MB/sec each (totaling 1275 MB/sec), which corresponds to the writing speed into one table of 623 MB/sec (see No. 11 above).
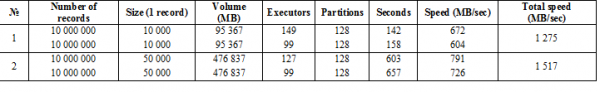
However, the second run with 50 KB records shows that the loading speed increases only slightly, indicating that we are approaching the limits. It should be noted that there is practically no load on HBASE itself; all that is required from it is to first deliver data from hbase:meta, and after placing HFiles, flush the BlockCache data and save the MemStore buffer to disk, if it is not empty.
3. Reading data from HBASE
Dacă presupunem că toată informația din hbase:meta este deja disponibilă clientului (vezi p. 2), atunci cererea se trimite direct către RS-ul unde este stocat cheia dorită. Mai întâi, căutarea se desfășoară în MemCache. Indiferent dacă datele sunt disponibile sau nu, căutarea se efectuează și în bufferul BlockCache și, dacă este necesar, în HFiles. Dacă datele sunt găsite în fișier, ele sunt plasate în BlockCache și la următoarea cerere vor fi returnate mai repede. Căutarea în HFile se desfășoară relativ rapid datorită utilizării filtrului Bloom, adică, citind un volum mic de date, se determină imediat dacă acest fișier conține cheia dorită și, dacă nu, se trece la următorul.
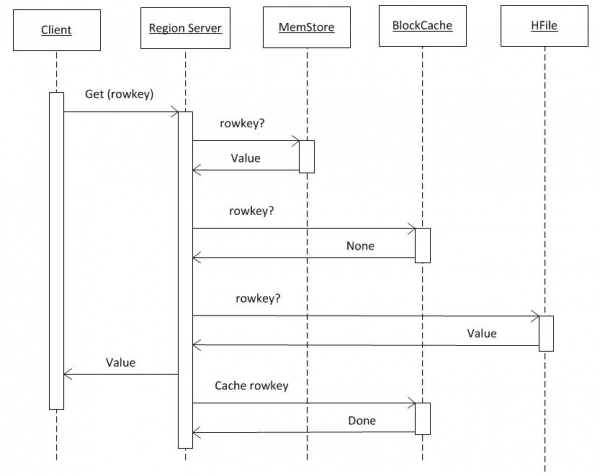
După obținerea datelor din aceste trei surse, RS-ul formează un răspuns. În special, poate transmite mai multe versiuni găsite ale obiectului, dacă clientul a solicitat versionare.
4. Cache-ul de date
Buffer-ele MemStore și BlockCache ocupă până la 80% din memoria on-heap alocată pentru RS (restul este rezervat pentru sarcini de servicii ale RS-ului). Dacă modul tipic de utilizare este că procesele scriu și citesc imediat aceste date, are sens să se reducă BlockCache și să se crească MemStore, având în vedere că, la scriere, datele nu ajung în cache-ul de citire, astfel utilizarea BlockCache-ului va fi mai rară. Buffer-ul BlockCache este compus din două părți: LruBlockCache (întotdeauna on-heap) și BucketCache (de obicei off-heap sau pe SSD). Este recomandat să utilizați BucketCache atunci când există foarte multe cereri de citire și acestea nu se încadrează în LruBlockCache, ceea ce duce la o activitate intensă a Garbage Collector-ului. Totuși, nu ar trebui să așteptați o creștere radicală a performanței din utilizarea cache-ului de citire, dar la acest subiect ne vom întoarce în p. 8.
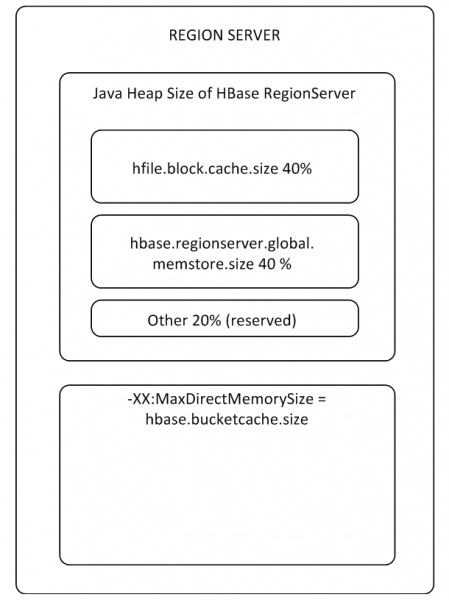
BlockCache-ul este comun pentru întreg RS-ul, iar MemStore-ul este specific fiecărei tabele (câte unul pentru fiecare Column Family).
Cum Teoretic, la scriere, datele nu ajung în cache și într-adevăr, parametrii CACHE_DATA_ON_WRITE pentru tabelă și „Cache DATA on Write” pentru RS sunt setați pe false. Cu toate acestea, în practică, dacă scrieți date în MemStore, apoi le salvați pe disc (astfel curățându-l), apoi ștergeți fișierul rezultat, atunci, efectuând o cerere get, vom obține cu succes datele. Chiar și dacă dezactivați complet BlockCache și umpleți tabelul cu date noi, apoi reușiți să salvați MemStore-ul pe disc, să le ștergeți și să solicitați dintr-o altă sesiune, acestea vor fi extrase totuși din undeva. Așadar, HBase stochează nu doar date, ci și mistere fascinante.
hbase(main):001:0> create 'ns:magic', 'cf'
Created table ns:magic
Took 1.1533 seconds
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Took 0.2610 seconds
hbase(main):003:0> flush 'ns:magic'
Took 0.6161 seconds
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Parametrul „Cache DATA on Read” este setat pe false. Dacă aveți sugestii, vă rugăm să le discutați în comentarii.
5. Procesarea în loturi a datelor MultiGet/MultiPut
Procesarea cererilor individuale (Get/Put/Delete) este o operațiune destul de costisitoare, așa că ar trebui să le combinăm, dacă este posibil, într-o List sau List, ceea ce permite obținerea unui câștig semnificativ de performanță. Acest lucru este deosebit de important în cazul operațiunilor de scriere, iar în ceea ce privește citirea, există un alt obstacol. În graficul de mai jos este prezentat timpul necesar pentru citirea a 50.000 de înregistrări din MemStore. Citirea a fost efectuată pe un singur fir, iar pe axa orizontală este arătat numărul de chei în cerere. Se poate observa că, atunci când numărul de chei într-o cerere ajunge la o mie, timpul de execuție scade, adică viteza crește. Cu toate acestea, în modul MSLAB activat implicit, după acest prag, performanța începe să scadă dramatic, iar cu cât volumul de date din înregistrare este mai mare, cu atât timpul de execuție este mai mare.
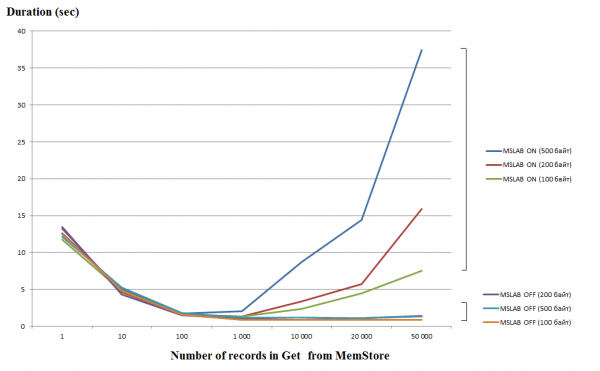
Teste au fost efectuate pe o mașină virtuală, cu 8 nuclee, versiunea HBase 2.0.0-cdh6.0.0-beta1.
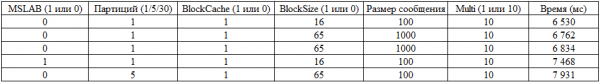
Modul MSLAB este destinat reducerii fragmentării heap-ului, care apare din amestecarea datelor din generații noi și vechi. Ca soluție, atunci când MSLAB este activat, datele sunt plasate în celule relativ mici (chunk) și sunt procesate pe porțiuni. Drept rezultat, atunci când volumul datelor solicitate depășește dimensiunea alocată, performanța scade brusc. Pe de altă parte, dezactivarea acestui mod nu este de asemenea de dorit, deoarece va duce la opriri din cauza GC în momentele de muncă intensă cu datele. O soluție bună este creșterea dimensiunilor celulei, în cazul unei scrieri active prin put simultan cu citirea. Este de menționat că problema nu apare dacă după scriere se execută comanda flush, care descarcă MemStore pe disc sau dacă se efectuează încărcarea prin BulkLoad. În tabelul de mai jos se arată că cererile din MemStore pentru date de volum mai mare (și același număr) duc la încetinire. Cu toate acestea, crescând chunksize, timpul de procesare revine la normal.
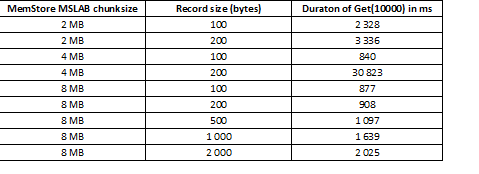
Pe lângă creșterea chunksize, ajută și divizarea datelor pe regiuni, adică splitarea tabelelor. Acest lucru face ca pentru fiecare regiune să vină un număr mai mic de cereri și, dacă acestea sunt plasate în celule, răspunsul rămâne bun.
6. Strategia de divizare a tabelelor pe regiuni (splitare)
Deoarece HBase este o stocare de tip key-value și partizionarea se face pe cheie, este extrem de important să se împartă datele uniform pe toate regiunile. De exemplu, partionarea unei astfel de tabele în trei părți va duce la faptul că datele vor fi împărțite în trei regiuni:
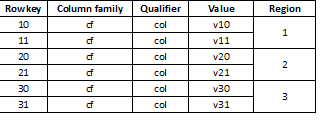
Uneori, aceasta duce la o încetinire bruscă, dacă datele ulterior încărcate vor avea, de exemplu, valori de tip long care în mare parte încep cu aceeași cifră, de exemplu:
1000001
1000002
…
1100003
Deoarece cheile sunt stocate sub forma unui array de bytes, toate acestea vor începe la fel și vor aparține aceleași regiuni #1 care stochează acest interval de chei. Există mai multe strategii de divizare:
HexStringSplit – Transformă cheia într-un șir cu codificare hexadecimală în intervalul „00000000” => „FFFFFFFF” și completând cu zerouri la stânga.
UniformSplit – Transformă cheia într-un array de bytes cu codificare hexadecimală în intervalul „00” => „FF” și completând cu zerouri la dreapta.
În plus, se poate specifica orice interval sau set de chei pentru divizare și se poate activa autosplitarea. Totuși, una dintre cele mai simple și eficiente abordări este UniformSplit și utilizarea concatenării hash-ului, de exemplu, prima pereche de bytes din rularea cheii prin funcția CRC32(rowkey) și cheia rowkey propriu-zisă:
hash + rowkey
Atunci toate datele vor fi distribuite uniform pe regiuni. La citire, primii doi bytes sunt pur și simplu eliminați și rămâne cheia originală. De asemenea, RS controlează cantitatea de date și chei din regiune și, în cazul depășirii limitelor, le împărțeste automat în părți.
7. Toleranța la erori și localizarea datelor
Dat fiecare set de chei este responsabil pentru o singură regiune, soluția problemelor legate de prăbușirile RS sau de externalizarea acestora este stocarea tuturor datelor necesare în HDFS. Atunci când RS cedează, masterul detectează acest lucru prin absența heartbeat-ului pe nodul ZooKeeper. Acesta numește o regiune alternativă unui alt RS și, deoarece HFiles sunt stocate în sistemul de fișiere distribuit, noul proprietar le citește și continuă să servească datele. Totuși, deoarece o parte din date poate fi în MemStore și nu a ajuns să fie transferată în HFiles, pentru a restaura istoricul operațiunilor se utilizează WAL, care sunt de asemenea stocate în HDFS. După aplicarea modificărilor, RS-ul este capabil să răspundă la cereri, însă migrarea duce la faptul că o parte din date și procesele care le servesc se află pe noduri diferite, adică localitatea scade.
Soluția problemei este major compaction – această procedură mută fișierele pe nodurile care le gestionează (acolo unde sunt situate regiunile lor), rezultând într-o încărcare bruscă a rețelei și discurilor în timpul acestei proceduri. Cu toate acestea, accesul la date devine semnificativ mai rapid ulterior. În plus, major_compaction realizează combinarea tuturor HFiles într-un singur fișier în cadrul regiunii, precum și curățarea datelor în funcție de setările tabelului. De exemplu, se poate seta numărul de versiuni ale unui obiect care trebuie păstrat sau timpul său de viață, după expirarea căruia obiectul este șters fizic.
Această procedură poate avea un impact foarte pozitiv asupra funcționării HBase. În imaginea de mai jos se poate observa cum a degenerat performanța ca urmare a scrierii active de date. Aici se poate observa cum 40 de fire scriu într-un singur tabel și 40 de fire citesc simultan datele. Firele care scriu formează din ce în ce mai multe HFiles, care sunt citite de celelalte fire. Ca rezultat, din ce în ce mai multe date trebuie șterse din memorie și, la un moment dat, începe să funcționeze GC-ul, care practic paralizează toată activitatea. Lansarea major compaction a dus la curățarea acumulărilor create și la restabilirea performanței.
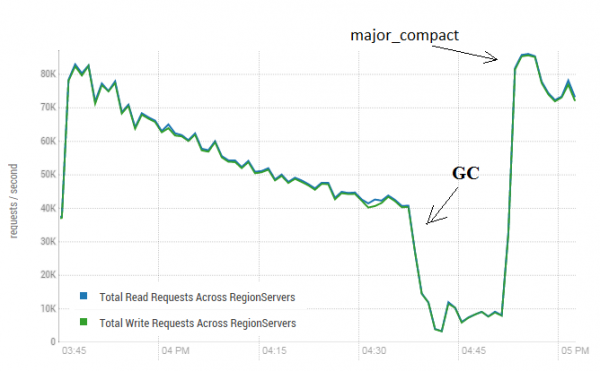
Testul a fost efectuat pe 3 DataNode și 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 fire). Versiunea HBase este 1.2.0-cdh5.14.2
Este important de menționat că lansarea major compaction a fost efectuată pe o tabelă „vie”, în care se scriau și se citeau activ date. În rețea s-a întâlnit afirmația că acest lucru poate duce la un răspuns incorect atunci când se citesc date. Pentru verificare, a fost lansat un proces care genera date noi și le scria în tabelă. După aceea, datele erau citite imediat și se verifica dacă valoarea obținută corespundea cu ceea ce fusese scris. În timpul desfășurării acestui proces, major compaction a fost lansat de aproximativ 200 de ori și nu a fost înregistrată nicio eroare. Este posibil ca problema să se manifeste rar și doar în timpul unei sarcini mari, așa că mai sigur ar fi totuși să se oprească planificat procesele de scriere și citire și să se efectueze curățarea, evitând astfel scăderile GC.
De asemenea, major compaction nu influențează starea MemStore, pentru a-l scrie pe disc și a compacta, trebuie utilizat flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Setări și performanță
După cum s-a spus, HBase își arată cel mai mare succes acolo unde nu trebuie să facă nimic, în timpul executării BulkLoad. Totuși, acest lucru se aplică majorității sistemelor și oamenilor. Cu toate acestea, acest instrument este mai potrivit pentru încărcarea masivă a datelor în blocuri mari, în timp ce, dacă procesul necesită executarea unui număr mare de cereri concurente de citire și scriere, se folosesc comenzile Get și Put descrise mai sus. Pentru a determina parametrii optimi, au fost efectuate lansări cu diferite combinații de parametri de tabele și setări:
- Au fost lansate 10 fire simultan de 3 ori la rând (să numim aceasta un bloc de fire).
- Timpul de funcționare al tuturor firelor în bloc a fost mediat și a constituit rezultatul final al blocului.
- Toate firele lucrau cu aceeași tabelă.
- Înainte de fiecare lansare a blocului de fire, se efectua o compacție majoră.
- Fiecare bloc efectua doar una dintre următoarele operațiuni:
— Put
— Get
— Get+Put
- Fiecare bloc efectua 50.000 de repetări ale operațiunii sale.
- Dimensiunea înregistrării în bloc era de 100 byte, 1000 byte sau 10000 byte (random).
- Blocurile erau lansate cu un număr diferit de chei solicitate (sau o cheie sau 10).
- Blocurile erau lansate cu diferite setări ale tabelului. Parametrii modificati erau:
— BlockCache = activat sau dezactivat
— BlockSize = 65 KB sau 16 KB
— Partitii = 1, 5 sau 30
— MSLAB = activat sau dezactivat
Astfel, blocul arată astfel:
a. Modurile MSLAB erau activate/dezactivate.
b. A fost creat un tabel, pentru care au fost stabilite următoarele parametrii: BlockCache = true/none, BlockSize = 65/16 Kb, Partitions = 1/5/30.
c. A fost setat compresia GZ.
d. Au fost lansate 10 fire de execuție care efectuează simultan 1/10 operațiuni put/get/get+put pe acest tabel cu înregistrări de 100/1000/10000 de bytes, executând 50.000 de cereri consecutiv (cheile sunt aleatoare).
e. Punctul d a fost repetat de trei ori.
f. Timpul de execuție al tuturor firelor a fost mediat.
Au fost verificate toate combinațiile posibile. Este previzibil că, pe măsură ce dimensiunea înregistrării crește, viteza va scădea sau că dezactivarea cache-ului va duce la o încetinire. Cu toate acestea, scopul a fost să înțelegem gradul și semnificația influenței fiecărui parametru, astfel încât datele colectate au fost introduse în funcția de regresie liniară, care permite evaluarea fiabilității prin intermediul statisticii t. Mai jos sunt prezentate rezultatele blocurilor care efectuează operațiuni Put. Numărul total de combinații 2*2*3*2*3 = 144 variante + 72 deoarece unele au fost executate de două ori. Așadar, în total 216 execuții:
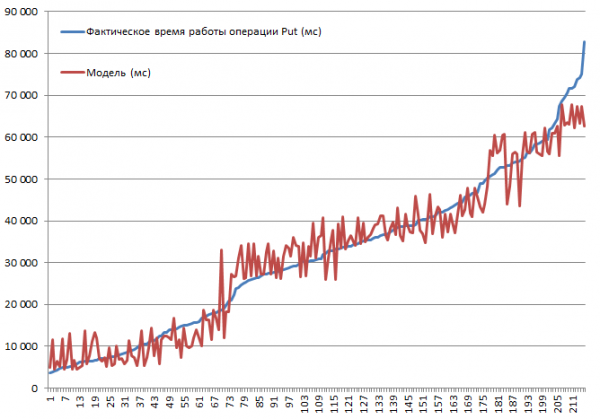
Testarea a fost realizată pe un mini-cluster format din 3 DataNode și 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 thread-uri). Versiunea HBase 1.2.0-cdh5.14.2.
Cea mai mare viteză de inserare de 3.7 secunde a fost obținută în modul MSLAB dezactivat, pe un tabel cu o singură partiție, cu BlockCache activat, BlockSize = 16, înregistrări de 100 bytes, 10 bucăți per pachet.
Cea mai mică viteză de inserare de 82.8 secunde a fost obținută în modul MSLAB activat, pe un tabel cu o singură partiție, cu BlockCache activat, BlockSize = 16, înregistrări de 10000 bytes, 1 bucată per rând.
Acum să ne uităm la model. Observăm o calitate bună a modelului conform R2, dar este foarte clar că extrapolarea este contraindicată aici. Comportamentul real al sistemului în funcție de parametrii va fi non-liniar, acest model este necesar nu pentru prognoze, ci pentru a înțelege ce s-a întâmplat în cadrul parametru-lor specificate. De exemplu, aici vedem că, conform criteriului Student, pentru operația Put, parametrii BlockSize și BlockCache nu au importanță (ceea ce este, în general, destul de previzibil):
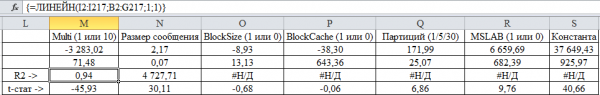
Ceea ce este surprinzător este că creșterea numărului de partiții duce la scăderea performanței (deja am observat un impact pozitiv al creșterii numărului de partiții în cazul BulkLoad), deși este explicabil. În primul rând, pentru procesare este necesar să se formeze cereri către 30 de regiuni în loc de una, iar volumul de date nu este suficient pentru a aduce un avantaj. În al doilea rând, timpul total de execuție este determinat de cel mai lent RS, iar cum numărul de DataNode este mai mic decât numărul de RS, o parte din regiuni au localitate zero. Și acum să privim top cinci lideri:
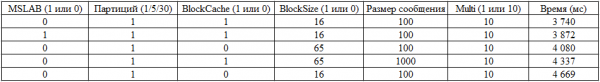
Acum să evaluăm rezultatele execuției blocurilor Get:
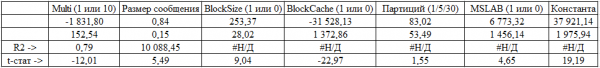
Numărul de partiții și-a pierdut semnificația, ceea ce probabil se explică prin faptul că datele sunt bine cached, iar cache-ul pentru citiri este parametru cel mai semnificativ (din punct de vedere statistic). Evident, creșterea numărului de mesaje în cerere este, de asemenea, foarte benefică pentru performanță. Cele mai bune rezultate:
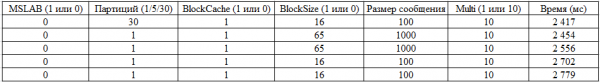
Și în sfârșit, să ne uităm la modelul blocului care a executat mai întâi get, apoi put:
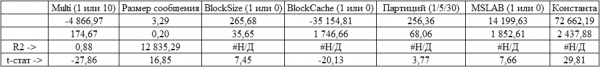
Aici toate parametrii sunt semnificativi. Iată rezultatele liderilor:
9. Testare de stres
Și în sfârșit, să lansăm o încărcare mai mult sau mai puțin decentă, dar este întotdeauna mai interesant când avem cu ce compara. Pe site-ul DataStax – dezvoltatorul principal al Cassandra este NT-ul mai multor stocări NoSQL, inclusiv HBase versiunea 0.98.6-1. Încărcarea a fost realizată cu 40 de fire, dimensiunea datelor de 100 de biți, discurile SSD. Rezultatul testării operațiunilor Read-Modify-Write a arătat următoarele rezultate.
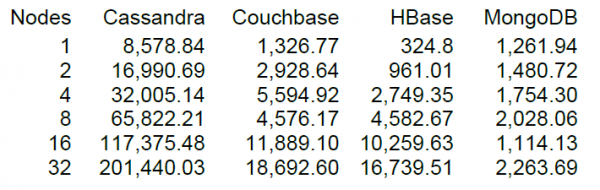
Din câte am înțeles, citirea a fost realizată în blocuri de 100 de înregistrări și pentru 16 noduri HBase, testul DataStax a arătat o performanță de 10.000 de operațiuni pe secundă.
Este bine că avem și noi 16 noduri în cluster, dar nu este foarte "bine" că fiecare are 64 de nuclee (fire), în timp ce în testul DataStax aveau doar 4. Pe de altă parte, ei au SSD-uri, iar noi HDD-uri și o versiune mai nouă de HBase, iar utilizarea CPU-ului în timpul sarcinilor de lucru nu a crescut semnificativ (vizual cu 5-10 procente). Cu toate acestea, vom încerca să pornim pe această configurație. Setările tabelului sunt implicite, iar citirea se face în intervalul cheilor de la 0 la 50 de milioane, la întâmplare (adică, în esență, de fiecare dată nou). În tabel sunt 50 de milioane de înregistrări, împărțite în 64 de partiții. Cheile sunt hash-uite pe crc32. Setările tabelului sunt implicite, MSLAB este activat. Vom lansa 40 de fire, fiecare citind un set de 100 de chei aleatorii și imediat scriind 100 de octeți generați înapoi pe aceste chei.
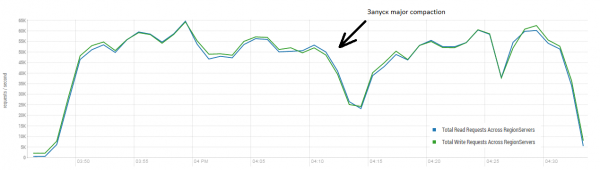
Stand: 16 DataNode și 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 fire). Versiunea HBase 1.2.0-cdh5.14.2.
Rezultatul mediu se apropie de 40 de mii de operațiuni pe secundă, ceea ce este semnificativ mai bine decât în testul DataStax. Cu toate acestea, în scopuri experimentale, putem modifica puțin condițiile. Este destul de puțin probabil ca toată munca să fie efectuată exclusiv cu o singură tabelă și doar cu chei unice. Să presupunem că există un set de chei „fierbinți” care generează majoritatea încărcăturii. Prin urmare, vom încerca să creăm o încărcătură cu înregistrări mai mari (10 KB), de asemenea, în pachete de 100, în 4 tabele diferite și limitând intervalul cheilor solicitate la 50 de mii. În graficul de mai jos, este arătată lansarea a 40 de fire, fiecare citind un set de 100 de chei și imediat scriind 10 KB aleatorii înapoi pe aceste chei.
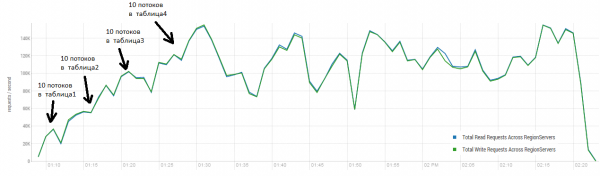
Stand: 16 DataNode și 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 fire). Versiunea HBase 1.2.0-cdh5.14.2.
În timpul încărcării, a fost inițiat de mai multe ori compacția majoră, așa cum s-a arătat mai sus, fără această procedură performanța va degrada treptat, totuși, în timpul execuției apare și o încărcătură suplimentară. Scăderile sunt cauzate de diferite motive. Uneori firele încetau să funcționeze și, în timp ce erau repornite, apărea o pauză, iar alteori aplicațiile externe creau o încărcătură pe cluster.
Citirea și scrierea imediată sunt unul dintre cele mai dificile scenarii de utilizare pentru HBase. Dacă se efectuează doar cereri de tip put de dimensiuni mici, de exemplu, de 100 de octeți, grupându-le în pachete de 10.000-50.000, pot fi obținute sute de mii de operațiuni pe secundă, iar situația este similară cu cererile doar de citire. Merită menționat că rezultatele sunt radical mai bune decât cele obținute de DataStax, în mare parte datorită cererilor în bloc de 50.000.
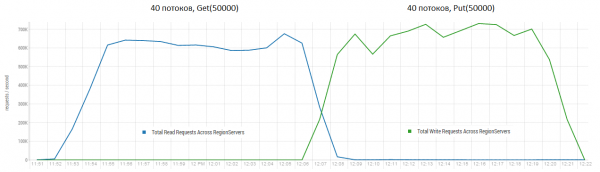
Stand: 16 DataNode și 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 fire). Versiunea HBase 1.2.0-cdh5.14.2.
10. Concluzii
Acest sistem este destul de flexibil în configurare, însă influența unui număr mare de parametri rămâne în continuare necunoscută. O parte dintre aceștia au fost testați, dar nu au fost inclusi în setul de teste rezultat. De exemplu, experimentele preliminare au arătat o semnificație nesemnificativă a parametrului DATA_BLOCK_ENCODING, care codifică informația folosind valori din celulele adiacente, ceea ce este destul de explicabil pentru datele generate aleatoriu. În cazul utilizării unui număr mare de obiecte repetitive, câștigul poate fi semnificativ. În general, se poate spune că HBase dă impresia unei baze de date destul de serioase și bine gândite, care poate fi suficient de performantă în operațiuni cu blocuri mari de date. Mai ales dacă există posibilitatea de a defalca în timp procesele de citire și scriere.
Dacă considerați că ceva nu este suficient dezvăluit, sunt gata să discut mai în detaliu. Vă propun să ne împărtășim experiențele sau să discutăm dacă nu sunteți de acord cu ceva.
Sursa: habr.com
