

Canarul este o pasăre mică care cântă constant. Aceste păsări sunt sensibile la metan și monoxid de carbon. Chiar și la o concentrație mică de gaze în aer, ele își pierd cunoștința sau mor. Căutătorii de aur și minerii foloseau canari în exploatări: cât timp cântă canarii, se poate lucra, dacă se opresc – există gaz în mină și e timpul să pleci. Minerii sacrificau acest mic canar pentru a se întoarce acasă în siguranță.
Această practică a fost adoptată și în IT. De exemplu, în sarcina standard de a desfășura o nouă versiune a unui serviciu sau aplicație în producție, precedată de teste. Mediu de testare poate fi prea costisitor, testele automatizate nu acoperă tot ceea ce ne-am dori, iar aglomerarea fără teste și sacrificarea calității este riscantă. În astfel de situații ajută abordarea Canary Deployment, când un mic trafic de producție este direcționat către noua versiune. Această abordare ajută să verifici în siguranță noua versiune în producție, sacrificând puțin pentru un scop mai mare. Mai multe despre cum funcționează această abordare, de ce este utilă și cum poate fi implementată, va explica Andrei Markelov (), prin exemplul implementării în compania Infobip.
Andrei Markelov — inginer programator senior în Infobip, care lucrează de 11 ani la dezvoltarea aplicațiilor pe Java în domeniul financiar și telecomunicațiilor. De asemenea, dezvoltă produse Open Source, participă activ în comunitatea Atlassian și scrie pluginuri pentru produsele Atlassian. Este evangelist pentru Prometheus, Docker și Redis.
Despre compania Infobip
Este o platformă globală de telecomunicații care permite băncilor, retailului, magazinelor online și companiilor de transport să trimită mesaje clienților lor prin SMS, notificări push, e-mailuri și mesaje vocale. În acest domeniu de afaceri, stabilitatea și fiabilitatea sunt esențiale pentru ca clienții să primească mesajele la timp.
Infrastructura IT a Infobip în cifre:
- 15 centre de date în întreaga lume;
- 500 de servicii unice în funcțiune;
- 2500 de instanțe de servicii, ceea ce este mult mai mult decât echipele;
- 4,5 Tbyte de trafic lunar;
- 4,5 miliarde de numere de telefon;
Afacerea crește, iar odată cu ea și numărul de lansări. Facem 60 de lansări pe zi, pentru că clienții doresc mai multe funcționalități și capacități. Dar este dificil – avem multe servicii și puține echipe. Trebuie să scriem rapid cod care să funcționeze în producție fără erori.
Lansări
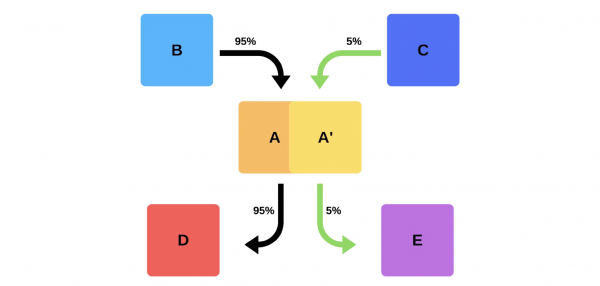
O lansare tipică la noi decurge astfel. De exemplu, există servicii A, B, C, D și E, fiecare fiind dezvoltat de o echipă diferită.
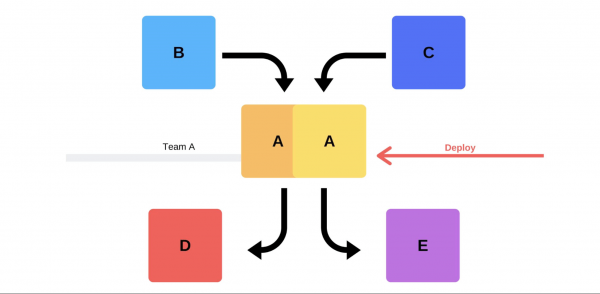
La un moment dat, echipa serviciului A decide să lanseze o nouă versiune, dar echipele serviciilor B, C, D și E nu știu despre aceasta. Există două opțiuni pentru echipa serviciului A.
Va efectua o lansare incrementală: mai întâi va înlocui o versiune, apoi pe cealaltă.
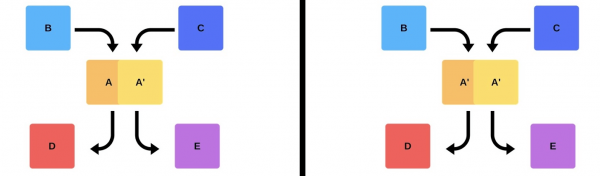
Dar există o a doua opțiune: echipa va găsi capacități și mașini suplimentare, va lansa noua versiune, apoi va schimba routerul, iar versiunea va începe să funcționeze în producție.
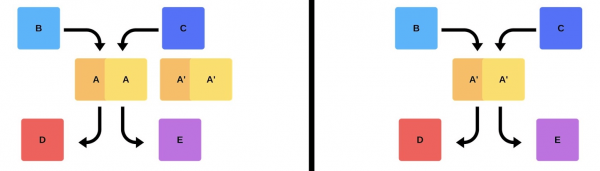
În orice variantă, după lansare apar aproape întotdeauna probleme, chiar dacă versiunea a fost testată. Se poate testa manual, se poate automatiza, se poate să nu fie testat — problemele vor apărea în orice caz. Cel mai simplu și corect mod de a le rezolva este să revenim la o versiune funcțională. Abia apoi putem analiza pagubele, cauzele și să le remediem.
Deci, ce vrem?
Nu avem nevoie de probleme. Dacă clienții le descoperă mai repede decât noi, aceasta va afecta reputația. Prin urmare, trebuie să identificăm problemele mai repede decât clienții.. Lucrând anticipat, minimizăm paguba.
Între timp, vrem să accelerăm lansarea, astfel încât să se desfășoare rapid, ușor, de la sine și fără stres din partea echipei. Inginerii, inginerii DevOps și programatorii trebuie protejați — lansarea unei noi versiuni este stresantă. Echipa nu este un consumabil, ne străduim să folosim rațional resursele umane..
Problemele de lansare
Traficul clientului este imprevizibil.. Nu putem prezice când va fi minim trafic pentru clienți. Nu știm unde și când clienții își vor începe campaniile — poate, în noaptea asta în India, iar mâine în Hong Kong. Având în vedere diferența mare de fus orar, lansarea chiar și la ora 2 dimineața nu garantează că clienții nu vor fi afectați.
Problemele furnizorilor. Mesageri și furnizori — sunt partenerii noștri. Uneori aceștia au întreruperi care cauzează erori în timpul lansării noilor versiuni.
Echipe distribuite.. Echipele care dezvoltă partea client și backend sunt în fusuri orare diferite. Din această cauză, adesea nu pot ajunge la un acord între ele.
Centrele de date nu pot fi reproduce pe stagiul. Într-un centru de date sunt 200 de rack-uri — a reproduce aceasta în sandbox nici măcar nu este posibil aproximativ.
Timpurile de inactivitatenu sunt acceptabile! Avem un nivel acceptabil de disponibilitate (Error Budget), când lucrăm 99,99% din timp, iar procentul rămas reprezintă „dreptul la eroare”. Este imposibil să atingem 100% fiabilitate, dar este esențial să monitorizăm constant căderile și timpii de nefuncționare.
Opțiuni clasice de soluționare
Scrierea codului fără erori. Când eram un dezvoltator tânăr, managerii veneau la mine cerându-mi să fac o lansare fără erori, dar acest lucru nu este întotdeauna posibil.
Scrierea testelor. Testele funcționează, dar uneori nu în modul dorit de afacere. A face bani nu este sarcina testelor.
Testarea în mediu de staging. În cei 3,5 ani de muncă la Infobip, nu am văzut niciodată ca starea de staging să coincidă parțial cu producția.
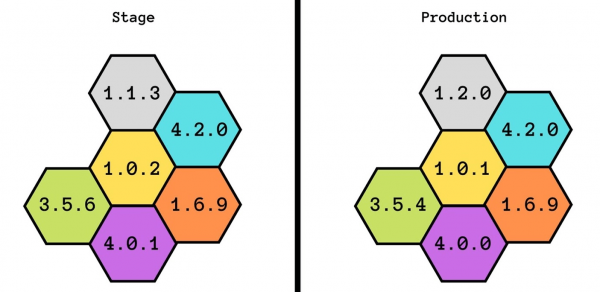
Chiar am încercat să dezvoltăm această idee: mai întâi am avut un staging, apoi preproducție, iar apoi preproducția preproducției. Dar nici asta nu a ajutat - acestea nu coincideau nici măcar în putere. La staging, putem garanta funcționalitatea de bază, dar nu știm cum va funcționa sub sarcini.
Lansarea o face cel care a dezvoltat. Aceasta este o practică bună: chiar dacă cineva schimbă numele unui comentariu, îl adaugă imediat în producție. Aceasta ajută la dezvoltarea responsabilității și la a nu uita modificările făcute.
Există și dificultăți suplimentare. Pentru un dezvoltator, este stresant să investească mult timp pentru a verifica totul manual.
Lansări coordonate. Această opțiune este de obicei propusă de management: „Hai să ne înțelegem că în fiecare zi veți testa și adăuga versiuni noi”. Aceasta nu funcționează: întotdeauna există o echipă care așteaptă pe ceilalți sau, dimpotrivă.
Teste Smoke
O altă modalitate de a rezolva problemele noastre de implementare. Să examinăm cum funcționează testele smoke în exemplul anterior, când echipa A dorește să implementeze o nouă versiune.
Mai întâi, echipa implementează un instanț în producție. Mesajele către instanța de la mock-uri simulează traficul real, astfel încât să fie similar cu traficul zilnic normal. Dacă totul este bine, echipa comută noua versiune pe traficul utilizatorului.
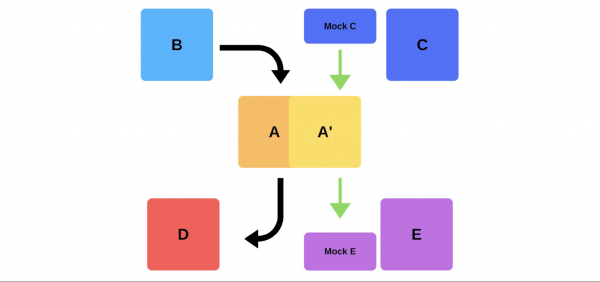
A doua opțiune este să implementați cu hardware suplimentar. Echipa îl testează în producție, apoi comută, și totul funcționează.
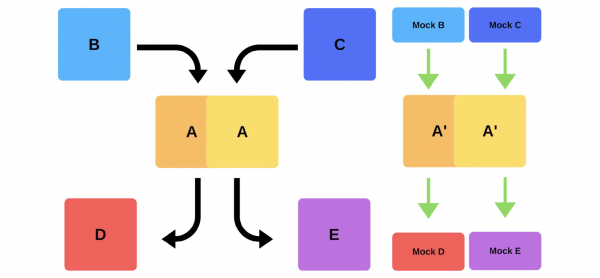
Dezavantajele testelor smoke:
- Testele nu sunt de încredere. De unde să obținem același trafic ca în producție? Putem folosi traficul de ieri sau de săptămâna trecută, dar acesta nu coincide întotdeauna cu cel curent.
- Dificil de susținut. Va trebui să gestionăm conturile de testare, să le resetăm constant înainte de fiecare implementare, când în stoc sunt trimise înregistrări active. Este mai complicat decât a scrie un test în propria noastră zonă de testare.
Singurul bonus aici este că putem verifica performanța.
Relațiile canary
Din cauza dezavantajelor testelor smoke, am început să utilizăm relații canary.
Practicile, similar cu modul în care minerii foloseau canari pentru a indica nivelul gazelor, s-au aplicat și în IT. Lăsăm puțin trafic real de producție pe noua versiune, în timp ce ne străduim să ne încadram în Acordul de Nivel de Serviciu (SLA). SLA este „dreptul nostru la greșeală”, pe care îl putem folosi o dată pe an (sau într-un alt interval de timp). Dacă totul merge bine, adăugăm mai mult trafic. Dacă nu — revenim la versiunile anterioare.
Implementarea și nuanțele
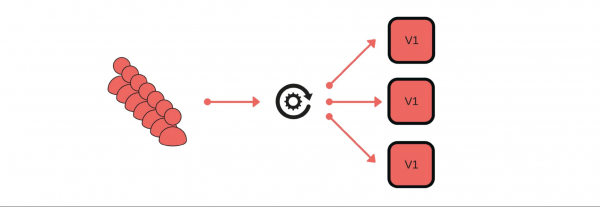
Cum am implementat relațiile canary? De exemplu, un grup de clienți trimite mesaje prin serviciul nostru.
Implementarea se desfășoară astfel: scoatem un nod din echilibror (1), schimbăm versiunea (2) și în mod separat lăsăm să treacă puțin trafic (3).
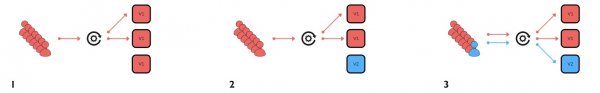
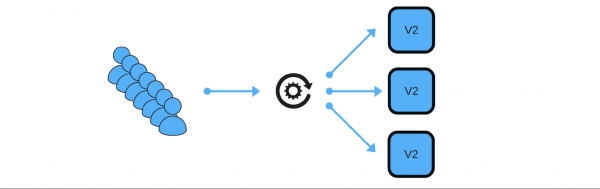
În general, vor fi mulțumiți toți din grup, chiar dacă un utilizator este nemulțumit. Dacă totul este în regulă — schimbăm toate versiunile.
Voi arăta schematic cum arată acest lucru pentru microservicii în majoritatea cazurilor.
Există Descoperirea Serviciilor și încă două servicii: S1N1 și S2. Primul serviciu (S1N1) anunță Descoperirea Serviciilor atunci când pornește, iar Descoperirea Serviciilor îl memorized. Al doilea serviciu cu două noduri (S2N1 și S2N2) anunță de asemenea Descoperirea Serviciilor la pornire.
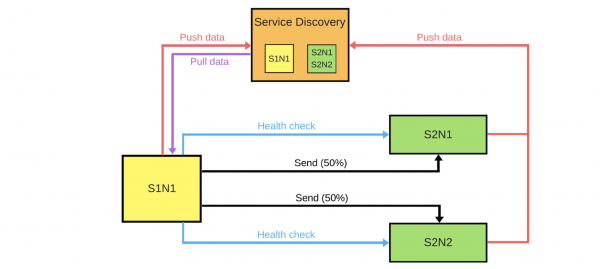
Al doilea serviciu pentru primul funcționează ca un server. Primul solicită de la Descoperirea Serviciilor informații despre serverele sale, iar când le primește — le caută și le verifică („verificarea stării”). Când le verifică, le va trimite mesaje.
Când cineva dorește să implementeze o nouă versiune a celui de-al doilea serviciu, informează Descoperirea Serviciilor că nodul secundar va fi nodul canary: va primi mai puțin trafic pentru că va avea loc implementarea. Scoatem nodul canary din echilibror și primul serviciu nu-i trimite trafic.
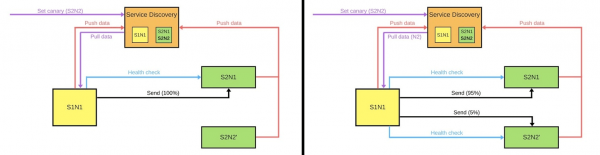
Schimbăm versiunea, iar Service Discovery știe că a doua nodă este acum canary — putem să-i dăm o sarcină mai mică (5%). Dacă totul decurge bine, schimbăm versiunea, restaurăm sarcinile și continuăm activitatea.
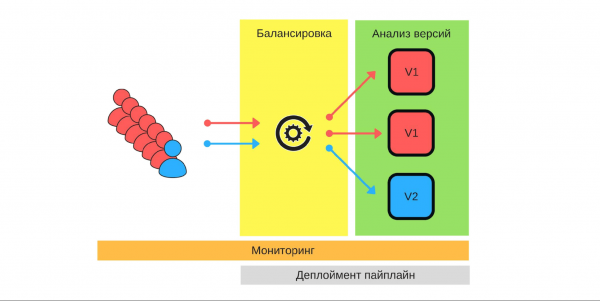
Pentru a realiza toate acestea, avem nevoie de:
- balansare;
- monitorizare, deoarece este important să știm ce așteaptă fiecare utilizator și cât de detaliat funcționează serviciile noastre;
- analiza versiunilor, pentru a înțelege cât de bine va funcționa noua versiune în producție;
- automatizarea — scriem secvența de desfășurare (deployment pipeline).
Balansarea
Este primul lucru la care trebuie să ne gândim. Există două strategii de balansare.
Cea mai simplă variantă este când o nodă este întotdeauna canary.Această nodă primește întotdeauna mai puțin trafic, iar desfășurarea începe cu ea. În caz de probleme, comparăm performanța ei dinainte de desfășurare și în timpul desfășurării. De exemplu, dacă numărul de erori s-a dublat, înseamnă că și pagubele s-au dublat.
Noda canary este stabilită în timpul desfășurării.Când desfășurarea se termină și îi ridicăm statutul de nodă canary, echilibrul traficului se restabilește. Cu un număr mai mic de mașini, obținem o distribuție corectă.
Monitorizare
Piatra de temelie a lansărilor canary. Trebuie să înțelegem exact de ce facem acest lucru și ce metri dorim să colectăm.
Exemple de metrici pe care le colectăm de la serviciile noastre.
- Numărul de erori, care sunt scrise în jurnale. Acesta este un indicator evident că totul funcționează cum trebuie. În general, este o metrică bună.
- Timpul de execuție al cererilor (latency). Această metrică este monitorizată de toți, deoarece toată lumea dorește să funcționeze rapid.
- Dimensiunea cozii (throughput).
- Numărul de răspunsuri de succes pe secundă.
- Timpul de execuție al 95% din toate cererile.
- Metrici de afaceri: cât de mult câștigă afacerea într-un anumit interval de timp sau rata de abandon a utilizatorilor. Aceste metrici pentru noua noastră versiune ar putea fi mai importante decât cele pe care le adaugă inginerii.
Exemple de metrici în cele mai populare sisteme de monitorizare.
Counter. Este o cantitate crescătoare, de exemplu, numărul de erori. Această metrică poate fi ușor interpolată și studiată grafic: ieri au fost 2 erori, iar astăzi 500, înseamnă că ceva a mers prost.
Numărul de erori pe minut sau pe secundă, acesta este un indicator esențial care poate fi calculat folosind Counter. Aceste date oferă o imagine clară asupra funcționării sistemului pe termen lung. Să analizăm exemplul graficului numărului de erori pe secundă pentru două versiuni ale sistemului de producție.
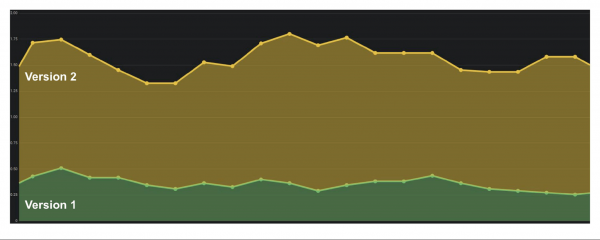
În prima versiune erau puține erori, poate auditul nu funcționa. În a doua versiune, totul este mult mai rău. Putem spune cu certitudine că există probleme, așa că trebuie să revenim la această versiune.
Gauge. Metrixele sunt asemănătoare cu Counter, dar înregistrăm valori care pot atât să crească, cât și să scadă. De exemplu, timpul de execuție al solicitărilor sau dimensiunea cozii.
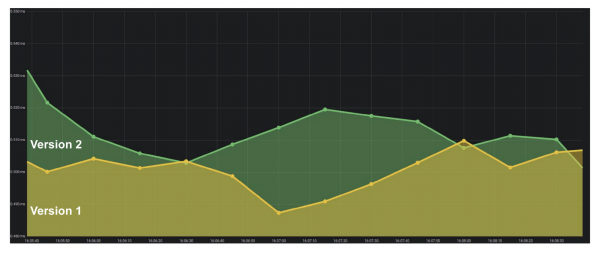
În grafic este un exemplu de timp de răspuns (latency). Din grafic se poate observa că versiunile sunt asemănătoare, sunt utilizabile. Dar dacă ne uităm mai atent, se observă cum se schimbă mărimea. Dacă timpul de execuție al solicitărilor crește odată cu adăugarea utilizatorilor, atunci este evident că sunt probleme — nu a fost așa înainte.
Summary. Unul dintre cei mai importanți indicatori pentru afaceri sunt percentilile. Metrixa arată că în 95% din cazuri sistemul nostru funcționează așa cum ne dorim. Ne putem împăca cu problemele ocazionale, pentru că înțelegem tendința generală, cât de bine sau rău stăm.
Instrumente
ELK Stack. Implementarea canary poate fi realizată utilizând Elasticsearch - înregistrăm erorile în acesta atunci când apar evenimente. Printr-un simplu apel API putem obține numărul de erori în orice moment și să comparăm cu intervalele anterioare: GET /applg/_cunt?q=level:errr.
Prometheus. S-a dovedit eficient în Infobip. Permite realizarea metrixelor multidimensionale, deoarece sunt folosite etichete.
Putem folosi level, instance, service, combinându-le într-un singur sistem. Cu ajutorul offset putem verifica, de exemplu, valoarea unei mărimi cu o săptămână în urmă, folosind o singură comandă GET /api/v1/query?query={query}, unde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analiza versiunilor
Există câteva strategii pentru analiza versiunilor.
Să ne uităm doar la metrixele nodului canary. Una dintre cele mai simple variante: am implementat o nouă versiune și studiem doar funcționarea acesteia. Dar dacă inginerul începe în acest timp să analizeze jurnalele, reîncărcând nervos paginile, această soluție nu se deosebește de celelalte.
Nodul canary este comparat cu orice alt nod. Aceasta este o comparație cu alte instanțe care funcționează cu trafic complet. De exemplu, dacă cu un trafic mic lucrurile stau mai rău, sau nu mai bine decât pe instanțele reale, atunci ceva nu este în regulă.
Nodul canary se compară cu sine în trecut. Nodurile dedicate pentru canary pot fi comparate cu datele istorice. De exemplu, dacă acum o săptămână totul era în regulă, putem folosi aceste informații pentru a înțelege situația actuală.
Automatizarea
Vrem să eliberăm inginerii de comparațiile manuale, așa că este important să implementăm automatizarea. Procesul de deployment arată de obicei așa:
- începem;
- îndepărtăm nodul de sub balansor;
- așezăm nodul canary;
- activăm balansorul cu o cantitate limitată de trafic;
- comparam.
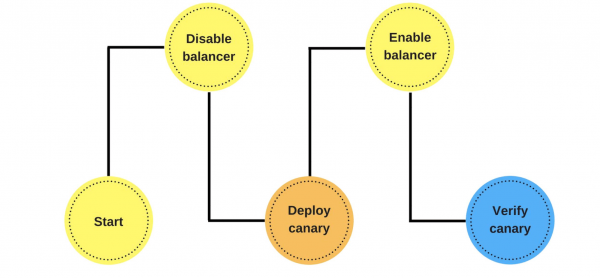
În acest stadiu, implementăm compararea automată. Cum poate arăta aceasta și de ce este mai bună decât verificarea după deploy, vom explica printr-un exemplu din Jenkins.
Acesta este un pipeline în Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary a eșuat, trebuie să revenim"
        return false
    }
}
Aici în ciclu stabilim că vom compara noul nod pe parcursul a unei ore. Dacă procesul canary nu s-a încheiat încă — apelăm funcția. Aceasta raportează dacă totul este în regulă sau nu: def isOk = compare(srv, canary, time, base, offset, metrics).
Dacă totul este în regulă — sleep DEFAULT SLEEP, de exemplu, un secundă, și continuăm. Dacă nu, ieșim — deploy-ul a eșuat.
Descrierea metricii. Să vedem cum poate arăta funcția compare în exemplul DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Să presupunem că comparăm numărul de erori și dorim să aflăm numărul de erori pe secundă în ultimele 5 minute.
Avem două valori: valoarea de bază și valoarea nodului canary. Valoarea de la nodul canary este cea curentă. Valoarea de bază este baseValue — aceasta este valoarea oricărui alt nod care nu este canary. Comparăm valorile între ele în baza formulei, pe care o stabilim din experiența și observațiile noastre. Dacă valoarea canaryValue este slabă, atunci deploy-ul a eșuat și revenim.
De ce este necesar tot acest lucru?
Oamenii nu pot verifica sute și mii de metrici, mai ales să o facă rapid. Compararea automată ajută la verificarea tuturor metricilor și notifică rapid despre probleme. Timpul de notificare este critic: dacă ceva s-a întâmplat în ultimele 2 secunde, daunele vor fi mai mici decât dacă s-ar fi întâmplat cu 15 minute în urmă. Până cineva observă problema, scrie la suport, iar suportul ne ajută să revenim, putem pierde clienți.
Dacă procesul a decurs bine, desfășurăm automat toate celelalte noduri. În această perioadă, inginerii nu fac nimic. Numai când lansează canary, decid ce metrici să ia, cât timp să facă comparația, ce strategie să folosească.
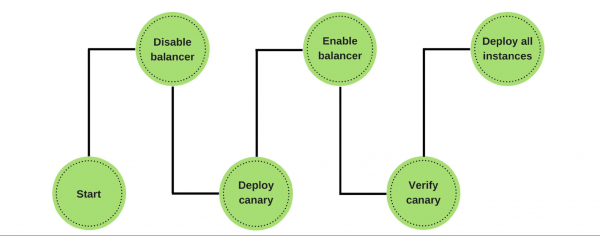
Dacă apar probleme, răsturnăm automat nodul canary, lucrăm cu versiunile anterioare și corectăm erorile identificate. Pe baza metricilor, este ușor să le găsim și să vedem impactul noii versiunii.
Obstacole
Implementarea acestui lucru nu este deloc simplă. În primul rând, avem nevoie de o sistem de monitorizare comun. Inginerii au metricile lor, suportul și analiștii au altele, iar afacerea are alte nevoie. Un sistem comun este limbajul comun prin care comunică afacerea și dezvoltarea.
Trebuie să verificăm în practică stabilitatea metricilor. Verificarea ajută la înțelegerea ce set minim de metrici este necesar pentru a asigura calitatea.
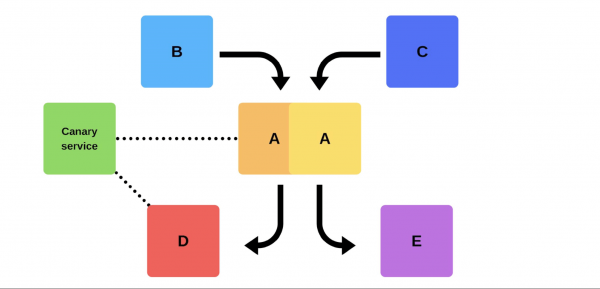
Cum putem realiza asta? Utilizați serviciul canary nu în timpul desfășurării. Adăugăm pe versiunea veche un serviciu care poate prelua oricând un nod dedicat, reducând traficul fără desfășurare. Apoi comparăm: analizăm erorile și căutăm acel punct în care atingem calitatea.
Ce beneficii am obținut din lansările canary
Am minimizat procentul de daune cauzate de buguri. Cele mai multe erori de desfășurare apar din cauza inconsecvenței unor date sau priorități. Aceste erori au devenit mult mai rare deoarece putem rezolva problemele în primele momente.
Am optimizat munca echipelor. Nou-veniții beneficiază de "dreptul la greșeală": pot desfășura în producție fără teama de a greși, există o inițiativă suplimentară, un stimulent de a lucra. Dacă rup ceva, nu va fi o problemă critică, iar persoana care a greșit nu va fi concediată.
Am automatizat desfășurarea. Acesta nu mai este un proces manual, ca înainte, ci un proces automatizat veritabil. Dar durează mai mult.
Am definit metricile importante. Întreaga companie, de la afacere la ingineri, înțelege ce este cu adevărat important în produsul nostru, ce metrici, de exemplu, rata de plecare și venire a utilizatorilor. Controlăm procesul: testăm metricile, introducem noi metrici, observăm cum funcționează cele vechi, pentru a construi un sistem care va genera venituri mai eficient.
Avem multe practici și sisteme interesante care ne ajută. Cu toate acestea, ne străduim să fim profesioniști și să ne facem munca de calitate, indiferent dacă avem sau nu un sistem care să ne ajute.
Abordările și practicile inginerești — . Dacă ai obținut succese în drumul către excelența tehnică și ești gata să împărtășești ce te-a ajutat, — .
Planificăm să organizăm pe 8 iunie. Înțelegem că este dificil să iei decizii privind participarea la conferință. Dar, în același timp, considerăm că izolarea nu este un motiv pentru a opri comunicarea și dezvoltarea profesională. Prin urmare, cu siguranță vom găsi o modalitate de a discuta despre provocările liderilor tehnici și despre abordările pentru soluționarea acestora — dacă va fi necesar, vom merge online și ne vom extinde rețeaua acolo!
Sursa: habr.com
