

Traducerea articolului a fost pregătită special pentru studenții cursului .
— dezvoltator de software, pasionat de Go și iubitor de provocări complexe. De asemenea, este mentinator pentru Prometheus și cofondator al Kubernetes SIG instrumentation. În trecut, a fost inginer de producție la SoundCloud și a condus echipa de monitorizare la CoreOS. În prezent, lucrează la Google.
— inginer de infrastructură la Improbable. Este interesat de tehnologiile noi și de problemele sistemelor distribuite. Are experiență în programarea la nivel de bază la Intel, experiență ca contributor în Mesos și experiență de producție SRE la nivel global la Improbable. Lucrează la îmbunătățirea lumii microserviciilor. Cele trei iubiri ale sale sunt: Golang, codul sursă deschis și voleiul.
Privind produsul nostru de vârf, SpatialOS, poți intui că Improbable necesită o infrastructură cloud dinamică, la scară globală, cu zeci de clustere Kubernetes. Am fost printre primii care au început să utilizeze sistemul de monitorizare . Prometheus poate urmări milioane de metrici în timp real și vine cu un limbaj de interogare puternic, care permite extragerea informațiilor necesare.
Simplicity and reliability of Prometheus is one of its main advantages. However, after reaching a certain scale, we encountered several shortcomings. To address these issues, we developed — un proiect open-source, creat de Improbable, pentru transformarea seamless a clusterelor existente Prometheus într-un sistem de monitorizare unificat cu stocare nelimitată a datelor istorice. Thanos este disponibil pe Github .
Obiectivele noastre cu Thanos
La o anumită scară, apar probleme care depășesc capacitățile vaniliei Prometheus. Cum putem stoca în mod fiabil și economic petabytes de date istorice? Se poate face acest lucru fără a afecta timpii de răspuns la interogări? Putem accesa toate metricile aflându-se pe servere Prometheus diferite printr-o singură interogare API? Putem cumva să unim datele replicate, adunate folosind Prometheus HA?
Pentru a răspunde acestor întrebări, am creat Thanos. În secțiunile următoare, vă vom descrie cum am abordat aceste întrebări și vom explica obiectivele pe care le-am urmărit.
Interogarea datelor din mai multe instanțe Prometheus (interogare globală)
Prometheus oferă o abordare funcțională pentru shard-ing. Chiar și un singur server Prometheus asigură o scalabilitate adecvată pentru a elibera utilizatorii de complexitățile shard-ului orizontal, practic în toate cazurile de utilizare.
Deși este un model excelent de desfășurare, adesea este necesar să accesați datele de pe diferite servere Prometheus printr-un API sau UI unic — global view. Desigur, există posibilitatea de a afișa mai multe cereri într-un singur panou Grafana, dar fiecare cerere poate fi efectuată doar pe un singur server Prometheus. Pe de altă parte, cu ajutorul Thanos, puteți solicita și agrega date de la mai multe servere Prometheus, deoarece toate sunt disponibile de la un singur punct final.
Anterior, pentru a obține global view în Improbable, ne-am organizat instanțele Prometheus într-o structură ierarhică. . Aceasta a implicat crearea unui meta-server Prometheus, care colectează o parte din metrici de la fiecare server "frunză".
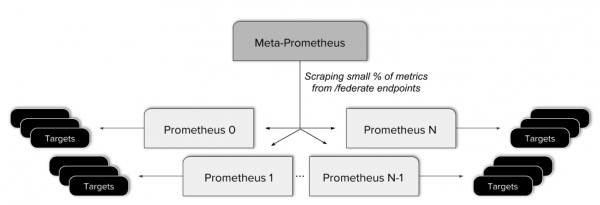
Această abordare s-a dovedit a fi problematică. A dus la complicarea configurației, adăugarea unui potențial punct de eșec suplimentar și aplicarea unor reguli complexe pentru a oferi punctului final federat doar datele necesare. În plus, o astfel de federare nu permite obținerea unui adevărat global view, deoarece nu toate datele sunt disponibile dintr-o singură cerere API.
Acest lucru este strâns legat de viziunea unitară a datelor colectate pe servere Prometheus cu înaltă disponibilitate (high-availability, HA). Modelul HA Prometheus colectează datele independent de două ori, ceea ce este atât de simplu încât nu poate fi mai simplu. Cu toate acestea, utilizarea unei viziuni combinate și deduplicată a ambelor fluxuri ar fi mult mai convenabilă.
Desigur, există o nevoie de servere Prometheus cu înaltă disponibilitate. La Improbable, tratăm foarte serios monitorizarea datelor la fiecare minut, dar a avea o singură instanță Prometheus pe cluster este un punct unic de eșec. Orice eroare de configurare sau defecțiune hardware poate duce potențial la pierderea unor date importante. Chiar și o desfășurare simplă poate duce la mici întreruperi în colectarea metricilor, deoarece repornirea poate dura semnificativ mai mult decât intervalul de scraping.
Stocare fiabilă a datelor istorice
Stocarea metricelor ieftină, rapidă și de lungă durată este visul nostru (împărtășit de majoritatea utilizatorilor Prometheus). La Improbable, a trebuit să setăm perioada de stocare a metricelor pe nouă zile (pentru Prometheus 1.8). Aceasta aduce limitări evidente asupra cât de departe putem privi înapoi.
Prometheus 2.0 a devenit mai bun în această privință, deoarece numărul de serii temporale nu mai influențează performanța generală a serverului (vezi. ). Cu toate acestea, Prometheus stochează datele pe discul local. Deși compresia de date de înaltă performanță poate reduce semnificativ utilizarea SSD-ului local, totuși există o limitare asupra volumului de date istorice stocate.
În plus, la Improbable, ne pasă de fiabilitate, simplitate și costuri. Discurile locale mari sunt mai greu de operat și de realizat backup. Acestea sunt mai scumpe și necesită mai multe instrumente pentru backup, ceea ce duce la o complexitate excesivă.
Reducerea
Odată ce am început să lucrăm cu datele istorice, am realizat că există dificultăți fundamentale cu O-mare, care fac ca interogările să devină din ce în ce mai lente atunci când lucrăm cu date pe săptămâni, luni și ani.
Soluția standard pentru această problemă este (downsampling) – reducerea frecvenței de eșantionare a semnalului. Prin scăderea eșantionării, putem „reduce scala” la un interval de timp mai mare și păstra același număr de eșantioane, ceea ce va permite menținerea rapidității interogărilor.
Reducerea datelor vechi este o cerință inevitabilă a oricărei soluții pentru stocarea pe termen lung și depășește Prometheus-ul vanilat.
Obiective suplimentare
Unul dintre obiectivele inițiale ale proiectului Thanos a fost integrarea fără cusur cu orice instalare existentă a Prometheus. Al doilea obiectiv a fost ușurința în utilizare cu o barieră de intrare minimă. Orice dependențe trebuie să fie ușor satisfăcute atât pentru utilizatori mici, cât și pentru cei mari, ceea ce implică, de asemenea, costuri de bază reduse.
Arhitectura Thanos
După ce am enumerat obiectivele noastre în secțiunea anterioară, haideți să lucrăm la ele și să vedem cum Thanos abordează aceste probleme.
Vizuinea globală
Pentru a obține o vedere globală asupra instanțelor existente Prometheus, trebuie să conectăm un punct unic de intrare al cererilor cu toate serverele. Acesta este rolul componentului Thanos. . Acesta este desfășurat lângă fiecare server Prometheus și funcționează ca un proxy, servind datele locale Prometheus prin intermediul interfeței gRPC Store API, permițând selectarea datelor time series pe baza etichetelor și intervalului de timp.
Pe de altă parte, se află componenta Querier, care este scalabilă orizontal și fără stocare de stare, care face mai mult decât să răspundă la cererile PromQL prin intermediul standard HTTP API al Prometheus. Componentele Querier, Sidecar și alte module Thanos interacționează prin .
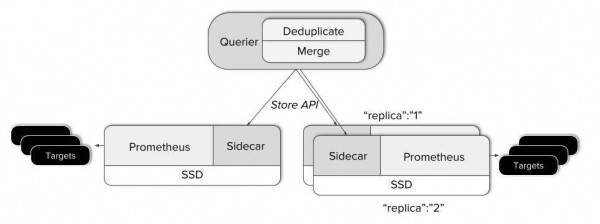
- Querier, la primirea unei cereri, se conectează la serverul corespunzător Store API, adică la Sidecar-urile noastre, și obține datele time series de la serverele Prometheus corespunzătoare.
- Apoi, acesta combină răspunsurile și execută cererea PromQL. Querier poate combina date atât din surse necorelate, cât și date duplicate de la serverele HA Prometheus.
Aceasta rezolvă cea mai mare parte a problemei noastre — combinarea datelor de pe serverele izolate Prometheus într-o singură imagine. Practic, Thanos poate fi utilizat doar pentru această funcționalitate. Nu sunt necesare modificări în serverele Prometheus existente!
Stocare nelimitată!
Cu toate acestea, mai devreme sau mai târziu, vom dori să păstrăm datele care depășesc perioada obișnuită de stocare Prometheus. Pentru stocarea datelor istorice, am ales un serviciu de stocare de obiecte. Acesta este disponibil pe scară largă în orice cloud, precum și în centre de date locale, și este foarte economic. În plus, aproape orice serviciu de stocare de obiecte este accesibil prin binecunoscutul S3 API.
Prometheus scrie datele din memoria operațională pe disc la aproximativ fiecare două ore. Modul în care datele sunt salvate conține toate datele pentru o perioadă fixă de timp și este imuabil. Acest lucru este foarte convenabil, deoarece Thanos Sidecar poate doar să verifice catalogul de date Prometheus și, pe măsură ce apar noi module, să le încarce în bucketurile serviciului de stocare de obiecte.
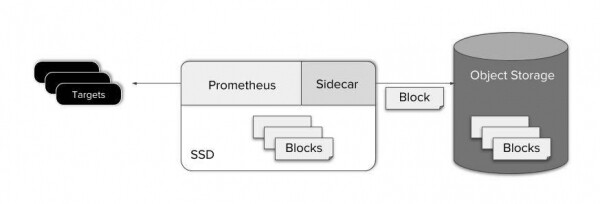
Încărcarea în serviciul de stocare de obiecte imediat după scrierea pe disc permite de asemenea menținerea simplității „scraper-ului” (Prometheus și Thanos Sidecar). Acest lucru simplifică întreținerea, costurile și designul sistemului.
După cum puteți vedea, backup-ul datelor se realizează foarte simplu. Dar ce zicem despre cererea de date din stocarea obiectelor?
Componenta Thanos Store acționează ca un proxy pentru obținerea datelor din stocarea obiectelor. La fel ca Thanos Sidecar, acesta participă la clusterul gossip și implementează API-ul Store. Astfel, Querier-urile existente îl pot considera ca pe un Sidecar, ca o altă sursă de date time series — nicio configurare specială nu este necesară.
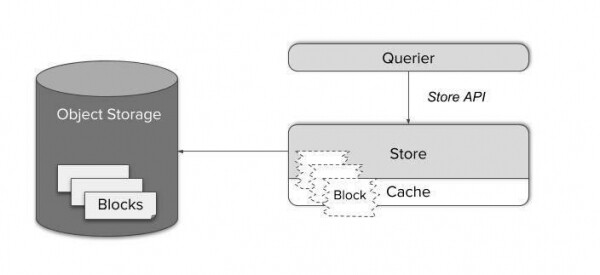
Blocurile de date time series sunt formate din mai multe fișiere mari. Descărcarea lor la cerere ar fi destul de ineficientă, iar stocarea locală în cache ar necesita o cantitate uriașă de memorie și spațiu pe disc.
În schimb, Store Gateway știe cum să gestioneze formatul de stocare Prometheus. Datorită unui planificator de cereri inteligent și a stocării în cache doar a părților index necesare ale blocurilor, a devenit posibil să reducem cererile complexe la un număr minim de cereri HTTP către fișierele din stocarea obiectelor. Astfel, se poate reduce numărul de cereri cu patru până la șase ordine de mărime și se poate obține un timp de răspuns care este, în general, greu de deosebit de cererile de date pe un SSD local.
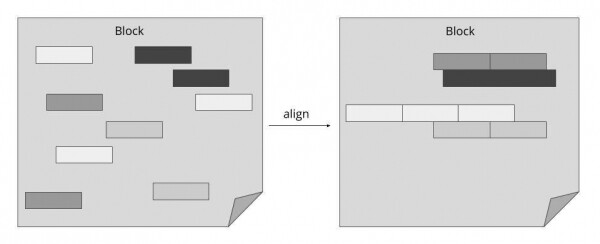
După cum este arătat în diagrama de mai sus, Thanos Querier reduce semnificativ costurile pentru o cerere de date din stocarea obiectelor, folosind formatul de stocare Prometheus și plasând datele conexe aproape. Folosind această abordare, putem combina numeroase cereri individuale într-un număr minim de operații bulk.
Compresia și downsampling-ul
După ce un nou bloc de date time series a fost încărcat cu succes în stocarea obiectelor, îl considerăm date „istorice”, care devin imediat disponibile prin Store Gateway.
Cu toate acestea, după un timp, blocurile dintr-o singură sursă (Prometheus cu Sidecar) se acumulează și nu mai profită din plin de potențialul de indexare. Pentru a rezolva această problemă, am introdus un alt component numit Compactor. Acesta aplică pur și simplu mecanismul local de compresie Prometheus datelor istorice din stocarea obiectelor și poate fi rulat ca o simplă sarcină programată periodic.
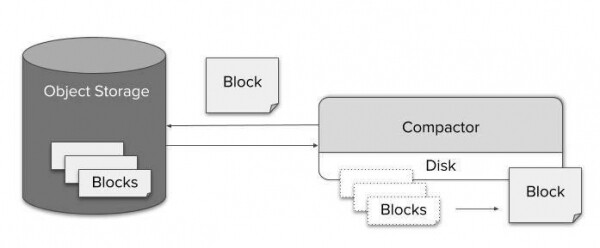
Datorită comprimării eficiente, solicitările de stocare pe o perioadă lungă de timp nu reprezintă o problemă din punct de vedere al dimensiunii datelor. Totuși, costul potențial de descompresie a unui miliard de valori și de procesare a acestora va duce inevitabil la o creștere semnificativă a timpului de execuție al cererii. Pe de altă parte, deoarece pentru fiecare pixel de pe ecran există sute de puncte de date, devine imposibil să se vizualizeze chiar și datele în rezoluție maximă. Astfel, downsampling-ul nu este doar posibil, ci nu va duce la o pierdere semnificativă a preciziei.
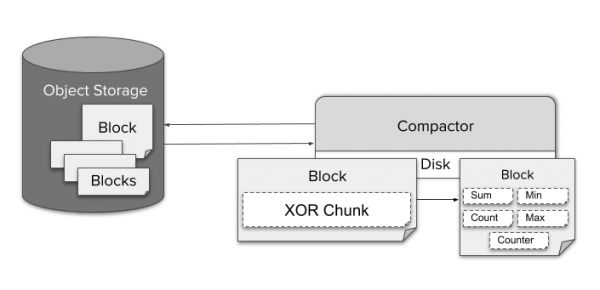
Pentru downsampling-ul datelor, Compactor agregă continuu datele cu o rezoluție de cinci minute și o oră. Pentru fiecare fragment nestructurat, codificat cu compresia TSDB XOR, sunt stocate diferite tipuri de date agregate, cum ar fi min, max sau sum pentru un singur bloc. Aceasta permite Querier-ului să selecteze automat agregatul care se potrivește pentru solicitarea PromQL dată.
Pentru utilizarea datelor cu precizie redusă, utilizatorul nu necesită nicio configurare specială. Querier-ul trece automat între diferite rezoluții și date nestructurate pe măsură ce utilizatorul mărește sau micșorează scala. Dacă dorește, utilizatorul poate gestiona acest lucru direct prin parametrul 'step' din solicitare.
Având în vedere că costul stocării unui GB este redus, Thanos păstrează implicit datele originale, datele cu rezoluție de cinci minute și de o oră. Nu este necesar să se elimine datele originale.
Reguli de înregistrare
Chiar și cu Thanos, regulile de înregistrare sunt o parte esențială a stivei de monitorizare. Acestea reduc complexitatea, latența și costul solicitărilor. De asemenea, sunt utile utilizatorilor pentru a obține date agregate pe metrici. Thanos se bazează pe instanțele vanille ale Prometheus, așa că este absolut acceptabil să se păstreze regulile de înregistrare și regulile de alertă pe serverul Prometheus existent. Totuși, în unele cazuri, acest lucru poate să nu fie suficient:
- Alertă și regulă globale (de exemplu, alertă atunci când un serviciu nu funcționează în mai mult de două dintre cele trei clustere).
- Regulă pentru datele din afara stocării locale.
- Tendința de a păstra toate regulile și alertele într-un singur loc.
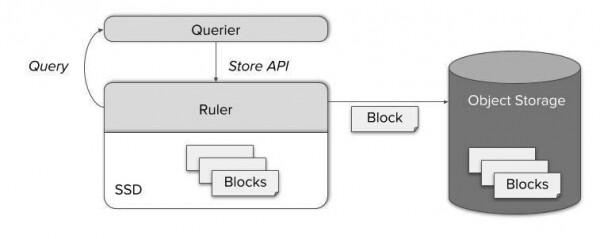
Pentru toate aceste cazuri, Thanos include un component separat numit Ruler, care calculează reguli și alerte prin Thanos Queries. Oferind un well-known StoreAPI, nodul Query poate accesa metrici recent calculate. Ulterior, acestea sunt de asemenea salvate în stocarea de obiecte și devin disponibile prin Store Gateway.
Puterea Thanos
Thanos este suficient de flexibil pentru a fi configurat conform cerințelor dumneavoastră. Acest lucru este deosebit de util la migrarea de la un Prometheus simplu. Hai să ne amintim rapid, cu un exemplu mic, ce am învățat despre componentele Thanos. Iată cum să transferați Prometheus-ul dvs. vanilla în lumea „stocării nelimitate a metricilor”:
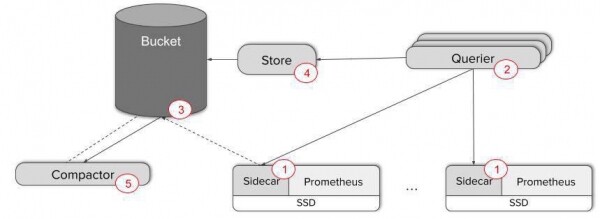
- Adăugați Thanos Sidecar la serverele dvs. Prometheus — de exemplu, un container vecin în podul Kubernetes.
- Dezvoltați mai multe replici Thanos Querier pentru a putea vizualiza datele. În această etapă este ușor să configurați gossip între Scraper și Querier. Pentru a verifica interacțiunea componentelor, utilizați metrica ‘thanos_cluster_members’.
Numai acești doi pași sunt suficienți pentru a asigura o viziune globală și deduplicarea fără cusur a datelor de la posibilele replici HA ale Prometheus! Conectați pur și simplu tablourile de bord la punctul final HTTP Querier sau folosiți interfața Thanos UI direct.
Totuși, dacă aveți nevoie de backup pentru metrici și stocare pe termen lung, va fi necesar să efectuați încă trei pași:
- Creați un bucket AWS S3 sau GCS. Configurați Sidecar pentru a copia datele în aceste bucket-uri. Acum puteți minimiza stocarea locală a datelor.
- Dezvoltați Store Gateway și conectați-l la clusterul gossip existent. Acum puteți trimite cereri către datele din backup-uri!
- Dezvoltați Compactor pentru a îmbunătăți eficiența cererilor pentru intervale lungi de timp, folosind comprimarea și downsampling-ul.
Dacă doriți să aflați mai multe, nu ezitați, consultați și !
În total, în cinci pași, am transformat Prometheus într-un sistem de monitorizare de încredere cu viziune globală, timp nelimitat de stocare și disponibilitate înaltă potențială pentru metrici.
Cerere de pull: avem nevoie de voi!
a fost un proiect open-source încă de la început. Integrarea fără cusur cu Prometheus și capacitatea de a folosi doar o parte din Thanos fac din el o alegere excelentă pentru scalarea sistemului de monitorizare fără eforturi suplimentare.
Suntem întotdeauna bucuroși să primim Pull Request-uri și Issues pe GitHub. De asemenea, nu ezitați să ne contactați prin GitHub Issues sau Slack., dacă aveți întrebări sau feedback, sau doriți să împărtășiți experiența dumneavoastră! Dacă vă place ceea ce facem la Improbable, nu ezitați să ne contactați — !
Sursa: habr.com
