

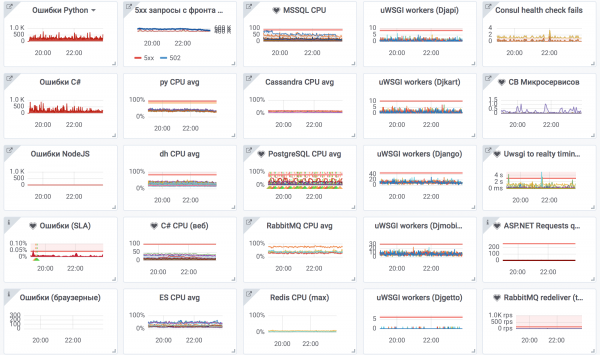
Salutare tuturor!
Mă numesc Nikita, sunt liderul echipei de ingineri de la Cian. Una dintre responsabilitățile mele în companie este de a reduce la zero numărul incidentelor legate de infrastructură în producție.
Ceea ce urmează va fi discutat a adus multe durei, iar scopul acestui articol este de a împiedica alte persoane să repete greșelile noastre sau măcar să minimizeze impactul acestora.
Preambul
Demult, când Cian era format din monolituri și nu existau indicii despre microservicii, măsuram disponibilitatea resursei prin verificarea a 3-5 pagini.
Dacă acestea răspundeau — era bine, iar dacă nu răspundeau pentru o perioadă îndelungată — se activa un alert. Cât timp trebuiau să nu funcționeze pentru a fi considerate un incident, decideau oamenii în întâlniri. Echipa de ingineri participa întotdeauna la investigarea incidentului. Când investigația se termina, se scria un postmortem — un fel de raport pe email în format: ce s-a întâmplat, cât a durat, ce am făcut atunci și ce vom face în viitor.
Pagini principale ale site-ului sau cum înțelegem că am atins fundul.
Pentru a putea evalua prioritățile erorilor, am evidențiat cele mai critice pagini funcționalității de afaceri ale site-ului. Pe acestea, numărăm cantitatea de solicitări reușite/nereușite și timeout-uri. Astfel, măsurăm uptime-ul.
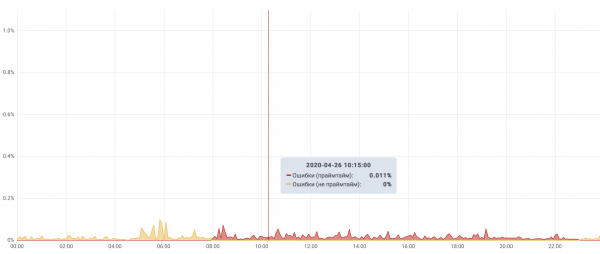
Să presupunem că am stabilit că există o serie de secțiuni extrem de importante ale site-ului care răspund de principalul serviciu — căutarea și publicarea anunțurilor. Dacă procentul de solicitări care s-au terminat cu eroare depășește 1% — acesta este un incident critic. Dacă, în timpul vârfului de trafic, procentul de erori depășește 0,1% în decurs de 15 minute — aceasta este, de asemenea, considerată un incident critic. Aceste criterii acoperă cea mai mare parte a incidentelor, restul ieșind din sfera acestui articol.
Cele mai bune incidente de la Cian
Așadar, cu siguranță am învățat să identificăm faptul că un incident a avut loc.
Acum, fiecare incident este detaliat și reflectat în epicul Jira. Apropo: pentru asta am înființat un proiect separat, l-am numit FAIL — în care se pot crea doar epice.
Dacă am aduna toate eșecurile din ultimii ani, iată ce iese în evidență:
- incidente legate de mssql;
- incidente cauzate de factori externi;
- eroare de administrator.
Vom detalia mai amănunțit erorile administratorilor, precum și unele alte eșecuri interesante.
Locul cinci — „Facem ordine în DNS”
A fost o marți ploioasă. Am decis să facem ordine în clusterul DNS.
Mi-a venit ideea să trec serverele DNS interne de la bind la powerdns, dedicând pentru aceasta servere complet separate, unde nu exista nimic altceva în afară de DNS.
Am plasat câte un server DNS în fiecare locație a datacentrelor noastre, iar a venit momentul să transferăm zonele de la bind la powerdns și să schimbăm infrastructura pe noile servere.
În plin proces de transfer, dintre toate servere, care erau specificate în cache-urile locale bind de pe toate serverele, a rămas doar unul, care se afla în data center-ul din Sankt-Petersburg. Acest datacenter inițial a fost declarat ca fiind necritic pentru noi, dar dintr-o dată a devenit un punct unic de defecțiune.
Chiar în acea perioadă de transfer, canalul între Moscova și Sankt-Petersburg a cedat. Practic, am rămas fără DNS timp de cinci minute și ne-am revenit când hoster a remediat problemele.
Concluzii:
Dacă înainte neglijam factorii externi în timpul pregătirii lucrărilor, acum i-am inclus și pe aceștia în lista a ceea ce ne pregătim. Și acum ne străduim ca toate componentele să fie rezervate n-2, iar pe durata lucrărilor putem reduce acest nivel la n-1.
- În timpul elaborării planului de acțiune, marcați punctele unde serviciul poate cădea și gândiți-vă la scenariul în care totul a mers „îngrozitor de rău”, din timp.
- Distribuiți serverele DNS interne în diferite geolocații/datacentere/rack-uri/comutatoare/introduceri.
- Pe fiecare server, instalați un server DNS local de cache care redirecționează cererile către serverele DNS principale, iar în cazul indisponibilității acestuia, va răspunde din cache.
Locul patru — „Facem ordine în Nginx”
Într-o zi frumoasă, echipa noastră a decis că „a fost destul” și a început procesul de refactorizare a configurațiilor nginx. Scopul principal — a aduce configurațiile la o structură intuitivă. În trecut, totul era „istoric” și nu avea nicio logică. Acum fiecare server_name a fost mutat în fișierele corespunzătoare și toate configurațiile au fost distribuite pe foldere. Apropo — configurația conține 253949 de linii sau 7836520 de caractere și ocupă aproape 7 megabytes. Nivelul superior al structurii:
Structura Nginx
├── acces
│   ├── allow.list
...
│   └── whitelist.conf
├── geobază
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dinamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logici
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ro
│   │   ├── cian.ro.conf
│   │   ├── ...
│   │   └── my.cian.ro.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
A devenit semnificativ mai bine, dar în procesul de redenumire și redistribuție a configurațiilor, o parte dintre ele au avut extensia greșită și nu au intrat în directiva include *.conf. Drept urmare — unele găzduiri au devenit inaccesibile și au returnat 301 la pagina principală. Din cauza faptului că codul de răspuns nu era 5xx/4xx, acest lucru nu a fost observat imediat, ci abia dimineața. După aceasta, am început să scriem teste pentru a verifica componentele infrastructurii.
Concluzii:
- Structurați corect configurațiile (nu doar nginx) și gândiți structura încă din etapa inițială a proiectului. Așa veți face ca acestea să fie mai clare pentru echipă, ceea ce va reduce timpul de livrare.
- Pentru unele componente ale infrastructurii, scrieți teste. De exemplu: verificați că toate numele cheie server_name returnează statutul corect, plus corpul răspunsului. Va fi suficient să aveți câteva scripturi care verifică funcțiile esențiale ale componentei, astfel încât să nu vă agitați în miez de noapte întrebându-vă ce altceva trebuie să verificați.
Locul trei — „A rămas brusc fără loc în Cassandra”
Datele au crescut constant și totul a fost bine până în momentul în care în clusterul Cassandra au început să eșueze reparațiile pentru mari case de date, deoarece compacția nu putea funcționa pe acestea.
Într-o zi mohorâtă, clusterul s-a transformat aproape într-o dovleacă, mai exact:
- mai rămăsese aproximativ 20% din capacitatea totală a clusterului;
- nu se pot adăuga noduri, deoarece nu se finalizează curățarea după adăugarea unui nod din cauza lipsei de spațiu pe partiții;
- performanța scade treptat, deoarece compacția nu funcționează;
- clusterul funcționează în modul de urgență.
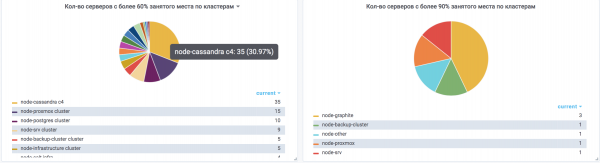
Ieșirea — am adăugat încă 5 noduri fără curățare, după care am început să scoatem sistematic din cluster și să introducem din nou, ca noduri goale, pe care nu mai era spațiu. Timpul petrecut a fost mult mai mare decât ne-am fi dorit. A existat riscul de nedisponibilitate parțială sau totală a cluster-ului.
Concluzii:
- Pe toate serverele Cassandra, nu ar trebui să fie ocupat mai mult de 60% din spațiul fiecărei partiții.
- Acestea ar trebui să fie încărcate la mai mult de 50% din CPU.
- Nu trebuie să neglijăm planificarea capacității, și aceasta trebuie gândită pentru fiecare componentă, în funcție de specificul său.
- Cu cât sunt mai multe noduri în cluster, cu atât mai bine. Serverele care conțin un volum mic de date se reconectează mai repede, iar un astfel de cluster este mai ușor de recuperat.
Locul doi — „Datele au dispărut din stocarea key-value consul”
Pentru descoperirea serviciilor, noi, ca și mulți alții, folosim consul. Dar la noi, key-value este folosit și pentru desfășurarea blue-green a monolitului. Acolo se stochează informațiile despre upstream-urile active și inactive, care se schimbă între ele în timpul desfășurării. A fost scris un serviciu de desfășurare care interacționa cu KV. La un moment dat, datele din KV au dispărut. Le-am recuperat din memorie, dar cu o serie de erori. Drept urmare, la desfășurare, sarcina pe upstream-uri s-a distribuit neuniform, iar noi am primit multe erori 502 din cauza suprasarcinii backend-urilor pe CPU. În cele din urmă, am trecut de la consul KV la postgres, de unde eliminarea acestora nu mai este atât de simplă.
Concluzii:
- Serviciile fără nicio autorizare nu ar trebui să conțină date critice pentru funcționarea site-ului. De exemplu, dacă nu aveți autorizare în ES, ar fi mai bine să interziceți accesul la nivel de rețea din toate locurile unde acesta nu este necesar, lăsând doar cele esențiale, și să faceți action.destructive_requires_name: true.
- Exersați mecanismul de backup și restaurare din timp. De exemplu, creați din timp un script (de exemplu, în Python) care să poată atât să facă backup, cât și să restaureze.
Locul întâi — „Căpitanul neocvios”
La un moment dat, am observat o distribuție inegală a încărcăturii pe upstream-urile nginx atunci când în backend erau 10+ servere. Deoarece round-robin redirecționa cererile de la primul la ultimul upstream în ordine, iar fiecare reîncărcare nginx începea de la început, primele upstream-uri primeau întotdeauna mai multe cereri decât celelalte. Drept consecință, ele funcționau mai lent, afectând întregul site. Acest lucru devenea din ce în ce mai evident pe măsură ce volumul de trafic creștea. Pur și simplu actualizarea nginx pentru a include random nu a fost suficientă — a fost necesar să refacem o mulțime de cod lua, care nu a funcționat în versiunea 1.15 (la acel moment). A fost nevoie să patch-uim nginx 1.14.2, introducând suport pentru random. Aceasta a rezolvat problema. Această eroare câștigă la categoria „căpitanul neobservabil”.
Concluzii:
A fost foarte interesant și captivant să investighez această eroare).
- Configurați monitorizarea astfel încât să ajute la identificarea rapidă a fluctuațiilor similare. De exemplu, puteți folosi ELK pentru a observa rps pentru fiecare backend al fiecărui upstream, urmărind timpii lor de răspuns în ceea ce privește nginx. În acest caz, acest lucru ne-a ajutat să identificăm problema.
O mare parte din eșecuri ar fi putut fi evitate printr-o abordare mai minuțioasă a ceea ce faci. Trebuie să ne amintim întotdeauna de legea lui Murphy: Orice ar putea merge prost, va merge prost, și să construim componente având în vedere acest lucru.
Sursa: habr.com
