

Ce ați simți dacă, într-o zi frumoasă de vară, centrul de date cu echipamentul dumneavoastră ar arăta astfel?
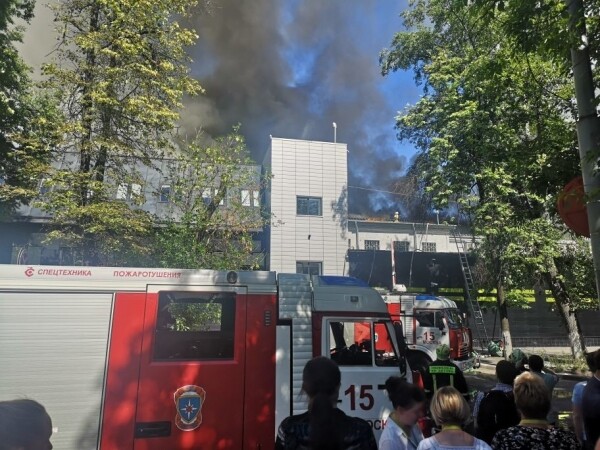
Salut tuturor! Mă numesc Dmitri Samsonov, sunt administrator de sistem principal la „”. În fotografie este unul dintre cele patru centre de date unde este instalat echipamentul care deservește proiectul nostru. În spatele acestor pereți se află aproximativ 4.000 de unități de echipamente: servere, sistem de stocare a datelor, echipamente de rețea etc. — aproape ⅓ din tot echipamentul nostru.
Majoritatea serverelor sunt cu Linux. Există și câteva zeci de servere cu Windows (MS SQL) — moștenirea noastră, de care ne desfacem treptat de-a lungul anilor.
Așadar, pe 5 iunie 2019, la ora 14:35, inginerii unuia dintre centrele noastre de date au raportat o alarmă de incendiu.
Negare
14:45. Incidente minore de fum în centrele de date se întâmplă mai des decât pare. Indicatorii din săli erau normali, așa că prima noastră reacție a fost relativ calmă: am impus o interdicție asupra lucrărilor cu producția, adică asupra oricăror modificări de configurație, lansării de versiuni noi etc., cu excepția lucrărilor legate de reparația unor echipamente.
Furie
Ați încercat vreodată să întrebați pompierii exact unde pe acoperiș a avut loc incendiul sau să ajungeți singur pe un acoperiș în flăcări pentru a evalua situația? Cât de mare va fi gradul de încredere în informațiile primite prin intermediul a cinci oameni?
14:50. Am primit informații că focul se apropie de sistemul de răcire. Dar va ajunge? Administratorul de sistem de serviciu redirecționează traficul extern de la fronturile acestui centru de date.
În prezent, fronturile tuturor serviciilor noastre sunt replicate în trei centre de date, folosind echilibrarea la nivel de DNS, ceea ce permite eliminarea adreselor unuia dintre centrele de date din DNS, protejând astfel utilizatorii de problemele potențiale de acces la servicii. În cazul în care problemele din centrul de date au intervenit deja, acesta iese automat din rotație. Detalii suplimentare pot fi citite aici:
Până acum, incendiul nu ne-a afectat deloc — nici utilizatorii, nici echipamentele nu au avut de suferit. Este aceasta o situație de urgență? Primul capitol al documentului „Plan de acțiune în caz de urgență” oferă o definiție a termenului „Situatie de urgență”, iar capitolul se încheie astfel:
«Dacă există îndoieli, este situație de urgență sau nu, atunci este situație de urgență!»
14:53. Se numește coordonatorul de urgență.
Coordonatorul este persoana care controlează comunicația între toți participanții, evaluează amploarea incidentului, folosește „Planul de acțiune pentru urgențe”, implică personalul necesar, supraveghează finalizarea reparațiilor și, cel mai important, delegă orice sarcini. Cu alte cuvinte, este persoana care gestionează întregul proces de eliminare a incidentului.
Negociere
15:01. Începem să oprim serverele care nu sunt legate de producție.
15:03. Oprim corect toate serviciile rezervate.
Acestea includ nu doar fronturile (la care utilizatorii nu mai au acces în acest moment) și serviciile lor auxiliare (logica de afaceri, cache-uri etc.), ci și diferite baze de date cu factor de replicare de 2 sau mai mult (, , , și altele).
15:06. Am primit informații că un incendiu amenință una dintre sălile centrului de date. În această sală nu avem echipamente, dar faptul că focul s-ar putea extinde de pe acoperiș la săli schimbă semnificativ situația.
(Mai târziu s-a dovedit că nu exista o amenințare fizică pentru sală, deoarece era etanș izolată de acoperiș. Amenințarea era doar pentru sistemul de răcire al acestei săli.)
15:07. Permitem execuția comenzilor pe servere în regim accelerat, fără verificări suplimentare ().
15:08. Temperatura în săli este în limite normale.
15:12. A fost înregistrată o creștere a temperaturii în săli.
15:13. Peste jumătate din serverele din centrul de date sunt oprite. Continuăm.
15:16. S-a luat decizia de a opri toată echiparea.
15:21. Începem să oprim alimentarea pe serverele stateless fără a închide corect aplicația și sistemul de operare.
15:23. Se desemnează un grup responsabil pentru MS SQL (sunt puțini, dependența serviciilor de ei nu este mare, dar procedura de recuperare a funcționalității durează mai mult timp și este mai complexă decât, de exemplu, cea pentru Cassandra).
Depresiune
15:25. Am primit informații despre oprirea alimentării în patru săli din 16 (nr. 6, 7, 8, 9). În sălile 7 și 8 se află echipamentele noastre. Încă nu avem informații despre alte două săli ale noastre (nr. 1 și 3).
De obicei, în caz de incendii, alimentarea electrică este oprită imediat, dar în acest caz, datorită muncii coordonate a pompierilor și personalului tehnic al centrului de date, nu a fost oprită peste tot și nu imediat, ci în funcție de necesitate.
(S-a descoperit ulterior că alimentarea în sălile 8 și 9 nu a fost oprită.)
15:28. Începem desfășurarea bazelor de date MS SQL din backupuri în alte centre de date.
Cât timp va dura acest lucru? Este suficientă lățimea de bandă a rețelei pe întregul traseu?
15:37. Au fost înregistrate deconectări ale unor porțiuni din rețea.
Managementul și rețeaua de producție sunt izolate fizic una de cealaltă. Dacă rețeaua de producție este disponibilă, atunci puteți accesa serverul, opri aplicația și închide OS-ul. Dacă nu este disponibilă, puteți accesa prin IPMI, opri aplicația și închide OS-ul. Dacă niciuna dintre rețele nu este disponibilă, nu puteți face nimic. „Mulțumesc, căpitane!”, veți gândi.
„Și, în general, e un pic prea multă agitație”, ați putea gândi și voi.
Ideea este că serverele, chiar și fără incendiu, generează o cantitate uriașă de căldură. Mai exact, când există răcire, ele generează căldură, iar când nu este, creează un iad termic care, în cel mai bun caz, va topi o parte din echipament și va opri o altă parte, iar în cel mai rău caz… va provoca un incendiu în sală, care va distruge practic totul.
15:39. Fixăm problemele cu baza de date conf.
Baza conf este backend-ul pentru serviciul omonim, care este utilizat de toate aplicațiile de producție pentru a modifica rapid setările. Fără această bază, nu putem gestiona funcționarea portalului, dar portalul în sine poate funcționa.
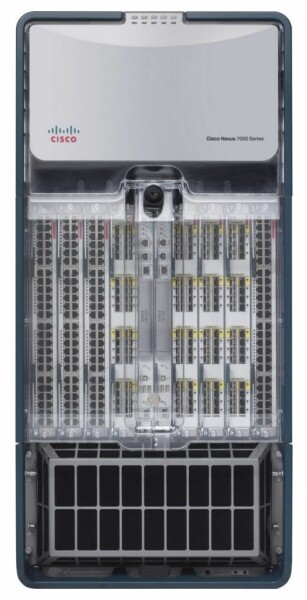
15:41. Senzorii de temperatură de pe echipamentele de rețea Core înregistrează valori apropiate de limitele admisibile. Este o cutie care ocupă un rack și asigură funcționarea tuturor rețelelor din interiorul centrului de date.
15:42. Issue tracker și wiki sunt inaccesibile, trecem pe standby.
Aceasta nu este producție, dar într-o urgență, accesibilitatea oricărei baze de cunoștințe poate fi critică.
15:50. Una dintre sistemele de monitorizare s-a oprit.
Sunt mai multe, fiecare responsabil cu diferite aspecte ale funcționării serviciilor. O parte dintre ele sunt configurate să funcționeze autonom în fiecare centru de date (adică monitorizează doar centrul lor de date), iar altele sunt compuse din componente distribuite, care pot supraviețui pierderii oricărui centru de date.
În acest caz, a încetat să funcționeze , care funcționează în modul master-standby. Am trecut pe standby.
Acceptare
15:51. Prin IPMI, am oprit fără a încheia corect activitatea tuturor serverelor, cu excepția MS SQL.
Sunteți pregătiți pentru gestionarea în masă a serverelor prin IPMI, dacă va fi necesar?
Exact momentul în care salvarea echipamentelor din centrul de date este completă în această etapă. Tot ce se putea face, s-a făcut. Unii colegi pot să se odihnească.
16:13. A fost raportat că țevile de freon de pe acoperiș s-au rupt—aceasta va amâna lansarea centrului de date după stingerea incendiului.
16:19. Conform datelor primite de la personalul tehnic al centrului de date, creșterea temperaturii în săli s-a oprit.
17:10. Funcționarea bazei conf a fost restabilită. Acum putem schimba setările aplicațiilor.
De ce este atât de important, dacă totul este redundat și funcționează chiar și fără un centru de date?
În primul rând, nu totul este redundant. Există diverse servicii secundare care momentan nu fac față bine la un eșec al centrului de date, iar unele baze sunt în modul master-standby. Capacitatea de a gestiona setările permite să facem tot ce este necesar pentru a minimiza impactul consecințelor accidentului asupra utilizatorilor, chiar și în condiții dificile.
În al doilea rând, a devenit clar că activitatea centrului de date nu va fi complet restabilită în următoarele ore, așa că era necesar să se ia măsuri pentru a preveni ca indisponibilitatea pe termen lung a replicilor să conducă la probleme suplimentare, cum ar fi umplerea discurilor în centrele de date rămase.
17:29. Este timpul pentru pizza! La noi lucrează oameni, nu roboți.
Reabilitare
18:02. Temperatura s-a stabilizat în sălile nr. 8 (a noastră), 9, 10 și 11. În una din cele care rămân oprite (nr. 7) se află echipamentele noastre, iar temperatura continuă să crească.
18:31. Am dat undă verde pentru pornirea echipamentului în sălile nr. 1 și 3—aceste săli nu au fost afectate de incendiu.
În prezent, se desfășoară pornirea serverelor în sălile nr. 1, 3, 8, începând cu cele mai critice. Se verifică corectitudinea funcționării tuturor serviciilor pornite. Există în continuare probleme cu sala nr. 7.
18:44. Personalul tehnic al centrului de date a descoperit că în sala nr. 7 (unde se află doar echipamentele noastre) multe servere nu sunt oprite. Conform datelor noastre, acolo rămân active 26 de servere. După o nouă verificare, descoperim 58 de servere.
20:18. Personalul tehnic al centrului de date ventilază aerul din sala fără aer condiționat prin conducte mobile, instalate prin coridoare.
23:08. Am trimis primul administrator acasă. Cineva trebuie să se odihnească noaptea pentru a continua lucrările mâine. Apoi, trimitem acasă și o parte din alți administratori și dezvoltatori.
02:56. Am pornit tot ce poate fi pornit. Facem o verificare amplă a tuturor serviciilor cu teste automate.
03:02. Aerul conditionat din sala 7, ultima, a fost restabilit.
03:36. Am adus fronturile în data center în rotație în DNS. De acum, începe să vină traficul utilizatorilor.
Dispersăm o mare parte din echipa de administratori acasă. Dar păstrăm câțiva oameni.
Un mic FAQ:
Î: Ce s-a întâmplat între 18:31 și 02:56?
R: Conform „Planului de acțiune în caz de urgență”, pornim toate serviciile, începând cu cele mai importante. În acest timp, coordonatorul din chat atribuie un serviciu administratorului disponibil, care verifică dacă OS-ul și aplicația s-au pornit corect, dacă nu sunt erori, dacă parametrii sunt normali. După finalizarea pornirii, el anunță în chat că este liber și primește de la coordonator un nou serviciu.
Procesul este suplimentar întârziat de echipamentele defecte. Chiar dacă oprirea OS-ului și închiderea serverelor s-au desfășurat corect, o parte din servere nu revin din cauza discurilor, memoriei sau carcaselor care au cedat brusc. În cazul pierderii alimentării, procentul de defecțiuni crește.
Î: De ce nu este posibil să pornim totul dintr-o dată și apoi să reparăm ce apare în monitorizare?
R: Totul trebuie făcut treptat, deoarece există dependențe între servicii. Iar verificarea ar trebui făcută din timp, fără a aștepta monitorizarea — deoarece problemele trebuie rezolvate imediat, fără a aștepta agravarea lor.
7:40. Ultimul administrator (coordonator) a plecat să doarmă. Lucrările primei zile s-au încheiat.
8:09. Primii dezvoltatori, ingineri din data center și administratori (inclusiv noul coordonator) au început lucrările de restaurare.
09:37. Am început ridicarea sălii nr. 7 (ultima).
În paralel, continuăm să restaurăm ceea ce nu am reușit să reparăm în celelalte săli: înlocuirea discurilor/memoriei/serverelor, repararea tuturor celor care „arde” în monitorizare, revenirea la schimbarea rolurilor în schemele master-standby și alte mici lucruri, care deși sunt multe, totuși sunt destul de numeroase.
17:08. Permit toate lucrările planificate cu producția.
21:45. Lucrările celei de-a doua zile s-au încheiat.
09:45. Astăzi este vineri. În monitorizare există în continuare destul de multe probleme minore. Ne așteaptă un weekend, tuturor ne place să ne odihnim. Continuăm să reparăm masiv tot ce se poate. Sarcinile administrative planificate au fost amânate. Avem un coordonator nou.
15:40. Într-o întorsătură neașteptată, jumătate din stiva de echipamente de rețea din ALT centru de date s-a restartat. Am scos din rotație frontend-urile pentru a minimiza riscurile. Nu există efecte pentru utilizatori. Mai târziu, s-a dovedit că a fost un șasiu defect. Coordonatorul lucrează la repararea a două avarii simultan.
17:17. Funcționarea rețelei în alt centru de date a fost restabilită, totul a fost verificat. Centrul de date a fost reintegrat în rotație.
18:29. Lucrările de recuperare de după avarie au fost finalizate.
Cuvânt înainte
04.04.2013, , „Odnoklassniki” — timp de trei zile, portalul a fost complet sau parțial inaccesibil. Pe parcursul acestei perioade, peste 100 de persoane din diferite orașe, din diferite companii (încă o dată, mulțumesc!), au reparat mii de servere, atât de la distanță, cât și direct în centrele de date, atât manual, cât și automat.
Am învățat lecțiile. Pentru a evita repetarea unei astfel de situații, am realizat și continuăm să desfășurăm lucrări ample.
Care sunt principalele diferențe între avaria curentă și cea 404?
- Am implementat un „Plan de acțiune în caz de avarie”. Odată pe trimestru, desfășurăm exerciții — simulăm o situație de avarie, pe care grupul de administratori (toți pe rând) trebuie să o elimine, folosind „Planul de acțiune în caz de avarie”. Administratorii principali își asumă pe rând rolul de coordonator.
- În fiecare trimestru, în mod experimental, izolăm centrele de date (toate pe rând) pe rețelele LAN și WAN, ceea ce permite identificarea în timp util a punctelor slabe.
- Până acum am avut mai puține discuri defecte, deoarece am strâns normele: ore de utilizare mai puține, valori limită mai stricte pentru S.M.A.R.T.
- Am abandonat complet BerkeleyDB — o bază de date veche și instabilă, care necesita mult timp pentru recuperare după restartul serverului.
- Am redus numărul de servere cu MS SQL și am diminuat dependența de cele rămase.
- Avem propriul nostru , în care migrăm activ toate serviciile de doi ani. Cloud-ul simplifică semnificativ întregul ciclu de lucru cu aplicația, iar în caz de avarie oferă instrumente unice, precum:
- oprirea corectă a tuturor aplicațiilor cu un singur clic;
- migrarea simplă a aplicațiilor de pe serverele defecte;
- lansarea automată, cu prioritate (în ordinea serviciilor) a întregului centru de date.
Incidentele descrise în acest articol au fost cele mai mari de la 404. Desigur, nu totul a mers perfect. De exemplu, în timp ce centrul de date afectat era inaccesibil, un disc de pe unul dintre servere a eșuat în alt centru de date, ceea ce a dus la faptul că doar una dintre cele trei replici din clusterul Cassandra a fost disponibilă, ceea ce a făcut ca 4,2% dintre utilizatorii aplicațiilor mobile să nu se poată conecta. În același timp, utilizatorii deja conectați au continuat să lucreze. În total, în urma incidentului, au fost identificate peste 30 de probleme – de la bug-uri banale până la deficiențe arhitecturale ale serviciilor.
Dar cea mai mare diferență între incidentul actual și cel din 404 este că, în timp ce noi remediem efectele incendiului, utilizatorii continuau să scrie mesaje și să facă apeluri video în , se jucau, ascultau muzică, își făceau cadouri, se uitau la videoclipuri, seriale și canale TV în , precum și să transmită în direct în .
Și cum vă desfășurați incidentele?
Sursa: habr.com
