

Un cuvânt introductiv scurt
Consider că am putea realiza un număr mai mare de sarcini dacă ne-ar fi oferite instrucțiuni pas cu pas care să ne spună ce și cum să facem. Îmi amintesc momente din viața mea când nu am putut începe o activitate din cauza că era pur și simplu dificil să înțeleg de unde să încep. Poate că, cu mult timp în urmă, ai văzut cuvintele „Data Science” pe internet și ai decis că ești prea departe de acest domeniu, iar oamenii care se ocupă cu asta sunt undeva departe, în altă lume. Dar nu este așa, ei sunt chiar aici. Și, poate, datorită celor din acest domeniu, un articol ți-a apărut în feed. Există multe cursuri care te pot ajuta să înveți acest meșteșug, iar eu te voi ajuta să faci primul pas.
Ei bine, ești pregătit? Voi spune din start că va trebui să știi Python 3, deoarece acesta îl voi folosi aici. De asemenea, îți recomand să instalezi Jupyter Notebook sau să vezi cum să folosești Google Colab.
Pasul întâi
Kaggle este un ajutor semnificativ în acest demers. În principiu, poți să te descurci și fără el, dar despre asta voi vorbi într-un articol viitor. Este o platformă unde sunt organizate competiții de Data Science. În fiecare competiție, la început, vei acumula o cantitate imensă de experiență în rezolvarea problemelor de diferite tipuri, dezvoltare și muncă în echipă, ceea ce este important în ziua de azi.
Vom prelua sarcina de acolo. Se numește: „Titanic”. Condiția este: să prezicem dacă fiecare individ va supraviețui. În general, sarcina cuiva care se ocupă de DS este colectarea de date, prelucrarea acestora, antrenarea modelului, prognoza și așa mai departe. Pe Kaggle, ni se permite să sărim peste etapa de colectare a datelor — acestea sunt disponibile pe platformă. Trebuie doar să le descărcăm și putem începe lucrul!
Se poate face astfel:
în tab-ul Data sunt fișierele în care se află datele


Am descărcat datele, am pregătit notele noastre Jupyter și…
Pasul al doilea
Cum putem acum să descărcăm aceste date?
În primul rând, vom importa bibliotecile necesare:
import pandas as pd
import numpy as np
Pandas ne va permite să descărcăm fișiere .csv pentru prelucrarea ulterioară.
Numpy este necesar pentru a reprezenta tabelul nostru de date sub formă de matrice cu numere.
Să continuăm. Vom lua fișierul train.csv și îl vom descărca:
dataset = pd.read_csv('train.csv')
Vom vom indica că vom face referire la setul nostru de date train.csv prin intermediul variabilei dataset. Să vedem ce conține:
dataset.head()
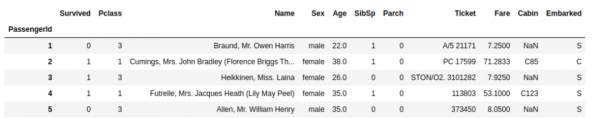
Funcția head() ne permite să vizualizăm primele câteva rânduri ale dataframe-ului.
Coloana Survived reprezintă exact rezultatele noastre care sunt cunoscute în acest dataframe. În ceea ce privește sarcina, trebuie să prezicem coloana Survived pentru datele din test.csv. Aceste date conțin informații despre alți pasageri ai Titanicului, pentru care, noi, cei care rezolvăm sarcina, nu cunoaștem rezultatele.
Așadar, să împărțim tabelul nostru în date dependente și independente. Aici e totul simplu. Datele dependente sunt acele date care depind de cele independente, adică de rezultatele obținute. Datele independente sunt acele date care influențează rezultatul.
De exemplu, avem un astfel de set de date:
"Vova a învățat informatica — nu.
Vova a obținut 2 la informatică."
Nota la informatică depinde de răspunsul la întrebarea: a învățat Vova informatica? Clar? Să continuam, suntem deja mai aproape de țintă!
Variabila tradițională pentru datele independente este X. Pentru cele dependente — y.
Facem următoarele:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Ce este asta? Funcția iloc[:, 2:] îi spune lui Python: vreau să văd în variabila X datele care încep cu a doua coloană (inclusiv, cu condiția că numărătoarea începe de la zero). În a doua linie spunem că vrem să vedem în y datele din prima coloană.
[ a:b, c:d ] — aceasta este construcția pe care o folosim în paranteze. Dacă nu specificăm anumite variabile, acestea vor rămâne implicite. Adică putem specifica [:,: d] și astfel vom obține în dataframe toate coloanele, cu excepția celor care încep cu numărul d și mai departe. Variabilele a și b definesc rândurile, dar avem nevoie de toate, așa că lăsăm implicit.
Să vedem ce am obținut:
X.head() 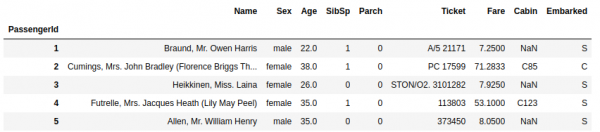
y.head() 
Pentru a simplifica această mică lecție, vom elimina coloanele care necesită o „îngrijire” specială, sau care nu influențează deloc supraviețuirea. Acestea conțin date de tip str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Să trecem la pasul următor.
Pasul trei
Aici va trebui să codificăm datele noastre, astfel încât mașina să înțeleagă mai bine cum aceste date influențează rezultatul. Dar vom codifica doar datele de tip str pe care le-am păstrat. Coloana „Sex”. Cum dorim să codificăm? Să ne imaginăm datele despre sexul unei persoane ca un vector: 10 — sex masculin, 01 — sex feminin.
Pentru început, să transformăm tabelele noastre într-o matrice NumPy:
X = np.array(X)
y = np.array(y)
Și acum să ne uităm:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Biblioteca sklearn este o bibliotecă fantastică care ne permite să realizăm o muncă completă în Data Science. Aceasta conține o mulțime de modele interesante de învățare automată și ne permite, de asemenea, să ne ocupăm de pregătirea datelor.
OneHotEncoder ne va permite să codificăm sexul unei persoane în formatul pe care l-am descris. Vor fi create 2 clase: masculin, feminin. Dacă persoana este bărbat, atunci în coloana „masculin” va fi scris 1, iar în „feminin”, respectiv, 0.
După OneHotEncoder() se află [1] — aceasta înseamnă că dorim să codificăm coloana numărul 1 (numărarea începe de la zero).
Super. Să avansăm mai departe!
De obicei, se întâmplă ca unele date să rămână necompletate (adică NaN — not a number). De exemplu, există informații despre o persoană: numele, sexul. Dar datele despre vârsta sa lipsesc. În acest caz, vom aplica o metodă: vom găsi media aritmetică pe toate coloanele și, dacă unele date dintr-o coloană sunt omise, vom completa vidul cu media aritmetică.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Și acum să luăm în considerare că se întâmplă situații în care datele sunt foarte dispersate. Unele date se află în intervalul [0:1], iar altele pot ajunge la sute și mii. Pentru a exclude această dispersie și pentru ca computerul să fie mai precis în calcule, vom scala datele, le vom dimensiona. Să facem ca toate numerele să nu depășească trei. Pentru aceasta, vom utiliza funcția StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Acum datele noastre arată astfel:

Clasă. Suntem deja aproape de obiectivul nostru!
Pasul patru
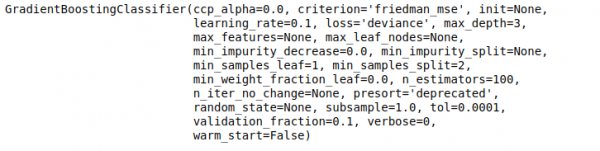
Să ne învățăm primul model! Din biblioteca sklearn, putem găsi o mulțime de informații interesante. Am aplicat pentru această sarcină modelul Gradient Boosting Classifier. Folosim un classifier deoarece sarcina noastră este o sarcină de clasificare. Trebuie să prognozăm dacă o persoană a supraviețuit (1) sau nu (0).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funcția fit îi spune lui Python: Să lase modelul să caute dependențele între X și y.
În mai puțin de o secundă, modelul este gata.
Cum să îl aplicăm? Acum vom vedea!
Pasul cinci. Concluzie
Acum trebuie să încărcăm tabelul cu datele noastre de testare pentru care trebuie să facem prognoza. Cu acest tabel vom urma aceleași etape ca și pentru X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Să aplicăm deja modelul nostru!
gbc_predict = gbc.predict(X_test)
Totul. Am realizat prognoza. Acum trebuie să o scriem în csv și să o trimitem pe site.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Gata. Am obținut un fișier care conține predicțiile pentru fiecare pasager. Rămâne să încărcăm aceste soluții pe site și să obținem evaluarea prognozei. Această soluție simplă oferă nu doar 74% răspunsuri corecte în public, ci și un impuls în Data Science. Cei mai curioși pot să îmi scrie oricând în mesajele personale pentru a pune întrebări. Mulțumesc tuturor!
Sursa: habr.com
