

Salut, Habr!
În lumina evenimentelor curente cauzate de coronavirus, o serie de servicii internet au început să primească o încărcătură crescută. De exemplu, , deoarece nu erau suficiente resurse. Și de cele mai multe ori nu poți accelera un server doar prin adăugarea de hardware mai puternic, însă trebuie să gestionezi cererile clienților (sau aceștia vor merge la concurență).
În acest articol, voi prezenta pe scurt practici populare care vor permite crearea unui serviciu rapid și rezistent la erori. Totuși, din schemele posibile de dezvoltare, am selectat doar acele metode ușor de utilizat. Pentru fiecare punct, aveți fie biblioteci gata pregătite, fie soluții disponibile prin platforme cloud.
Scalare orizontală
Cel mai simplu și cunoscut punct. Schematic, cele două metode cele mai frecvente de distribuire a sarcinii sunt scalarea orizontală și verticală. permiți serviciilor să funcționeze în paralel, distribuind astfel sarcina între ele. comanzi servere mai puternice sau îți optimizezi codul.
Pentru exemplu, voi lua un spațiu de stocare în cloud abstract, adică un analog al OwnCloud, OneDrive etc.
Imaginea standard a unei astfel de scheme este prezentată mai jos, dar aceasta demonstrează doar complexitatea sistemului. Trebuie să găsim o modalitate de a sincroniza serviciile. Ce se întâmplă dacă un utilizator salvează un fișier de pe tabletă și apoi vrea să-l vizualizeze pe telefon?
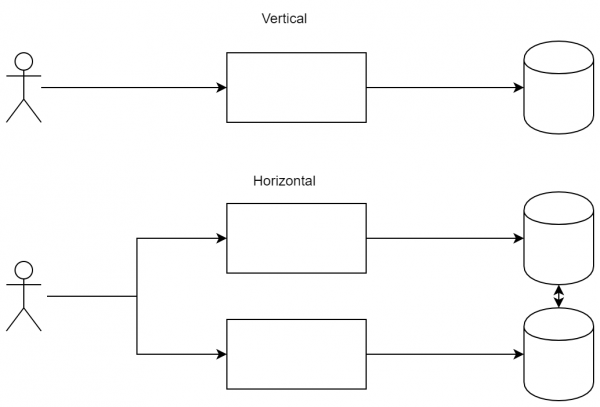
Diferența dintre abordări: în scalarea verticală suntem pregătiți să creștem puterea nodurilor, iar în scalarea orizontală – să adăugăm noduri noi pentru a distribui sarcina.
CQRS
este un tipar destul de important, deoarece permite diferitelor clienți să se conecteze nu doar la servicii diferite, ci și să primească fluxuri de evenimente identice. Beneficiile sale nu sunt atât de evidente pentru o aplicație simplă, totuși, este extrem de important (și simplu) pentru un serviciu saturat. Conceptul său: fluxurile de date de intrare și ieșire nu trebuie să se intersece. Aceasta înseamnă că nu poți trimite o cerere și aștepta un răspuns, în schimb trimiteți o cerere la serviciul A, dar primești un răspuns la serviciul B.
Primul avantaj al acestei abordări este capacitatea de a întrerupe conexiunea (în sens larg) în timpul executării unei cereri de lungă durată. Ca exemplu, să luăm o secvență mai mult sau mai puțin standard:
- Clientul a trimis o cerere serverului.
- Serverul a început prelucrarea îndelungată.
- Serverul a răspuns clientului cu rezultatul.
Să presupunem că la punctul 2 a avut loc o întrerupere a conexiunii (sau rețeaua s-a reconectat, sau utilizatorul a navigat pe o altă pagină, întrerupând conexiunea). În acest caz, serverului îi va fi greu să trimită răspunsul utilizatorului cu informații despre ce a fost procesat. Aplicând CQRS, secvența va fi puțin diferită:
- Clientul s-a abonat la actualizări.
- Clientul a trimis o cerere serverului.
- Serverul a răspuns „cerere acceptată”.
- Serverul a trimis rezultatul prin canalul din punctul „1”.
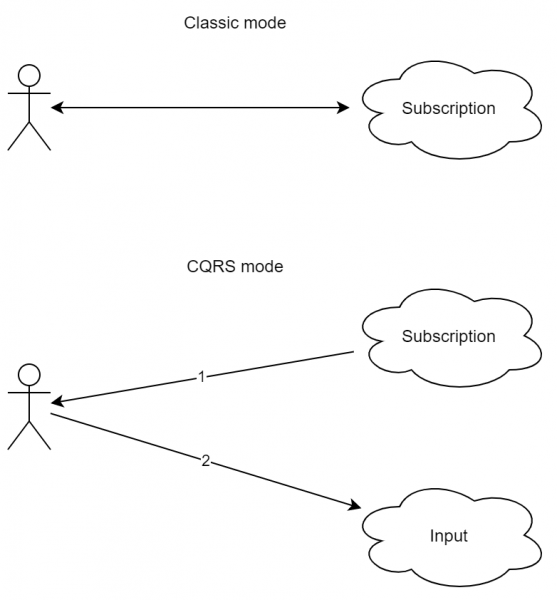
După cum se poate observa, schema este puțin mai complexă. Mai mult, abordarea intuitivă request-response lipsește aici. Cu toate acestea, după cum se poate observa, o întrerupere a conexiunii în timpul procesării cererii nu va duce la o eroare. Mai mult, dacă utilizatorul este într-adevăr conectat la serviciu de pe mai multe dispozitive (de exemplu, de pe telefonul mobil și de pe tabletă), răspunsul poate fi trimis pe ambele dispozitive.
Ce este interesant, este că codul de prelucrare a mesajelor de intrare devine similar (nu 100%) atât pentru evenimentele afectate de client, cât și pentru celelalte evenimente, inclusiv cele de la alți clienți.
Cu toate acestea, în realitate obținem bonusuri suplimentare datorită faptului că fluxul unidirecțional poate fi procesat în stil funcțional (folosind RX și analogii). Aceasta este o mare realizare, deoarece, în esență, aplicația poate deveni complet reactivă, cu aplicarea abordării funcționale. Pentru aplicațiile complexe, aceasta poate economisi semnificativ resurse în dezvoltare și întreținere.
Dacă combinăm această abordare cu scalarea orizontală, atunci ca bonus obținem capacitatea de a trimite cereri la un server, dar a primi răspunsuri de la altul. Astfel, clientul poate alege serviciul care îi este convenabil, iar sistemul intern va putea totuși să proceseze corect evenimentele.
Event Sourcing
După cum știți, una dintre caracteristicile principale ale unui sistem distribuit este lipsa unui timp comun și a unei secțiuni critice comune. Pentru un singur proces, puteți realiza sincronizarea (pe aceleași mutexuri), în care sunteți sigur că nimeni altcineva nu execută acest cod. Totuși, pentru un sistem distribuit, aceasta este periculoasă, deoarece va necesita overhead, iar toată frumusețea scalabilității va fi anulată — în orice caz, toate componentele vor aștepta una.
Așadar, ajungem la un fapt important — un sistem distribuit rapid nu poate fi sincronizat, deoarece ne va reduce performanța. Pe de altă parte, de multe ori avem nevoie de o anumită coerență a componentelor. Și pentru asta putem folosi abordarea cu , unde se garantează că, în absența modificărilor datelor, după un anumit interval de timp de la ultima actualizare („în cele din urmă”), toate solicitările vor returna ultima valoare actualizată.
Este important să înțelegem că pentru bazele de date clasice se aplică destul de des , unde fiecare nod deținea aceeași informație (acest lucru se obține de obicei atunci când tranzacția este considerată stabilită doar după ce primește un răspuns de la al doilea server). Aici există anumite relaxări din cauza nivelurilor de izolare, totuși esența generală rămâne aceeași — puteți trăi într-o lume complet coerentă.
Dar să ne întoarcem la problema inițială. Dacă o parte a sistemului poate fi construită cu , atunci se poate construi următoarea schemă.
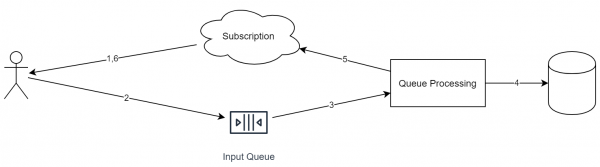
Caracteristicile importante ale acestei abordări:
- Fiecare solicitare primită este plasată într-o coadă.
- În procesul de procesare a solicitării, serviciul poate, de asemenea, să plaseze sarcini în alte cozi.
- Fiecare eveniment primit are un identificator (care este necesar pentru deduplicare).
- Coadă funcționează ideologic pe principiul "append only". Elemente din ea nu pot fi eliminate sau repoziționate.
- Coadă funcționează pe principiul FIFO (îmi pare rău pentru tautologie). Dacă este necesară executarea paralelă, atunci trebuie să rearanjați obiectele în diferite cozi în unul dintre etape.
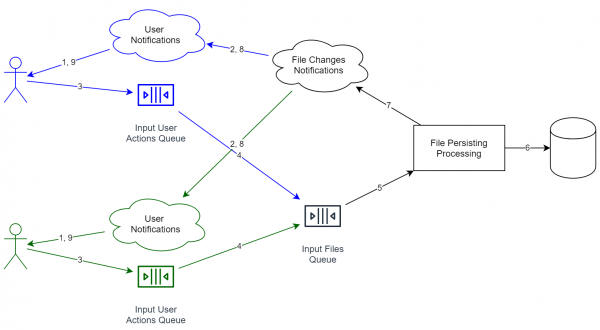
Îmi amintesc că discutăm despre cazul unui stocare online a fișierelor. În acest caz, sistemul va arăta, aproximativ, astfel:
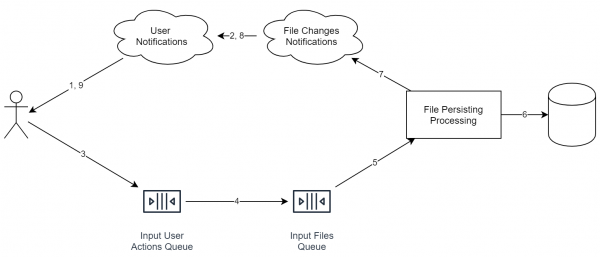
Este important de știut că serviciile din diagramă nu semnifică neapărat un server separat. Chiar dacă procesul poate fi același. Ce este esențial este că, ideologic, aceste lucruri sunt separate astfel încât să permită o scalare orizontală ușoară.
Iar pentru doi utilizatori, schema va arăta astfel (serviciile destinate diferitelor utilizatori sunt marcate cu culori diferite):
Beneficiile unei astfel de combinații:
- Serviciile pentru procesarea informațiilor sunt separate. Cozile sunt, de asemenea, separate. Dacă va fi necesar să creștem capacitatea de procesare a sistemului, tot ce trebuie să facem este să lansăm mai multe servicii pe un număr mai mare de servere.
- Când primim informații de la utilizator, nu trebuie neapărat să așteptăm finalizarea completă a salvării datelor. Dimpotrivă, este suficient să răspundem „ok”, iar apoi să începem să lucrăm treptat. De asemenea, coada atenuează vârfurile, deoarece adăugarea unui nou obiect se face rapid, iar utilizatorul nu trebuie să aștepte întregul ciclu.
- Ca exemplu, am adăugat un serviciu de deduplicare, care încearcă să unească fișierele identice. Dacă acesta funcționează mult timp în 1% din cazuri, clientul aproape că nu va observa (vezi mai sus), ceea ce este un mare avantaj, deoarece nu mai este necesară o viteză și o fiabilitate de 100%.
Cu toate acestea, se pot observa și dezavantajele:
- Sistemul nostru a pierdut coerența strictă. Asta înseamnă că, de exemplu, dacă ne abonăm la servicii diferite, teoretic putem obține stări diferite (deoarece unul dintre servicii poate să nu reușească să primească notificarea din coada internă). Ca un alt efect, sistemul nu mai are un timp comun. Asta înseamnă că nu putem, de exemplu, să sortăm toate evenimentele pur și simplu după timpul de sosire, deoarece ceasurile dintre servere pot să nu fie sincronizate (mai mult, a avea aceeași oră pe două servere este o utopie).
- Niciun eveniment nu poate fi acum pur și simplu inversat (așa cum s-ar putea face cu o bază de date). În schimb, este necesar să adăugăm un nou eveniment — , care va schimba ultima stare în cea necesară. Ca exemplu dintr-o zonă similară: fără reînscrierea istoricului (ceea ce este rău în unele cazuri) în git nu se poate inversa un commit, însă se poate realiza un , care de fapt va returna pur și simplu starea anterioară. Totuși, istoricul va păstra atât commit-ul greșit, cât și rollback-ul.
- Schema de date se poate schimba de la o versiune la alta, totuși evenimentele vechi nu pot fi actualizate la noul standard (deoarece, în principiu, evenimentele nu pot fi modificate).
După cum se poate observa, Event Sourcing se integrează excelent cu CQRS. Mai mult, implementarea unui sistem cu cozi eficiente și confortabile, dar fără separarea fluxurilor de date, este deja de la sine complicată, deoarece va trebui să adăugăm puncte de sincronizare care vor anula întregul efect pozitiv al cozilor. Aplicând ambele abordări simultan, este necesară o mică ajustare a codului funcționării programei. În cazul nostru, când trimitem un fișier pe server, răspunsul returnat este doar “ok”, ceea ce înseamnă doar că “operațiunea de adăugare a fișierului a fost salvată”. Formal, aceasta nu înseamnă că datele sunt deja disponibile pe alte dispozitive (de exemplu, serviciul de deduplicare poate reconstrui indexul). Totuși, după un timp, clientul va primi o notificare de tip “fișierul X a fost salvat”.
Ca rezultat:
- Numărul statutelor de trimitere a fișierelor crește: în loc de clasicul “fișier trimis”, obținem două: “fișier adăugat în coada serverului” și “fișier salvat în stocare”. Ultimul înseamnă că alte dispozitive pot începe deja să primească fișierul (cu observația că cozile funcționează cu viteze diferite).
- Din cauza faptului că informațiile despre trimitere vin acum prin diferite canale, trebuie să găsim soluții pentru a obține statutul prelucrării fișierului. Drept urmare: spre deosebire de clasicul request-response, clientul poate fi repornit în timpul prelucrării fișierului, totuși statutul acestei prelucrări va fi corect. De fapt, acest punct funcționează, în esență, din cutie. Ca urmare: suntem acum mai toleranți la erori.
Sharding
După cum s-a menționat mai sus, în sistemele cu event sourcing nu există o consistență strictă. Asta înseamnă că putem folosi mai multe stocări fără nicio sincronizare între ele. Apropiindu-ne de sarcina noastră, putem:
- Separarea fișierelor pe tipuri. De exemplu, imaginile/video pot fi decodificate și selectate într-un format mai eficient.
- Separarea conturilor pe țări. Din cauza multor legislații, asta poate fi necesar, însă această schemă arhitecturală oferă această posibilitate în mod automat.
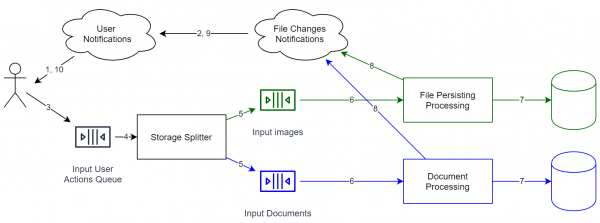
Dacă doriți să transferați date de la un stoc la altul, atunci aici nu se poate folosi soluția standard. Din păcate, în acest caz, este necesar să opriți coada, să faceți migrarea și apoi să o reporniți. În general, datele nu pot fi transferate „în zbor”, totuși, dacă coada evenimentelor este complet stocată, și aveți copii ale stărilor anterioare ale stocului, putem repara evenimentele astfel:
- În Event Source, fiecare eveniment are un identificator (ideal - unul care nu scade). Astfel, în stoc, putem adăuga un câmp - id-ul ultimului element procesat.
- Duplicăm coada, astfel încât toate evenimentele să poată fi procesate pentru mai multe stocuri independente (primul este cel în care datele sunt deja stocate, iar al doilea este nou, însă momentan gol). A doua coadă, evident, nu este încă procesată.
- Lansăm a doua coadă (adică începem reintroducerea evenimentelor).
- Când noua coadă va fi relativ goală (adică diferența medie în timp între adăugarea unui element și extragerea acestuia va fi acceptabilă), putem începe să comutăm cititorii pe noul stoc.
Așa cum se vede, sistemul nostru nu a avut și nu are o coerență strictă. Există doar coerență eventuală, ceea ce înseamnă că evenimentele sunt procesate în aceeași ordine (însă, posibil, cu întârziere diferită). Și, folosind asta, putem transfera datele relativ ușor fără a opri sistemul dintr-un capăt al lumii în altul.
Astfel, continuând exemplul nostru despre stocarea online a fișierelor, această arhitectură ne oferă deja o serie de bonusuri:
- Putem muta obiecte mai aproape de utilizatori, într-un mod dinamic. Astfel, putem îmbunătăți calitatea serviciului.
- Putem stoca o parte din date în interiorul companiilor. De exemplu, utilizatorii Enterprise solicită adesea să își stocheze datele în centre de date controlate (pentru a evita scurgerile de date). Prin sharding, putem susține ușor acest lucru. Și sarcina devine și mai simplă dacă clientul are un cloud compatibil (de exemplu, ).
- Cel mai important este că nu suntem obligați să facem asta. De fapt, la început ne-ar ajunge un singur depozit pentru toate conturile (pentru a începe rapid lucrul). O caracteristică cheie a acestui sistem este că, deși este extins, la etapa inițială este suficient de simplu. Pur și simplu nu trebuie să scriem din prima cod care lucrează cu milioane de cozi independente etc. Dacă va fi necesar, acest lucru poate fi realizat în viitor.
Găzduire de conținut static
Acest punct poate părea evident, dar este totuși necesar pentru o aplicație standard cu o încărcare mai mare. Esența sa este simplă: tot conținutul static este livrat nu de pe acelasi server cu aplicația, ci de pe servere dedicate în acest scop. Ca urmare, aceste operații se desfășoară mai repede (de exemplu, nginx livrează fișierele mai rapid și mai eficient decât un server Java). În plus, arhitectura CDN () permite plasarea fișierelor noastre mai aproape de utilizatorii finali, ceea ce îmbunătățește experiența de utilizare a serviciului.
Cel mai simplu și standard exemplu de conținut static este un set de scripturi și imagini pentru un site. Este simplu — acestea sunt cunoscute dinainte, apoi arhiva este încărcată pe serverele CDN, de unde sunt livrate utilizatorilor finali.
Cu toate acestea, în practică, pentru conținutul static se poate aplica o abordare similară arhitecturii lambda. Să ne întoarcem la sarcina noastră (depozitul online de fișiere), în care trebuie să livrăm fișiere utilizatorilor. Cea mai simplă soluție ar fi să facem un serviciu care, pentru fiecare cerere a utilizatorului, face toate verificările necesare (autorizare etc.), și apoi descarcă fișierul direct de la depozitul nostru. Principalul dezavantaj al acestei abordări este că conținutul static (iar un fișier cu o revizie specifică este, în esență, conținut static) este livrat de același server care conține logica de afaceri. În loc de aceasta, putem crea următoarea schemă:
- Serverul oferă un URL pentru descărcare. Acesta poate fi în forma file_id + key, unde key este o semnătură digitală minimă care oferă dreptul de acces la resursă timp de aproape o zi.
- Livrarea fișierelor este gestionată de un simplu nginx cu următoarele opțiuni:
- Cache-ul de conținut. Deoarece acest serviciu poate fi pe un server separat, ne-am lăsat o rezervă pentru viitor, având posibilitatea de a stoca toate fișierele descărcate recent pe disc.
- Verificarea cheii în momentul creării conexiunii
- Opțional: procesarea de conținut în flux. De exemplu, dacă comprimăm toate fișierele în serviciu, putem efectua dezirhivarea direct în acest modul. Ca urmare: operațiile IO sunt realizate acolo unde li se potrivesc cel mai bine. Un arhivator pe Java va consuma multă memorie suplimentară, dar rescrierea serviciului cu logica de afaceri în Rust/C++ ar putea fi, de asemenea, ineficientă. În cazul nostru, se folosesc procese diferite (sau chiar servicii), astfel încât logica de afaceri și operațiile IO pot fi separate destul de eficient.
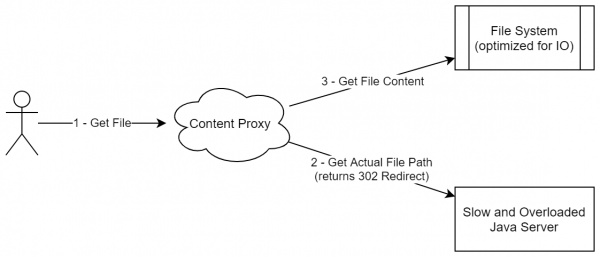
Această schemă nu seamănă foarte mult cu livrarea conținutului static (deoarece nu descargăm întregul pachet de statice undeva), dar în realitate, această abordare se ocupă de livrarea datelor imuabile. Mai mult, această schemă poate fi generalizată pentru alte cazuri, când conținutul nu este doar static, ci poate fi reprezentat ca un set de blocuri imuabile și nedepășite (deși pot fi adăugate).
Ca un alt exemplu (pentru a întări ideea): dacă ați lucrat cu Jenkins/TeamCity, știți că ambele soluții sunt scrise în Java. Ambele reprezintă un proces Java care se ocupă atât cu orchestrarea construcțiilor, cât și cu gestionarea conținutului. În special, ambele au sarcini de tip "transmite fișier/carte de la server". De exemplu: livrarea artefactelor, transmiterea codului sursă (când agentul nu descarcă direct codul din depozit, ci o face serverul), accesul la jurnale. Toate aceste sarcini diferă în ceea ce privește încărcătura pe IO. Așadar, serverul responsabil pentru logica de afaceri complexă trebuie, de asemenea, să fie capabil să împingă eficient fluxuri mari de date. Și ceea ce este cel mai interesant, o astfel de operație poate fi delegată aceluiași nginx exact în aceeași schemă (cu excepția faptului că în cerere ar trebui adăugat cheia de date).
Totuși, dacă ne întoarcem la sistemul nostru, rezultă o schemă similară:
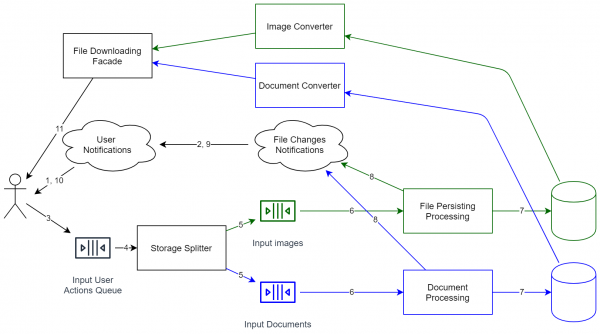
După cum se poate observa, sistemul s-a complicat radical. Acum nu este doar un mini-proces care stochează fișiere local. Acum este necesară o susținere mai complexă, controlul versiunilor API etc. De aceea, după ce toate diagramele sunt desenate, este cel mai bine să evaluăm în detaliu dacă scalabilitatea implică astfel de costuri. Totuși, dacă doriți să aveți posibilitatea de a extinde sistemul (inclusiv pentru a lucra cu un număr și mai mare de utilizatori), va trebui să luați astfel de decizii. Din fericire, ca rezultat, arhitectura sistemului este pregătită pentru creșterea încărcăturii (practic fiecare componentă poate fi clonată pentru scalarea orizontală). Sistemul poate fi actualizat fără a fi oprit (doar anumite operațiuni se vor încetini ușor).
Așa cum am menționat la început, acum o serie de servicii online au început să suporte o încărcătură crescută. Și unele dintre ele pur și simplu au început să nu funcționeze corect. Practic, sistemele au cedat exact în momentul în care afacerea ar fi trebuit să genereze venituri. Asta înseamnă că, în loc de livrări amânate, în loc de a oferi clienților „planificați livrările pentru lunile următoare”, sistemul a spus pur și simplu „mergeți la concurenți”. Aceasta este, de fapt, prețul unei performanțe scăzute: pierderile vor apărea exact atunci când profitul ar fi fost cel mai mare.
Concluzie
Toate aceste abordări au fost cunoscute și anterior. De exemplu, VK utilizează de mult timp ideea de Hosting pentru Conținut Static pentru a livra imagini. O mulțime de jocuri online folosesc schema de Sharding pentru a împărți jucătorii pe regiuni sau pentru a separa locațiile de joc (dacă lumea este unitară). Abordarea Event Sourcing este utilizată activ în e-mail. Majoritatea aplicațiilor traderilor, unde datele sosesc continuu, sunt de fapt construite pe abordarea CQRS pentru a avea capacitatea de a filtra datele primite. Iar scalarea orizontală este utilizată de mult timp în multe servicii.
Însă, ceea ce este cel mai important, toate aceste modele au devenit foarte ușor de aplicat în aplicațiile moderne (dacă sunt adecvate, desigur). Cloud-urile oferă Sharding și scalare orizontală imediat, ceea ce este mult mai simplu decât să comanzi servere dedicate în centre de date diferite de unul singur. CQRS a devenit mult mai simplu, cel puțin datorită dezvoltării bibliotecilor, cum ar fi RX. Cu 10 ani în urmă, un site web rar ar fi putut să susțină așa ceva. Event Sourcing se configurează de asemenea incredibil de ușor datorită containerelor deja pregătite cu Apache Kafka. Acum 10 ani, acest lucru ar fi fost o inovație, iar acum este o normalitate. La fel și cu Static Content Hosting: datorită tehnologiilor mai convenabile (inclusiv pentru că există documentație detaliată și o bază mare de răspunsuri), o astfel de abordare a devenit și mai simplă.
Ca urmare, implementarea unei serii de modele arhitecturale destul de complexe a devenit acum mult mai ușoară, ceea ce înseamnă că ar trebui să fie luată în considerare din timp. Dacă într-o aplicație de acum zece ani s-a renunțat la una dintre soluțiile de mai sus din cauza costurilor ridicate de implementare și întreținere, acum, în noua aplicație, sau după o refactorizare, se poate crea un serviciu care arhitectural va fi atât scalabil (din punct de vedere al performanței), cât și pregătit pentru cerințe noi din partea clienților (de exemplu, pentru localizarea datelor personale).
Și cel mai important: nu folosiți, vă rog, aceste abordări dacă aveți o aplicație simplă. Da, sunt frumoase și interesante, însă pentru un site cu un vârf de 100 de vizitatori, adesea se poate miza pe un monolit clasic (cel puțin din exterior, în interior totul poate fi spart în module etc.).
Sursa: habr.com
