

Netflix — liderul pieței de televiziune online — compania care a creat și dezvoltă activ acest segment. Netflix este cunoscut nu doar pentru catalogul extins de filme și seriale, disponibile din aproape orice colț al lumii și de pe orice dispozitiv cu ecran, ci și pentru infrastructura sa fiabilă și cultura inginerie unică.
Un exemplu clar al abordării Netflix în dezvoltarea și întreținerea sistemelor complexe a fost prezentat la DevOops 2019 — director de dezvoltare la Netflix. Absolvent al facultății de matematică și informatică a Universității NNGU numită după Lobacevski, Sergei este unul dintre primii ingineri din Open Connect — echipa CDN de la Netflix. El a construit sisteme de monitorizare și analiză a datelor video, a lansat serviciul popular pentru evaluarea vitezei conexiunii la internet FAST.com și în ultimii ani a lucrat la optimizarea cererilor pe internet, astfel încât aplicația Netflix să funcționeze cât mai repede pentru utilizatori.
Prezentarea a primit cele mai bune recenzii din partea participanților la conferință, și am pregătit pentru voi versiunea text a acesteia.
În prezentare, Sergei a discutat în detaliu
- despre ce influențează întârzierea cererilor pe internet între client și server;
- cum să reduci această întârziere;
- cum să proiectezi, întreții și monitorizezi sisteme rezistente la erori;
- cum să atingi rezultate într-un timp scurt, cu un risc minim pentru afacere;
- cum să analizezi rezultatele și să înveți din greșeli.
Răspunsurile la aceste întrebări sunt necesare nu doar celor care lucrează în mari corporații.
Principiile și tehnicile prezentate ar trebui să fie cunoscute și aplicate de către oricine dezvoltă și întreține produse online.
În continuare — povestea din perspectiva vorbitorului.
Importanța vitezei internetului
Viteza cererilor pe internet este direct legată de afaceri. Să luăm în considerare domeniul comerțului online: compania Amazon în 2009 , că o întârziere de 100 ms duce la pierderi de 1% din vânzări.
Tot mai multe dispozitive mobile apar, iar odată cu ele, tot mai multe site-uri și aplicații mobile. Dacă pagina ta se încarcă mai lent de 3 secunde, pierzi aproximativ jumătate din utilizatori. Din , Google ia în considerare viteza de încărcare a paginii tale în rezultatele căutării: cu cât pagina se încarcă mai repede, cu atât poziția ei în Google este mai bună.
Viteza conexiunii este, de asemenea, importantă și în organizațiile financiare, unde întârzierea este critică. În 2015, compania Hibernia Networks o cablare între New York și Londra, cu un cost de 400 de milioane de dolari, pentru a reduce latența între orașe cu 6 ms. Imaginați-vă, 66 de milioane de dolari pentru o reducere de 1 ms a latenței!
Conform , viteza de conexiune de peste 5 Mbit/s încetează să mai influențeze direct viteza de încărcare a unui site web tipic. Totuși, între latența conexiunii și viteza de încărcare a paginii există o dependență liniară:
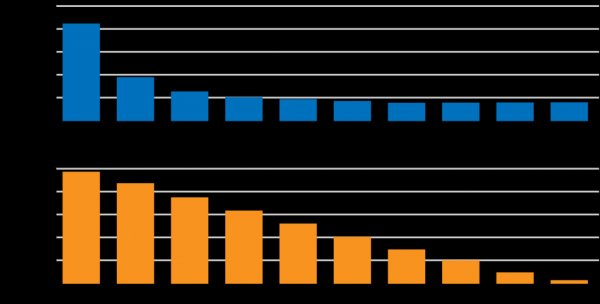
Cu toate acestea, Netflix nu este un produs tipic. Impactul latenței și vitezei asupra utilizatorului este un domeniu activ de analiză și dezvoltare. Există încărcarea aplicației și selectarea conținutului, care depind de latență, dar încărcarea elementelor statice și streaming-ul depind și de viteza conexiunii. Analiza și optimizarea factorilor cheie care influențează calitatea serviciului pentru utilizator sunt domenii active de dezvoltare pentru mai multe echipe din Netflix. Una dintre sarcini este reducerea latenței cererilor între dispozitivele Netflix și infrastructura cloud.
În această prezentare ne vom concentra pe reducerea latenței în contextul infrastructurii Netflix. Vom examina din punct de vedere practic cum să abordăm procesele de proiectare, dezvoltare și operare ale sistemelor distribuite complexe și cum să investim timp în inovații și rezultate, nu în diagnosticarea problemelor operaționale și a defecțiunilor.
În interiorul Netflix
Mii de dispozitive diferite suportă aplicațiile Netflix. Dezvoltarea acestora este responsabilitatea a patru echipe diferite, care creează versiuni separate ale clientului pentru Android, iOS, TV și browserele web. Investim foarte mult efort pentru a îmbunătăți și personaliza interfața utilizatorului. Pentru aceasta, desfășurăm sute de teste A/B în paralel.
Personalizarea este susținută de sute de microservicii în cloud-ul AWS, care oferă date personalizate pentru utilizatori, gestionarea cererilor, telemetrie, Big Data și Encoding. Vizualizarea traficului arată astfel:
În stânga se află entry point-ul, iar apoi traficul este distribuit între sute de microservicii, care sunt susținute de echipe backend diferite.
Un alt component important al infrastructurii noastre este Open Connect CDN, care livrează conținut static - videoclipuri, imagini, cod pentru clienți etc. CDN-ul este amplasat pe servere personalizate (OCA - Open Connect Appliance). În interior se află array-uri de SSD-uri și HDD-uri, gestionate de FreeBSD optimizat, cu NGINX și un set de servicii. Proiectăm și optimizăm componentele hardware și software astfel încât acest server CDN să poată trimite cât mai multe date utilizatorilor.
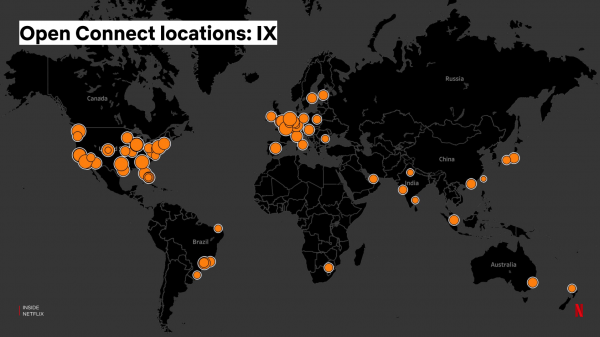
„Zidul” acestor servere la punctul de schimb de trafic internet (Internet eXchange - IX) arată astfel:
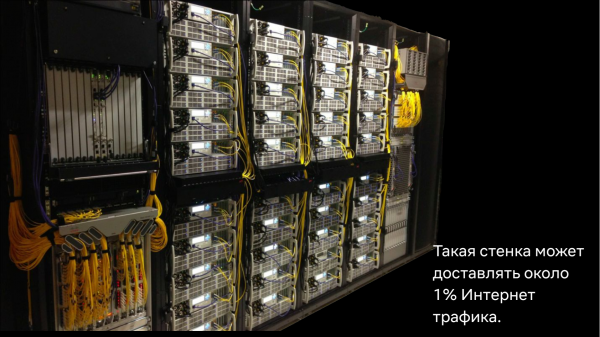
Internet Exchange oferă posibilitatea furnizorilor de internet și furnizorilor de conținut să se „conecteze” unii la alții pentru un schimb de date mai direct pe internet. În întreaga lume sunt aproximativ 70-80 de puncte Internet Exchange, unde sunt instalate serverele noastre, iar noi ne ocupăm în mod autonom de instalarea și întreținerea acestora:
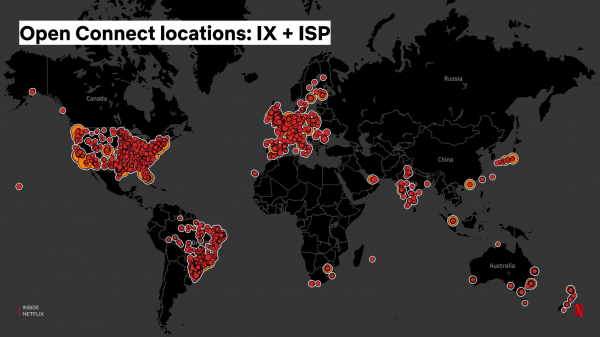
În plus, furnizăm servere direct furnizorilor de internet, pe care aceștia le instalează în rețeaua lor, îmbunătățind localizarea traficului Netflix și calitatea streaming-ului pentru utilizatori:
Setul de servicii AWS este responsabil pentru gestionarea cererilor video de la clienți către serverele CDN, precum și configurarea acestora - actualizarea conținutului, codului sursă, setărilor etc. Pentru acest lucru, am construit, de asemenea, o rețea backbone, care conectează serverele din punctele Internet Exchange cu AWS. Rețeaua backbone reprezintă o rețea globală din cabluri de fibră optică și routere, pe care le putem proiecta și configura în funcție de nevoile noastre.
După , infrastructura noastră CDN livrează în orele de vârf aproximativ ⅛ din traficul mondial de internet și ⅓ din traficul din America de Nord, unde Netflix există cel mai mult timp. Cifre impresionante, dar pentru mine, una dintre cele mai surprinzătoare realizări este că întreaga sistemă CDN este dezvoltată și întreținută de o echipă de mai puțin de 150 de persoane.
Inițial, infrastructura CDN a fost proiectată pentru livrarea datelor video. Totuși, de-a lungul timpului, am realizat că putem folosi și pentru optimizarea cererilor dinamice de la clienți în cloud-ul AWS.
Despre accelerarea internetului
Astăzi, Netflix are 3 regiuni AWS, iar întârzierea cererilor în cloud va depinde de distanța la care se află clientul față de cea mai apropiată regiune. Avem, de asemenea, multe servere CDN care sunt utilizate pentru livrarea conținutului static. Există vreo modalitate de a folosi această infrastructură pentru a accelera cererile dinamice? Din păcate, nu putem cache-ui aceste cereri – API-urile sunt personalizate, iar fiecare rezultat este unic.
Hai să facem un proxy pe serverul CDN și să începem să gestionăm traficul prin el. Va fi mai rapid?
Partea tehnică
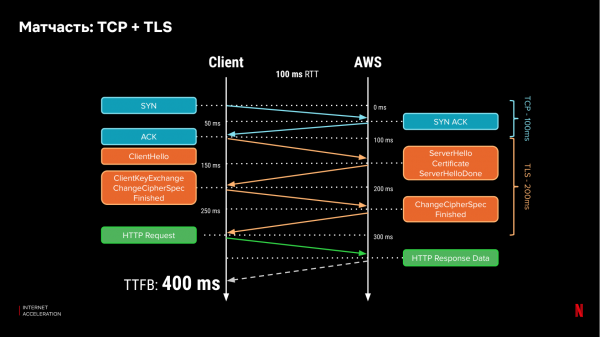
Să ne amintim cum funcționează protocoalele de rețea. Astăzi, cea mai mare parte a traficului de pe internet folosește HTTPS, care depinde de protocoalele de bază TCP și TLS. Pentru ca un client să se conecteze la server, efectuează un handshake, iar pentru a stabili o conexiune securizată, clientul trebuie să schimbe mesaje cu serverul de trei ori și apoi să trimite datele, ceea ce necesită cel puțin o altă dată. Cu o întârziere de un schimb (RTT) de 100 ms, avem nevoie de 400 ms pentru a primi primul bit de date:
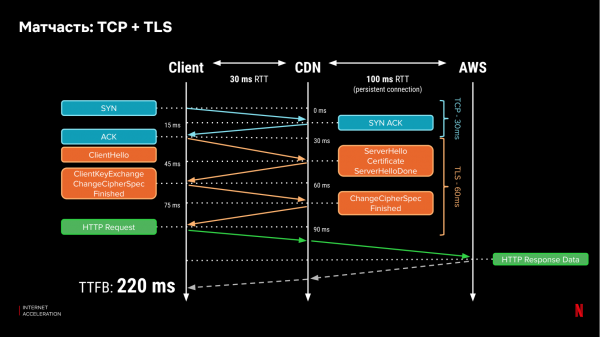
Dacă certificatele sunt amplasate pe serverul CDN, atunci timpul de „strângere de mână” între client și server poate fi redus semnificativ, dacă CDN-ul se află mai aproape. Să presupunem că întârzierea până la serverul CDN este de 30 ms. Atunci pentru a obține primul bit va fi nevoie deja de 220 ms:
Dar avantajele nu se opresc aici. După ce conexiunea a fost deja stabilită, TCP crește fereastra de congestionare (cantitatea de informație pe care o poate transmite prin această conexiune în paralel). Dacă un pachet de date se pierde, atunci implementările clasice ale protocolului TCP (precum TCP New Reno) reduc „fereastra” deschisă la jumătate. Creșterea ferestrei de congestionare și viteza de recuperare de la pierdere depind din nou de întârzierea (RTT) până la server. Dacă conexiunea merge doar până la serverul CDN, această recuperare va fi mai rapidă. Pierderile de pachete sunt un fenomen standard, în special pentru rețelele wireless.
Lățimea de bandă a internetului poate scădea, mai ales în orele de vârf din cauza traficului generat de utilizatori, ceea ce poate duce la „blocaje”. În plus, nu există nicio modalitate de a oferi prioritate unor cereri în favoarea altora. De exemplu, nu putem prioritiza cererile cu volume mici și sensibile la întârziere față de fluxurile de date „grele” care îngreunează rețeaua. Cu toate acestea, în cazul nostru, existența unei rețele backbone proprii ne permite să facem acest lucru pe o parte din drumul cererii — între CDN și cloud, și putem să o configurăm complet. Putem face astfel încât pachetele mici și sensibile la întârziere să fie prioritizate, iar fluxurile mari de date să meargă puțin mai târziu. Cu cât CDN-ul este mai aproape de client, cu atât mai mare este eficiența.
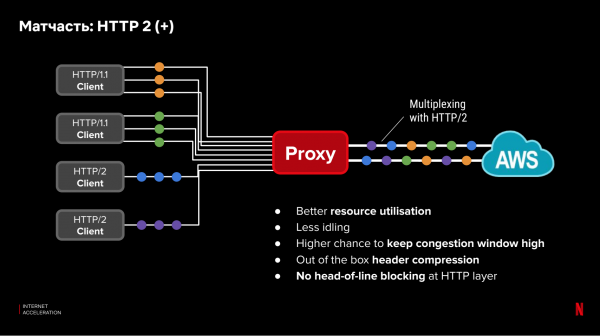
De asemenea, protocoalele de nivel aplicație (OSI Nivelul 7) influențează întârzierea. Protocoalele noi, cum ar fi HTTP/2, permit optimizarea performanței cererilor paralele. Cu toate acestea, avem clienți Netflix cu dispozitive vechi, care nu suportă protocoale noi. Nu toți clienții pot fi actualizați sau configurați optim. În plus, între proxy-ul CDN și cloud – există un control complet și posibilitatea de a folosi protocoale și configurații noi, optime. Partea ineficientă cu protocoale vechi va acționa doar între client și serverul CDN. Mai mult, putem multiplexa cererile pe o conexiune deja stabilită între CDN și cloud, îmbunătățind utilizarea conexiunii la nivel TCP:
Măsurăm
Deși teoria promite îmbunătățiri, nu ne grăbim să lansăm imediat sistemul în producție. În schimb, trebuie să dovedim mai întâi că ideea va funcționa în practică. Pentru aceasta, trebuie să răspundem la câteva întrebări:
- Viteză: va fi proxy-ul mai rapid?
- Fiabilitate: va eșua mai des?
- Complexitate: cum se integrează cu aplicațiile?
- Preț: cât costă implementarea infrastructurii suplimentare?
Să analizăm detaliat abordarea noastră pentru evaluarea primei întrebări. Celelalte se analizează într-un mod asemănător.
Pentru a analiza viteza cererilor, dorim să obținem date pentru toți utilizatorii, fără a investi mult timp în dezvoltare și fără a afecta producția. Există mai multe abordări pentru aceasta:
- RUM, sau măsurarea pasivă a cererilor. Măsurăm timpul de execuție al cererilor curente de la utilizatori și asigurăm o acoperire completă a utilizatorilor. Un dezavantaj este semnalul nu foarte stabil din cauza multor factori, cum ar fi dimensiunile diferite ale cererilor, timpul de procesare pe server și client. În plus, nu putem testa o nouă configurație fără efect asupra producției.
- Teste de laborator. Servere și infrastructură specială care imită clienții. Cu ajutorul acestora efectuăm testele necesare. Astfel, obținem un control complet asupra rezultatelor măsurărilor și un semnal clar. Dar nu există o acoperire completă a dispozitivelor și a locației utilizatorilor (în special cu un serviciu global și suport pentru mii de modele de dispozitive).
Cum putem combina avantajele ambelor metode?
Echipa noastră a găsit o soluție. Am scris un mic fragment de cod — probă — pe care l-am integrat în aplicația noastră. Probe ne permit să facem teste de rețea complet controlate de pe dispozitivele noastre. Funcționează astfel:
- La scurt timp după încărcarea aplicației și finalizarea activităților inițiale, lansăm probele noastre.
- Clientul face o cerere către server și primește un «rețetă» de test. Rețeta constă într-o listă de adrese URL la care trebuie să facem cereri HTTP(s). Pe lângă aceasta, rețeta configurează parametrii cererilor: întârzieri între cereri, volumul de date solicitate, antetele HTTP(s) etc. În plus, putem testa simultan mai multe rețete diferite — la cererea de configurare, se determină aleatoriu ce rețetă să fie furnizată.
- Timpul de lansare a probei este ales pentru a nu intra în conflict cu utilizarea activă a resurselor de rețea pe client. Practic, se alege un moment în care clientul nu este activ.
- După primirea rețetei, clientul face cereri pentru fiecare dintre adresele URL, în paralel. Cererea pentru fiecare dintre adrese poate fi repetată — așa-numitele «pulsi». La primul puls, măsurăm cât timp a fost necesar pentru a stabili conexiunea și a descărca datele. La al doilea puls, măsurăm timpul de încărcare a datelor prin conexiunea deja stabilită. Înainte de al treilea, putem introduce o întârziere și măsura viteza de stabilire a reconexiunii etc.
În timpul testului, măsurăm toate parametrii pe care dispozitivul le poate obține:
- timpul de cerere DNS;
- timpul de stabilire a conexiunii prin TCP;
- timpul de stabilire a conexiunii prin TLS;
- timpul necesar pentru primirea primului byte de date;
- timpul total de încărcare;
- codul de stare a rezultatului.
- După încheierea tuturor pulsurilor, proba încarcă rezultatele tuturor măsurărilor pentru analiză.
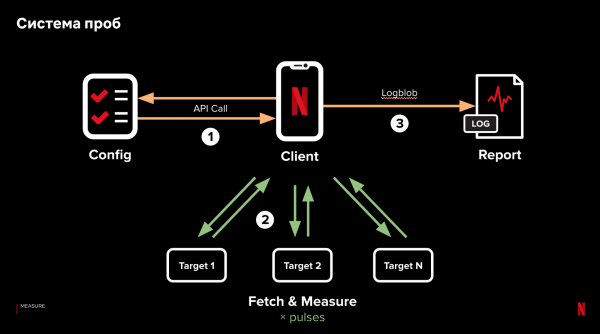
Punctele cheie sunt dependența minimă de logica clientului, procesarea datelor pe server și măsurarea cererilor paralele. Astfel, obținem posibilitatea de a izola și testa influența diferitelor factori care afectează performanța cererilor, variind aceștia în cadrul aceleași rețete și obținând rezultate din partea clienților reali.
Această infrastructură s-a dovedit utilă nu doar pentru analiza performanței cererilor. În acest moment, avem 14 rețete active, peste 6000 de probe pe secundă, care obțin date din toate colțurile lumii și au o acoperire completă a dispozitivelor. Dacă Netflix ar cumpăra un astfel de serviciu de la companii externe, ar costa milioane de dolari pe an, având o acoperire mult mai slabă.
Testăm teoria în practică: prototipul
Cu un astfel de sistem, am obținut posibilitatea de a evalua eficiența proxy-ului CDN asupra latenței cererilor. Acum trebuie să:
- creăm un prototip de proxy;
- distribuim prototipul pe CDN;
- stabilim cum să direcționăm clienții către proxy pe un anumit server CDN;
- comparăm performanța cu cererile în AWS fără proxy.
Obiectivul este de a evalua cât mai repede eficiența soluției propuse. Pentru implementarea prototipului, am ales Go, datorită disponibilității unor biblioteci de rețea bune. Pe fiecare server CDN am instalat prototipul proxy ca un binary static, pentru a minimiza dependențele și a simplifica integrarea. În implementarea inițială, am folosit la maximum componentele standard și mici modificări pentru pooling-ul conexiunilor HTTP/2 și multiplexarea cererilor.
Pentru a echilibra între regiunile AWS, am folosit o bază de date geografică DNS, aceeași folosită pentru echilibrarea clienților. Pentru a alege serverul CDN pentru client, utilizăm TCP Anycast pentru serverele din Internet Exchange (IX). În această variantă, folosim o singură adresă IP pentru toate serverele CDN, în timp ce clientul va fi direcționat către serverul CDN cu cel mai mic număr de hops IP. La serverele CDN instalate la furnizorii de internet (ISP), nu avem control asupra routerului pentru configurarea TCP Anycast, așa că folosim , conform căreia clienții sunt direcționați către furnizorii de internet pentru streaming video.
Deci, avem trei tipuri de căi pentru cerere: în cloud prin internet deschis, prin server CDN în IX sau prin server CDN situat la furnizorul de internet. Scopul nostru este să înțelegem care cale este mai bună și ce beneficii are proxy-ul, comparativ cu modul în care cererile sunt direcționate în producție. Pentru aceasta, folosim un sistem de probe în următorul mod:
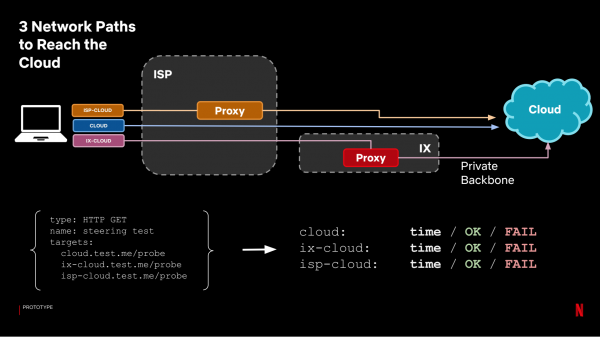
Fiecare dintre căi devine un target separat, iar noi ne uităm la timpul pe care l-am obținut. Pentru analiză, grupăm rezultatele proxy în un singur grup (alegem cel mai bun timp între proxy-urile IX și ISP) și comparăm cu timpul cererilor în cloud fără proxy:
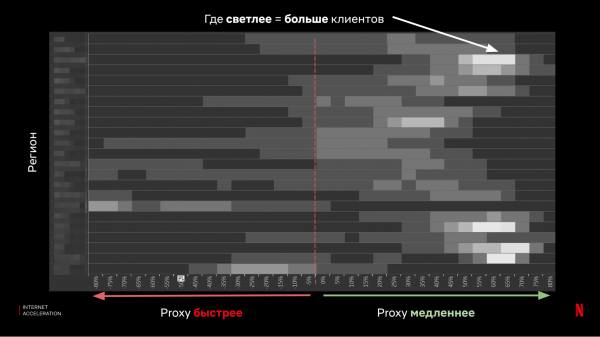
După cum se vede, rezultatele s-au dovedit ambigue - în majoritatea cazurilor, proxy-ul oferă un bun avans, dar există, de asemenea, un număr suficient de clienți pentru care situația se va înrăutăți semnificativ.
Ca urmare, am realizat câteva lucruri importante:
- Am evaluat performanța așteptată a cererilor de la clienți în cloud prin proxy CDN.
- Am obținut date de la clienți reali, de pe toate tipurile de dispozitive.
- Am înțeles că teoria nu a fost confirmată 100% și propunerea inițială cu proxy CDN nu va funcționa pentru noi.
- Nu am riscat - nu am schimbat configurațiile de producție pentru clienți.
- Nu am stricat nimic.
Prototip 2.0
Deci, ne întoarcem la tablă și repetăm procesul de la început.
Ideea este - în loc de 100% proxy, pentru fiecare client vom determina cea mai rapidă cale și vom dirija cererile acolo - adică vom face ceea ce se numește client steering.
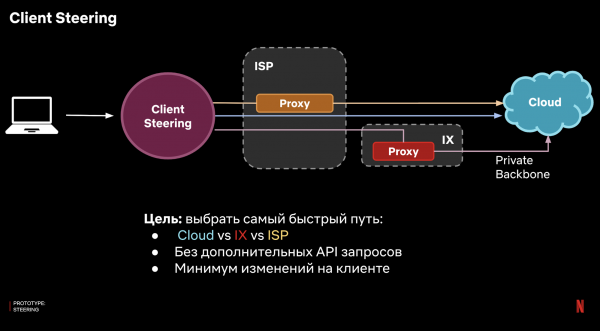
Cum să realizăm asta? Nu putem folosi logica pe server, deoarece scopul este să ne conectăm la acest server. Trebuie să facem acest lucru cumva pe client și, ideal, să reducem la minimum logica complexă pentru a evita problemele de integrare cu o gamă largă de platforme client.
Răspunsul este utilizarea DNS. În cazul nostru, dispunem de propria infrastructură DNS și putem configura zona de domeniu pentru care serverele noastre vor fi autoritare. Funcționează astfel:
- Clientul trimite o cerere către serverul DNS folosind un host, de exemplu api.netflix.com.
- Cererea ajunge la serverul nostru DNS.
- Serverul DNS știe care este calea cea mai rapidă pentru acest client și returnează adresa IP corespunzătoare.
În soluție există o dificultate suplimentară: furnizorii de DNS autoritari nu văd adresa IP a clientului și pot considera doar adresa IP a resolver-ului recursiv folosit de client.
Astfel, resolverul nostru autoritar trebuie să ia decizii nu pentru un singur client, ci pentru un grup de clienți pe baza resolver-ului recursiv.
Pentru a rezolva problema, folosim aceleași probe, agregăm rezultatele măsurătorilor de la clienți pentru fiecare dintre resolver-urile recursiv și decidăm unde să direcționăm acest grup - prin proxy prin IX folosind TCP Anycast, prin proxy-ul ISP sau direct în cloud.
Obținem un astfel de sistem:
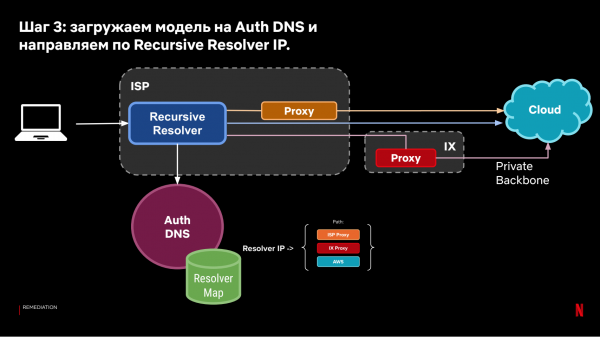
Modelul obținut de DNS steering permite direcționarea clienților pe baza observațiilor istorice asupra vitezei conexiunilor de la clienți la cloud.
Întrebarea este din nou - cât de eficient va fi acest abordare? Pentru a răspunde, folosim din nou sistemul nostru de probe. Prin urmare, configurăm un experiment recent, unde una dintre ținte urmează direcția de la DNS steering, iar cealaltă - merge direct în cloud (producția curentă).
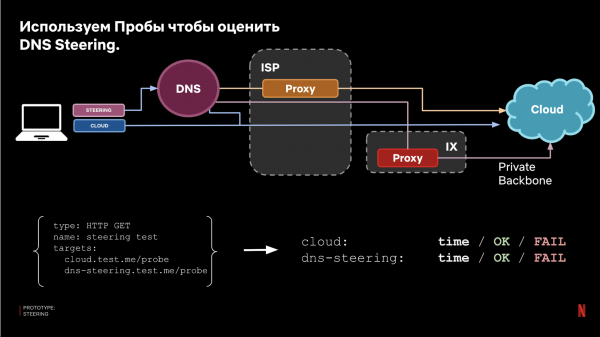
În final, comparăm rezultatele și obținem o estimare a eficienței:
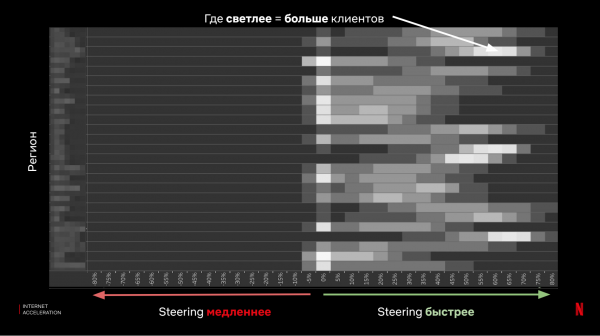
Așadar, am învățat câteva lucruri importante:
- Am evaluat performanța așteptată a cererilor de la clienți către cloud folosind DNS steering.
- Am obținut date de la clienți reali, de pe toate tipurile de dispozitive.
- Am demonstrat eficiența ideii propuse.
- Nu am riscat - nu am schimbat configurațiile de producție pentru clienți.
- Nu am stricat nimic.
Acum, despre o provocare - lansăm în producție.
Cel mai simplu este acum în trecut - avem un prototip funcțional. Acum, partea complicată este să implementăm soluția pentru tot traficul Netflix, să o desfășurăm pe 150 de milioane de utilizatori, mii de dispozitive, sute de microservicii și un produs și infrastructură în continuă schimbare. Serverele Netflix primesc milioane de cereri pe secundă și este ușor să strici serviciul printr-o acțiune neatenției. În același timp, dorim să direcționăm traficul dinamic prin mii de servere CDN în internet, unde ceva se schimbă și se strică constant, și în cel mai nefericit moment.
Și, cu toate acestea, echipa noastră constă din 3 ingineri responsabili pentru dezvoltarea, desfășurarea și suportul complet al sistemului.
Prin urmare, vom vorbi despre un somn calm și sănătos.
Cum să continuăm dezvoltarea, fără a ne pierde tot timpul în suport? La baza abordării noastre stau 3 principii:
- Reducem potențialul de amploare al defectelor (blast radius).
- Ne pregătim pentru surprize - ne așteptăm ca ceva să se strice, în ciuda testării și experienței personale.
- Degradare graduală (graceful degradation) - dacă ceva nu funcționează corect, ar trebui să fie reparat automat, chiar dacă nu în cel mai eficient mod.
S-a dovedit că în cazul nostru, cu o abordare de acest tip, putem găsi o soluție simplă și eficientă, care să simplifice semnificativ suportul sistemului. Am realizat că putem adăuga o mică bucată de cod în client și să monitorizăm erorile cererilor de rețea cauzate de problemele de conectivitate. În cazul erorilor de rețea, facem fallback direct în cloud. Această soluție nu necesită eforturi considerabile din partea echipelor clientului, dar reduce semnificativ riscul de defecte neașteptate și surprize pentru noi.
Desigur, în ciuda fallback-ului, respectăm totuși o disciplină strictă pe parcursul dezvoltării:
- Test pe probe.
- Testare A/B sau Canaries.
- Publicare treptată (progressive rollout).
În ceea ce privește probele, abordarea a fost descrisă - modificările sunt testate mai întâi cu ajutorul unei rețete configurate.
Pentru testarea canary, trebuie să obținem perechi comparabile de servere pe care să comparăm cum funcționează sistemul înainte și după modificări. Pentru aceasta, din numeroasele noastre site-uri CDN, facem o selecție de perechi de servere care primesc trafic comparabil:
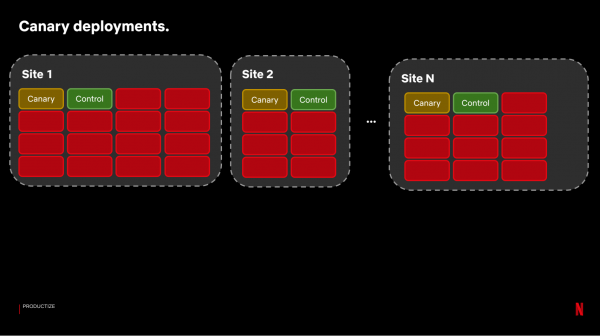
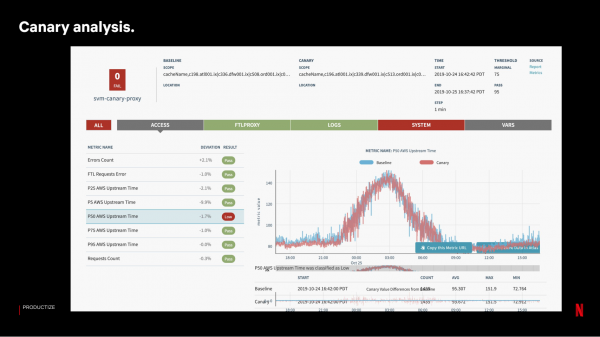
Apoi, vom implementa versiunile cu modificările pe serverele Canary. Pentru a evalua rezultatele, rulăm un sistem care compară aproximativ 100-150 de metrici cu un eșantion de servere Control:
Dacă testarea Canary a fost reușită, lansăm treptat, în valuri. Pe fiecare site, nu actualizăm serverele simultan — pierderea unui întreg site în cazul unor probleme are un impact mai semnificativ asupra serviciului pentru utilizatori decât pierderea unui număr similar de servere, dar în locuri diferite.
În general, eficiența și securitatea unei astfel de abordări depind de cantitatea și calitatea metricilor colectate. Pentru sistemul nostru de accelerare a cererilor, colectăm metrici din toate componentele posibile:
- de la clienți — numărul de sesiuni și cereri, ratele de fallback;
- proxy — statistici privind numărul și timpul cererilor;
- DNS — numărul și rezultatele cererilor;
- cloud edge — numărul și timpul de procesare a cererilor în cloud.
Toate acestea sunt colectate într-un pipeline unic, iar, în funcție de nevoi, decidem ce metrici să trimitem pentru analiza în timp real și ce metrici — în Elasticsearch sau Big Data pentru diagnoză mai detaliată.
Monitorizăm
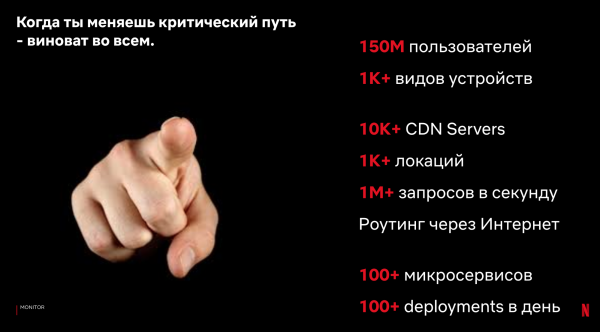
În cazul nostru, facem modificări pe calea critică a cererilor între client și server. Totuși, numărul diferitelor componente de pe client, server și pe drumul prin internet este enorm. Modificările pe client și server se petrec constant — în timpul activității zecilor de echipe și al schimbărilor naturale din ecosistem. Suntem în mijloc — la diagnosticarea problemelor, există o șansă mare să fim implicați în acest proces. De aceea, trebuie să înțelegem clar cum să definim, colectăm și analizăm metricile pentru o localizare rapidă a problemelor.
Ideal — acces complet la toate tipurile de metrici și filtre în timp real. Dar sunt foarte multe metrici, așa că se pune problema costului. În cazul nostru, separăm metricile și instrumentele de dezvoltare astfel:
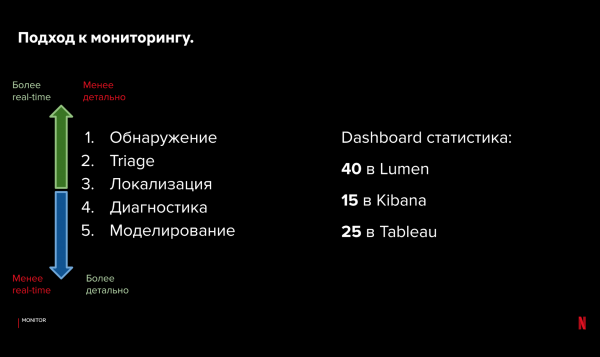
Pentru descoperirea și trierea problemelor, folosim un sistem propriu de timp real cu cod sursă deschis și — pentru vizualizare. Acesta păstrează metricile agregate în memorie, este de încredere și se integrează cu sistemul de alertare. Pentru localizare și diagnoză, avem acces la jurnalele din Elasticsearch și Kibana. Pentru analiza statistică și modelare — folosim big data și vizualizarea în Tableau.
Se pare că este foarte complicat să lucrăm cu această abordare. Totuși, prin organizarea ierarhică a metricilor și instrumentelor, putem analiza rapid problema, defini tipul său și apoi - ne putem aprofunda în metricile detaliate. De obicei, ne ia între 1 și 2 minute pentru a identifica sursa defecțiunii. După aceea, colaborăm cu echipa specifică pentru diagnosticare - de la zeci de minute până la câteva ore.
Chiar dacă diagnosticul este realizat rapid, nu ne dorim să se întâmple frecvent. În mod ideal, vom primi alerte critice doar atunci când există un impact semnificativ asupra serviciului. Pentru sistemul nostru de accelerare a cererilor, avem doar 2 alerte care vor notifica:
- procentul Client Fallback - evaluarea comportamentului clienților;
- procentul erorilor Probe - date despre stabilitatea componentelor de rețea.
Aceste alerte critice monitorizează dacă sistemul funcționează pentru majoritatea utilizatorilor. Ne uităm la câți clienți au utilizat fallback-ul, dacă nu au reușit să obțină accelerarea cererilor. În medie, avem mai puțin de 1 alertă critică pe săptămână, deși în sistem se întâmplă o cantitate gigantică de modificări. De ce ne ajunge acest lucru?
- Există fallback pentru clienți în cazul în care proxy-ul nostru nu funcționează.
- Există un sistem de steering automat care reacționează la probleme.
Despre ultimul în detaliu. Sistemul nostru de probe și sistemul de determinare automată a celui mai optim drum pentru cererile de la client către cloud ne permit să facem față automat unor probleme.
Să revenim la configurația noastră de probe și cele 3 categorii de drumuri. În afară de timpul de încărcare, putem analiza și faptul de livrare. Dacă nu am reușit să încărcăm datele, prin observarea rezultatelor pe diferite drumuri putem determina unde și ce s-a defectat și dacă putem face automat o corectare modificând drumul cererii.
Exemple:
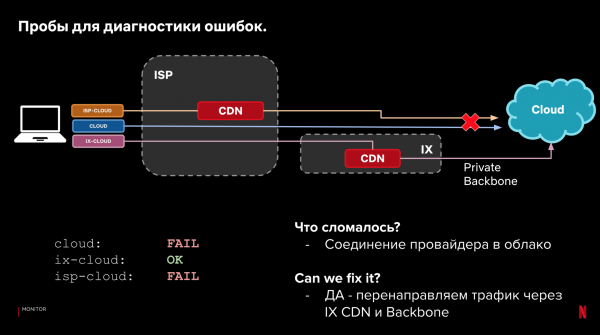
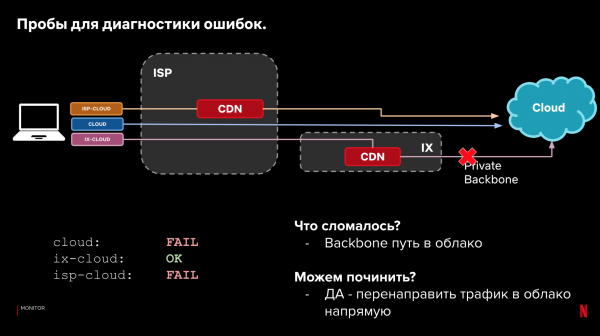
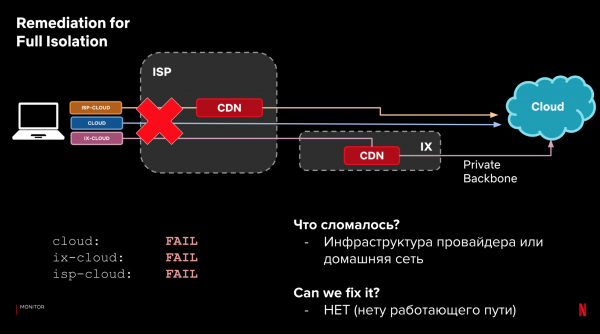
Acest proces poate fi automatizat. Îl putem include în sistemul de steering. Și să o învățăm să reacționeze la probleme de performanță și fiabilitate. Dacă ceva începe să se defecteze - să reacționeze, dacă există o opțiune mai bună. În același timp, reacția instantanee nu este critică, datorită fallback-ului pentru clienți.
Astfel, principiile de suport ale sistemului pot fi formulate astfel:
- reducem amploarea defecțiunilor;
- colectăm metrici;
- remediem automat defecțiunile, dacă putem;
- dacă nu putem - notificăm;
- Lucrăm la dashboards și un triage toolset pentru reacții rapide.
Lecțiile învățate
Crearea prototipului nu necesită mult timp. În cazul nostru, acesta a fost gata în doar 4 luni. Cu el, am obținut noi metrici, iar după 10 luni de la începutul dezvoltării, am avut primul trafic în production. Apoi a început munca grea și foarte complicată: să producem și să extindem treptat sistemul, să migram traficul principal și să învățăm din greșeli. Acest proces eficient nu va fi liniar — în ciuda tuturor eforturilor, nu se poate prezice totul. Este mult mai eficient să iterăm rapid și să reacționăm la noi date.
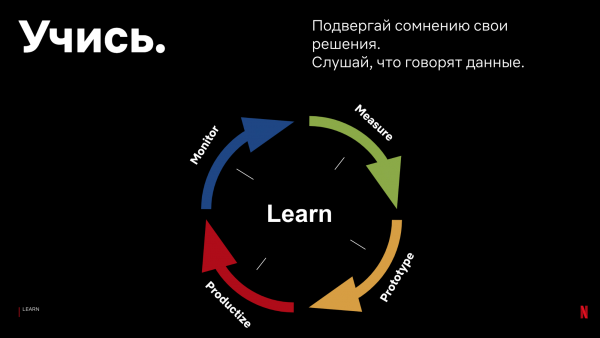
Pe baza experienței noastre, putem recomanda următoarele:
- Nu vă bazați pe intuiție.
Intuiția noastră ne-a înșelat constant, în ciuda experienței vaste a membrilor echipei. De exemplu, am prezis greșit accelerarea așteptată de la utilizarea CDN proxy-urilor sau comportamentul TCP Anycast.
- Obțineți date din production.
Este important să obțineți cât mai repede acces la măcar o cantitate mică de date din production. Este aproape imposibil să obțineți numărul unic de cazuri, configurații sau setări în condiții de laborator. Accesul rapid la rezultate va permite cunoașterea mai rapidă a problemelor potențiale și integrarea acestora în arhitectura sistemului.
- Nu urmați sfaturile și rezultatele altora — adunați-vă propriile date.
Urmați principiile de colectare și analiză a datelor, dar nu acceptați orbește rezultatele și afirmațiile altora. Numai voi puteți ști exact ce funcționează pentru utilizatorii voștri. Sistemele și clienții voștri pot diferi semnificativ de alte companii. Din fericire, instrumentele de analiză sunt acum disponibile și ușor de utilizat. Rezultatele obținute pot să nu coincidă cu ceea ce afirmă Netflix, Facebook, Akamai și alte companii. În cazul nostru, performanța TLS, HTTP2 sau statisticile legate de cererile DNS diferă de rezultatele Facebook, Uber, Akamai — pentru că avem dispozitive, clienți și fluxuri de date diferite.
- Nu urmăriți tendințele la modă fără necesitate și evaluarea eficienței.
Începeți cu ceva simplu. Este mai bine să realizați un sistem de lucru simplu într-un timp scurt, decât să petreceți o perioadă îndelungată dezvoltând componente inutile. Abordați problemele care sunt importante pe baza măsurătorilor și rezultatelor voastre.
- Fii pregătit pentru noi aplicații.
La fel de greu cum este să previi toate problemele, la fel de greu este să anticipezi avantajele și aplicațiile. Ia exemplu de la startup-uri - capacitatea lor de a se adapta la cerințele clienților. În cazul tău - poți descoperi noi probleme și soluții pentru acestea. În proiectul nostru, ne-am propus să reducem latența cererilor. Cu toate acestea, în timpul analizei și discuțiilor, am realizat că putem utiliza serverele proxy și pentru:
- echilibrarea traficului între regiunile AWS și reducerea costurilor;
- modelarea stabilității CDN;
- configurarea DNS;
- configurarea TLS/TCP.
Concluzie
În raport am descris cum Netflix abordează problema accelerării cererilor internet între clienți și cloud. Cum colectăm date prin intermediul sistemului de sondaje la clienți și folosim date istorice pentru a direcționa cererile de producție de la clienți prin cea mai rapidă rută pe internet. Cum aplicăm principiile funcționării protocoalelor de rețea, infrastructura noastră CDN, rețeaua backbone și serverele DNS pentru a atinge acest obiectiv.
Cu toate acestea, soluția noastră este doar un exemplu de cum am implementat un astfel de sistem la Netflix. Ce a funcționat pentru noi. Partea practică a raportului meu pentru voi - principiile de dezvoltare și suport pe care le urmăm și care ne ajută să obținem rezultate bune.
Soluția noastră pentru problema voastră s-ar putea să nu fie potrivită. Totuși, teoria și principiile de dezvoltare rămân, chiar dacă nu aveți o infrastructură CDN proprie sau dacă aceasta diferă semnificativ de a noastră.
De asemenea, rămâne importantă viteza cererilor pentru afaceri. Chiar și pentru un serviciu simplu trebuie să faceți o alegere: între furnizorii „cloud”, locația serverelor, CDN-uri și furnizorii DNS. Alegerile voastre vor influența eficiența cererilor internet pentru clienții voștri. Este important să măsurați și să înțelegeți această influență.
Începeți cu soluții simple, aveți grijă de modul în care modificați produsul. Învățați pe parcurs și îmbunătățiți sistemul pe baza datelor de la clienții voștri, infrastructura voastră și afacerea voastră. Gândiți-vă la posibilitatea unor defecțiuni neprevăzute în procesul de proiectare. Și astfel veți putea accelera procesul de dezvoltare, îmbunătăți eficiența soluției, evita o suprasolicitare a suportului și dormi liniștiți.
Anul acesta în format online. Vei putea să pui întrebări unuia dintre părinții DevOps, lui John Willis!
Sursa: habr.com
