

VictoriaMetrics este o bază de date rapidă și scalabilă pentru stocarea și procesarea datelor sub formă de serii temporale (o înregistrare generează timp și un set de valori corespunzătoare acestui timp, de exemplu, obținute prin interogarea periodică a stării senzorilor sau colectarea metricilor).
Mă numesc Kolobaev Pavel. DevOps, SRE, LeroyMerlin, totul ca un cod – toate acestea sunt despre noi: despre mine și despre ceilalți angajați LeroyMerlin.
Există un nor pe baza OpenStack. Acolo este un link mic pe tech radar.
A fost construit pe baza infrastructurii Kubernetes, precum și pe toate serviciile conexe OpenStack și de jurnalizare.
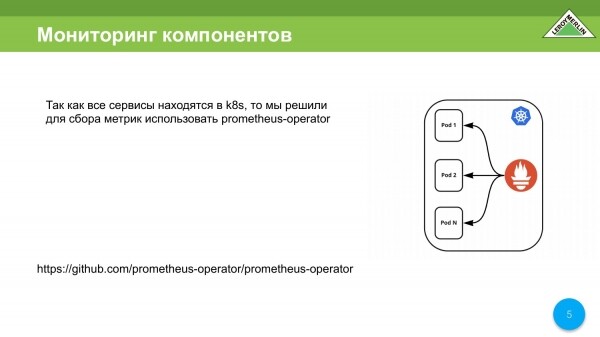
Schema arăta cam așa în timpul dezvoltării. Când am lucrat la toate acestea, aveam un operator Prometheus, care stoca datele în interiorul clusterei K8s. Acesta găsește automat ceea ce trebuie să extragă și adună sub picioarele sale, într-un fel.
Toate datele trebuie extrase din exteriorul clusterei Kubernetes, pentru că, dacă se întâmplă ceva, trebuie să înțelegem ce și unde.
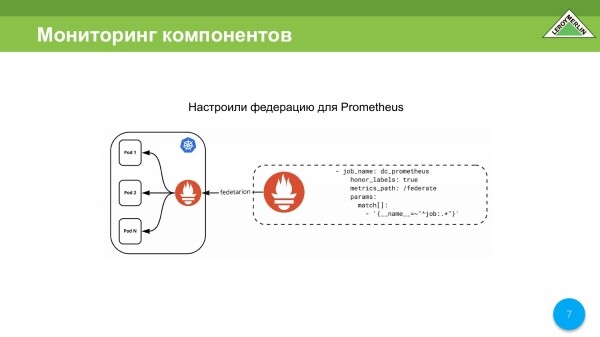
Prima soluție – folosim federation, când avem un Prometheus extern, când accesăm clustera Kubernetes prin mecanismul federation.
Dar apar probleme mici. În cazul nostru, problemele au început când aveam 250.000 de metrici, iar când au devenit 400.000 de metrici, am realizat că nu putem lucra astfel. Am crescut scrape_timeout la 25 de secunde.
De ce a trebuit să facem asta? Prometheus începe să numere timpul de timeout de la începutul perioadei de prelevare. Și nu contează că datele continuă să curgă. Dacă în acest interval specific de timp datele nu s-au descărcat și sesiunea nu este închisă prin http, atunci se consideră că sesiunea a eșuat și datele nu ajung în Prometheus.
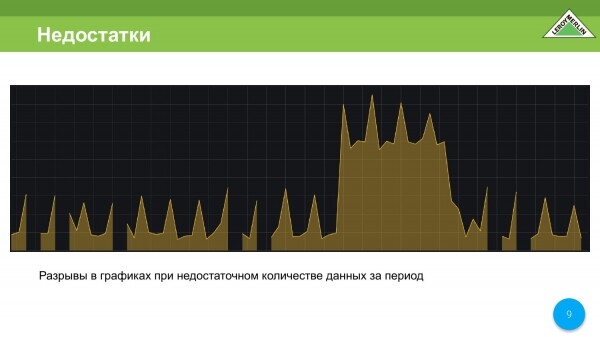
Toată lumea recunoaște graficele pe care le obținem când o parte din date lipsește. Graficele sunt fragmentate și nu ne mulțumește.
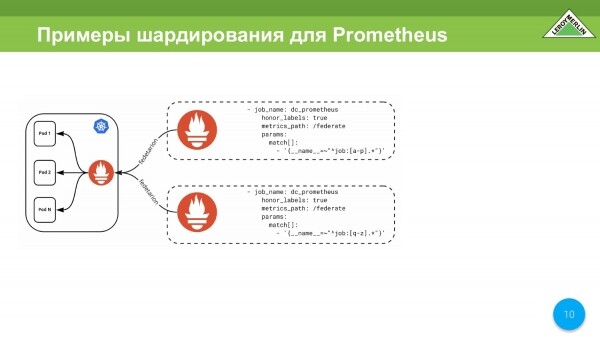
Următoarea opțiune – shardarea pe baza a două Prometheus diferite prin același mecanism federation.
De exemplu, pur și simplu să le shardăm după nume. Acest lucru poate fi utilizat, dar am decis să mergem mai departe.
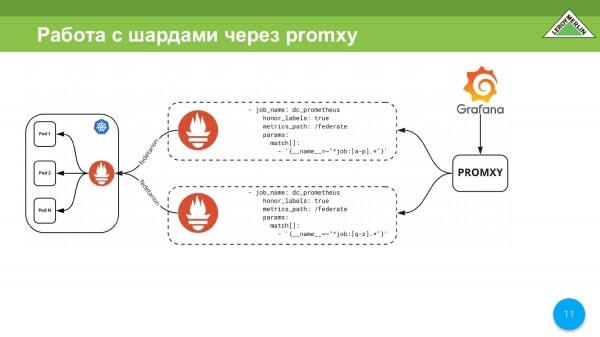
Va trebui acum să procesăm aceste șarduri într-un fel. Putem lua promxy, care accesează zona shard-ului, multiplicând datele. Acesta funcționează cu două șarduri ca un singur punct de acces. Acest lucru poate fi realizat prin promxy, dar este încă prea complicat.
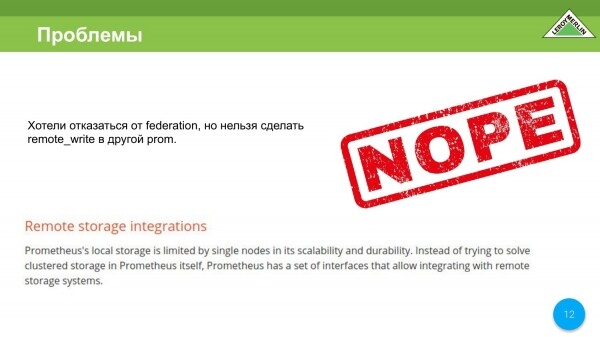
Prima variantă – dorim să renunțăm la mecanismul federation, deoarece este foarte lent.
Dezvoltatorii Prometheus spun clar: „Băieți, folosiți alte TimescaleDB, pentru că nu vom susține stocarea pe termen lung a metricilor”. Aceasta nu este sarcina lor. 
Ne notăm pe o foaie că totuși avem nevoie de export extern, pentru a nu stoca totul într-un singur loc.
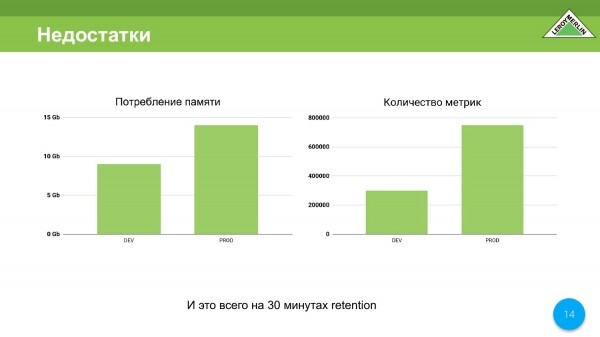
Al doilea dezavantaj este consumul de memorie. Da, înțeleg că mulți vor spune că, în anul 2020, câțiva gigabaiți de memorie sunt insignifianți, dar totuși.
Acum avem un mediu dev și unul prod. În dev, acesta consumă aproximativ 9 gigabaiți pentru 350.000 de metrici. În prod, acesta consumă puțin peste 14 gigabaiți pentru 780.000 de metrici. În plus, timpul de retenție este de doar 30 de minute. Este o problemă. Și acum voi explica de ce.
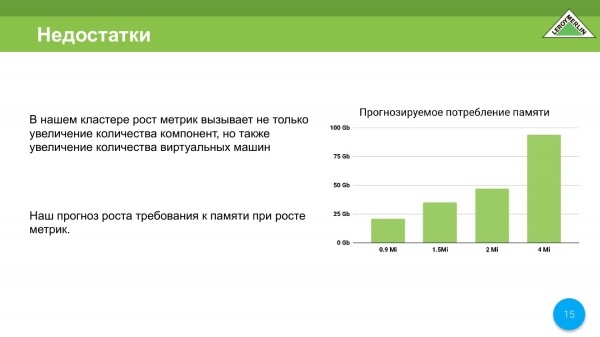
Facem o estimare, adică, la un milion și jumătate de metrici, iar noi suntem deja aproape de acest număr, în etapa de proiectare, obținem 35-37 de gigabaiți de memorie. Dar deja la 4 milioane de metrici este necesară aproximativ 90 de gigabaiți de memorie. Adică, aceasta a fost calculată conform formulei furnizate de dezvoltatorii Prometheus. Am verificat corelația și am realizat că nu dorim să plătim câteva milioane pentru un server doar pentru monitorizare.
Nu ne va crește doar numărul de mașini, ci monitorizăm și mașinile virtuale. Așadar, cu cât sunt mai multe mașini virtuale, cu atât mai multe metrici de diferite tipuri etc. Va exista o creștere specială a clusterului nostru în ceea ce privește metricile.
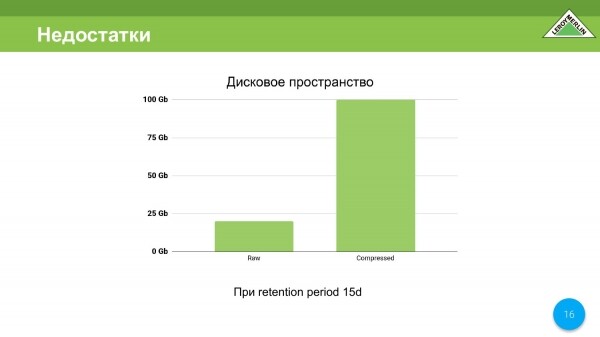
Din punct de vedere al spațiului pe disc, lucrurile nu stau atât de prost, dar ar fi dorit să îmbunătățim. Am obținut în 15 zile un total de 120 de gigabaiți, dintre care 100 sunt date comprimate, iar 20 sunt date necomprimate, dar întotdeauna ne dorim mai puțin.
Așadar, notăm un alt punct – este un consum mare de resurse pe care ne-ar plăcea să îl economisim, deoarece nu dorim ca clusterul nostru de monitorizare să consume mai multe resurse decât clusterul care se ocupă de gestionarea OpenStack.
Există un alt dezavantaj la Prometheus pe care l-am identificat pentru noi, este un oarecare limitare a memoriei. La Prometheus, lucrurile stau mult mai rău, deoarece nu are deloc astfel de limitări. Folosirea limitărilor în Docker nu este o opțiune. Dacă cumva RAF se prăbușește și sunt 20-30 de gigabaiți, atunci procesul de ridicare va dura foarte mult.
Aceasta este încă o motivare pentru care Prometheus nu ni se potrivește, adică nu putem limita consumul de memorie.
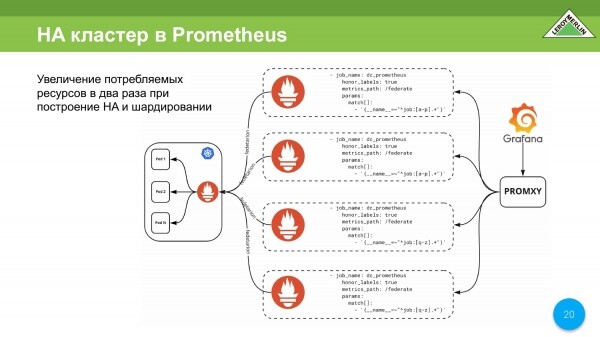
Am putea să ajungem la un astfel de sistem. Această schemă ne este necesară pentru a organiza un cluster HA. Vrem ca metricile noastre să fie disponibile mereu și peste tot, chiar și atunci când serverul care le stochează se prăbușește. Astfel, va trebui să construim un astfel de sistem.
Această schemă indică faptul că vom avea redundanță a shard-urilor, iar, în consecință, și redundanță a resurselor consumate. Poate fi aproape scalabil orizontal, dar consumul de resurse va fi enorm.
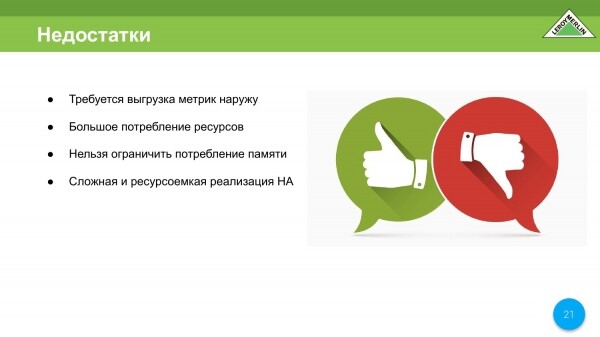
Deficiențele pe care le-am listat în ordinea în care le-am considerat:
- Este necesară exportarea metricilor în exterior.
- Consumul de resurse este mare.
- Nu se poate limita consumul de memorie.
- Implementarea HA este complexă și necesită multe resurse.
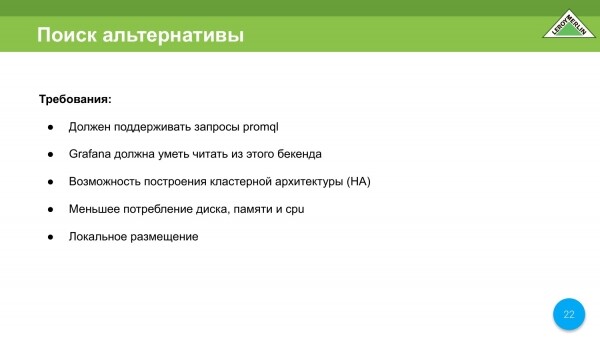
Am decis că ne îndepărtăm de Prometheus ca soluție de stocare.
Am definit și câteva cerințe suplimentare pe care le dorim. Acestea sunt:
- Suport pentru promql, deoarece deja multe lucruri sunt scrise pentru Prometheus: interogări, alerte.
- Apoi, avem Grafana, care este, de asemenea, construită pentru Prometheus ca backend. Nu vrem să rescriem tablourile de bord.
- Dorim să construim o arhitectură HA corespunzătoare.
- Vrem să reducem consumul de orice resurse.
- Există o mică nuanță. Nu putem folosi sisteme de colectare de metrici de tip cloud. Nu știm ce metrici ne vor părăsi până acum. Și având în vedere că orice ar putea să ajungă acolo, suntem nevoiți să ne limităm la stocarea locală.
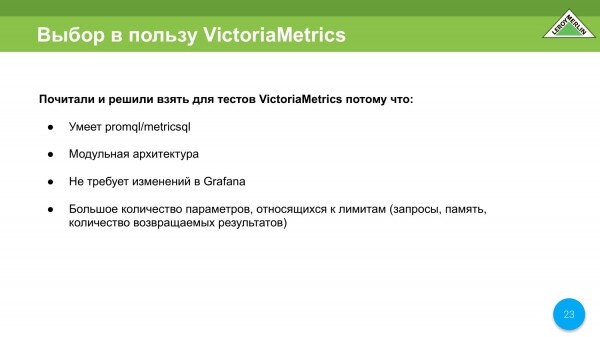
Alegerea a fost limitată. Am adunat tot ce aveam experiență. Ne-am uitat la pagina Prometheus din secțiunea integrare, am citit o mulțime de articole, am verificat ce există. Și pentru noi am ales VictoriaMetrics ca înlocuitor pentru Prometheus.
De ce? Pentru că:
- Sprijină promql.
- Are o arhitectură modulară.
- Nu necesită modificări în Grafana.
- Și cel mai important – este posibil să oferim stocarea metricilor în cadrul companiei noastre ca serviciu, așa că ne uităm deja în direcția limitării diverselor tipuri, astfel încât utilizatorii să poată folosi resursele clusterei într-un mod limitat, deoarece există șansa ca acesta să fie multitenant.
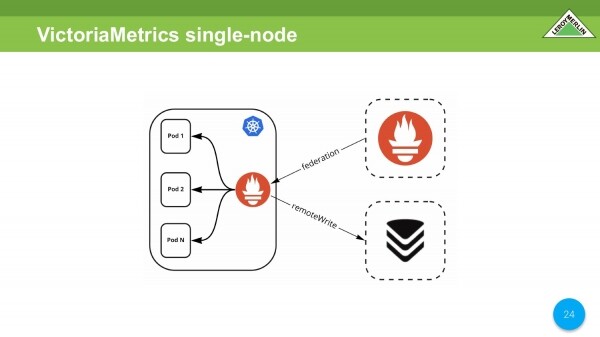
Facem prima comparație. Luăm același Prometheus în cadrul cluster-ului, la el accesează un Prometheus extern. Adăugăm prin remoteWrite VictoriaMetrics.
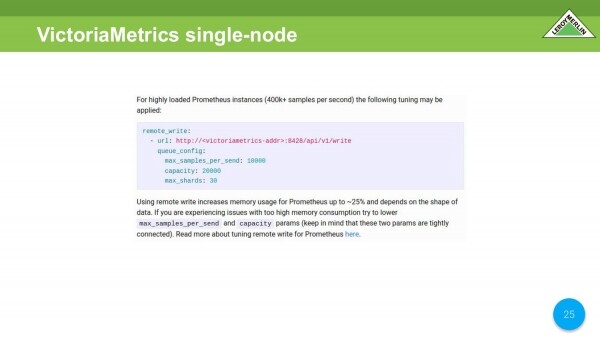
Voi spune direct că aici am observat o ușoară creștere a consumului de CPU din partea VictoriaMetrics. Pe wiki-ul VictoriaMetrics sunt specificate cele mai bune setări. Le-am testat. Acestea au redus semnificativ consumul de CPU.
În cazul nostru, consumul de memorie al Prometheus, care se află în clusterul Kubernetes, a crescut cu o intensitate nesemnificativă.
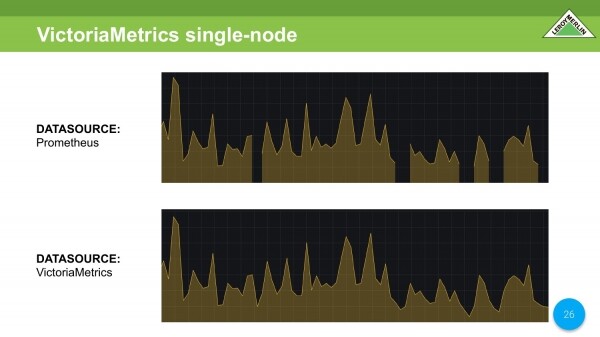
Comparăm două surse de date cu aceleași informații. În Prometheus vedem aceleași date lipsă. În VictoriaMetrics totul este în regulă.
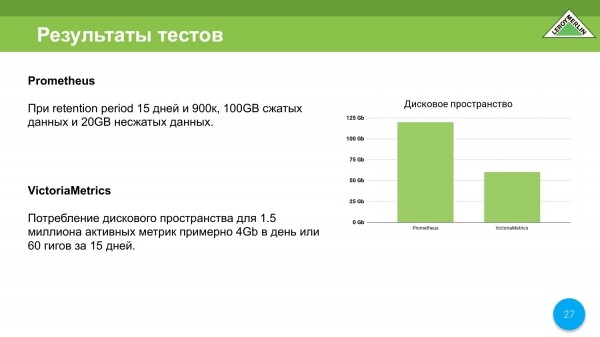
Rezultatele testelor privind spațiul de stocare. Am obținut un total de 120 de gigabytes în Prometheus. În VictoriaMetrics primim deja 4 gigabytes pe zi. Acolo funcționează un mecanism ceva mai diferit față de ceea ce am văzut în Prometheus. Adică datele sunt comprimate destul de bine pe parcursul zilei, în doar 30 de minute. Acestea sunt bine comprimate în această perioadă, chiar dacă ulterior vor fi fuzionate. În final, am economisit pe spațiul de stocare.
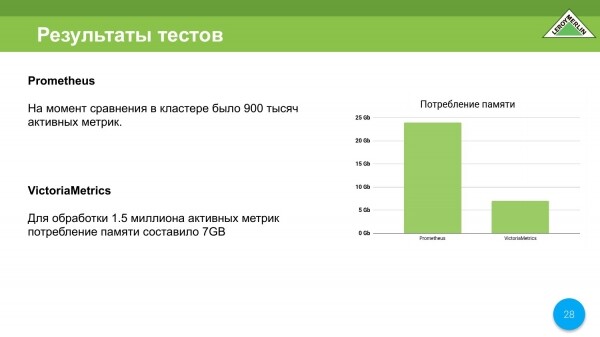
De asemenea, economisim pe consumul resurselor de memorie. La momentul testelor, Prometheus era implementat pe o mașină virtuală – 8 nuclee, 24 de gigabytes. Prometheus consumă practic totul. A fost oprit de OOM Killer. În acest context, acesta gestiona doar 900,000 de metrici active. Aproximativ 25,000-27,000 de metrici pe secundă.
VictoriaMetrics a fost rulată pe o mașină virtuală cu două nuclee și 8 gigabytes RAM. Am reușit să facem VictoriaMetrics să funcționeze bine, ajustând anumite setări pe această mașină de 8 gigabytes. În final, ne-am încadrat în 7 gigabytes. În plus, am obținut o viteză de livrare a conținutului, adică a metricilor, chiar mai bună decât cea a Prometheus.
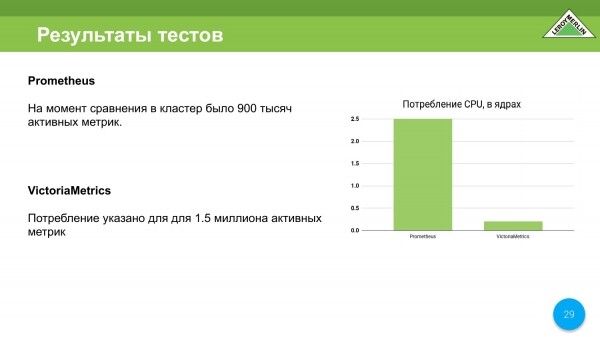
Pe partea de CPU, situația s-a îmbunătățit semnificativ în comparație cu Prometheus. Aici, Prometheus consumă 2,5 nuclee, iar VictoriaMetrics doar 0,25 nuclee. La început – 0,5 nuclee. Pe parcursul fuzionării, ajunge la un nucleu, dar acest lucru se întâmplă extrem de rar.
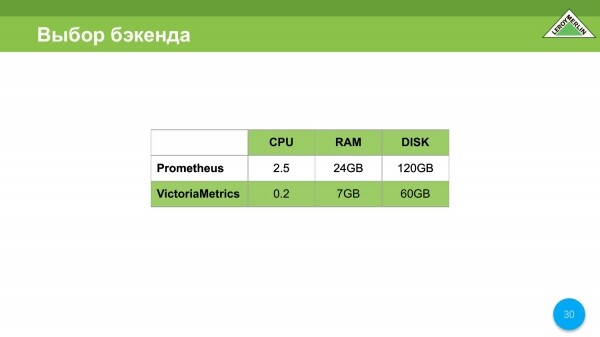
În cazul nostru, alegerea a căzut pe VictoriaMetrics din motive evidente, am dorit să economisim și chiar am economisit.
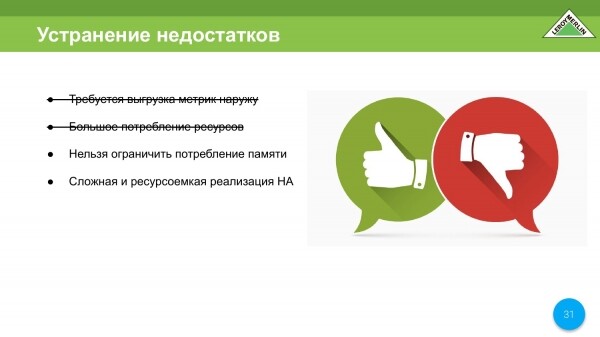
Excludem din start două puncte – exportul metricilor și consumul crescut de resurse. Ne rămân de rezolvat două puncte pe care le-am lăsat pentru noi.
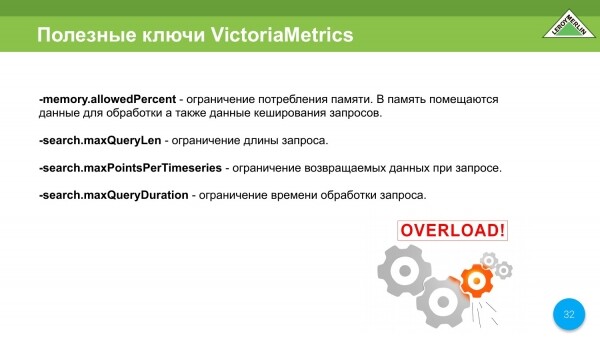
Aici subliniez că considerăm VictoriaMetrics ca un depozit de metrici. Dar, din moment ce probabil vom oferi VictoriaMetrics ca depozit pentru tot Leroy, trebuie să limităm utilizatorii acestui cluster, pentru a nu-l supraîncărca.
Există o caracteristică excelentă care permite limitarea în funcție de timp, de volumul de date și de durata de execuție.
De asemenea, există o opțiune excelentă care permite limitarea consumului de memorie, astfel încât putem găsi acel echilibru care să ne asigure o viteză de funcționare normală și un consum adecvat de resurse.
Un alt dezavantaj este că nu putem limita consumul de memorie.
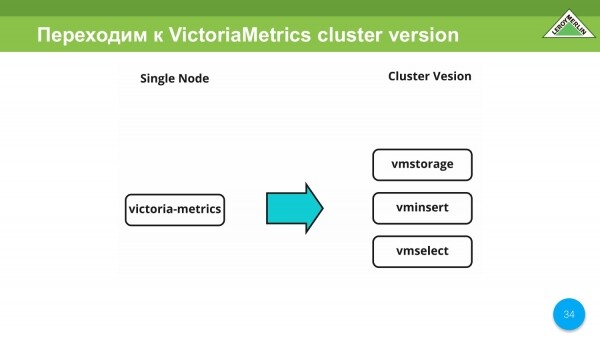
La primele iterații, am testat VictoriaMetrics Single Node. Apoi, trecem la versiunea Cluster a VictoriaMetrics.
Aici, avem mai multă libertate în ceea ce privește dispersarea diferitelor servicii în VictoriaMetrics, în funcție de pe ce vor rula și ce resurse vor consuma. Este o soluție foarte flexibilă și convenabilă. Am utilizat acest lucru pe propria piele.
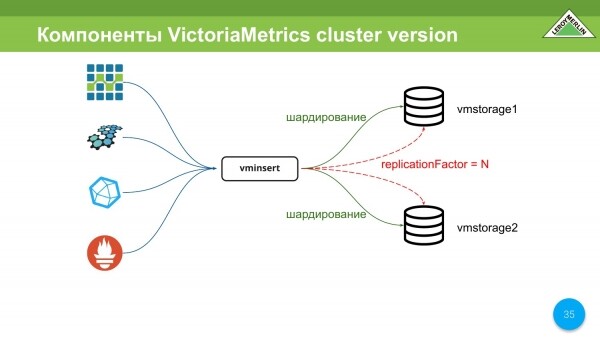
Principalele componente ale versiunii Cluster a VictoriaMetrics sunt vmstorage. Poate exista un număr N de astfel de componente. În cazul nostru, momentan sunt 2.
Și există vminsert. Acesta este un server proxy care ne permite: să facem shard-ing între toate storages despre care i-am spus și, de asemenea, oferă replicare, adică veți avea atât shard-ing, cât și replicare.
Vminsert suportă protocoalele OpenTSDB, Graphite, InfluxDB și remoteWrite de la Prometheus.
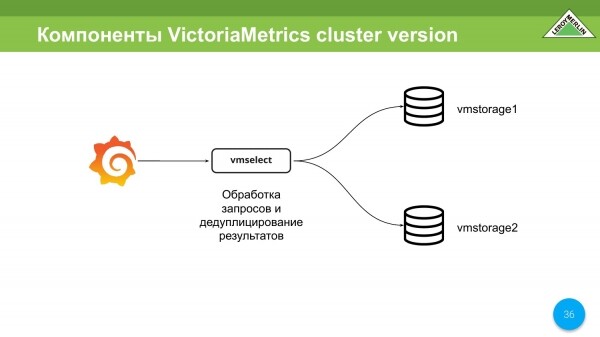
Există, de asemenea, vmselect. Sarcina sa principală este să acceseze vmstorage, să obțină datele de la acestea, să dedupliceze datele și să le predea clientului.
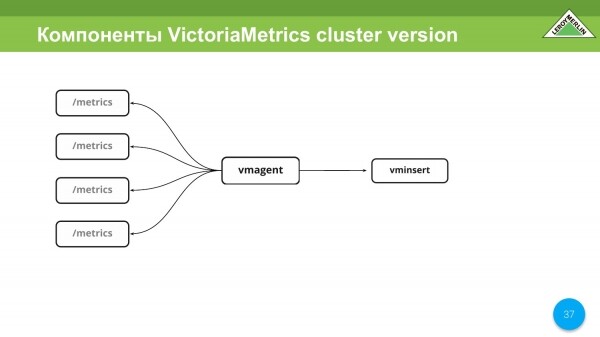
Există o caracteristică minunată numită vmagent. Ne place foarte mult. Aceasta permite configurarea exact ca Prometheus și face totul exact ca Prometheus. Adică, colectează metrici din diferite entități și servicii și le trimite la vminsert. Apoi, totul depinde de voi.
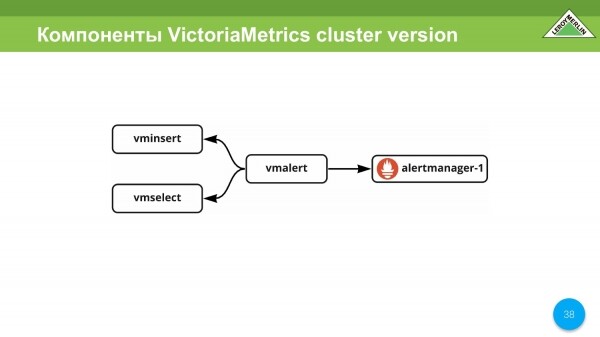
Un alt serviciu minunat este vmalert, care permite utilizarea VictoriaMetrics ca backend, obținând date de la vminsert și trimite datele procesate către vmselect. Acesta procesează alertele și regulile. În cazul alertelor, obținem alerta prin alertmanager.
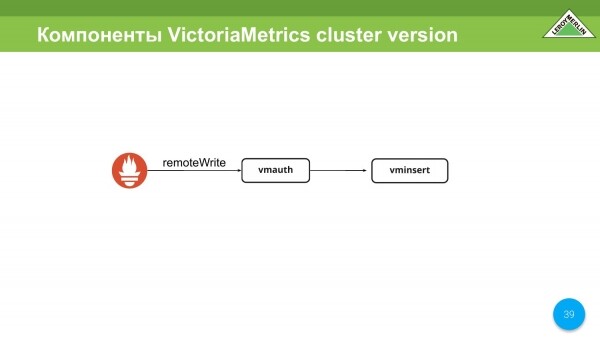
Există un component numit wmauth. Acesta va fi, poate, utilizat, iar poate nu (încă nu ne-am decis) ca sistem de autorizare în versiunea multitenancy a clusterelor. Acesta suportă remoteWrite pentru Prometheus și poate autoriza pe baza url-ului, mai exact a celei de-a doua părți, unde aveți voie să scrieți sau nu.
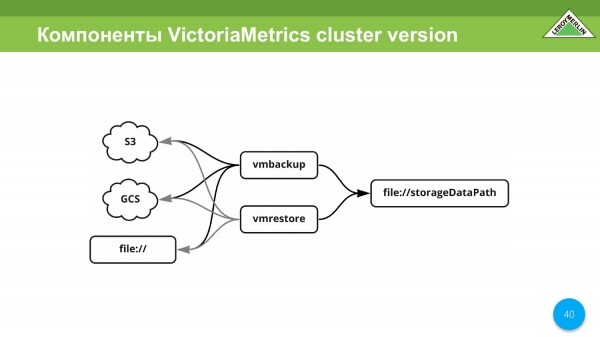
Există, de asemenea, vmbackup, vmrestore. Acestea sunt, în esență, recuperarea și backup-ul tuturor datelor. Suportă S3, GCS, file.
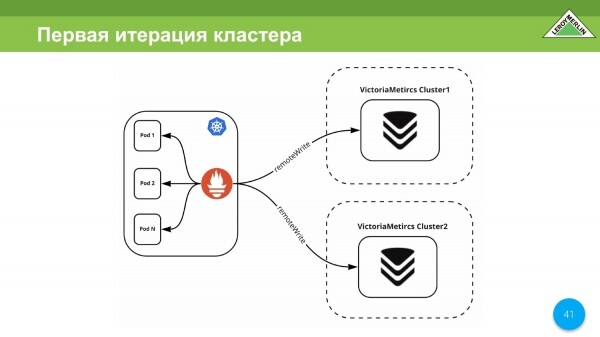
Prima iterație a cluster-ului nostru a fost realizată în timpul carantinei. La acea vreme nu aveam replici, așadar iterația noastră consta în două clustere diferite și independente, din care primeam date prin remoteWrite.
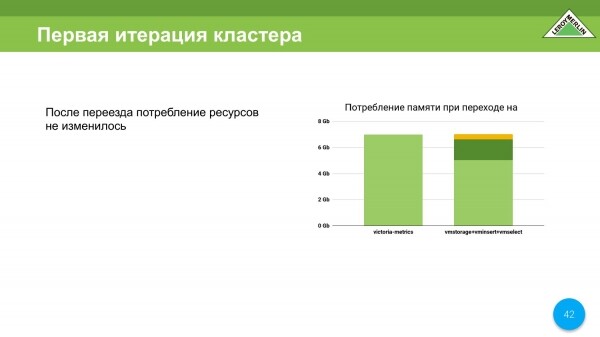
Aici aș dori să menționez că, atunci când am trecut de la VictoriaMetrics Single Node la versiunea cluster a VictoriaMetrics, am rămas totuși cu aceleași resurse consumate, adică principalul - este memoria. Cam așa s-au distribuit datele noastre, adică consumul de resurse.
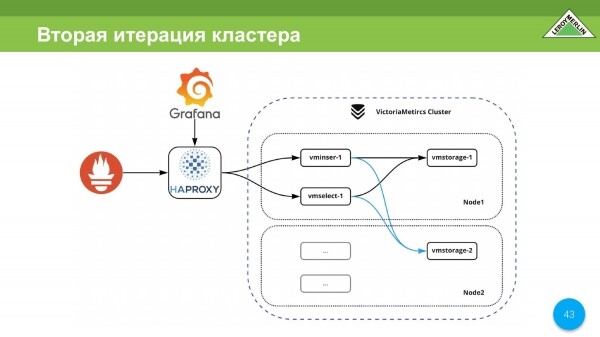
Aici deja a fost adăugată o replică. Am unit toate acestea într-un cluster relativ mare. Toate datele noastre sunt atât shard-uite, cât și replicate.
Întregul cluster are N puncte de intrare, adică Prometheus poate adăuga date prin HAPROXY. Aici avem acest punct de intrare. Și prin acest punct de intrare se poate accesa cu Grafana.
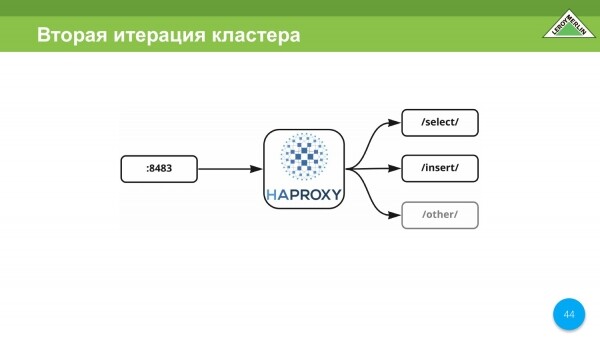
În cazul nostru, HAPROXY este singurul port care proxează select, insert și celelalte servicii în interiorul acestui cluster. În cazul nostru nu a fost posibil să avem o singură adresă, a trebuit să creăm mai multe puncte de intrare, deoarece mașinile virtuale pe care rulează clusterul VictoriaMetrics se află în zone diferite ale aceluiași furnizor de cloud, adică nu în interiorul cloud-ului nostru, ci în exterior.
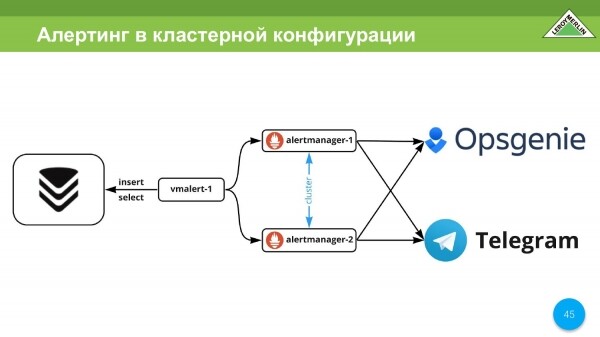
Avem alertare. O folosim. Folosim alertmanager de la Prometheus. Ca canal de livrare a alertelor, folosim Opsgenie și Telegram. În Telegram vin alerte de la dev, poate și ceva de la prod, dar mai mult sunt informații statistice, necesare inginerilor. Iar Opsgenie – critic. Acesta este pentru apeluri, gestionarea incidentelor.
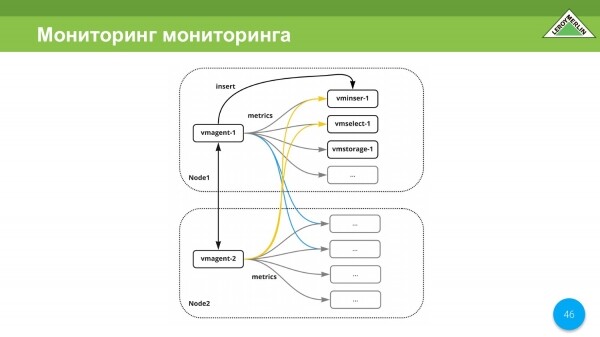
Întrebarea eternă: „Cine monitorizează monitorizarea?”. În cazul nostru, monitorizarea își monitorizează propria monitorizare, deoarece folosim vmagent pe fiecare nod. Și având în vedere că nodurile noastre sunt distribuite în diverse centre de date ale aceluiași furnizor, avem un canal propriu pentru fiecare centru de date, ele sunt independente și chiar dacă apare un split brain, tot vom primi alerte. Da, vor fi mai multe, dar mai bine să avem mai multe alerte decât niciuna.
Încheiem lista noastră cu implementarea HA.
Și aș dori să subliniez experiența de comunicare cu comunitatea VictoriaMetrics. A fost foarte pozitivă. Oamenii sunt receptivi. Ei încearcă să se implice în fiecare caz propus.
Am deschis probleme pe GitHub. Acestea au fost rezolvate foarte repede. Există încă câteva probleme care nu sunt complet închise, dar deja din cod pot vedea că lucrările în această direcție sunt în curs.
Durerea principală în timpul iterațiilor pentru mine a fost că, dacă opream un nod, primele 30 de secunde nu am reușit să înțeleg că backend-ul nu era disponibil. Acum aceasta este deja rezolvată. Și, literalmente, în una sau două secunde, datele sunt preluate deja de la toate celelalte noduri, iar cererea încetează să mai aștepte acel nod lipsă.
Am vrut, într-un anumit moment, să avem operatorul VictoriaMetrics. L-am așteptat. Acum suntem în proces activ de construire a unei interfețe pentru operatorul VictoriaMetrics, pentru a prelua toate regulile de pre-calcul și așa mai departe din Prometheus, deoarece folosim destul de activ regulile care vin împreună cu operatorul Prometheus.
Există sugestii pentru îmbunătățirea implementării clusterului. Le-am expus mai sus.
Și mai vrem foarte mult downsampling. În cazul nostru, downsampling-ul este necesar exclusiv pentru vizualizarea tendințelor. Pe scurt, îmi ajunge o singură metrică pe zi. Aceste tendințe sunt necesare pe un an, pe trei, pe cinci, pe zece ani. Și o singură valoare a metricii este complet suficientă.
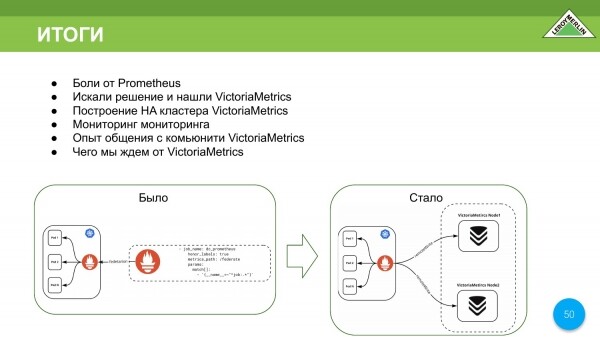
- Am cunoscut durerea, la fel ca și unii dintre colegii noștri, atunci când folosim Prometheus.
- Am ales VictoriaMetrics pentru noi.
- Se scalazează destul de bine atât vertical, cât și orizontal.
- Putem distribui diferite componente pe un număr diferit de noduri în cluster, limitându-le în funcție de memorie, adăugând memorie etc.
Vom folosi VictoriaMetrics deoarece ne-a plăcut foarte mult. Iată ce a fost și ce este acum.
Un set de coduri QR pentru chatul VictoriaMetrics, contactele mele, tehnologia LeroyMerlin.
Sursa: habr.com
