

Bună ziua tuturor, împărtășim cu voi a doua parte a publicației „Sistemele de fișiere virtuale în Linux: de ce sunt necesare și cum funcționează?” Prima parte poate fi citită . Reamintim că această serie de publicații este dedicată lansării unui nou flux pentru cursul , care va începe foarte curând.
Cum să observați VFS cu ajutorul instrumentelor eBPF și bcc
Cel mai simplu mod de a înțelege cum operează nucleul cu fișierele sysfs – este să urmăriți acest proces în practică, iar cel mai simplu mod de a observa ARM64 – este să folosiți eBPF. eBPF (prescurtare de la Berkeley Packet Filter) constă dintr-o mașină virtuală, rulată în , pe care utilizatorii privilegiați o pot solicita (query) din linia de comandă. Sursa nucleului informează cititorul despre ceea ce poate face nucleul; rularea instrumentelor eBPF într-un sistem încărcat arată ceea ce face de fapt nucleul.
Din fericire, începerea utilizării eBPF este destul de ușoară cu ajutorul instrumentelor , care sunt disponibile ca pachete din distribuția generală și sunt documentate în detaliu . Instrumentele bcc sunt scripturi în Python cu mici inserții de cod în C, ceea ce înseamnă că oricine familiarizat cu ambele limbi le poate modifica cu ușurință. În bcc/tools există 80 de scripturi Python, ceea ce înseamnă că, cel mai probabil, dezvoltatorul sau administratorul de sistem va putea găsi ceva potrivit pentru a rezolva problema.
Pentru a obține cel puțin o imagine de ansamblu despre munca pe care o desfășoară VFS într-un sistem activ, încercați vfscount sau vfsstat. Aceasta va arăta, de exemplu, că zeci de apeluri vfs_open() și „prietenii săi” au loc literalmente în fiecare secundă.
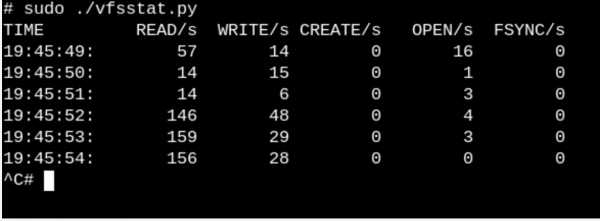
vfsstat.pyeste un script în Python, cu inserții de cod C, care pur și simplu numără apelurile funcțiilor VFS.
Să dăm un exemplu mai trivial și să vedem ce se întâmplă când conectăm un stick USB la calculator și este detectat de sistem.
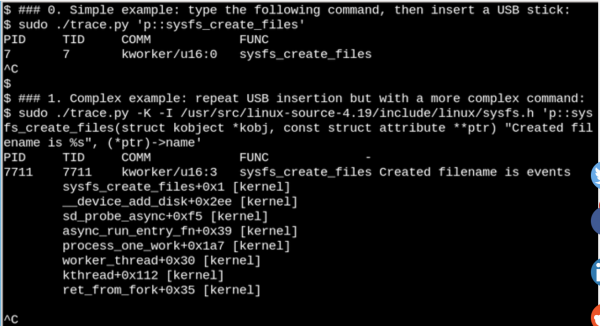
Cu ajutorul eBPF, putem observa ceea ce se întâmplă în
/sys, atunci când este inserat stick-ul USB. Aici este prezentat un exemplu simplu și unul complex.
În exemplul arătat mai sus, bcc un instrument afisează un mesaj când este executată comanda sysfs_create_files(). Vedem că sysfs_create_files() a fost pornit cu ajutorul kworker fireii ca răspuns la faptul că stick-ul a fost inserat, dar ce fișier a fost creat? Al doilea exemplu arată toată puterea eBPF. Aici trace.py oferă o trasare inversă a nucleului (kernel backtrace) (opțiunea -K) și numele fișierului care a fost creat sysfs_create_files(). Inserarea în citate simple este un cod C, care include un șir de formatare ușor de recunoscut, asigurat de un script Python care rulează LLVM compilator just-in-time. Acest șir este compilat și executat în mașina virtuală din interiorul nucleului. Semnătura completă a funcției sysfs_create_files () trebuie să fie reprodusă în al doilea comanda, pentru ca șirul de formatare să poată face referire la unul dintre parametrii. Erorile din acest fragment de cod C duc la erori recognoscibile ale compilatorului C. De exemplu, dacă este omis parametrul -l, vei vedea "Failed to compile BPF text." Dezvoltatorii care sunt familiarizați cu C și Python vor găsi instrumentele bcc ușor de extins și modificat.
Când unitatea USB este introdusă, trasarea inversă a nucleului va arăta că PID 7711 este firul kworker, care a creat fișierul „events” în sysfs. Prin urmare, apelul cu sysfs_remove_files() va arăta că eliminarea unității a dus la ștergerea fișierului , care este utilizată pentru, ceea ce corespunde conceptului general de numărare a referințelor. În acest caz, vizualizarea sysfs_create_link () cu eBPF în timpul introducerii unității USB va arăta că au fost create nu mai puțin de 48 de linkuri simbolice.
Așadar, care este sensul fișierului events? Utilizarea pentru a căuta , arată că aceasta apelează disk_add_events (), și fie "media_change", sau "eject_request" pot fi scrise în fișierul de evenimente. Aici, stratul de blocuri al nucleului informează userspace despre apariția și extragerea „discului”. Observați cât de informativ este acest mod de cercetare în cazul introducerii unității USB comparativ cu încercările de a descoperi cum funcționează totul exclusiv din sursele de cod.
Sistemele de fișiere rădăcină numai pentru citire permit dispozitivele încorporate
Desigur, nimeni nu oprește serverul sau computerul său trăgându-l din priză. Dar de ce? Totul se datorează faptului că sistemele de fișiere montate pe dispozitivele fizice de stocare pot avea scrieri amânate, iar structurile de date care le înregistrează starea pot să nu se sincronizeze cu înregistrările din stocare. Când se întâmplă acest lucru, proprietarii sistemului trebuie să aștepte următoarea pornire pentru a rula utilitarul fsck filesystem-recovery și, în cel mai rău caz, să piardă date.
Cu toate acestea, știm cu toții că multe dispozitive IoT, precum și routerele, termostatele și automobilele, funcționează acum pe Linux. Multe dintre aceste dispozitive nu au practic interfață pentru utilizator și nu există nicio modalitate de a le opri „complet”. Imaginați-vă să porniți o mașină cu bateria descărcată, când alimentarea dispozitivului de control oscilează constant. Cum se face că sistemul pornește fără un lung fsck, atunci când motorul începe în sfârșit să funcționeze? Răspunsul este simplu. Dispozitivele încorporate se bazează pe un sistem de fișiere rădăcină (prescurtat ro-rootfs (sistem de fișiere rădăcină doar pentru citire).
ro-rootfs oferă multe avantaje, care sunt mai puțin evidente decât autenticitatea. Unul dintre aceste avantaje este că malware-ul nu poate scrie în /usr sau /lib, deoarece niciun proces Linux nu poate scrie acolo. Un alt avantaj este că un sistem de fișiere în mare parte neschimbabil este esențial pentru suportul de teren al dispozitivelor de la distanță, deoarece personalul auxiliar folosește sisteme locale care sunt nominal egale cu sistemele de la fața locului. Poate că cel mai important (dar și cel mai insidios) avantaj este că ro-rootfs îi forțează pe dezvoltatori să decidă care obiecte de sistem vor fi neschimbabile în stadiul de proiectare al sistemului. Lucrul cu ro-rootfs poate fi incomod și dureros, așa cum se întâmplă adesea cu variabilele const în limbajele de programare, dar avantajele lor compensează cu ușurință costurile suplimentare.
Crearea rootfs doar pentru citire necesită un efort suplimentar din partea dezvoltatorilor de sisteme încorporate, iar aici intervine VFS. Linux necesită ca fișierele în /var să fie accesibile pentru scriere, iar, în plus, multe aplicații populare care rulează pe sistemele încorporate vor încerca să creeze fișiere de configurare dot-files în $HOME. O soluție pentru fișierele de configurare din directorul personal este, în general, generarea lor preliminară și montarea într-o rootfs. Pentru /var abordare posibilă este să fie montat într-o partiție separată, accesibilă pentru scriere, în timp ce / este montat doar pentru citire. O altă alternativă populară este utilizarea montărilor legate sau suprapuse (bind sau overlay mounts).
Mounturi legate și suprapuse, utilizarea acestora de către containere
Executarea comenzilor man mount este cea mai bună metodă de a învăța despre mounturi legate și suprapuse, care oferă dezvoltatorilor și administratorilor de sistem posibilitatea de a crea un sistem de fișiere într-un anumit loc și apoi de a-l pune la dispoziția aplicațiilor într-altul. Pentru sistemele încorporate, aceasta implică posibilitatea de a stoca fișiere în /var pe un dispozitiv flash disponibil doar pentru citire, dar montarea suprapusă sau legată a unei căi din tmpfs în /var la încărcare va permite aplicațiilor să scrie acolo note (scrawl). La următoarea pornire, modificările din /var vor fi pierdute. Montarea suprapusă creează o fuziune între tmpfs și sistemul de fișiere de bază și permite efectuarea unor modificări aparent ale fișierelor existente în ro-tootf în timp ce montarea legată poate face noile foldere goale vizibile ca fiind disponibile pentru scriere în tmpfs căi. În timp ce ro-rootfs overlayfs este tipul corect ( proper) de sistem de fișiere, montarea legată este implementată înspațiul numel VFS .
containerele Linux pentru a lansa un container, utilizând instrumentul mountsnoop system-nspawn de la bcc.
Apel lancează containerul în timpul execuției mountsnoop.py în timpul "încărcării" containerului arată că mediul de execuție al containerului depinde foarte mult de montarea legată (Afișează doar începutul unei ieșiri lungi)..
Să vedem ce a ieșit:
Pornire system-nspawn oferă fișierele selectate din
Aici systemd-nspawn gazda în container ca căi în procfs și sysfs . În plus față de rootfsMS_BIND flag, care stabilește montarea legată, alte câteva flage în sistemul montat determină relația între modificările din spațiul numel gazdei și containerului. De exemplu, montarea legată poate fie să permită modificările în în container, fie să le ascundă în funcție de apel. /proc și /sys Înțelegerea structurii interne a Linux poate părea o sarcină imposibilă, deoarece nucleul conține o cantitate uriașă de cod, lăsând deoparte aplicațiile din spațiul utilizatorului Linux și interfețele de apel ale sistemului în biblioteci în limbajul C, cum ar fi
Concluzie
Înțelegerea funcționării interne a Linux poate părea o sarcină imposibilă, deoarece nucleul său conține o cantitate uriașă de cod, lăsând deoparte aplicațiile din spațiul utilizatorului Linux și interfețele de apel de sistem din biblioteci scrise în C, precum glibc. Una dintre modalitățile de a progresa este să citim codul sursă al unei subsisteme a nucleului, concentrându-ne asupra înțelegerii apelurilor de sistem și a header-elor adresate spațiului utilizatorului, precum și a interfețelor interne de bază ale nucleului, de exemplu, tabela. file_operations. Operațiunile pe fișiere asigură principiul „totul este un fișier”, astfel că gestionarea lor este deosebit de plăcută. Fișierele sursă ale nucleului în limbajul C se află în directorul de nivel superior. fs/ ele reprezintă implementarea sistemelor de fișiere virtuale, care sunt un strat de tablă ce asigură o compatibilitate largă și relativ simplă cu sistemele de fișiere populare și dispozitivele de stocare. Montarea prin legare și suprapunerea prin spațiile de nume Linux este magia VFS, care face posibilă crearea containerelor și sistemelor de fișiere de bază doar pentru citire. Împreună cu studiul codului sursă, instrumentul nucleului eBPF și interfața sa bcc
fac cercetarea nucleului mai ușoară ca niciodată.
Prietenii, ați scris dacă acest articol v-a fost util? Poate aveți comentarii sau observații? Iar cei care sunt interesați de cursul „Administrator Linux” sunt invitați la , care va avea loc pe 18 aprilie.
Sursa: habr.com
