

Articolul acestui subiect a fost inspirat de cantitatea mare de materiale despre analiza statică, care apar din ce în ce mai des. În primul rând, este vorba despre , care se promovează activ pe Habr prin recenzii ale erorilor descoperite de instrumentul lor în proiecte open-source. Recent, PVS-studio a implementat , iar, desigur, dezvoltatorii IntelliJ IDEA, al căror analizor încorporat este, probabil, cel mai avansat pentru Java, .
Citind astfel de recenzii, ai senzația că este vorba despre un elixir magic: apasă pe un buton și iată-l - o listă de defecte în fața ta. Se pare că, pe măsură ce analizorii devin mai perfecționați, bug-urile vor fi găsite din ce în ce mai multe, iar produsele scanate de acești roboți vor deveni din ce în ce mai bune, fără niciun efort din partea noastră.
Dar nu există elixire magice. Aș dori să discut despre ceea ce de obicei nu se menționează în posturi de genul „iată ce poate găsi robotul nostru”: ce nu pot face analizorii, care este rolul și locul lor real în procesul de livrare a software-ului și cum să îi implementăm corect.
Zgârci (sursa: ).
Ce nu vor putea face niciodată analizorii statici
Ce înseamnă, din punct de vedere practic, analiza codului sursă? Introducem anumite surse, iar la ieșire, într-un timp foarte scurt (mult mai scurt decât rularea testelor), obținem anumite informații despre sistemul nostru. O limitare principială și matematic imposibil de depășit este că putem obține astfel doar o clasă destul de restrânsă de informații.
Cea mai cunoscută problemă care nu poate fi rezolvată prin analiza statică este : aceasta este o teoremă care dovedește că nu este posibil să dezvolți un algoritm general care, pe baza codului sursă al unui program, să determine dacă se va bloca într-un ciclu sau se va finaliza într-un timp finit. O extensie a acestei teoreme este , afirmând că pentru orice proprietate non-trivială a funcțiilor computabile, definiția dacă un program oarecare calculează o funcție cu această proprietate este o sarcină algoritmic imposibil de rezolvat. De exemplu, este imposibil să scrii un analizator care, pentru orice cod sursă, să determine dacă programul analizat este o implementare a unui algoritm care calculează, să zicem, ridicarea la pătrat a unui număr întreg.
Astfel, funcționalitatea analizatorilor statici are limitări greu de depășit. Un analizator static nu va putea niciodată să determine în toate cazurile aspecte precum, de exemplu, apariția «null pointer exception» în limbaje care permit valoarea null, sau în toate cazurile să determine apariția «attribute not found» în limbaje cu tipizare dinamică. Tot ce poate face cel mai sofisticat analizator static este să evidențieze cazuri particulare, numărul cărora în rândul tuturor problemelor posibile cu codul tău sursă este, fără exagerare, o picătură în mare.
Analiză statică — nu este căutarea bug-urilor
Din cele spuse mai sus reiese o concluzie: analiza statică nu este un mijloc de reducere a numărului de defecte din program. Îmi permit să afirm că, atunci când este aplicată pentru prima dată în proiectul tău, va găsi în cod locuri «interesante», dar, cel mai probabil, nu va determina defecte care influențează calitatea funcționării programului tău.
Exemplele de defecte, găsite automat de analizatori, sunt impresionante, dar nu trebuie să uităm că aceste exemple au fost găsite prin scanarea unui set mare de baze de cod mari. După aceeași idee, hackeri care au posibilitatea de a verifica câteva parole simple pe un număr mare de conturi ajung, în cele din urmă, să găsească acele conturi care au o parolă simplă.
Înseamnă asta că analiza statică nu trebuie aplicată? Desigur că nu! Și din același motiv pentru care ar trebui să verifici fiecare parolă nouă pentru a nu figura pe lista de «parole simple».
Analiză statică — este mai mult decât căutarea bug-urilor
În realitate, problemele care sunt practic soluționabile prin analiză sunt mult mai diverse. În general, analiza statică este orice verificare a codului sursă care se efectuează înainte de execuția acestuia. Iată câteva lucruri pe care le poți face:
- Verificarea stilului de codare în sens larg al termenului. Aceasta include atât verificarea formatării, cât și căutarea utilizării parantezelor goale/înnăscute, stabilirea valorilor limită pentru metrici precum numărul de linii/complexitatea ciclomatică a metodei etc. - tot ceea ce ar putea îngreuna citibilitatea și întreținerea codului. În Java, un astfel de instrument este Checkstyle, iar în Python, flake8. Programele de acest tip sunt de obicei denumite „lintere”.
- Analiza nu se poate limita doar la codul executabil. Fișierele de resurse, cum ar fi JSON, YAML, XML, .properties pot (și ar trebui!) să fie verificate automat pentru validitate. Este mai bine să afli că structura JSON este ruptă din cauza unor ghilimele nepereche în stadiul inițial al verificării automate a Pull Request-ului, decât în timpul testării sau al execuției? Instrumentele corespunzătoare sunt disponibile: de exemplu, , .
- Compilarea (sau parsarea pentru limbajele de programare dinamice) este de asemenea un tip de analiză statică. De obicei, compilatoarele sunt capabile să emită avertizări care semnalează problemele legate de calitatea codului sursă, și aceste avertizări nu ar trebui ignorate.
- Uneori, compilarea nu se referă doar la compilarea codului executabil. De exemplu, dacă ai documentație în format , atunci în momentul transformării acesteia în HTML/PDF, procesorul AsciiDoctor () poate emite avertizări, de exemplu, despre linkuri interne rupte. Și acesta este un motiv valid pentru a respinge un Pull Request cu modificări în documentație.
- Verificarea ortografiei este de asemenea un tip de analiză statică. Instrumentul poate verifica ortografia nu doar în documentație, ci și în codurile sursă ale programelor (în comentarii și litere) în diferite limbaje de programare, inclusiv C/C++, Java și Python. O greșeală de ortografie în interfața utilizatorului sau în documentație reprezintă de asemenea un defect!
- Testele de configurare (pentru mai multe informații, vezi și prezentările), deși sunt executate în medii de testare unității de tip pytest, sunt de fapt și ele o formă de analiză statică, deoarece nu execută codurile sursă în timpul desfășurării lor.
Așa cum se poate observa, identificarea erorilor din această listă are un rol mai puțin important, în timp ce restul este accesibil prin utilizarea instrumentelor open source gratuite.
Care dintre aceste tipuri de analiză statică ar trebui aplicate în proiectul dumneavoastră? Cu siguranță, cu cât mai multe, cu atât mai bine! Important este să implementați corect, despre ce vom discuta în continuare.
Canalul de livrare ca un filtru în mai multe etape și analiza statică ca primul său cascade.
Metafora clasică a integrării continue este un canal (pipeline) prin care trec modificările — de la schimbarea codului sursă până la livrarea în producție. Secvența standard a etapelor acestui canal arată astfel:
- analiza statică
- compilare
- teste unitare
- teste de integrare
- teste UI
- verificare manuală
Modificările respinse la etapa N a canalului nu sunt transmise etapei N+1.
De ce exact așa și nu altfel? În partea canalului care se ocupă cu testarea, testerele învață despre binecunoscuta piramidă de testare.
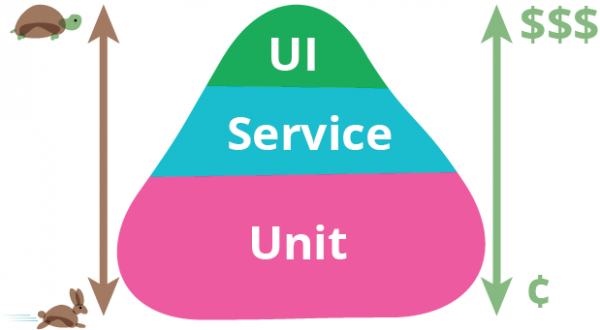
Piramida testelor. Sursa: Martin Fowler.
În partea de jos a acestei piramide se află teste care sunt mai ușor de scris, executate mai repede și nu au tendința de a da alarme false. Prin urmare, ar trebui să fie mai multe, ele ar trebui să acopere mai mult cod și să fie executate primele. În partea de sus a piramidei, lucrurile stau invers, astfel încât numărul testelor de integrare și UI ar trebui să fie redus la minimul necesar. Persoana din această lanț este cea mai scumpă, lentă și nesigură resursă, de aceea se află la sfârșit și își desfășoară activitatea doar în cazul în care etapele anterioare nu au descoperit defecte. Totuși, conform acelorași principii se construiește canalul și în părțile care nu sunt direct legate de testare!
Aș dori să propun o analogie folosind un sistem multistadiu de filtrare a apei. Apa murdară (modificările cu defecte) este introdusă, iar la ieșire trebuie să obținem apă curată, toate contaminările nedorite fiind filtrate.
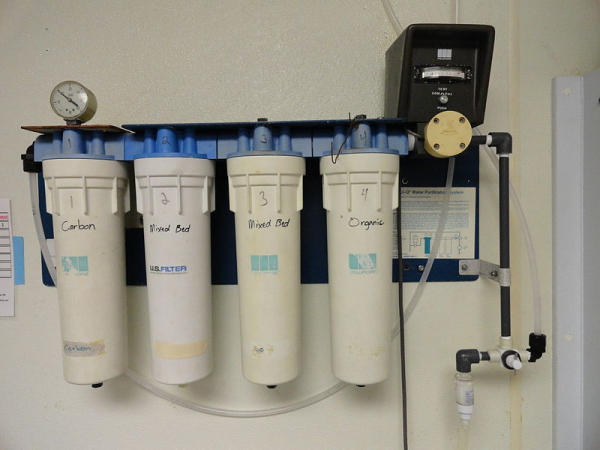
Filtru multistadiu. Sursa:
După cum se știe, filtrele de curățare sunt proiectate astfel încât fiecare următorul stadiu să poată separa fracțiile de impurități din ce în ce mai fine. Astfel, stadiile de curățare mai grosiere au o capacitate de filtrare mai mare și un cost mai mic. În analogia noastră, aceasta înseamnă că porțile de calitate de intrare au o viteză de reacție mai mare, necesită mai puțin efort pentru a porni și sunt, de asemenea, mai puțin exigente în funcționare - și exact în această ordine sunt construite. Rolul analizei statice, care, așa cum am înțeles acum, este capabil să elimine doar cele mai grosiere defecte - este rolul grilei de „prefiltru” la începutul cascadei de filtre.
Analiza statică în sine nu îmbunătățește calitatea produsului final, așa cum un prefiltru nu face apa potabilă. Totuși, în contextul general al altor elemente din linia de producție, importanța sa este evidentă. Deși în filtrele cu mai multe stadii stadiile de ieșire pot captura în mod potențial aceleași impurități ca și cele de intrare - este clar la ce consecințe va duce încercarea de a folosi doar stadiile fine de curățare, fără stadiile de intrare.
Scopul prefiltrului este de a descărca stadiile următoare de captarea defectelor complet grosiere. De exemplu, cu siguranță, persoana care efectuează revizuirea codului nu ar trebui să fie distrasă de un cod formatat greșit și de încălcări ale normelor de codare stabilite (precum paranteze inutile sau ramificații prea adânci). Bug-urile, precum NPE, ar trebui să fie capturate de testele de unitate, dar dacă, înainte de test, analizatorul ne indică faptul că bug-ul va apărea inevitabil - aceasta va accelera semnificativ corectarea sa.
Cred că acum este clar de ce analiza statică nu îmbunătățește calitatea produsului atunci când este aplicată episodic și ar trebui aplicată constant pentru a elimina modificările cu defecte grosiere. Întrebarea dacă utilizarea analizorului static va îmbunătăți calitatea produsului vostru este aproximativ echivalentă cu întrebarea „se vor îmbunătăți calitățile de potabilitate ale apei prelevate dintr-un bazin murdar, dacă o treci printr-o sită?”.
Implementarea în proiecte legacy
O întrebare practică importantă: cum putem integra analiza statică în procesul de integrare continuă ca „barieră de calitate”? În cazul testelor automate, totul este clar: există un set de teste, eșecul oricăruia dintre ele este un motiv suficient pentru a considera că construcția nu a trecut barrieră de calitate. Încercarea de a stabili o barieră pe baza rezultatelor analizei statice eșuează: în codul legacy, numărul de avertismente ale analizei este prea mare, nu dorim să le ignorăm complet, dar nici nu putem opri livrarea produsului doar pentru că acesta conține avertismente ale analizoarelor.
Atunci când este aplicat pentru prima dată, pe orice proiect, analizoarele generează o cantitate imensă de avertismente, majoritatea cărora nu au legătură cu funcționarea corectă a produsului. Corectarea imediată a tuturor acestor observații este imposibilă, iar multe dintre ele — nici nu sunt necesare. În fond, noi știm că produsul nostru funcționează în general și înainte de implementarea analizei statice!
Din acest motiv, mulți se limitează la utilizarea ocazională a analizei statice sau o folosesc doar în modul de informare, când la construirea proiectului se emite pur și simplu un raport al analizei. Aceasta este echivalentă cu lipsa oricărei analize, deoarece dacă avem deja multe avertismente, apariția unui altul (indiferent de seriozitate) atunci când se modifică codul rămâne neobservată.
Se cunosc următoarele metode de introducere a barrierelor de calitate:
- Stabilirea unei limite a numărului total de avertismente sau a numărului de avertismente, împărțit la numărul de linii de cod. Aceasta funcționează prost, deoarece o astfel de barieră permite liber modificări cu noi defecte, atâta timp cât limita nu este depășită.
- Fixarea, într-un anumit moment, a tuturor avertismentelor vechi din cod ca fiind ignorate și refuzul compilării în cazul apariției unor avertismente noi. Această funcționalitate este oferită de PVS-studio și unele resurse online, cum ar fi Codacy. Nu am avut ocazia să lucrez cu PVS-studio, iar în ceea ce privește experiența mea cu Codacy, principala lor problemă constă în faptul că determinarea a ceea ce este un „vechi” și ce este un „nou” avertisment este un algoritm destul de complicat și care nu funcționează întotdeauna corect, mai ales dacă fișierele sunt modificate sau redenumite semnificativ. Din cele ce-mi amintesc, Codacy putea să sară peste noi avertismente într-un pull request și, în același timp, să nu permită pull request-ul din cauza unor avertismente care nu aveau legătură cu modificările din codul acestui PR.
- Din punctul meu de vedere, cea mai eficientă soluție este cea descrisă în cartea „metoda ratchet-ului” („ratcheting”). Ideea de bază este că proprietatea fiecărei versiuni este numărul de avertismente de analiză statică, iar schimbările permise sunt doar acelea care nu cresc numărul total de avertismente.
Ratcheting
Funcționează astfel:
- În etapa inițială, se realizează înregistrarea în metadatele versiunii a numărului de avertismente din cod, găsite de analizatori. Astfel, la compilarea ramurii principale, în managerul dvs. de repositorii se va înregistra nu doar „versiunea 7.0.2”, ci „versiunea 7.0.2, care conține 100500 avertismente Checkstyle”. Dacă utilizați un manager avansat de repositorii (cum ar fi Artifactory), este ușor să salvați astfel de metadate despre versiunea dvs.
- Acum, fiecare pull request la compilare compară numărul de avertismente obținute cu numărul care există în versiunea curentă. Dacă PR determină o creștere a acestui număr, atunci codul nu trece testul de calitate prin analiza statică. Dacă numărul de avertismente scade sau rămâne neschimbat, atunci trece.
- La următoarea versiune, numărul recalculează avertismentele va fi din nou înregistrat în metadatele versiunii.
Astfel, treptat, dar constant (ca la funcționarea unui mecanism de tip ratchet), numărul de avertizări va tinde spre zero. Desigur, sistemul poate fi păcălit, introducând o nouă avertizare, dar corectând una existentă. Este în regulă, deoarece pe termen lung se obține un rezultat: avertizările sunt corectate, de obicei, nu individual, ci simultan într-un anumit grup, iar toate avertizările ușor eliminabile sunt rezolvate destul de repede.
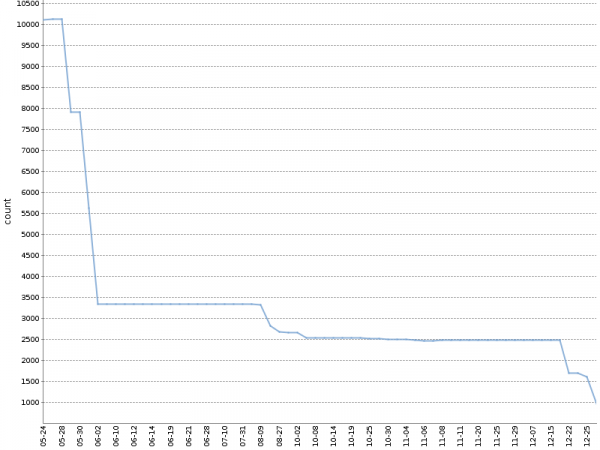
În acest grafic este prezentat numărul total de avertizări Checkstyle pe parcursul a șase luni de lucru cu un astfel de „mecanism ratchet” pe . Numărul de avertizări a scăzut cu o ordine de mărime, iar acest lucru s-a întâmplat natural, în paralel cu dezvoltarea produsului!
Aplic o versiune modificată a acestei metode, numărând separat avertizările în funcție de modulele proiectului și instrumentele de analiză, fișierul YAML cu metadate despre construcție arată aproximativ astfel:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
În orice sistem CI avansat, „mecanismul ratchet” poate fi implementat pentru orice instrumente de analiză statică, fără a se baza pe plugin-uri și instrumente externe. Fiecare dintre analizatori produce propriul raport într-un format text simplu sau XML, ușor de analizat. Rămâne doar să scriem logica necesară în scriptul CI. Putem observa cum este implementat în proiectele noastre open source bazate pe Jenkins și Artifactory sau . Ambele exemple depind de biblioteca : metoda countWarnings() numără în mod obișnuit etichetele xml din fișierele generate de Checkstyle și Spotbugs, iar compareWarningMaps() implementa acel mecanism ratchet, generând o eroare în cazul în care numărul de avertizări din oricare dintre categorii crește.
O variantă interesantă de implementare a „rachetă” este posibilă pentru analiza ortografiei comentariilor, literelor text și documentației cu ajutorul aspell. Așa cum se știe, în timpul verificării ortografiei, nu toate cuvintele necunoscute pentru dicționarul standard sunt greșite; acestea pot fi adăugate în dicționarul utilizatorului. Dacă facem dicționarul utilizatorului parte din codul sursă al proiectului, atunci quality gate pentru ortografie poate fi formulat astfel: rularea aspell cu dicționarul standard și cel personalizat. să găsească erori de ortografie.
Despre importanța fixării versiunii analizoarelor
În concluzie, trebuie să menționăm următoarele: indiferent de modul în care implementați analiza în fluxul dvs. de livrare, versiunea analizoarelor trebuie să fie fixată. Dacă permiteți actualizarea spontană a analizoarelor, atunci la compilarea următorului pull request pot apărea noi defecte, care nu sunt legate de modificarea codului, ci de faptul că noul analizor poate descoperi mai multe defecte — și asta vă va afecta procesul de acceptare al pull request-urilor. Upgrade-ul analizoarelor ar trebui să fie o acțiune conștientă. Totuși, fixarea strictă a versiunii fiecărei componente a compilării este, în general, o cerință necesară și un subiect pentru o discuție separată.
Conclusions
- Analiza statică nu va găsi bug-uri și nu va îmbunătăți calitatea produsului dvs. în urma unei singure utilizări. Efectul pozitiv asupra calității este dat doar de utilizarea constantă a acesteia în procesul de livrare.
- Căutarea bug-urilor nu este, în general, principala sarcină a analizei; majoritatea funcțiilor utile sunt disponibile în instrumentele open-source.
- Implementați quality gates pe baza rezultatelor analizei statice încă din prima etapă a fluxului de livrare, folosind „rachetă” pentru codul moștenit.
Linkuri
- prezentare despre diferite metode de analiză a codului (nu doar static!)
Sursa: habr.com
