

Povestea
Așa s-a întâmplat că serverul a fost atacat de un virus ransomware, care, prin "norocul întâmplării", a lăsat parțial neafectuate fișierele .ibd (fișierele cu date brute ale tabelelor innodb), dar a criptat complet fișierele .fpm (fișierele structurale). Astfel, .idb putea fi împărțit în:
- fișiere ce pot fi recuperate prin metode standard și ghiduri. Pentru astfel de cazuri, există o excelentă ;
- tabele parțial criptate. Predominant, acestea sunt tabele mari, la care (așa am înțeles eu), atacatorii nu au avut suficientă memorie operativă pentru a le cripta complet;
- și tabele complet criptate, care nu pot fi recuperate.
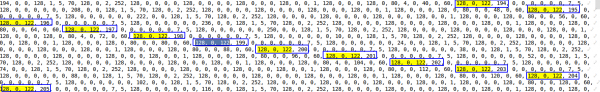
Am reușit să determin la ce tip aparțin tabelele prin simpla deschidere a fișierului în orice editor de text cu codificarea necesară (în cazul meu, aceasta este UTF8) și pur și simplu să vizualizez fișierul în căutarea câmpurilor de text, de exemplu:
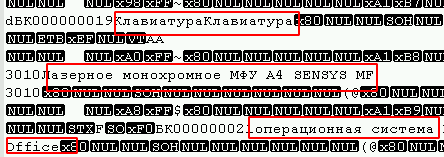
De asemenea, la începutul fișierului se pot observa o mulțime de byte-uri de zero, iar virusurile ce folosesc algoritmi de criptare pe blocuri (destul de comune) le afectează de obicei și pe acestea.

În cazul meu, atacatorii lăsau la sfârșitul fiecărui fișier criptat un șir de 4 byte-uri (1, 0, 0, 0), ceea ce a simplificat sarcina. Pentru a găsi fișierele necontaminate, a fost suficient un script:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Astfel, am reușit să găsesc fișierele aparținând primului tip. Al doilea implică o muncă manuală îndelungată, dar cele găsite erau suficiente. Totul ar fi fost bun, dar trebuie să știi structura exactă și (desigur) a apărut o situație în care a trebuit să lucrez cu o tabelă care se schimba des. Nimeni nu își aducea aminte dacă tipul câmpului s-a schimbat sau a fost adăugat un nou coloană.
Din păcate, Debris City nu a putut ajuta cu un astfel de caz, de aceea este scris acest articol.
Mai aproape de subiect
Există o structură a tabelei de acum 3 luni care nu coincide cu cea actuală (posibil pe un câmp sau mai multe). Structura tabelei:
CREAȚI TABELA `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
în acest sens, trebuie să extragem:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Pentru recuperare se folosește analiza pe octeți a fișierului .ibd, cu conversia ulterioară într-o formă mai ușor de citit. Deoarece pentru a găsi ceea ce ne trebuie, este suficient să analizăm tipurile de date precum int și datetime, articolul va descrie doar acestea, dar uneori voi face referire și la alte tipuri de date, ceea ce poate ajuta în alte incidente asemănătoare.
Problema 1: în câmpurile cu tipurile DATETIME și TEXT existau valori NULL, iar în fișier ele sunt pur și simplu omișionate, din această cauză, a fost imposibil să determin structura pentru recuperare în cazul meu. În noile coloane, valoarea implicită era null, iar o parte a tranzacției putea fi pierdută din cauza setării innodb_flush_log_at_trx_commit = 0, astfel încât pentru a determina structura ar fi fost necesar să se aloce timp suplimentar.
Problema 2: trebuie să țineți cont că rândurile șterse prin DELETE vor rămâne în continuare în fișierul ibd, dar în urma ALTER TABLE structura lor nu va fi actualizată. Ca urmare, structura datelor poate varia de la începutul fișierului până la sfârșitul său. Dacă utilizați frecvent OPTIMIZE TABLE, este puțin probabil să întâlniți această problemă.
Vă rugăm să observați, versiunea SGBD afectează modul de stocare a datelor, iar acest exemplu poate să nu funcționeze pentru alte versiuni majore. În cazul meu, am folosit versiunea de Windows mariadb 10.1.24. De asemenea, deși în mariadb lucrați cu tabele InnoDB, de fapt acestea sunt , ceea ce exclude aplicabilitatea metodei cu InnoDB mysql.
Analiza fișierului
În python, tipul de date afişează datele în unicode în locul setului obișnuit de numere. Deși fișierul poate fi vizualizat și în această formă, pentru confort se pot converti octeții în formă numerică, transformând matricea de octeți într-o matrice obișnuită (list(example_byte_array)). În orice caz, pentru analiză vor fi utile ambele metode.
Examinând mai multe fișiere ibd, se pot întâlni următoarele:
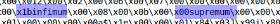
Și, dacă împărțim fișierul după aceste cuvinte cheie, vom obține blocuri de date predominant uniforme. Vom folosi infimum ca divizor.
table = table.split("infimum".encode())O observație interesantă, pentru tabelele cu un număr mic de date, între infimum și supremum există un indicator al numărului de rânduri din bloc.
 — tabel de test cu 1 rând
 — tabel de test cu 2 rânduri
Array-ul de rânduri table[0] poate fi omis. După examinarea acestuia, nu am reușit să descoper datele brute ale tabelelor. Cel mai probabil, acest bloc servește pentru stocarea indicilor și cheilor.
Începând de la table[1] și transformându-l într-un array numeric, deja se pot observa anumite pattern-uri, și anume:
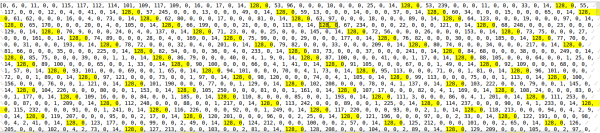
Acestea sunt valori int stocate în rând. Primul byte indică dacă numărul este pozitiv sau negativ. În cazul meu, toate numerele sunt pozitive. Din ceilalți 3 byte, se poate determina numărul folosind următoarea funcție. Script:
def find_int(val: str):  # exemplu '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
De exemplu, 128, 0, 0, 1 = 1, sau 128, 0, 75, 108 = 19308.
În tabel se găsea o cheie primară cu auto-increment, și aici o putem descoperi și noi.
Comparând datele din tabelele de test, s-a constatat că obiectul DATETIME constă din 5 byte și începe cu 153 (cel mai probabil indică intervale anuale). Deoarece intervalul DATETIME este '1000-01-01' până la '9999-12-31', cred că numărul de byte poate varia, dar în cazul meu, datele se încadrează în intervalul 2016-2019, așa că vom considera că 5 byte sunt suficienți.
Pentru a determina timpul fără secunde, au fost scrise următoarele funcții. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Pentru an și lună nu am reușit să scriu o funcție funcțională, așa că a trebuit să fac hardcoding. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Sunt sigur că, dacă se investește un timp n, această neînțelegere poate fi corectată.
Mai departe, o funcție care returnează un obiect datetime dintr-un șir. Script:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Am reușit să identific valori adesea repetate din int, int, datetime, datetime 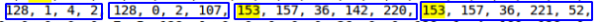 , pare că aceasta este ceea ce trebuie. În plus, o astfel de secvență nu se repetă de două ori într-un șir.
Folosind expresii regulate, găsim datele necesare:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Rețineți că, în căutarea cu această expresie, nu vor putea fi determinate valorile NULL în câmpurile necesare, dar în cazul meu acest lucru nu este critic. Apoi, în ciclul de iterație, parcurgem rezultatele găsite. Script:
rezultat = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    rezultat.append(pre_result)
În esență, datele din array-ul rezultat sunt ceea ce avem nevoie.
Înțeleg că această metodă nu va fi potrivită pentru toată lumea, dar scopul principal al articolului este mai degrabă să încurajeze acțiunea decât să rezolve toate problemele voastre. Cred că cel mai corect ar fi să începeți să studiați codul sursă al acesteia. , dar din cauza timpului limitat, metoda actuală a părut cea mai rapidă.
În unele cazuri, analizând fișierul, veți putea determina structura aproximativă și să o reconstruiți prin una dintre metodele standard menționate mai sus. Aceasta va fi mult mai corect și va cauza mai puține probleme.
Sursa: habr.com
