

Salut, și mai întâi un pic de lirică. Uneori invidiez colegii care lucrează de la distanță - este minunat să ai posibilitatea de a lucra din orice colț al lumii conectate la Internet, vacanțe oricând, responsabilitate pentru proiecte și termene limită, nu doar să fii în birou de la 8 la 17. Poziția mea și responsabilitățile mele de muncă exclud practic posibilitatea de a fi mult timp absent din centrul de date. Cu toate acestea - ocazional apar cazuri interesante, asemănătoare celui descris mai jos - și înțeleg că există puține poziții care oferă atât de mult spațiu pentru exprimarea creativă a unui troubleshooter intern.
O mică precizare - în momentul scrierii acestui articol, cazul nu este complet rezolvat, dar având în vedere viteza de răspuns a furnizorilor, soluția completă poate dura încă luni, iar eu vreau să împărtășesc descoperirile mele deja acum. Sper, dragi cititori, că îmi veți ierta această grabă. Dar destul cu introducerile - ce se întâmplă cu cazul?
Mai întâi, o introducere: există o firmă (unde lucrez ca inginer de rețea), care găzduiește soluții pentru clienți în cloud-ul privat VMWare. Cele mai multe soluții noi sunt conectate la segmentele VXLAN, care sunt gestionate de NSX-V - nu voi evalua cât timp mi-a oferit această soluție, pe scurt - mult. Am reușit chiar să îi învăț pe colegi să configureze NSX ESG, iar soluțiile mici pentru clienți sunt desfășurate fără intervenția mea. O mențiune importantă - control plane-ul nostru folosește replicare unicast. Hypervizorii sunt conectați redundant prin două interfețe la diferite comutatoare fizice Juniper QFX5100 (asamblează în Virtual Chassis) și politica de temporizare a rutelor se bazează pe portul virtual de origine - aceasta pentru a completa imaginea.
Soluțiile pentru clienți sunt foarte variate: de la Windows IIS, unde toate componentele serverului web sunt instalate pe o singură mașină, până la soluții destul de mari - de exemplu, fronturi web Apache load-balanced + LB MariaDB în Galera + servere de partajare, sincronizate cu GlusterFS. Practic, fiecare server trebuie monitorizat separat, iar adresele publice nu sunt disponibile pentru toate componentele - dacă ați întâlnit această problemă și aveți o soluție mai elegantă, aș fi recunoscător pentru sfaturi.
Soluția mea de monitorizare constă în „conectarea” unui firewall (Fortigate) la fiecare rețea internă de client (+SNAT și, desigur, restricții stricte privind tipurile de trafic permise) și monitorizarea adreselor interne — astfel se realizează o anumită unificare și simplificare a monitorizării. Monitorizarea se efectuează dintr-un cluster de servere PRTG. Schema de monitorizare este aproximativ așa:
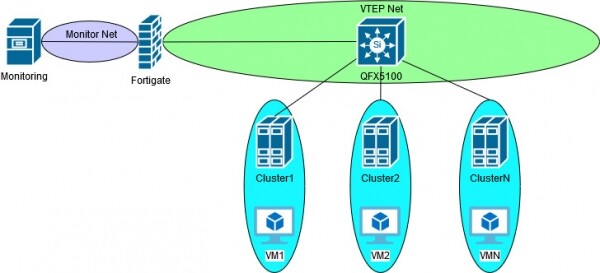
Până când am operat doar cu VLAN, totul era destul de obișnuit și funcționa ca un ceas. După implementarea NSX-V și VXLAN, am întâmpinat pregunta — putem continua monitorizarea așa cum am făcut până acum? La momentul acestei întrebări, cea mai „rapidă” soluție era să desfășurăm NSX ESG și să conectăm interfața trunk VXLAN în rețeaua VTEP. Rapid în ghilimele — deoarece utilizarea GUI pentru configurarea rețelelor clientului, SNAT și regulile firewall-ului poate unifica managementul într-un singur interfață vSphere, dar, în opinia mea, este destul de greoaie și, printre altele, limitează setul de instrumente pentru depanare. Cei care au folosit NSX ESG ca înlocuire pentru un firewall „real” cred că vor fi de acord. Deși, probabil, o astfel de soluție ar fi mai stabilă — având în vedere că totul se desfășoară în cadrul unui singur furnizor.
O altă soluție este utilizarea NSX DLR în modul de bridge între VLAN și VXLAN. Aici cred că este clar — pur și simplu se pierde beneficiul utilizării VXLAN — deoarece în acest caz trebuie să aducem VLAN la instalația de monitorizare. Apropo, în procesul de implementare a acestei soluții m-am confruntat cu problema în care DLR-bridge nu trimitea pachete către mașina virtuală cu care se afla pe același host. Știu, știu — în cărțile și ghidurile despre NSX-V se spune clar că pentru NSX Edge ar trebui să fie alocat un cluster separat, dar asta este în cărți... Așa sau altfel, după câteva luni de suport tehnic, problema nu a fost rezolvată. În principiu, am înțeles logica de funcționare — modulul nucleului hipervizorului, responsabil pentru încapsularea VXLAN, nu era activat dacă DLR și serverul observat se aflau pe același host, deoarece traficul nu părăsește hostul și, conform logicii, ar trebui să fie conectat la segmentul VXLAN — încapsularea nu este necesară. Cu suportul tehnic, ne-am oprit la interfața virtuală vdrPort, care unește logic uplink-urile și care realizează bridging/încapsulare — acolo a fost observată o nepotrivire în traficul de intrare, pe care am luat-o pentru a o analiza în acest caz. Dar, așa cum am spus, nu am dus acest caz până la capăt, deoarece am fost trasferit la un alt proiect, iar ramura era de la bun început fără ieșire și nu aveam de gând să o dezvolt foarte mult. Dacă nu mă înșel, problema a fost observată în versiunile NSX 6.1.4 și 6.2.
Și aici — bingo! Fortinet anunță suport nativ . Și nu doar point-to-point sau VXLAN-over-IPSec, nu bridging-ul software VLAN-VXLAN — toate acestea au început să fie implementate încă din versiunea 5.4 (și sunt disponibile la altele ), și adevărata suport pentru controlul unicast al planului. Când am implementat soluția, m-am confruntat cu o altă problemă — serverele monitorizate dispăreau și reapăreau periodic în monitorizare, deși mașina virtuală era activă. Motivul, așa cum s-a dovedit, a fost că am uitat să permit Ping pe interfața VXLAN. În timpul reechilibrării clusterei, mașinile virtuale erau mutate, iar Ping-ul încheia vMotion pentru a indica noul gazdă ESXI pe care s-a mutat mașina. A fost o nebunie din partea mea, dar această problemă a subminat din nou încrederea în suportul producătorului — în acest caz, Fortinet. Nu mai vorbesc de faptul că fiecare caz legat de VXLAN începe cu întrebarea „unde aveți setările VLAN-VXLAN pe softswitch?” De data aceasta, mi-au sugerat să schimb MTU — asta pentru Ping, care are 32 de octeți. Apoi „experimentează” cu tcp-send-mss și tcp-receive-mss în politică — pentru VXLAN, care este encapsulat în UDP. Uf, scuze — m-am descărcat. În general, am rezolvat această problemă singur.
După ce am testat traficul, s-a decis implementarea acestei soluții. Și în producție s-a dovedit că, după o zi sau două, tot ce era monitorizat prin VXLAN începea să se deconecteze treptat. Dezactivarea/activarea interfeței ajuta, dar doar temporar. Ținând cont de lentoarea suportului producătorului, m-am apucat de troubleshooting din partea mea — la urma urmei, compania mea, rețeaua mea — responsabilitatea mea.
Sub spoilerul acesta se află procesul de troubleshooting. Cine s-a săturat de cuvinte și laude — poate să sară și să treacă la post-analisă.
Procesul de troubleshootingMulțumesc că ați continuat să citiți — să continuăm!
Așadar, monitorizarea funcționează o vreme, apoi se deconectează singură. Asta înseamnă că, cel mai probabil, nu sunt probleme în politicile de firewall. Totuși, deoarece m-am confruntat cu problema proceselor de sistem blocate în Fortigate versiunilor 5.6+, începem cu „diagnose debug flow” — așa cum era de așteptat, traficul se permite și iese pe interfață, iar așa cum era de așteptat, nu vine nimic înapoi. Asta înseamnă că trebuie să căutăm mai departe în stivă. Va trebui, din păcate, să ascund adresele, chiar dacă sunt RFC1918, dar sper că voi asigura procesul cu o descriere suficientă pentru înțelegere. Serverul din interiorul VXLAN are adresa x.x.x.15, interfața fortigate x.x.x.254, toate celelalte adrese aparțin rețelei VTEP.
Pentru un transfer de pachete VXLAN înfășurate cu succes, este necesară informația corectă în mai multe tabele. Pentru overlay, acestea sunt ARP și OVSDB, iar pentru underlay, ARP și CAM. În cazul Fortigate, VXLAN FDB și OVSDB sunt aceleași. Să începem de acolo:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=u.u.u.47 port=4789 vni=5008 ifindex=7
Aici totul este destul de simplu – adresa MAC a mașinii virtuale trebuie să se afle pe VTEP cu adresa u.u.u.47. Verificând conținutul și configurația clusterului ESXI, constat că adresa MAC a mașinii virtuale este corectă, adresa VTEP de asemenea. Verific ARP/CAM tabela de pe Fortigate – din nou, totul se potrivește cu setările gazdei ESXI:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
Tabelele sunt corecte și traficul pleacă – poate problema nu este pe Fortigate? Am omis intenționat analiza comutării traficului pe Juniper – logic, acesta ar trebui să efectueze următorul pas în depanare, dar rețeaua mea este simplă – doar un VLAN pentru VTEP și toate componentele sunt conectate direct. În plus, îmi amintesc de cazul cu bridge DLR, VDR și traficul care dispare – merg să monitorizez pe gazda ESXI, în paralel, creez un caz pentru VMWare. Mai jos, MAC „97:6e” aparține Fortigate-ului, vmnic1 – aceasta este interfața care are VTEP cu adresa u.u.u.47, monitorizez în ambele direcții "–dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
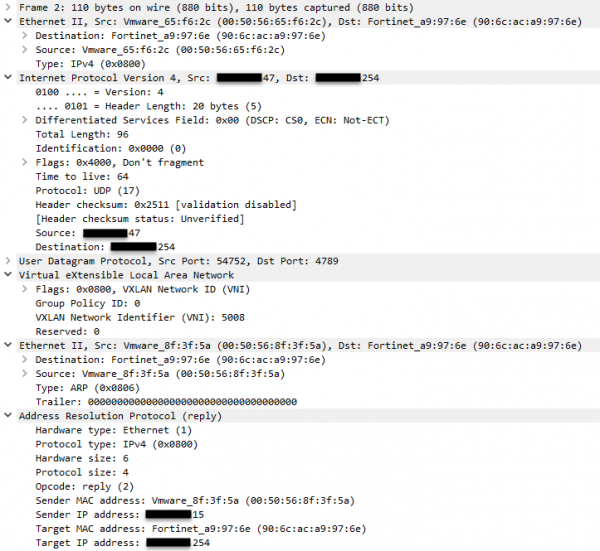
Progres – în monitorizare văd un request ARP și un răspuns venit. Aduc doar răspunsul ARP și acolo totul este corect. Nu am menționat, dar tot acest timp serverul de monitorizare trimite ping către adresa h.h.h.15 – unde este traficul ICMP? Îmi amintesc că am două uplink-uri. Aici se poate argumenta și spune că portul virtual sursă este același (politica mea de teaming), deci pentru aceeași vNIC ar trebui să se selecteze același uplink, dar cum sunt pe gazdă, verificarea unui alt uplink nu este o problemă:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
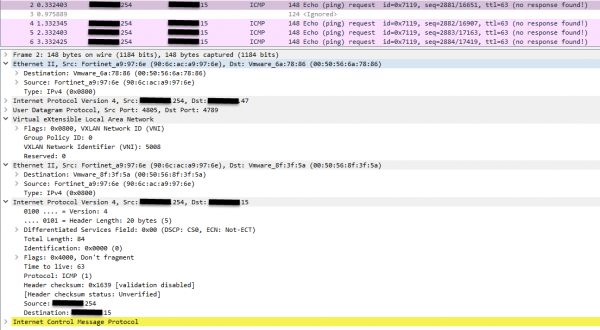
Sunt cereri de la Fortigate, dar nu este niciun răspuns. Asta înseamnă că problema nu este la Fortigate. Ei bine, mă gândesc eu, iarăși aceeași problemă cu traficul dispărut pe VDR, iarăși va trebui să direcționez cazul vreo câteva luni. După câteva zile, răcindu-mă și nesimțindu-mă confortabil cu acest blocaj, am decis să caut încă niște sniffuri pentru suport, pentru a accelera procesul. Și aici, „întâmplător”, privirea mea cade pe encapsularea Ethernet underlay. Împăratul nu este adevărat, iar adresa MAC a VTEP nu corespunde cu IP-ul său. Resetez, sniff, sap — corect, ce nu e corect. Voi aduce în apropiere tabela ARP, pentru a fi mai ușor de comparat. Vă rog să observați prima encapsulare Ethernet din imaginea de sus:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep u.u.u.42
u.u.u.42 0 00:50:56:6a:78:86 dmz
Așadar, ce avem în final — după migrarea mașinii virtuale, Fortigate încearcă să trimită trafic către VTEP din (corecta) VXLAN FDB, dar folosește un MAC DST greșit, iar traficul este, așa cum era de așteptat, respins de interfața care-l primește a hypervizorului. De altfel, în unul din patru cazuri, acest MAC aparținea hypervizorului inițial de la care a început migrarea mașinii.
Ieri am primit un e-mail de la suportul tehnic Fortinet — în cazul meu au deschis un bug 615586. Nu știu dacă să mă bucur sau să mă întristez: pe de o parte — problema nu este în setări, pe de altă parte — fixul va veni doar cu o actualizare a firmware-ului, în cel mai bun caz, în următoarea versiune. Ego-ul meu este alimentat și de un alt bug pe care l-am descoperit luna trecută, de data aceasta în GUI HTML5 vSphere. Chiar un departament local de QA pentru furnizori...
Îmi asum riscul de a presupune următoarele:
1 — este foarte probabil ca planul de control multicast să nu fie supus problemei descrise — deoarece adresele MAC ale VTEP sunt obținute din adresa IP a grupului la care este abonată interfața.
2 — problema Fortigate-ului este, probabil, legată de descărcarea sesiunilor pe Processorul de Rețea (aproximativ echivalent cu CEF) — dacă fiecare pachet este procesat prin CPU, vor fi utilizate tabele care conțin informații corecte — cel puțin vizual. În favoarea acestei presupuneri este și faptul că ajută să închizi/ deschizi interfața sau să aștepți un timp — mai mult de 5 minute.
3 — modificarea politicii de teaming, de exemplu, în explicit failover, sau implementarea LAG nu va rezolva problema, deoarece s-a observat „blocarea” MAC-ului hypervizorului inițial în pachetele encapsulate.
În lumina acestui lucru, pot să împărtășesc că recent am descoperit , unde într-unul dintre articole s-a afirmat că firewalls-urile stetfull și metodele de transmitere a datelor care pot fi cache-uite sunt doar soluții de avarie. Ei bine, nu sunt atât de experimentat în IT încât să fac astfel de afirmații, de asemenea nu sunt de acord cu toate afirmațiile din articolele blogului. Totuși, ceva îmi spune că există o parte de adevăr în cuvintele lui Ivan.
Vă mulțumesc pentru atenție! Voi fi bucuros să răspund la întrebări și să aud critici constructive.
Sursa: habr.com
