

Salutare tuturor. Mai jos găsiți transcrierea .
este un sistem de monitorizare a diverselor sisteme și servicii, prin care administratorii de sistem pot colecta informații despre parametrii actuali ai sistemelor și pot configura notificări pentru a primi alerte în caz de abateri de la funcționarea normală a acestora.
În prezentare va fi comparat și - proiecte pentru stocarea pe termen lung a metricilor Prometheus.
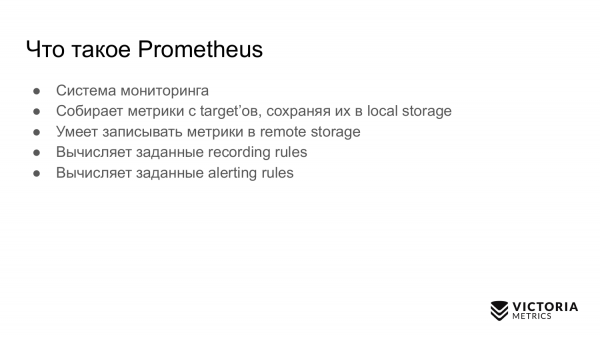
Mai întâi, voi vorbi despre Prometheus. Acesta este un sistem de monitorizare care colectează metrici de la ținti specificate și le salvează într-un stocare locală. Prometheus poate scrie metrici într-un stocare externă, poate genera alerte și reguli de înregistrare.
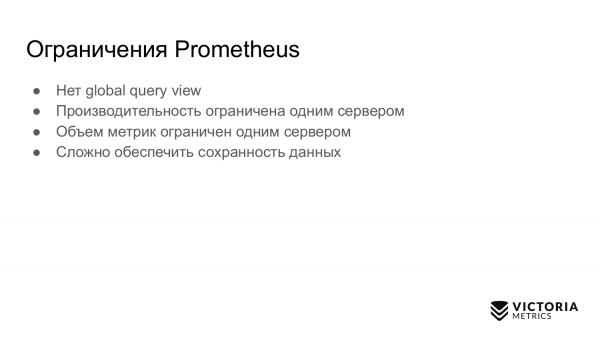
Limitările Prometheus:
- Nu are vizualizare globală a interogărilor. Aceasta este atunci când aveți mai multe instanțe independente de Prometheus. Ele colectează metrici și doriți să faceți o interogare pe toate aceste metrici, colectate de la diferite instanțe de Prometheus. Prometheus nu permite acest lucru.
- Performanța Prometheus este limitată la un singur server. Prometheus nu se poate scalabil automat pe mai multe servere. Puteți doar să vă împărțiți manual țintele între mai multe instanțe de Prometheus.
- Volumul metricilor în Prometheus este limitat la un singur server din același motiv pentru care nu se poate scala automat pe mai multe servere.
- În Prometheus nu este atât de simplu să organizați păstrarea datelor.
Care sunt soluțiile pentru aceste probleme?
Soluțiile sunt:
Toate aceste soluții sunt pentru stocarea externă a datelor colectate de Prometheus. Ele abordează problema stocării externe diferit. În această prezentare voi vorbi doar despre primele două soluții: și .
Informația despre a apărut prima dată la . Acolo este descrisă arhitectura și modul în care funcționează.
Thanos ia datele pe care Prometheus le-a salvat pe disc local și le copiază în S3, în sau în alt stocaj de obiecte.
Astfel, Thanos oferă vizibilitate globală asupra interogărilor. Puteți solicita datele stocate în stocarea de obiecte de la mai multe instanțe Prometheus.
Thanos suportă PromQL și .
Thanos utilizează codul Prometheus pentru stocarea datelor.
Thanos este dezvoltat de aceiași dezvoltatori care au creat Prometheus.
Despre . Iată , unde am vorbit prima dată despre .
VictoriaMetrics preia date de la mai multe instanțe Prometheus prin protocolul, suportat de Prometheus.
VictoriaMetrics oferă o vedere globală a interogărilor, deoarece mai multe instanțe Prometheus pot scrie date într-o singură instanță VictoriaMetrics. Astfel, poți realiza interogări pentru toate aceste date.

VictoriaMetrics suportă, la fel ca Thanos, PromQL și API-ul de interogare Prometheus.
Spre deosebire de Thanos, codul sursă al VictoriaMetrics a fost scris de la zero și optimizat pentru viteză și consum de resurse.
VictoriaMetrics, spre deosebire de Thanos, se scalează atât vertical, cât și orizontal. Există , care se scalează vertical. Poți începe cu un procesor și 1 GB de memorie și să crești treptat până la sute de procesoare și 1 TB de memorie. VictoriaMetrics este capabilă să utilizeze toate aceste resurse. Performanța ei va crește de aproximativ 100 de ori comparativ cu un sistem cu un singur nucleu.
Istoria Thanos a început în noiembrie 2017, când a avut loc prima commit publică. Înainte de aceasta, Thanos a fost dezvoltat intern în compania .
În iunie 2019, a avut loc un lansare semnificativă 0.5.0, în care Acesta a fost eliminat din Thanos deoarece s-a dovedit a fi ineficient. Adesea, clusterul Thanos funcționa greșit, iar nodurile se conectau incorect din cauza protocolului gossip. Prin urmare, s-a decis eliminarea acestuia. Consider că aceasta a fost o decizie corectă.
În aceeași lună iunie 2019, au trimis cererea numărul în .
și, după câteva luni, Thanos a fost acceptat în , care include Prometheus, Kubernetes și alte proiecte populare.
În ianuarie 2018, a început dezvoltarea VictoriaMetrics.
În septembrie 2018, am menționat pentru prima dată public despre VictoriaMetrics.
În decembrie 2018, a fost publicată versiunea Single-node.
În mai 2019 sursele atât pentru versiunea Single-node, cât și pentru versiunea cluster.
În iunie 2019, la fel ca Thanos, am trimis o cerere la fundația CNCF sub numărul . Am trimis cererea cu o zi înainte decât Thanos.
Dar, din păcate, nu am fost acceptați acolo până acum. Avem nevoie de ajutorul comunității.
Să analizăm cele mai importante diapozitive, care arată arhitectura Thanos și VictoriaMetrics.
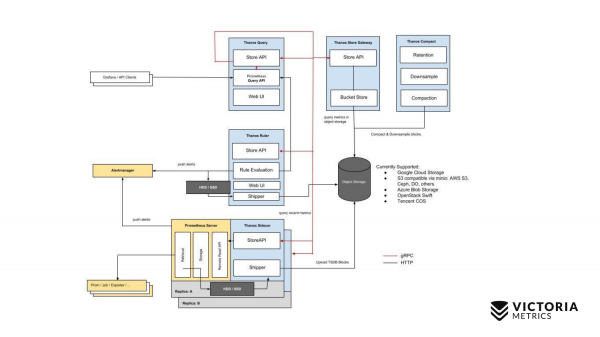
Să începem cu Thanos. Componentele galbene sunt componente Prometheus. Tot ce este altceva sunt componente Thanos. Să începem cu componenta cea mai importantă. Thanos Sidecar este componenta care este instalată lângă fiecare Prometheus. Aceasta se ocupă cu încărcarea datelor Prometheus din storage local în S3 sau în alt Object Storage.
Există și un component numit Thanos Store Gateway, care poate citi aceste date din Object Storage la cererile primite de la Thanos Query. Thanos Query implementează PromQL și API-ul Prometheus. Așadar, din exterior, acesta arată ca Prometheus. Acceptă cereri PromQL, le trimite către Thanos Store Gateway, iar Thanos Store Gateway obține datele necesare din Object Storage și le trimite înapoi.
Însă în Object Storage avem datele lipsă din ultimele două ore din cauza particularităților implementării Thanos Sidecar, care nu poate încărca ultimele două ore în Object Storage S3, deoarece pentru aceste două ore Prometheus nu a creat încă fișiere în stocarea locală.
Cum am reușit să o ocolim? Thanos Query, în afară de cererile către Thanos Store Gateway, trimite în paralel cereri și către fiecare Thanos Sidecar care se află aproape de Prometheus.
Iar Thanos Sidecar, la rândul său, procesează cererile mai departe în Prometheus și obține datele din ultimele două ore.
Pe lângă aceste componente, există și un component opțional, fără de care Thanos se va simți rău. Acesta este Thanos Compact, care se ocupă cu fuzionarea fișierelor mici din Object Storage în fișiere mai mari, care au fost încărcate aici de Thanos Sidecar-uri. Thanos Sidecar încarcă fișiere cu date pentru două ore. Aceste fișiere, dacă nu sunt fuzionate în fișiere mai mari, pot crește semnificativ. Cu cât sunt mai multe astfel de fișiere, cu atât mai multă memorie este necesară pentru Thanos Store Gateway, cu atât mai multe resurse sunt necesare pentru transferul datelor prin rețea și metadatele. Funcționarea Thanos Store Gateway devine ineficientă. Prin urmare, trebuie să lansezi neapărat Thanos Compact, care fuzionează fișierele mici în fișiere mai mari, pentru a avea mai puține astfel de fișiere și pentru a reduce overhead-ul pe Thanos Store Gateway.
Există și un component numit Thanos Ruler. Acesta execută regulile de alertă Prometheus și poate calcula regulile de înregistrare Prometheus, pentru a putea salva din nou datele în Object Storage. Dar acest component nu este recomandat, deoarece .
Iată o schemă simplă a lui Thanos.
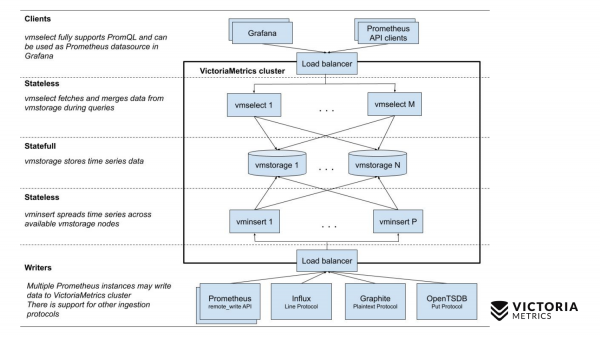
Acum să comparăm cu schema VictoriaMetrics.
VictoriaMetrics are 2 versiuni: Single-node și versiunea de cluster. Single-node funcționează pe un singur computer. În Single-node nu există aceste componente, ci doar un binar. Acest binar pe diapozitiv arată ca acest pătrat. Tot ce se află în interiorul pătratului este conținutul fișierului binar pentru versiunea Single-node. Nu trebuie să știți despre el. Pur și simplu rulați binarul și totul funcționează.
Versiunea cluster este mai complexă. În interiorul acesteia se află trei componente diferite: vmselect, vminsert și vmstorage. Din denumirile lor ar trebui să fie clar ce se ocupă fiecare dintre ele. Componenta Insert acceptă date în diferite formate: din API-ul Prometheus remote write, protocolul Influx line, protocolul Graphite și protocolul OpenTSDB. Componenta Insert le primește, le parsează și le împarte între componentele storage existente, unde datele sunt deja salvate. Componenta Select, pe de altă parte, acceptă interogări PromQL. Aceasta implementează , precum și API-ul de interogare Prometheus, și poate fi folosit ca un substitut pentru Prometheus în Grafana sau în alți clienți API Prometheus. Select primește interogări promql, le parsează, citește datele necesare pentru a executa această interogare din nodurile storage, le procesează și returnează un răspuns.
Să comparăm complexitatea instalării Thanos și VictoriaMetrics.
Să începem cu Thanos. Înainte de a începe să lucrați cu Thanos, trebuie să creați un bucket în Object Storage, cum ar fi S3 sau GCS, astfel încât Thanos Sidecar să poată scrie date acolo.
Apoi, pentru fiecare Prometheus trebuie să instalați Thanos Sidecar. Înainte de aceasta, nu uitați să dezactivați compresia datelor în Prometheus. Compresia datelor comprimă periodic datele din stocarea locală a Prometheus pentru a reduce consumul de resurse.
Atunci când instalați Thanos Sidecar la Prometheus-urile dvs., trebuie să dezactivați această compresie a datelor, deoarece Thanos Sidecar nu funcționează corect cu compresia activă. Aceasta înseamnă că Prometheus dvs. începe să salveze datele în blocuri de câte două ore și încetează să îmbine aceste blocuri în unele mai mari. Deci, dacă faceți interogări care depășesc durata ultimelor două ore, acestea nu vor funcționa atât de eficient comparativ cu cum ar putea funcționa dacă compresia datelor ar fi activată.
De aceea, Thanos recomandă reducerea timpului de retenție a datelor în stocarea locală la 6-8 ore, pentru a reduce această suprasarcină a unui număr mare de blocuri mici.
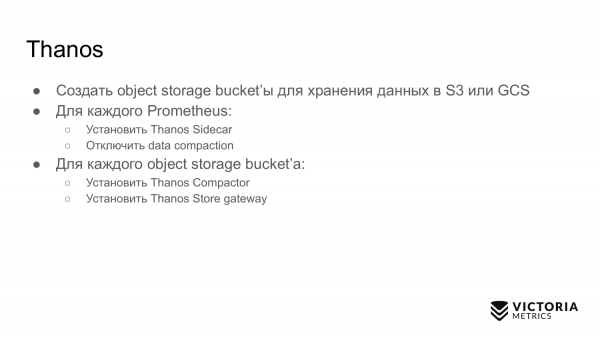
După ce ați instalat Thanos Sidecar, trebuie să instalați două componente pentru fiecare Object Storage Bucket. Acestea sunt Thanos Compactor și Thanos Store Gateway.
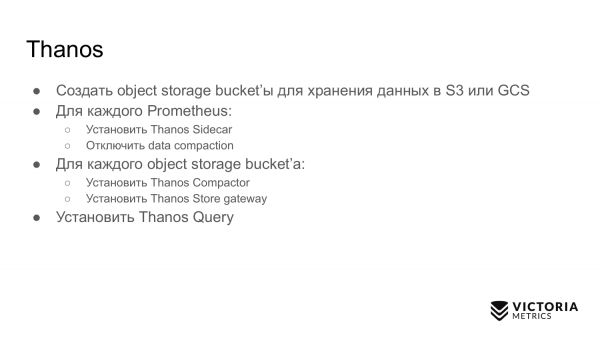
După aceea, trebuie să instalați Thanos Query și să-l configurați pentru a se putea conecta la toate Thanos Store Gateway-urile pe care le aveți, precum și să se conecteze la toate Thanos Sidecar-urile.
Aici poate apărea o mică problemă.
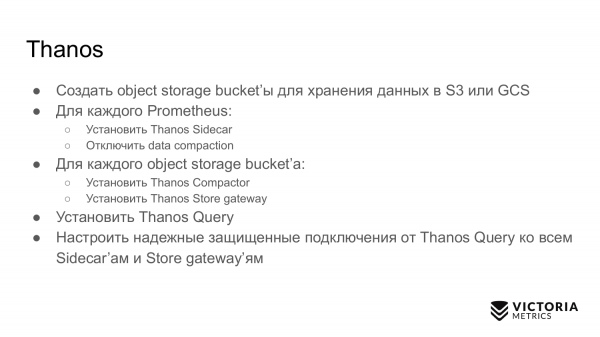
Trebuie să configurați o conexiune fiabilă și sigură de la Thanos Query la aceste componente. Iar dacă aveți Prometheus-uri în diferite centre de date sau în VPC-uri diferite, conexiunile externe sunt interzise. Dar pentru ca Thanos Query să funcționeze, trebuie să găsiți o modalitate de a configura conexiunea acolo.
Dacă aveți multe astfel de centre de date, fiabilitatea întregului sistem scade. Deoarece Thanos Query trebuie să mențină constant conexiunile cu toate Thanos Sidecar-urile situate în diferite centre de date. La fiecare solicitare primită, va redirecționa solicitările către toate Thanos Sidecar-urile. Dacă conexiunea se întrerupe, veți obține fie un set incomplet de date, fie un răspuns „clusterele nu funcționează”.
În VictoriaMetrics, totul este puțin mai simplu. Pentru versiunea Single-node, este suficient să rulați un singur binar și totul funcționează.
Pentru versiunea în cluster, este suficient să rulați toate cele trei tipuri de componente menționate anterior în orice număr de care aveți nevoie, sau să folosiți pentru automatizarea lansării componentelor în Kubernetes. De asemenea, plănuim să dezvoltăm un operator Kubernetes. Helm chart-ul nu acoperă unele cazuri și vă permite să vă împușcați în picior. De exemplu, permite reducerea numărului de storage node, ceea ce va duce la pierderea datelor.
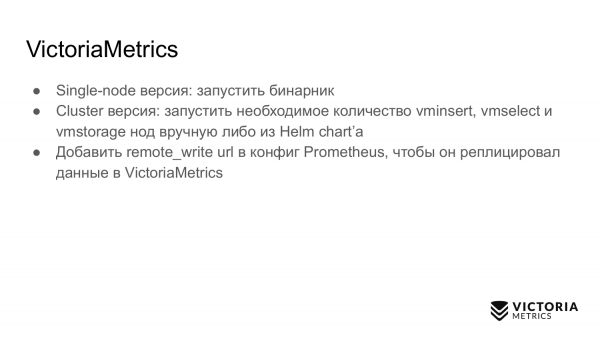
După ce ați lansat un binar sau versiunea în cluster, este suficient să adăugați în configurația Prometheus , pentru a începe să scrie datele simultan în storage-ul local și în storage-ul remote. După cum ați observat, această configurație ar trebui să funcționeze mult mai fiabil în comparație cu configurația Thanos. Nu avem nevoie să menținem conexiunea de la VictoriaMetrics la toate Prometheus-urile, deoarece Prometheus-urile se conectează singure la VictoriaMetrics și transmit datele.
Să analizăm mentenanța Thanos și VictoriaMetrics.
Thanos trebuie să monitorizeze Sidecar pentru a se asigura că nu întrerupe transferul de date în Object Storage. Acesta poate opri acest transfer din cauza unor erori de încărcare, de exemplu, dacă aveți o întrerupere temporară a conexiunii de rețea cu Object Storage sau dacă Object Storage devine temporar inaccesibil. Thanos Sidecar va observa acest lucru, va raporta o eroare, poate să se prăbușească și apoi să înceteze să funcționeze. Dacă nu îl monitorizați, datele nu vor mai fi transmise în Object Storage. Dacă trece timpul de retenție (6-8 ore recomandate), veți pierde datele care nu au ajuns în Object Storage.
Thanos compactorii pot înceta să funcționeze din cauza . Compactorii preiau date din Object Storage și le îmbină în bucăți de date mai mari. Deoarece compactorii nu sunt sincronizați cu Sidecar-urile, poate apărea următoarea situație: Sidecar-ul nu a terminat încă scrierea blocului, Compactorul decide că acest bloc este complet scris. Compactorul începe să-l citească. El citește blocul incomplet și încetează să funcționeze. Vezi detalii .
Store Gateway poate returna date inconsistene din cauza concurențelor între Compactor și Sidecar-uri. Aici este o situație similară, deoarece Store Gateway nu este sincronizat cu Compactorii și Sidecar-urile. Prin urmare, pot apărea condiții de cursă, când Store Gateway nu vede o parte a datelor sau vede date suplimentare.
Componenta Query din Thanos returnează implicit un rezultat parțial dacă unele Sidecar-uri sau Store Gateway nu sunt disponibile în acel moment. Veți primi o parte din date și nici nu veți ști că nu ați primit toate datele. Așa funcționează în mod implicit. Într-o situație similară, VictoriaMetrics returnează datele marcate ca parțiale.
Spre deosebire de Thanos, VictoriaMetrics rareori pierde date. Chiar dacă conexiunea de la Prometheus la VictoriaMetrics este întreruptă, nu este o problemă, deoarece Prometheus continuă să scrie datele noi primite în Write Ahead Log, care are o dimensiune de 2 ore. Dacă în termen de două ore restabiliți conexiunea cu VictoriaMetrics, datele nu se vor pierde. Prometheus .
Spre deosebire de Thanos, care scrie datele în object storage doar după două ore, Prometheus replică automat datele prin protocolul remote write în remote storage, cum ar fi VictoriaMetrics. Nu trebuie să îți faci griji cu privire la pierderea local storage în Prometheus. Dacă ar pierde local storage, în cel mai rău caz vei pierde ultimele secunde de date care nu au apucat să fie scrise în remote storage.
Kubernetes gestionează automat clusterul, spre deosebire de Thanos. Toate componentele Thanos sunt greu de inclus într-un singur cluster Kubernetes, în contrast cu componentele cluster ale VictoriaMetrics.
VictoriaMetrics are o actualizare foarte simplă la o nouă versiune. Pur și simplu oprești VictoriaMetrics, actualizezi binarele și repornești. Când este oprit prin semnalul SIGINT, toate binarele VictoriaMetrics fac un shutdown grațios. Ele salvează corect datele necesare, închid corect conexiunile intrante pentru a nu pierde nimic. Prin urmare, nu vei pierde nimic în timpul actualizării.
Extinderea clusterului VictoriaMetrics este foarte simplă. Pur și simplu adaugi componentele necesare și continui să lucrezi.
Despre capcanele din Thanos și VictoriaMetrics.
Thanos are următoarele capcane. Prometheus trebuie să stocheze datele pentru ultimele două ore. Dacă acestea se pierd, le vei pierde complet, deoarece nu au apucat să fie scrise în Object Storage, cum ar fi S3.
Componenta Store Gateway și componenta compactor pot necesita multă memorie pentru a lucra cu un mare Object Storage, dacă acolo sunt stocate multe fișiere mici. Cu cât numărul și volumul fișierelor sunt mai mari, cu atât Store Gateway și compactorul necesită mai multă memorie operațională pentru a stoca metainformațiile. Thanos are multe probleme legate de faptul că .
Thanos se laudă că se poate scala infinit în raport cu numărul de Prometheus. În realitate, acest lucru nu este adevărat. Deoarece toate cererile trec prin componenta Query, care trebuie să interogheze în paralel toate componentele Store Gateway și toate componentele Sidecar, extrașând date de acolo și apoi preprocesându-le. Este evident că viteza cererilor este limitată de cel mai lent punct slab, cel mai lent Store Gateway sau cel mai lent Sidecar.
Aceste componente pot fi supraîncărcate inegal. De exemplu, aveți un Prometheus care colectează milioane de metrici pe secundă. Și există un Prometheus care colectează mii de metrici pe secundă. Prometheus-ul care colectează milioane de metrici pe secundă solicită mult mai mult serverul pe care funcționează. Prin urmare, Sidecar-ul de acolo va funcționa mai lent. Și, în general, totul va funcționa încet. Componenta Query va extrage datele de acolo foarte încet. Astfel, performanța întregului cluster va fi limitată de acest Sidecar lent.
În mod implicit, Thanos oferă date parțiale dacă unele Sidecar-uri sau Store Gateway-uri nu sunt disponibile. De exemplu, dacă aveți Sidecar-uri dispersate în întreaga lume în diferite centre de date, probabilitatea de a întrerupe conexiunea și de a avea componente inaccesibile crește semnificativ. Prin urmare, în majoritatea cazurilor veți obține date parțiale, fără a ști chiar despre asta.
De asemenea, VictoriaMetrics are capcane. Prima capcană este opțiunea care limitează cantitatea de memorie RAM utilizată pentru cache-ul VictoriaMetrics. În mod implicit, aceasta este setată la 60% din memoria RAM a mașinii pe care rulează VictoriaMetrics sau 60% din RAM-ul podului VictoriaMetrics în Kubernetes.
Dacă schimbați incorect această valoare, puteți afecta performanța VictoriaMetrics. De exemplu, dacă setați o valoare prea mică, datele pot înceta să încapă în cache-ul VictoriaMetrics. Din această cauză, va trebui să efectueze muncă suplimentară și să solicite procesorul împreună cu discul. Dacă faceți această opțiune prea mare, crește, pe de o parte, probabilitatea ca VictoriaMetrics să se închidă cu eroarea out of memory, și, pe de altă parte, va duce la faptul că în sistemul de operare va rămâne foarte puțină memorie RAM pentru cache-ul de fișiere. Iar VictoriaMetrics se bazează pe cache-ul de fișiere pentru performanță. Dacă nu este suficient, atunci sarcina pe disc se poate crește semnificativ. De aceea, sfatul este să nu schimbați parametrul fără o necesitate extremă.
A doua opțiune. Este retentionPeriod — perioada care, în mod implicit, este setată la 1 lună. Aceasta este perioada în care VictoriaMetrics păstrează datele. La expirarea acestui termen, VictoriaMetrics șterge datele.
Multe persoane rulează VictoriaMetrics fără acest parametru, înregistrează date timp de o lună. Apoi se întreabă: de ce datele au dispărut în luna precedentă? Pentru că retentionPeriod implicit este de 1 lună. Așadar, trebuie să cunoști și să stabilești un retentionPeriod corect.
Să trecem în revistă caracteristicile unice.
Thanos are o funcționalitate numită downsampling: intervale de 5 minute și orare, care de multe ori . Dacă cauți pe Google și verifici problemele lor pe GitHub, vei găsi multe probleme legate de acest downsampling, care uneori nu funcționează corect sau nu funcționează așa cum se așteaptă utilizatorii.
Thanos are deduplicarea datelor pentru perechi Prometheus HA. Când două instanțe Prometheus colectează aceleași metrici de la aceleași ținte, Thanos le stochează în Object Storage. Thanos poate deduplica corect aceste date, spre deosebire de VictoriaMetrics.
Thanos are un component de alertă, care a fost menționat în schema Thanos. Dar acesta .
Thanos are avantajul că codul din Thanos și Prometheus este comun. Thanos și Prometheus sunt dezvoltate de aceiași dezvoltatori. Atunci când se fac îmbunătățiri în Thanos, partea cealaltă (Prometheus) beneficiază.
Principala caracteristică a VictoriaMetrics este — MetricsQL. Aceasta este extensia VictoriaMetrics pentru PromQL, despre care am vorbit la anteriorul big monitoring meetup.
VictoriaMetrics suportă încărcarea datelor prin multe protocoale diferite. VictoriaMetrics nu doar că poate primi date de la Prometheus, dar și prin protocoale precum Influx, OpenTSDB și Graphite.
Datele VictoriaMetrics ocupă de obicei mult mai puțin spațiu comparativ cu Thanos și Prometheus.
Dacă se înregistrează date reale, utilizatorii afirmă că dimensiunea datelor pe disc este redusă de 2-5 ori comparativ cu Prometheus și Thanos.
Un alt avantaj al VictoriaMetrics este că este optimizată pentru viteză.
Să discutăm despre costul infrastructurii.
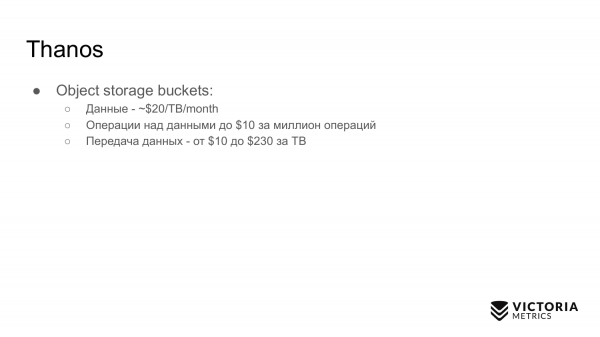
Unul dintre avantajele Thanos este că acesta păstrează datele în object storage, care este relativ ieftin.
Când salvezi date în obiect storage, trebuie să plătești pentru operațiile de scriere și citire a datelor (10 dolari pe milion de operații). Când scrii date în object storage, plătești costurile de hosting pentru încărcarea datelor pe internet, dacă clusterul tău nu se află în AWS — acolo este gratuit. Când citești datele, plătești între 10 dolari și 230 dolari pentru 1TB. Acest lucru poate fi semnificativ dacă soliciti frecvent date istorice din clusterul Thanos.
Pentru clusterul Thanos, este necesar să plătiți servere pentru componentele Compact, Store Gateway, Query, care necesită multă memorie și CPU pentru volume mari de date.
La VictoriaMetrics, costurile sunt astfel. Dacă păstrezi datele pe discuri GCE HDD, ajunge la 40 USD pe 1TB. Pentru VictoriaMetrics, sunt suficiente discuri HDD obișnuite, nu sunt necesare SSD-uri, care costă de cinci ori mai mult. VictoriaMetrics este optimizată pentru HDD.
VictoriaMetrics necesită servere pentru componente: fie Single-node, fie pentru componentele cluster, care, spre deosebire de componentele Thanos, necesită mult mai puțin CPU și RAM — astfel, va fi mai ieftin.
Exemple de implementare.
Un exemplu de implementare pentru Thanos este Gitlab. Gitlab funcționează pe deplin pe Thanos. Dar nu totul este atât de simplu. Dacă ne uităm la , putem observa că au constant anumite : le lipsește memorie pentru componentele Store Gateway sau Query. Sunt nevoiți să își crească constant capacitatea de memorie.
Din această cauză, costurile pentru rezolvarea acestor probleme cresc.
A doua implementare, care ar putea fi mai reușită — este compania Improbable, care a început dezvoltarea Thanos. Ei au publicat sursele Thanos. Improbable este o companie care se ocupă cu dezvoltarea de motoare de jocuri.
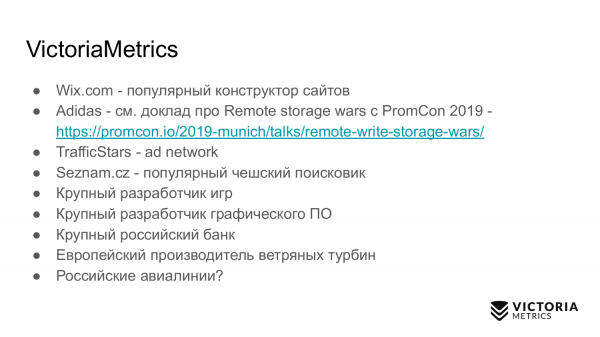
La VictoriaMetrics, exemplele publice de implementare sunt:
- wix.com, constructor de site-uri
- Adidas implementează VictoriaMetrics și chiar a făcut o prezentare la ultimul PromCon 2019
- TrafficStars — rețea de publicitate
- Seznam.cz — un motor de căutare popular din Cehia.
Apoi au fost companii mai puțin cunoscute, pe care nu pot să le numesc acum. Nu au dat consimțământul.
- Un dezvoltator mare de jocuri. Mai mare decât Improbable.
- Un mare dezvoltator de software grafic.
- O mare bancă rusă.
- Un producător european de turbine eoliene, care a testat cu succes VictoriaMetrics. Acest producător implementează VictoriaMetrics pentru monitorizarea datelor recepționate de la turbinele eoliene cu o rată de 50 de eșantioane pe secundă pentru fiecare senzor. Fiecare turbină eoliană are câteva sute de senzori. Au câteva sute de turbine eoliene.
- Aeroporturi ruse, care doresc să implementeze VictoriaMetrics, dar încă nu reușesc. Suntem în stadiul de contract.
 Concluzii.
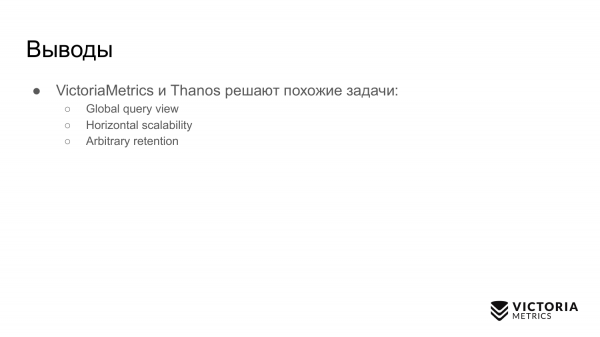
VictoriaMetrics și Thanos abordează probleme similare, dar în moduri diferite:
- Viziune globală a interogărilor
- scalare orizontală
- retentie arbitrară
Mulțumim.
Te așteptăm pe .
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Ce folosești ca stocare pe termen lung pentru Prometheus?
35,3%Thanos
0,0%Cortex
0,0%M3DB
41,2%VictoriaMetrics
23,5%alte
Au votat 17 de utilizatori. 16 utilizatori s-au abținut.
Sursa: habr.com
