

Vă invit să consultați transcrierea prezentării din începutul anului 2020 a lui Georgyi Rylov "WAL-G: noi posibilități și extinderea comunității"
Menținerii open-source se confruntă cu numeroase probleme pe măsură ce cresc. Cum să scrii tot mai multe funcții necesare, să rezolvi din ce în ce mai multe probleme și să reușești să examinezi din ce în ce mai multe cereri de pull? Folosind exemplul WAL-G (un instrument de backup pentru PostgreSQL), voi vorbi despre cum am abordat aceste probleme, lansând un curs de dezvoltare open-source la universitate, ce am reușit să realizăm și încotro ne îndreptăm mai departe.
Salut din nou, tuturor! Sunt dezvoltator la Yandex din Ekaterinburg. Astăzi voi vorbi despre WAL-G.
În titlul prezentării nu s-a spus că este vorba despre backup-uri. Cineva nu știe ce este WAL-G? Sau toată lumea știe? Ridicați mâna cei care nu știu. Wow, ați venit la prezentare și nu știți despre ce este vorba.
Permiteți-mi să vă explic ce va urma astăzi. A ieșit astfel încât echipa noastră se ocupă de backup-uri de ceva vreme. Și aceasta este o altă prezentare dintr-o serie în care vorbim despre cum ne păstrăm datele în siguranță, fiabil, convenabil și eficient.
În seriile anterioare au fost multe prezentări ale lui Andrei Borodin, Vladimir Leskov. Am fost mulți. Și toți am vorbit despre WAL-G de mulți ani.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Această prezentare va fi puțin diferită de celelalte, deoarece acolo s-a discutat mai mult despre partea tehnică, iar aici voi povesti despre cum ne-am confruntat cu problemele legate de creșterea comunității. Și cum am venit cu o idee mică care ne ajută să facem față.
Acum câțiva ani WAL-G era un proiect destul de mic, pe care l-am obținut de la Citus Data. Și abia l-am preluat. Era dezvoltat de o singură persoană.
Și în WAL-G lipseau:
- Backup-uri de pe replică.
- Nu erau backup-uri incrementale.
- Nu erau backup-uri WAL-Delta.
- Și multe altele lipseau.
În acești câțiva ani, WAL-G a crescut semnificativ.
Și până în 2020 toate cele menționate anterior au apărut deja. Și la toate acestea s-a adăugat faptul că acum avem:
- Peste 1 000 de stele pe GitHub.
- 150 de fork-uri.
- Aproape 15 PR-uri deschise.
- Și mulți alți contribuabili.
- Și probleme deschise constant. Și asta în condițiile în care intrăm acolo literalmente în fiecare zi și facem ceva cu asta.
Și am ajuns la concluzia că acest proiect necesită mai multă atenția noastră, chiar și atunci când noi înșine nu trebuie să implementăm nimic pentru serviciul nostru Managed Databases la Yandex.
Și undeva în toamna anului 2018, ne-a venit o idee. De obicei, echipa are câteva modalități de a dezvolta funcții sau de a corecta erori, atunci când nu aveți suficiente resurse. De exemplu, puteți angaja un alt dezvoltator și să-i plătiți salariul. Sau puteți angaja un stagiar pentru o perioadă și să-i plătiți o remunerație. Dar există și un grup destul de mare de oameni, dintre care o parte deja știe să scrie cod. Pur și simplu, nu știți întotdeauna ce calitate are codul respectiv.
Ne-am gândit și am decis să încercăm să atragem studenți. Dar studenții nu vor participa în tot. Ei vor face doar o parte din muncă. De exemplu, vor scrie teste, vor corecta erori, vor implementa funcții care nu afectează funcționalitatea principală. Funcționalitatea principală constă în crearea de backup-uri și restaurarea acestora. Dacă se produce o eroare în crearea unui backup, ne vom confrunta cu o pierdere de date. Și, bineînțeles, nimeni nu dorește asta. Toată lumea vrea ca totul să fie foarte sigur. De aceea, codul în care avem mai puțin încredere decât în propriul nostru nu dorim, desigur, să-l acceptăm. Adică, orice cod non-criticat este ceea ce am dori să primim de la mâinile noastre suplimentare.
În ce condiții este acceptat PR-ul studentului
- Ei trebuie să-și acopere codul cu teste. Totul trebuie să treacă prin CI.
- Și, de asemenea, trecem prin 2 revizuiri. Una de Andrei Borodin și una de la mine.
- Și, în plus, pentru a verifica că acest lucru nu va strica nimic în serviciul nostru, încarc separat o compunere cu acest commit. Și verificăm în testele end-to-end că nimic nu se strică.
Curs specializat pe Open Source
Un pic despre de ce este necesar și de ce mi se pare o idee genială.
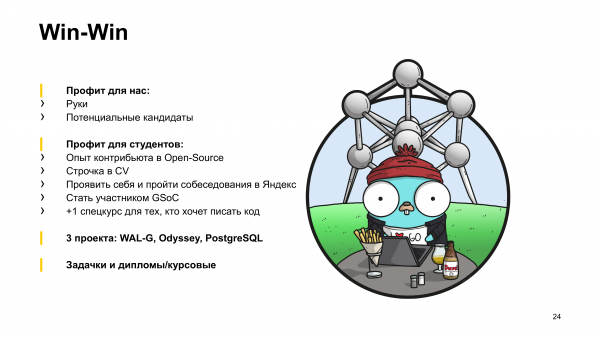
Pentru noi, beneficiul este evident:
- Obținem mâini suplimentare.
- Și căutăm candidați pentru echipă dintre studenți capabili, care scriu cod de calitate.
Care este beneficiul pentru studenți?
Ele pot fi mai puțin evidente, deoarece studenții, în cel mai bun caz, nu primesc bani pentru codul pe care îl scriu, ci doar note în carnet.
I-am întrebat despre asta. Și din câte mi-au spus:
- Experiența de contributor în Open Source.
- Obținerea unei mențiuni în CV.
- A se exprima și a trece un interviu la Yandex.
- A deveni participant la GSoC.
- +1 curs special pentru cei care doresc să scrie cod.
Nu voi povesti despre cum a fost organizat cursul. Voi spune doar că WAL-G a fost proiectul principal. De asemenea, am inclus în acest curs proiecte precum Odyssey, PostgreSQL și ClickHouse.
Și am avut sarcini nu doar în acest curs, ci am oferit și diplome și lucrări de curs.
Dar care este beneficiul pentru utilizatori?
Acum să trecem la partea care vă interesează mai mult. Ce câștig aveți din asta? Beneficiul este că studenții au reparat multe buguri. Și au realizat cereri de caracteristici pe care ne-ați cerut să le implementăm.
Și permiteți-mi să vă povestesc despre lucrurile pe care le-ați dorit de mult timp și care au fost implementate.
Suport pentru tablespaces. Suportul pentru tablespaces în WAL-G a fost așteptat, probabil, încă de la lansarea WAL-G, deoarece WAL-G este succesorul unui alt instrument de backup, WAL-E, unde au fost susținute backup-urile bazei de date cu tablespaces.
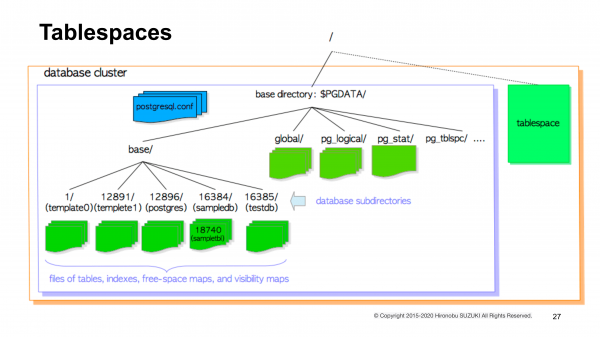
Pe scurt, amintesc ce este și de ce este necesar. De obicei, toate datele dvs. Postgres ocupă un singur director pe sistemul de fișiere, care se numește baza. Și acest director conține deja toate fișierele și subdirectoarele necesare pentru Postgres.
Tablespaces sunt directoare în care sunt stocate datele Postgres, dar acestea nu stau în afara directorului de bază. Pe diapozitiv se poate vedea că tablespac-urile se află în afara directorului de bază.
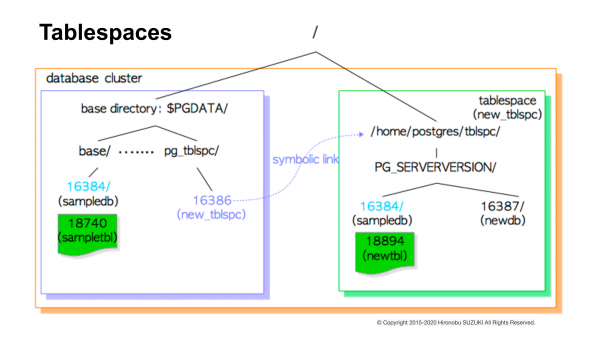
Cum arată asta pentru Postgres însuși? În directorul de bază există un subdirector numit pg_tblspc. Și în acesta se află link-uri simbolice către directoarele în care sunt stocate efectiv datele Postgres în afara directorului de bază.
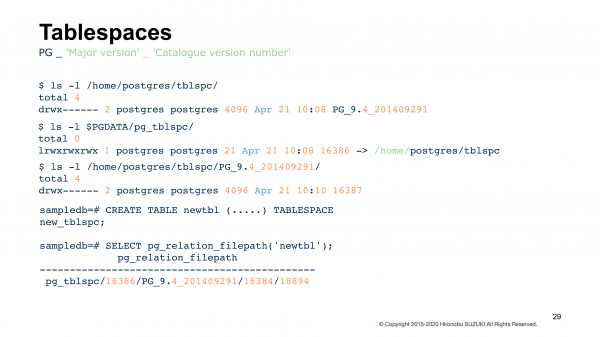
Când folosiți toate acestea, comenzile pentru dvs. pot arăta cam așa. Adică, creați o tabelă într-un tablespace specificat și vedeți unde se află acum. Aceste două ultime linii, cele două ultime comenzi apelate, arată un anumit drum. Dar, de fapt, nu este un drum real. Este un drum cu un prefix din directorul de bază către tablespace. Și de acolo este mapat printr-un link simbolic care duce la datele dvs. reale.
Toate acestea nu sunt folosite în echipa noastră, dar au fost folosite de mulți alți utilizatori WAL-E, care ne-au spus că doresc să migreze la WAL-G, dar acest lucru le-a împiedicat. Acum este susținut.
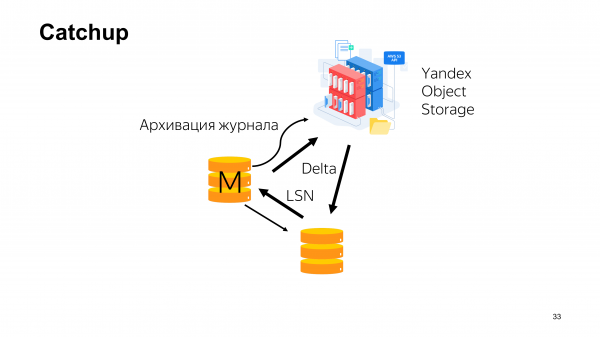
O altă caracteristică pe care ne-a adus cursul nostru special este catchup. Despre catchup știu oamenii care, probabil, au lucrat mai mult cu Oracle decât cu Postgres.
Într-un rezumat, iată despre ce este vorba. O topologie a clusterei din serviciul nostru poate arăta cam așa. Avem un master. Există o replică care transmite de la el jurnalul write-ahead. Replica îi spune masterului la ce LSN se află în prezent. În paralel, jurnalul poate fi arhivat. În plus, se fac copii de siguranță în cloud.
Ce probleme pot apărea? Când aveți o bază de date destul de mare, există posibilitatea ca replica să înceapă să întârzie semnificativ față de master. Și poate să întârzie atât de mult încât să nu o mai poată ajunge niciodată din urmă. Această problemă trebuie rezolvată de obicei într-un fel.
Cel mai simplu mod este de a elimina replica și de a o reinstala, deoarece nu o va mai ajunge niciodată, iar problema trebuie abordată. Dar acest proces durează destul de mult, întrucât recuperarea unei întregi copii de siguranță a unei baze de date de 10 TB este un proces extrem de îndelungat. Ne dorim să facem asta cât mai repede posibil atunci când apar astfel de probleme. Iar pentru asta este destinat catchup.
Catchup permite utilizarea copiilor de siguranță delta care sunt salvate în cloud într-un mod specific. Indicați la ce LSN se află replica întârziată și îl specificați în comanda catchup pentru a crea o copie de siguranță delta între acel LSN și LSN-ul la care se află în prezent clusterul dumneavoastră. Apoi, restaurați această copie de siguranță pe replica care întârzia.
Alte baze de date
De asemenea, studenții ne-au adus imediat multe funcționalități. Deoarece noi în Yandex lucrăm nu doar cu Postgres, ci și cu MySQL, MongoDB, Redis, ClickHouse, a venit un moment când a fost necesar să putem face copii de siguranță cu recuperare point-in-time pentru MySQL și să avem posibilitatea de a le încărca în cloud.
Și ne-am dorit să facem acest lucru într-un mod similar cu ceea ce face WAL-G. Am decis să experimentăm și să vedem cum va arăta totul.
La început, fără a separa aceste logici, am scris codul în fork. Am constatat că avem un model funcțional și că poate funcționa. Apoi ne-am gândit că principalul nostru public este utilizatorii de PostgreSQL, care folosesc WAL-G. Așadar, trebuie să separăm aceste părți. Când modificăm codul pentru PostgreSQL, să nu stricăm MySQL; când modificăm MySQL, să nu stricăm PostgreSQL.
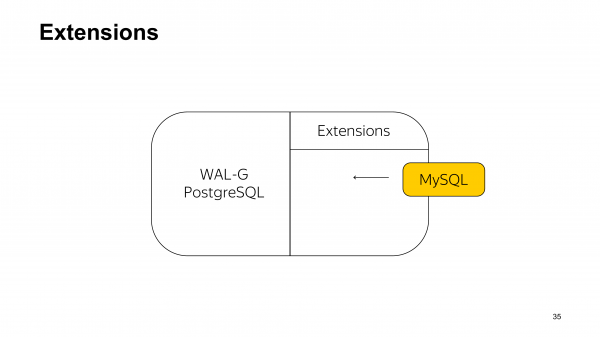
Prima idee despre cum să le separăm a fost folosirea aceleași abordări folosite în extensiile PostgreSQL. Şi, în esență, pentru a realiza un backup MySQL, trebuia să instalați o bibliotecă dinamică.
Dar aici se observă imediat asimetricia acestei abordări. Când faceți backup la Postgres, instalați un utilitar de backup normal pentru Postgres și totul este excelent. Iar pentru MySQL se pare că trebuie să instalați un utilitar de backup pentru Postgres și, în plus, o bibliotecă dinamică pentru MySQL. Sună oarecum ciudat. Ne-am gândit și noi astfel și am decis că aceasta nu este soluția de care avem nevoie.
Diferite utilitare pentru Postgres, MySQL, MongoDB, Redis
Dar aceasta ne-a permis, după părerea noastră, să ajungem la soluția corectă – separarea diferitelor utilitare pentru diferite baze de date. Acest lucru permitea izolarea logicii legate de backup-urile diferitelor baze de date, care vor apela la o API comună, implementată de WAL-G.
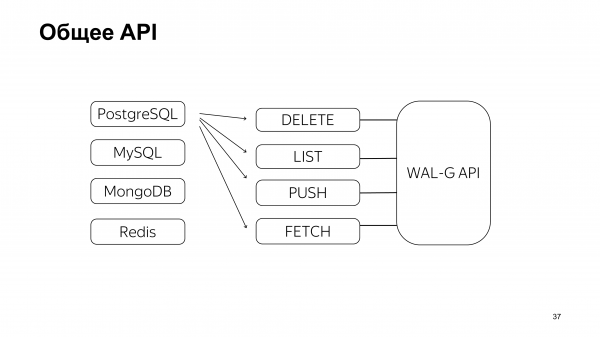
Aceasta este partea pe care am scris-o noi înșine – înainte de a le da studenților sarcinile. Adică, aceasta este exact partea unde ei ar fi putut face ceva greșit, de aceea am decis că mai bine facem noi ceva bine și totul va fi excelent.
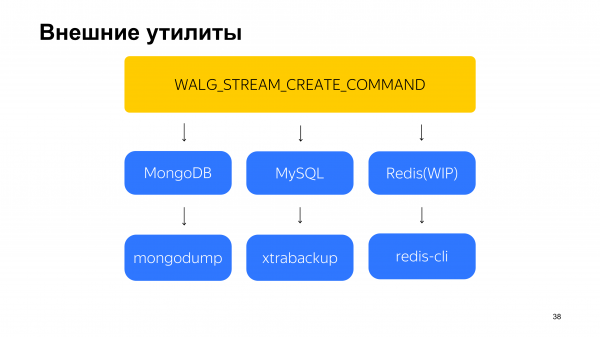
După aceea, am dat sarcinile. Aceștia au fost imediat preluați. De la studenți a fost necesar să suporte trei baze.
Este vorba despre MySQL, pe care îl facem backup cu ajutorul WAL-G în acest mod de mai bine de un an.
Și acum MongoDB se apropie de producție, acolo se îmbunătățește cu răbdare. Practic, structura pentru toate acestea a fost scrisă de noi. Apoi studenții au scris lucruri funcționale. Și apoi le ducem la un stadiu pe care putem să-l acceptăm în producție.
Aceste sarcini nu păreau că studenții trebuiau să scrie unelte complete de backup pentru fiecare dintre aceste baze. Nu ne-am confruntat cu această problemă. Problema noastră era că vroiam recuperare în timp, iar noi vroiam să facem backup în cloud. Și am cerut studenților să scrie un cod care să rezolve acest lucru. Studenții au folosit deja unelte de backup existente, care cumva fac backup-uri, iar apoi au integrat totul cu WAL-G, care trimitea toate acestea în cloud. Și de asemenea adăugau recuperarea în timp.
Ce au mai adus studenții? Au adus în WAL-G suport pentru criptarea Libsodium.
De asemenea, avem acum politici de păstrare a backup-urilor. Acum backup-urile pot fi marcate ca permanente. Și este mai convenabil pentru serviciul dumneavoastră să automatizăm procesul de stocare a acestora.
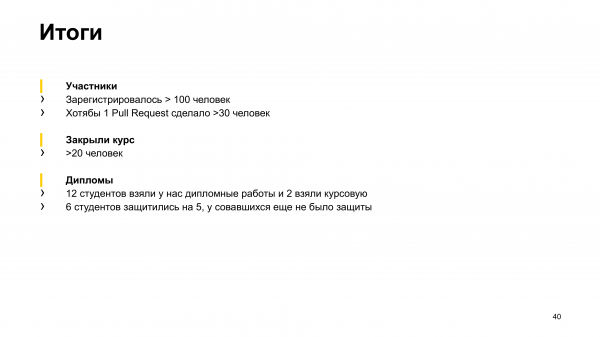
Ce rezultate a avut acest experiment?
Inițial, s-au înscris peste 100 de persoane la curs. La început, nu am menționat că universitatea din Ekaterinburg este Universitatea Federală Ural. Acolo am anunțat totul. 100 de persoane s-au înscris. De fapt, doar un număr mult mai mic a început să lucreze, aproximativ 30 de persoane.
Chiar mai puțin de 30 de persoane au terminat cursul, deoarece trebuia să scrie teste pentru codurile deja existente. De asemenea, trebuia să rezolve o eroare sau să implementeze o anumită funcționalitate. Totuși, câțiva studenți au reușit să finalizeze cursul.
În acest moment, studenții au rezolvat aproximativ 14 probleme și au realizat 10 funcționalități de diverse dimensiuni. Și, din punctul meu de vedere, aceasta este o înlocuire completă pentru unul sau doi dezvoltatori.
Pe lângă toate acestea, am eliberat diplome și lucrări de curs. 12 studenți au primit diplomele. 6 dintre ei au obținut deja nota 5. Ceilalți nu au avut încă susțineri, dar cred că le va merge bine și lor.
Planuri de viitor
Ce planuri avem pentru viitor?
Cel puțin acele cereri de funcționalități pe care le-am auzit deja de la utilizatori și pe care dorim să le implementăm. Acestea sunt:
- Monitorizarea corectitudinii urmăririi cronologiei în arhiva backup-urilor HA-cluster. Acest lucru se poate face cu ajutorul WAL-G. Și cred că vom găsi studenți care se vor ocupa de aceasta.
- Pentru transferul backup-urilor și WAL între cloud-uri, avem deja o persoană responsabilă.
- Recent, am publicat ideea că putem accelera și mai mult WAL-G prin decompresia backup-urilor incrementale fără a suprascrie paginile și optimizarea arhivelor pe care le trimitem acolo.
Puteți să le împărtășiți aici
La ce a fost această prezentare? La faptul că, în afară de cei 4 oameni care susțin acest proiect, avem multe mâini suplimentare. În special, dacă le scrii pe mesageria privată. Și dacă faci backup pentru datele tale folosind WAL-G sau ai dori să migrezi la WAL-G, atunci dorințele tale pot fi luate în considerare destul de ușor.
Acesta este un cod QR și un link. Puteți să le folosiți pentru a accesa și a scrie toate dorințele voastre. De exemplu, dacă nu rezolvăm o anumită eroare. Sau o funcționalitate pe care o doriți foarte mult, dar nu o găsiți încă în niciun serviciu de backup, inclusiv în al nostru. Vă rugăm, nu uitați să ne informați despre aceasta.
Întrebări
Bună ziua! Vă mulțumesc pentru prezentare! Am o întrebare despre WAL-G, dar nu despre Postgres. WAL-G face backup pentru MySQL și inițiază un backup suplimentar. Dacă luăm instalațiile moderne pe CentOS și faceți "yum install MySQL", atunci se va instala MariDB. Începând cu versiunea 10.3, backup-ul suplimentar nu mai este suportat, fiind acceptat backup-ul pentru MariDB. Cum stau lucrurile cu voi în această privință?
În prezent, nu am încercat să facem backup pentru MariDB. Am avut solicitări pentru suport pentru FoundationDB, dar în general, dacă există o astfel de solicitare, putem găsi oameni care să facă acest lucru. Nu este atât de mult timp și nu este atât de complicat, așa cum mi se pare.
Bună ziua! Vă mulțumesc pentru prezentare! O întrebare despre potențialele caracteristici noi. Sunteți pregătiți să faceți să funcționeze WAL-G cu benzi, astfel încât să putem face backup pe benzi?
Se pare că vă referiți la backup pe stocarea cu bandă?
Da.
Acolo este Andrei Borodin, care poate răspunde mai bine decât mine la această întrebare.
(Andrei) Da, mulțumesc pentru întrebare! Am avut o solicitare pentru a transfera backup-ul pe bandă din stocarea cloud. Și pentru aceasta transferul între clouduri. Pentru că transferul între clouduri este o versiune oarecum generalizată a transferului pe bandă. În plus, avem o arhitectură extensibilă în ceea ce privește stocările. Apropo, multe dintre stocări au fost scrise de studenți. Și dacă scrieți un Storage pentru bandă, atunci cu siguranță va fi suportat. Suntem pregătiți să luăm în considerare un pull request. Trebuie să scrieți un fișier, să citiți un fișier. Dacă aceste lucruri sunt făcute în Go, de obicei se ajunge la 50 de linii de cod. Și atunci banda va fi suportată în WAL-G.
Mulțumesc pentru prezentare! Este un proces de dezvoltare interesant. Backup-ul este o parte serioasă a funcționalității, care trebuie să fie bine acoperită de teste. Când ați realizat funcționalitatea pentru noile baze, teste au fost scrise și de studenți sau le-ați scris voi și apoi ați predat implementarea studenților?
Teste au fost scrise și de studenți. Dar studenții au scris mai mult pentru caracteristici precum noile baze. Ei au scris teste de integrare. Și au scris teste unitare. Dacă testele de integrare trec, adică la momentul actual - acesta este un scenariu, pe care îl executezi manual sau acesta este realizat de cron, de exemplu. Așadar, scenariul este foarte clar.
Studenții nu au foarte multă experiență. Cât timp se pierde pentru revizuire?
Da, reviziile necesită destul de mult timp. Adică, de obicei, când vin mai mulți dezvoltatori și spun că am făcut asta, am făcut asta, trebuie să ne gândim și să alocăm cam o jumătate de zi pentru a înțelege ce au scris. Pentru că codul trebuie citit cu atenție. Ei nu au trecut printr-un interviu. Nu îi cunoaștem foarte bine, așa că aceasta ia timp considerabil.
Mulțumesc pentru prezentare! Anterior, Andrei Borodin a afirmat că archive_command în WAL-G ar trebui apelat direct. Dar în cazul unui cluster patron, avem nevoie de logică suplimentară pentru a determina nodul de la care să trimitem jurnalul. Cum rezolvați această problemă la voi?
Ce problemă aveți aici? Să zicem că aveți o replică sincronă de la care faceți backup? Sau ce?
(Andrei) Problema este că, într-adevăr, WAL-G presupune utilizarea fără scripturi shell. Dacă lipsește ceva, atunci haideți să completăm logica care ar trebui să fie în interiorul WAL-G. Referitor la originea arhivării, noi credem că arhivarea ar trebui să vină de la masterul curent din cluster. Arhivarea din replică este o idee proastă. Există diferite scenarii cu probleme. În special, probleme cu arhivarea timeline-urilor și a informațiilor suplimentare. Mulțumesc pentru întrebare!
(Clarificare: Am renunțat la atașarea scripturilor shell) )
Bună seara! Mulțumesc pentru prezentare! M-a interesat funcția catchup despre care ați vorbit. Ne-am confruntat cu situatia în care replica întârziase și nu putea să recupereze. Și în WAL-G nu am găsit descrierea acestei funcții în documente.
Catchup a apărut practic în jurul datei de 20 ianuarie 2020. Poate ar trebui să lucrăm mai bine la documentație. O scriem noi și nu o facem neapărat excelent. Și probabil că ar trebui să cerem studenților să o redacteze.
Este deja în versiune?
Cererea de pull a fost deja integrată, adică am verificat-o. Am încercat aceasta pe un cluster de testare. Până acum nu am avut situații în care să putem verifica aceasta în practică.
Când să ne așteptăm?
Nu știu. Așteptați o lună, cu siguranță vom verifica.
Sursa: habr.com
