

Pe 27 mai, în sala principală a conferinței DevOpsConf 2019, parte a festivalului , în cadrul secțiunii „Livrare continuă”, a fost prezentată lucrarea „werf — instrumentul nostru pentru CI/CD în Kubernetes”. Aceasta discută despre provocările și dificultățile cu care se confruntă fiecare la implementarea în Kubernetes, precum și despre nuanțele care pot să nu fie evidente imediat. Analizând posibilele soluții, arătăm cum este implementat în instrumentul Open Source .
De la prezentare, utilitarul nostru (cunoscut anterior sub numele de dapp) a depășit o bornă istorică de 1000 de stele pe GitHub — sperăm că comunitatea în creștere a utilizatorilor îl va face viața mai ușoară multor ingineri DevOps.
Așadar, vă prezentăm (~47 de minute, mult mai informativ decât un articol) și o sinteză principală a acesteia în format text. Să începem!
Livrarea codului în Kubernetes
În prezentare se va discuta mai puțin despre werf și mai mult despre CI/CD în Kubernetes, presupunând că software-ul nostru este ambalat în containere Docker (despre care am vorbit în ), iar K8s va fi utilizat pentru a-l rula în producție (despre acest lucru — în ).
Cum arată livrarea în Kubernetes?
- Există un depozit Git cu codul și instrucțiunile pentru compilarea acestuia. Aplicația este compilată într-o imagine Docker și publicată în Docker Registry.
- În același depozit există instrucțiuni și despre cum să se implementeze și să se ruleze aplicația. În etapa de implementare, aceste instrucțiuni sunt trimise către Kubernetes, care primește imaginea necesară din registry și o lansează.
- În plus, de obicei există teste. Unele dintre acestea pot fi efectuate în timpul publicării imaginii. De asemenea, se poate (urmand aceleași instrucțiuni) să desfășurați o copie a aplicației (într-un spațiu de nume K8s separat sau într-un cluster separat) și să rulați teste acolo.
- În cele din urmă, este nevoie de un sistem CI care primește evenimente din Git (sau apăsări de butoane) și cheamă toate etapele definite: build, publish, deploy, test.
Aici sunt câteva observații importante:
- Deoarece avem o infrastructură imuabilă (immutable infrastructure), imaginea aplicației, care este utilizată în toate etapele (staging, production etc.), trebuie să fie una singură. Mai multe despre acest lucru, cu exemple, am discutat .
- Deoarece urmăm abordarea infrastructură ca cod (IaC), codul aplicației, instrucțiunile pentru compilarea și rularea acesteia trebuie să fie în același depozit. Mai multe detalii despre acest subiect — vezi în .
- Întreaga lanț de livrare (delivery) De obicei vedem așa: aplicația este compilată, testată și lansată (etapa release) și totul — livrarea a avut loc. Dar, în realitate, utilizatorul primește ceea ce ați lansat, nu atunci când a fost livrat în producție, și când a putut accesa acea producție și aceasta a funcționat. Prin urmare, consider că lanțul de livrare se termină numai la etapa de exploatare (run), și, dacă vrem să fim mai preciși, chiar în momentul în care codul este eliminat din producție (înlocuindu-l cu unul nou).
Să ne întoarcem la schema de livrare menționată mai sus în Kubernetes: aceasta nu a fost inventată doar de noi, ci practic de toți cei care s-au ocupat de această problemă. Practic, acest model este acum numit GitOps (mai multe despre termen și conceptele din spatele acestuia pot fi citite ). Să ne uităm la etapele schemei.
Etapa de compilare (build)
Părea că nu mai este nimic de spus în 2019 despre compilarea imaginilor Docker, când toată lumea știe să scrie Dockerfile-uri și să le ruleze docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- Dimensiunea imaginii contează, așa că folosiți , pentru a lăsa în imagine doar ceea ce este cu adevărat necesar pentru funcționarea aplicației.
- Numărul de straturi trebuie minimizat, combinând lanțurile de
comenzi RUN după semnificație.Cu toate acestea, acest lucru adaugă probleme - de depanare , deoarece, în cazul unei căderi a compilării, trebuie să găsim comanda specifică din lanț care a cauzat problema.Viteza de compilare
- este importantă, deoarece dorim să lansăm rapid modificările și să vedem rezultatul. De exemplu, nu vrem să recompilăm dependențele din bibliotecile limbajului la fiecare compilare a aplicației. Adesea, dintr-un singur repository Git sunt necesare
- multe imagini , ceea ce poate fi rezolvat printr-un set de Dockerfile-uri (sau etape denumite într-un singur fișier) și un script Bash pentru compilarea lor în mod secvențial.Acesta a fost doar vârful aisbergului cu care se confruntă toți. Dar există și alte probleme, în special:
Adesea, în etapa de compilare avem nevoie să montăm ceva
- (de exemplu, să cache-ăm rezultatul unei comenzi de tip apt într-un director extern). Dorim să compilăm fără Docker
- (de ce ne-ar trebui o mașină virtuală suplimentară, în care trebuie să configurăm totul, când avem deja un cluster Kubernetes în care putem rula containere?). Ansible Compilare paralelă
- (de ce ne-ar trebui o mașină virtuală suplimentară, în care trebuie să configurăm totul, când avem deja un cluster Kubernetes în care putem rula containere?). собирать без Docker (зачем нам дополнительная виртуальная машина, в которой надо всё для этого настраивать, когда уже есть кластер Kubernetes, в котором можно запускать контейнеры?).
- Параллельная сборка, care poate fi înțeles în moduri diferite: comenzi diferite din Dockerfile (dacă se utilizează multi-stage), mai multe commit-uri dintr-un singur depozit, mai multe Dockerfile-uri.
- Construire distribuită: dorim să construim ceva în pod-uri, care sunt „efemere”, deoarece cache-ul lor dispare, ceea ce înseamnă că trebuie să-l stocăm undeva separat.
- În cele din urmă, am denumit vârful dorințelor automagie: ar fi ideal să intri în depozit, să introduci o anumită comandă și să obții o imagine gata, construită cu înțelegerea a ceea ce trebuie făcut corect. Cu toate acestea, personal, nu sunt sigur că toate nuanțele pot fi prevăzute astfel.
Și iată că există proiecte:
- — un constructor de la compania Docker Inc (deja integrat în versiunile actuale de Docker), care încearcă să rezolve toate aceste probleme;
- — un constructor de la Google, care permite construcția fără Docker;
- — o încercare CNCF de a face automagie și, în special, o soluție interesantă cu rebase pentru straturi;
- și încă o mulțime de alte utilitare, cum ar fi , …
… și vezi câte stele au pe GitHub. Adică, pe de o parte, docker build există și pot face ceva, dar în realitate întrebarea nu este complet rezolvată — dovada acestui lucru o reprezintă dezvoltarea paralelă a constructorilor alternativi, fiecare dintre ei rezolvând o parte din probleme.
Construirea în werf
Așa am ajuns la (anterior sub numele de dapp) — un utilitar Open Source de la compania „Flant”, pe care îl dezvoltăm de mulți ani. Totul a început acum aproximativ 5 ani cu scripturi Bash care optimizau construirea Dockerfile-urilor, iar în ultimii 3 ani s-a desfășurat o dezvoltare completă în cadrul unui singur proiect cu propriul său depozit Git (inițial pe Ruby, iar apoi în Go, și cu această ocazie l-am redenumit). Ce probleme de construcție sunt rezolvate în werf?
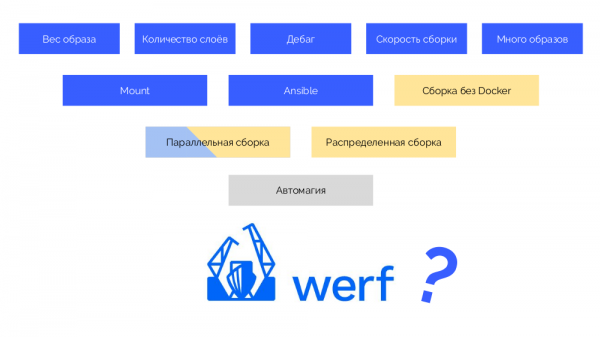
Problemele colorate în albastru sunt deja implementate, construcția paralelă a fost realizată în cadrul unei singure gazde, iar cele marcate în galben sunt planificate pentru finalizare până la sfârșitul verii.
Etapa de publicare în registru (publish)
Am folosit docker push… — ce poate fi complicat în a încarcă o imagine în registru? Și aici apare întrebarea: „Ce etichetă să punem imaginii?” Aceasta apare din cauza că avem Gitflow (sau o altă strategie Git) și Kubernetes, iar industria se îndreaptă spre a asigura că ceea ce se întâmplă în Kubernetes urmează ceea ce se face în Git. Deoarece Git este singura noastră sursă de adevăr.
Ce e complicat în asta? Agaranta reproducibilitatea: de commit-ul din Git, care este în mod inerent imuabil (imuabil), până la imaginea Docker, care trebuie să rămână aceeași.
De asemenea, este important pentru noi să definim originea, deoarece dorim să înțelegem din ce commit a fost construită aplicația care rulează în Kubernetes (atunci putem face diff-uri și lucruri asemănătoare).
Strategiile de etichetare
Prima este o simplă git tag. Avem un registry cu imaginea etichetată ca 1.0. În Kubernetes există stage și production, unde această imagine a fost implementată. În Git facem commit-uri și la un moment dat punem eticheta 2.0. O compilăm conform instrucțiunilor din repository și o plasăm în registry cu eticheta 2.0. O implementăm pe stage și, dacă totul este bine, apoi pe production.
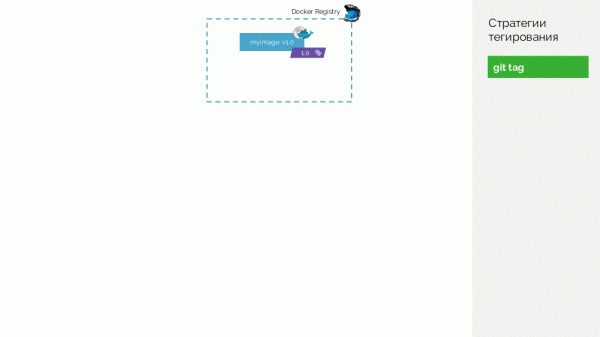
Problema acestei abordări este că am pus mai întâi o etichetă, iar abia apoi am testat și implementat. De ce? În primul rând, este pur și simplu nelogic: emitem o versiune a software-ului pe care nu l-am verificat încă (nu putem face altfel, deoarece pentru a verifica trebuie să punem eticheta). În al doilea rând, acest drum nu se potrivește cu Gitflow.
A doua variantă este git commit + tag. În ramura master există eticheta 1.0; pentru ea în registry – imaginea desfășurată pe production. În plus, în clusterul Kubernetes există contururi de preview și staging. Înaintăm cu Gitflow: în ramura principală pentru dezvoltare (develop) facem noi funcționalități, rezultând un commit cu identificatorul #c1. O compilăm și o publicăm în registry, folosind acest identificator (#c1). Cu același identificator o implementăm pe preview. Facem la fel cu commit-urile #c2 și #c3.
Când ne dăm seama că avem suficiente funcționalități, începem să stabilizăm totul. În Git creăm o ramură release_1.1 (pe baza #c3 din develop). Nu va fi nevoie să compilăm această versiune, deoarece a fost realizată în etapa anterioară. Prin urmare, putem pur și simplu să o implementăm pe staging. Corectăm erorile în #c4 și similar implementăm pe staging. Între timp, se desfășoară dezvoltarea în develop, unde periodic se iau modificări din release_1.1. La un moment dat obținem un commit compilat și implementat pe staging, cu care suntem mulțumiți (#c25).
Atunci facem merge (cu fast-forward) din ramura de release (release_1.1) în master. Punem pe acest commit o etichetă cu noua versiune (1.1). Dar această imagine este deja compilată în registry, așa că, pentru a nu o compila din nou, pur și simplu adăugăm a doua etichetă pe imaginea existentă (acum are în registry etichete #c25 și 1.1). După aceea o implementăm pe production.
Există un dezavantaj, că pe staging a fost implementată o imagine (#c25), iar pe production – ca și cum ar fi alta (1.1), dar știm că „fizic” este aceeași imagine din registry.
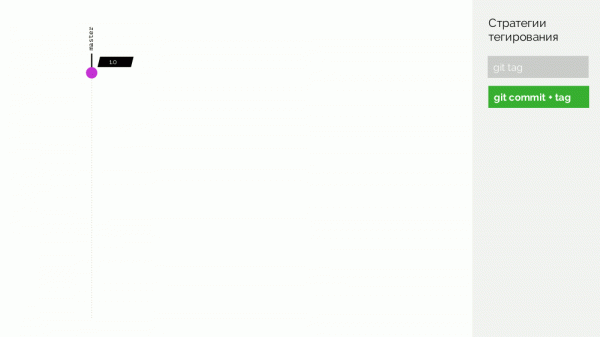
De fapt, dezavantajul este că nu există suport pentru merge commit-uri, trebuie să facem fast-forward.
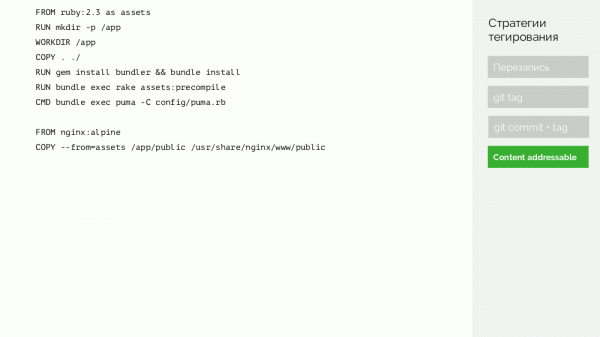
Putem merge mai departe și face un truc… Să luăm în considerare un exemplu simplu de Dockerfile:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Vom construi din el un fișier după următoarea idee:
- SHA256 din identificatorii imaginilor utilizate (
ruby:2.3șinginx:alpine), care sunt sume de control ale conținutului lor; - toate comenzile (
comenzi RUN după semnificație.,CMDetc.); - SHA256 din fișierele care au fost adăugate.
… și vom lua suma de control (din nou SHA256) a acestui fișier. Aceasta este semnătura a tot ceea ce definește conținutul imaginii Docker.
Să ne întoarcem la schemă și în loc de commit-uri, vom folosi astfel de semnături, adică vom eticheta imaginile cu semnături.
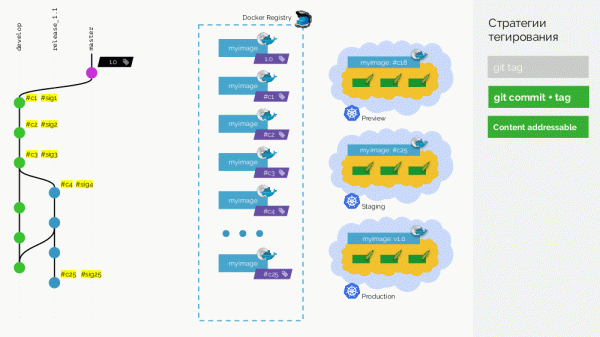
Acum, când va fi nevoie, de exemplu, să “mergem” schimbările din release în master, putem face un adevărat merge commit: va avea un alt identificator, dar aceeași semnătură. Cu același identificator, vom lansa imaginea și în producție.
Dezavantajul este că acum nu va fi posibil să determinăm ce commit a fost lansat în producție — sumele de control funcționează doar într-o singură direcție. Această problemă se rezolvă printr-un strat suplimentar de metadate — voi explica mai multe mai departe.
Etichetarea în werf
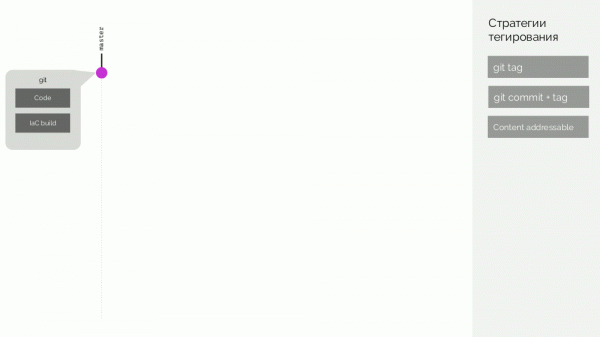
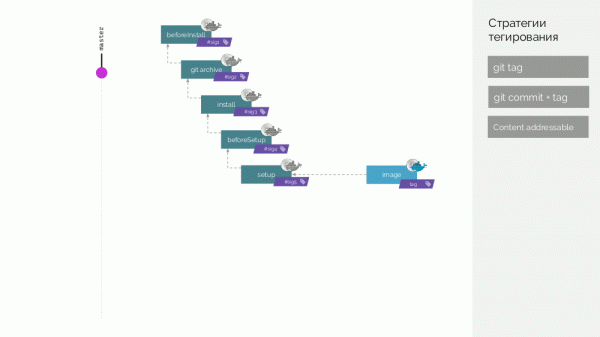
În werf am mers și mai departe și ne pregătim să facem o construcție distribuită cu un cache care nu se află pe o singură mașină… Așadar, noi construim imagini Docker de două tipuri, pe care le numim stage și imagine.
În depozitul Git werf se află instrucțiuni specifice pentru construcție, care descriu diferitele etape ale construției (beforeInstall, install, beforeSetup, setup). Prima imagine de etapă o construim cu semnătura definită ca sumă de control a primelor pași. Apoi adăugăm codul sursă, pentru noua imagine de etapă calculăm suma de control… Aceste operațiuni se repetă pentru toate etapele, rezultând un set de imagini de etapă. Apoi facem imaginea finală, care conține și metadate despre originea sa. Iar această imagine o etichetăm în diverse moduri (detalii mai târziu).
Să presupunem că apare un nou commit în care s-a adus o modificare doar în codul aplicației. Ce se va întâmpla? Pentru modificările de cod se va crea un patch, pregătit un nou stage-image. Semnătura sa va fi definită ca suma de control a vechiului stage-image și a noului patch. Din această imagine se va forma un nou final image.
Astfel, stage-images sunt un cache care poate fi stocat distribuit, iar imaginile create din acestea sunt încărcate în Docker Registry.
Curățarea registry-ului
Nu este vorba despre eliminarea straturilor care au rămas suspendate după etichetele șterse — aceasta este o capacitate standard a Docker Registry-ului. Vorbim despre situația în care se acumulează o mulțime de etichete Docker și realizăm că o parte dintre ele nu ne mai sunt necesare, dar ocupă spațiu (și/sau plătim pentru el).
Ce strategii de curățare există?
- Putem pur și simplu să nu facem nimic să nu curățăm. Uneori este mai simplu să plătim puțin pentru spațiul suplimentar decât să descurcăm un ghem uriaș de etichete. Dar asta funcționează doar până la un anumit moment.
- Resetare completă. Dacă ștergem toate imaginile și reconstruim doar cele actuale în CI, poate apărea o problemă. Dacă un container se repornește pe production, se va descărca o nouă imagine — una care nu a fost testată de nimeni. Asta contrazice ideea de infrastructură immutable.
- Blue-green. Un registry a început să se umple — încărcăm imaginile într-un altul. Aceeași problemă ca în metoda precedentă: în ce moment putem curăța registry-ul care a început să se umple?
- Pe baza timpului. Să ștergem toate imaginile mai vechi de 1 lună? Dar cu siguranță va exista un serviciu care nu a fost actualizat timp de o lună…
- Manual să determinăm ce poate fi șters deja.
În realitate, există două variante viabile: să nu curățăm sau o combinație de blue-green + manual. În ultimul caz, este vorba despre următoarele: când realizăm că este timpul să curățăm registry-ul, creăm unul nou și adăugăm toate imaginile noi în el timp de, să zicem, o lună. Apoi, după o lună, ne uităm care pod-uri din Kubernetes continuă să folosească registry-ul vechi și le transferăm și pe ele în registry-ul nou.
La ce concluzie am ajuns în werf? Мы собираем:
- Git head: toate etichetele, toate ramurile, presupunând că tot ce este etichetat în Git ne trebuie și în imagini (iar dacă nu, trebuie șters direct în Git);
- toate pod-urile care sunt acum descărcate în Kubernetes;
- ReplicaSet-urile vechi (cele care au fost recent descărcate), precum și planificarea scanării Helm-release-urilor și selectarea celor mai recente imagini.
… și facem din acest set un whitelist — o listă de imagini pe care nu le vom șterge. Tot ce rămâne va fi șters, după care căutăm imagini stage orfane și le eliminăm și pe acestea.
Etapa de implementare (deploy)
Declarativitate fiabilă
Primul aspect la care dorim să atragem atenția în cadrul implementării este actualizarea configurației resurselor, declarate declarativ. Documentul YAML original cu descrierea resurselor Kubernetes diferă întotdeauna semnificativ de rezultatul real care funcționează în cluster. Acest lucru se datorează faptului că Kubernetes adaugă în configurație:
- identificatori;
- informații de sistem;
- multe valori implicite;
- o secțiune cu starea curentă;
- modificările efectuate în cadrul funcționării webhook-ului de admitere;
- rezultatul activității diferitelor controllere (și programatorului).
Prin urmare, atunci când apare o nouă configurație a resursei (nou), nu putem pur și simplu să o suprascriem pe cea actuală, "vie" (live). Pentru aceasta, va trebui să comparăm nou cu configurația anterioară aplicată (last-applied) și să aplicăm live patch-ul obținut.
Această abordare se numește 2-way merge. Este utilizată, de exemplu, în Helm.
Există și 3-way merge, care se distinge prin faptul că:
- comparând last-applied și nou, observăm ce a fost șters;
- comparând nou și live, observăm ce a fost adăugat sau modificat;
- patch-ul sumarizat îl aplicăm pe live.
Implementăm peste 1000 de aplicații cu Helm, astfel că trăim efectiv cu 2-way merge. Totuși, există o serie de probleme pe care le-am rezolvat cu patch-urile noastre, ajutând Helm să funcționeze corect.
Starea reală a desfășurării
După ce sistemul nostru CI a generat o nouă configurație pentru Kubernetes, o trimite pentru aplicare (apply) în cluster — cu ajutorul Helm sau kubectl apply. Ulterior, are loc deja menționatul N-way merge, la care API-ul Kubernetes răspunde favorabil sistemului CI, iar acesta — utilizatorului său.
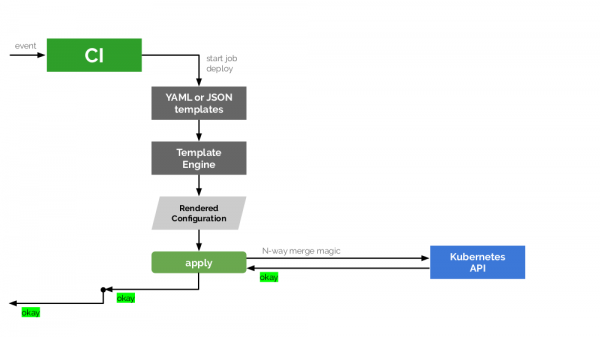
Totuși, există o problemă majoră: de fapt, aplicarea cu succes nu înseamnă desfășurare cu succes. Dacă Kubernetes a înțeles ce modificări trebuie aplicate, le aplică — încă nu știm ce va rezulta. De exemplu, actualizarea și repornirea pod-urilor în frontend poate decurge cu succes, în timp ce în backend — nu, și vom obține versiuni diferite ale imaginilor aplicației lansate.
Pentru a face totul corect, în acest schema se impune un element suplimentar - un tracker special care va primi informații de la Kubernetes API despre statut și o va transmite pentru analiza ulterioară a situației actuale. Am creat o bibliotecă Open Source în Go - (vezi anunțul său ), - care rezolvă această problemă și este încorporată în werf.
Comportamentul acestui tracker la nivel de werf este configurat prin intermediul anotărilor, care sunt plasate pe Deployments sau StatefulSets. Anotarea principală - fail-mode — înțelege următoarele valori:
-
IgnoreAndContinueDeployProcess— ignorăm problemele legate de implementarea acestui component și continuăm desfășurarea; -
FailWholeDeployProcessImmediately— o eroare în acest component oprește procesul de desfășurare; -
HopeUntilEndOfDeployProcess— sperăm că acest component va funcționa până la finalizarea desfășurării.
De exemplu, o astfel de combinație din resurse și valori de anotare fail-mode:
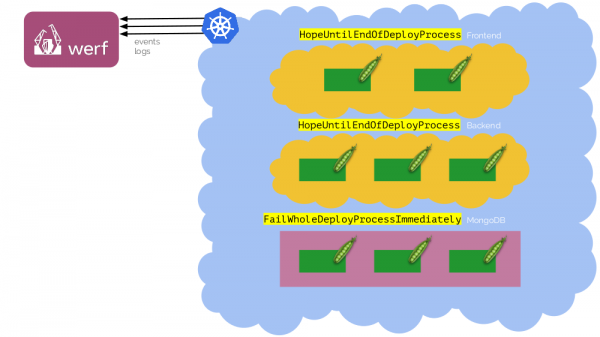
Când desfășurăm pentru prima dată, baza de date (MongoDB) poate încă să nu fie pregătită - Deployments vor eșua. Dar putem aștepta momentul în care aceasta se va porni, iar desfășurarea va avea loc.
Există încă două anotări pentru kubedog în werf:
-
failures-allowed-per-replica— numărul de eșecuri permise pentru fiecare replica; -
show-logs-until— reglează momentul până la care werf arată (în stdout) jurnalele din toate pod-urile desfășurate. Implicit, aceasta estePodIsReady(pentru a ignora mesajele care sunt puțin probabil să ne fie utile atunci când pe pod începe să vină trafic), totuși, sunt acceptate și valorileControllerIsReadyșiEndOfDeploy.
Ce altceva ne dorim de la desfășurare?
Pe lângă cele două puncte deja descrise, ne-ar plăcea să:
- vedem jurnalele — și doar cele necesare, nu toate cele aleatorii;
- urmărim progresul, pentru că, dacă task-ul „stă liniștit” câteva minute, este important să înțelegem ce se întâmplă acolo;
- avem o revenire automată în cazul în care ceva nu a mers bine (și, prin urmare, este critic să știm statutul real al desfășurării). Desfășurarea trebuie să fie atomică: fie trece până la capăt, fie totul revine la starea anterioară.
Concluzii
Pentru noi ca companie, pentru a implementa toate detaliile descrise în diferite etape de livrare (build, publish, deploy), este suficient un sistem CI și utilitarul .
În loc de concluzie:
Prin utilizarea werf, am avansat semnificativ în rezolvarea unui număr mare de probleme ale inginerilor DevOps și vom fi încântați dacă o comunitate mai largă va încerca măcar acest utilitar în acțiune. Obținerea unui rezultat bun împreună va fi mai ușor.
Videoclipuri și diapozitive
Video cu prezentarea (~47 minute):
Prezentarea conferinței:
P.S.
Alte prezentări despre Kubernetes pe blogul nostru:
- «» (Dmitri Stolyarov; 27 aprilie 2019 la „Stachka”);
- «» (Andrei Polovov; 8 aprilie 2019 la Saint HighLoad++);
- «» (Dmitri Stolyarov; 8 noiembrie 2018 la HighLoad++);
- «» (Dmitry Stolyarov; 28 mai 2018 la RootConf);
- «» (Dmitry Stolyarov; 7 noiembrie 2017 la HighLoad++);
- «» (Dmitry Stolyarov; 6 iunie 2017 la RootConf).
Sursa: habr.com
