

Împărtășesc din experiența mea personală ce, unde și când a fost util. Pe scurt și concis, pentru a fi clar ce și unde se poate explora mai departe — dar aici este vorba exclusiv despre experiența mea subiectivă, poate că pentru voi totul este complet diferit.
De ce este important să cunoști și să fii capabil să folosești limbajele de interogare? În esență, în Data Science sunt câteva etape esențiale ale muncii, iar cea mai importantă și prima (fără de care nimic nu funcționează!) este obținerea sau extragerea datelor. Cel mai frecvent, datele se găsesc în cine știe ce formă undeva și trebuie „scoase” de acolo.
Limbajele de interogare permit, tocmai, extragerea acestor date! Și astăzi vă voi vorbi despre limbajele de interogare care mi-au fost utile și vă voi arăta unde și cum anume — și de ce este necesar să le studiem.
Vor fi trei blocuri principale de tipuri de interogări pentru date pe care le vom analiza în acest articol:
- Limbaje de interogare „standard” — ceea ce se înțelege în mod obișnuit când se vorbește despre limbaje de interogare, cum ar fi algebra relațională sau SQL.
- Limbaje de interogare scriptate: de exemplu, utilizările în Python cum ar fi pandas, numpy sau scripting-ul shell.
- Limbaje de interogare pentru grafuri de cunoștințe și baze de date grafice.
Tot ce este scris aici este pur și simplu experiența personală, ce a fost util, cu descrierea situațiilor și „de ce a fost necesar” — fiecare poate evalua cât de mult aceste situații ar putea apărea și poate încerca să se pregătească pentru ele în prealabil, învățând aceste limbaje înainte de a fi nevoit să le folosească în (cazuri de urgență) pe un proiect sau de a ajunge în un proiect unde sunt necesare.
Limbaje de interogare „standard”
Limbajele de interogare standard sunt așa cum ne imaginăm în mod obișnuit când vorbim despre cereri.
Algebra relațională
De ce este necesară astăzi algebra relațională? Pentru a avea o bună înțelegere a motivului pentru care limbajele de interogare sunt structurate într-un anumit mod și pentru a le folosi conștient, este necesar să înțelegem miezul pe care se bazează.
Ce este algebra relațională?
Definiția formală este: algebra relațională — un sistem închis de operații asupra relațiilor din modelul de date relațional. Mai pe înțelesul tuturor, este un sistem de operații asupra tabelelor, astfel încât rezultatul să fie, de asemenea, întotdeauna o tabelă.
Vezi toate operațiile relaționale în articolul de pe Habră — aici descriem de ce trebuie să știi și unde este util.
De ce?
Începi să înțelegi cum se formează limbajele de interogare și ce operații stau la baza expresiilor specifice limbajelor de interogare — adesea oferă o înțelegere mai profundă a ceea ce și cum funcționează limbajele de interogare.
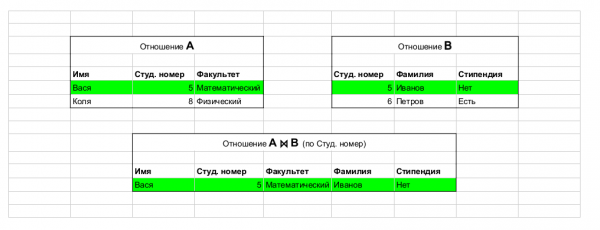
Preluat din articol. Exemplu de operație: join, care unește tabele.
Materiale pentru studiu:
. În general, există o mulțime de materiale despre algebra relațională și teorie — Coursera, Udacity. Există, de asemenea, o mulțime de materiale online, inclusiv cursuri academice bune, . Sfaturile mele personale: trebuie să înțelegi foarte bine algebra relațională — este baza bazei.
SQL
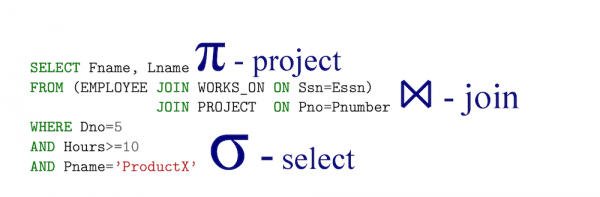
Preluat din articolului.
SQL este, de fapt, o implementare a algebrei relaționale — cu o importantă precizare, SQL este declarativ! Asta înseamnă că, scriind o interogare în limbajul algebrei relaționale, în esență, spui cum trebuie să se calculeze — iar cu SQL specifici ce vrei să extragi, iar apoi SGBD-ul generează deja (eficient) expresiile în limbajul algebrei relaționale (echivalența lor ne este cunoscută sub ).
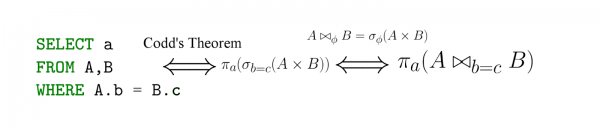
Preluat din articolului.
De ce?
SGBD-urile relaționale: Oracle, Postgres, SQL Server, etc — sunt în continuare, de fapt, peste tot, și este incredibil de probabil să interacționezi cu ele, ceea ce înseamnă că va trebui fie să citești SQL (ceea ce este foarte probabil), fie să scrii în el (de asemenea, nu este deloc improbabil).
Ce să citești și să studiezi
Pe aceleași linkuri de mai sus (despre algebra relațională), există o cantitate incredibilă de materiale, de exemplu, .
Apropo, ce este NoSQL?
„Este important să subliniem din nou că termenul „NoSQL” are o origine absolut spontană și nu are o definiție comun acceptată sau o instituție științifică în spate.” Respectiv, pe Habr.
Practic, oamenii au înțeles că modelul relațional complet nu este necesar pentru a rezolva multe probleme, în special pentru cele în care, de exemplu, performanța este principială și predomină anumite interogări simple cu agregare — acolo este critic să se calculeze rapid metricile și să le scrie în bază, iar majoritatea caracteristicilor relaționale s-au dovedit a fi nu doar inutile, ci și dăunătoare — de ce să normalizăm ceva dacă aceasta va afecta cel mai important lucru pentru noi (pentru o anumită sarcină specifică) — performanța?
De asemenea, deseori sunt necesare scheme flexibile în locul schemelor matematice fixe ale modelului relațional clasic — și asta simplifică incredibil dezvoltarea aplicațiilor, când este crucial să desfășori sistemul și să începi să lucrezi rapid, procesând rezultatele — sau schema și tipurile de date stocate nu sunt atât de importante.
De exemplu, creăm un sistem expert și dorim să stocăm informații pentru un anumit domeniu împreună cu unele metainformații — putem să nu cunoaștem toate câmpurile și pur și simplu să stocăm JSON pentru fiecare înregistrare — asta ne dă un mediu foarte flexibil pentru extinderea modelului de date și iterarea rapidă — de aceea, în acest caz, NoSQL va fi chiar preferabil și mai lizibil. Exemplul unei înregistrări (dintr-unul dintre proiectele mele, unde NoSQL a fost chiar acolo unde era necesar).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Mai multe detalii pot fi citite despre NoSQL.
Ce să studiez?
Aici mai degrabă trebuie să analizezi bine sarcina ta, care sunt proprietățile acesteia și ce sisteme NoSQL există care se potrivesc acestei descrieri — și deja să te apuci de studiat acest sistem.
Limbi de script pentru interogări
La început, pare ciudat să aduci în discuție Python — este un limbaj de programare, nu se ocupă în mod direct de interogări.
- Pandas este un adevărat cuțit elvețian al științei datelor, un număr imens de transformări de date, agregări etc. se realizează în el.
- Numpy — calcule vectoriale, matrice și algebră liniară.
- Scipy — multă matematică în acest pachet, în special statistica.
- Jupyter lab — multă analiză exploratorie a datelor se integrează bine în notebook-uri — este util să știi cum să lucrezi cu ele.
- Requests — lucrul cu rețeaua.
- Pyspark — foarte popular printre inginerii de date, cel mai probabil va trebui să interacționezi cu aceasta sau cu Spark, din cauza popularității lor.
- *Selenium — foarte util pentru colectarea datelor de pe site-uri și resurse, uneori datele pur și simplu nu pot fi obținute în alt mod.
Principalul meu sfat: învață Python!
Pandas
Să luăm ca exemplu următorul cod:
import pandas as pd
df = pd.read_csv(“data/dataset.csv”)
# Calculează și redenumește agregările
all_together = (df[df[‘trip_type’] == “return”]
    .groupby(['start_station_name','end_station_name'])
                            .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           ‘amax': 'max_duration_seconds'}))
În esență, vedem că codul se încadrează în tiparul clasic SQL.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Dar partea importantă este că acest cod face parte dintr-un script și un pipeline, practic încorporăm interogările în pipeline-ul Python. În această situație, limbajul interogărilor vine din biblioteci precum Pandas sau pySpark.
În general, în pySpark vedem un tip similar de transformare a datelor prin limbajul interogărilor de genul:
df.filter(df.trip_type = 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Unde și ce să citești
Despre Python în general să găsești materiale pentru studiu. Există o cantitate uriașă de tutoriale online despre , și cursuri despre (dar și despre ). În general, materialele se găsesc foarte bine pe Google și, dacă ar trebui să aleg un pachet pe care să mă concentrez, acela ar fi panda, desigur. Există de asemenea .
Shell ca limbaj de interogare
Multe dintre proiectele de prelucrare și analiză a datelor cu care am lucrat sunt, de fapt, scripturi shell, care apelează cod scris în Python, Java și, bineînțeles, comenzile shell în sine. Prin urmare, în general, putem considera pipeline-urile în bash/zsh/etc., ca o anumită interogare de nivel înalt (desigur, se pot include și bucle, dar asta nu este tipic pentru codul DS în limbajele shell), să dăm un exemplu simplu – trebuia să fac un mapping QID în wikidata și un link complet pe wiki-ul rus și englez, pentru asta am scris o simplă interogare din comenzile bash, iar pentru ieșire am scris un simplu script în Python, pe care l-am combinat astfel:
pv 'data/latest-all.json.gz' |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py 'output.csv'
unde
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Acesta a fost, de fapt, întregul pipeline care crea mapping-ul necesar, după cum vedem, totul a funcționat în modul de flux:
- pv filepath — oferă un bar de progres pe baza dimensiunii fișierului și transmite conținutul mai departe
- unpigz -c citea o parte din arhivă și o trimitea către jq
- jq cu cheia — stream returna imediat rezultatul și îl transmitea post-procesorului (la fel ca în primul exemplu) pe Python
- în interiorul post-procesorului — este o mașină de stări simplă care formatează ieșirea
În total, un pipeline complex care funcționează în modul de flux pe date mari (0,5TB), fără resurse substanțiale și este realizat dintr-un pipeline simplu și câteva unelte.
Un alt sfat important: învățați să lucrați bine și eficient în terminal și să scrieți în bash/zsh/etc.
Unde va fi util? Aproape peste tot - materialele pentru studiu sunt din nou FOARTE multe pe internet. În special, iată articolul meu anterior.
Programarea în R
Din nou, cititorul poate exclama - ei bine, acesta este un întreg limbaj de programare! Și desigur, ar avea dreptate. Totuși, de obicei, am întâlnit R întotdeauna în astfel de contexte, în care, de fapt, a fost foarte asemănător cu un limbaj de interogare.
R este un mediu pentru calcule statistice și un limbaj pentru calcule și vizualizări statistice (conform ).
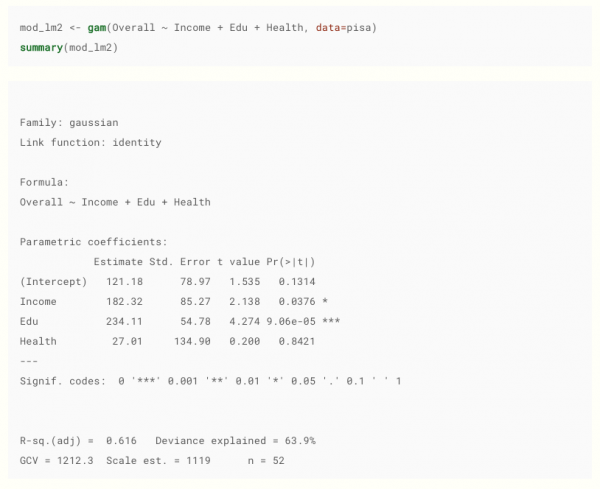
Luate . Apropo, recomand, este un material bun.
De ce trebuie să știe un data scientist R? Cel puțin, pentru că există o mulțime de oameni care nu sunt din IT, care se ocupă cu analiza datelor în R. Am întâlnit asta în următoarele domenii:
- Sectorul farmaceutic.
- Biologi.
- Sectorul financiar.
- Oameni cu pregătire pur matematică, care se ocupă cu statisticile.
- Modele statistice specializate și modele de învățare automată (care de obicei pot fi găsite doar în versiuni personalizate sub formă de pachet R).
De ce este acesta de fapt un limbaj de interogare? În forma în care este adesea întâlnit - este de fapt o solicitare pentru a crea un model, inclusiv citirea datelor și fixarea parametrilor interogării (modelului), precum și vizualizarea datelor în pachete precum ggplot2 - acesta este, de asemenea, o formă de scriere a interogărilor.
Exemplu de interogări pentru vizualizare
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
În general, multe idei din R au fost preluate în pachete python, precum pandas, numpy sau scipy, ca dataframe-uri și vectorizarea datelor - astfel că, în general, multe lucruri din R vă vor părea familiare și confortabile.
Există multe surse pentru studiu, de exemplu, .
Grafuri de cunoștințe (Knowledge graph)
Aici am o experiență puțin neobișnuită, deoarece mi se întâmplă destul de des să lucrez cu grafuri de cunoștințe și limbaje de interogare pentru grafuri. Așadar, vom trece rapid prin conceptele de bază, deoarece această parte este puțin mai exotică.
În bazele de date relaționale clasice, avem un schemă fixă - aici însă schema este flexibilă, fiecare predicat fiind practic o „coloană” și chiar mai mult.
Imaginați-vă că ați modela un om și ați dori să descrieți lucruri esențiale; de exemplu, să luăm ca bază descrierea acestui om, Douglas Adams.
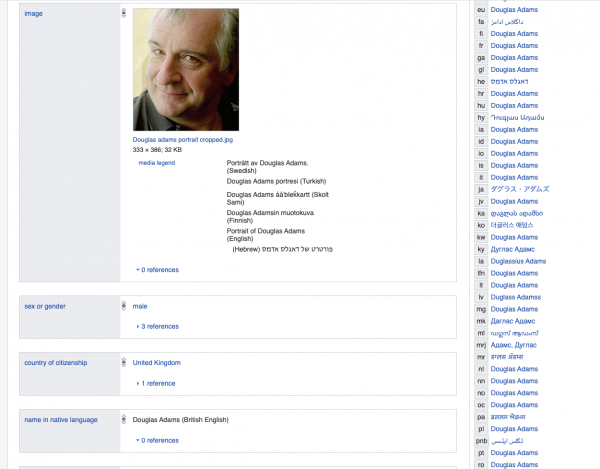
Dacă am folosit o bază de date relațională, ar fi trebuit să creăm un tabel uriaș sau tabele cu un număr enorm de coloane, majoritatea fiind NULL sau umplute cu o valoare implicită False; de exemplu, este puțin probabil ca mulți dintre noi să avem o înregistrare în biblioteca națională coreeană — desigur, am putea să le scoatem în tabele separate, dar, în final, aceasta ar fi o încercare de a modela o schemă logică flexibilă cu predicate, folosind o schemă relațională fixă.
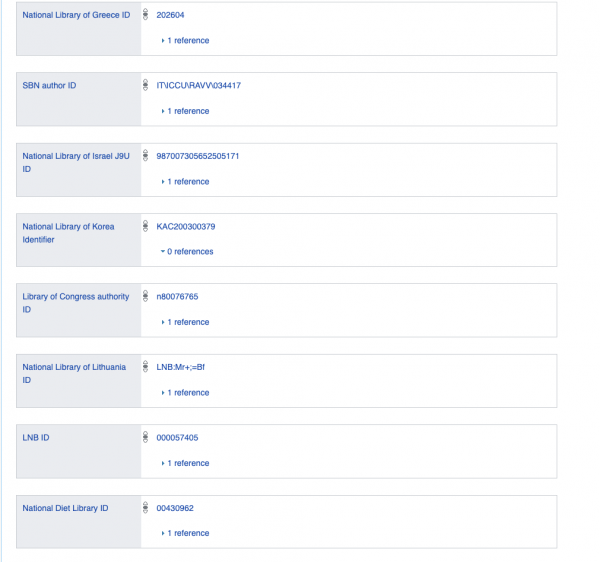
Prin urmare, imaginați-vă că toate datele sunt stocate sub formă de grafic sau de expresii logice binare și unare.
Unde ați putea întâlni așa ceva? În primul rând, lucrând cu , dar și cu orice baze de date grafice sau date interconectate.
Urmează principalele limbaje de interogare pe care a trebuit să le aplic și cu care am lucrat.
SPARQL
Wiki:
SPARQL ( de la SPARQL Protocol and RDF Query Language) — , prezentate conform modelului , dar și pentru pentru a transmite aceste interogări și răspunsurile la ele. SPARQL este o recomandare și una dintre tehnologiile .
De fapt, acesta este un limbaj de interogare pentru predicte logice unare și binare. Pur și simplu se indică, în mod convențional, ce este fix în expresia logică și ce nu este (foarte simplificat).
Însuși baza RDF (Resource Description Framework), pe care se execută interogările SPARQL - este un triplet obiect, predicat, subiect — și interogarea selectează tripletele necesare conform limitărilor specificate în stilul: a găsi un astfel de X, încât p_55(X, q_33) este adevărat - unde, desigur, p_55 este o relație cu id-ul 55, iar q_33 este un obiect cu id-ul 33 (aici se termină povestea, omiterând detaliile).
Exemplu de reprezentare a datelor:
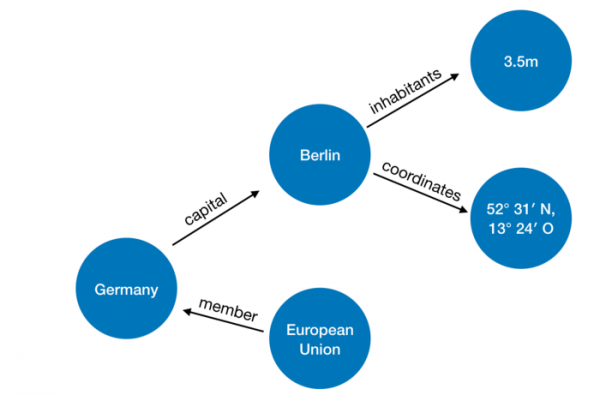
Imagini și exemplu cu țările aici .
Exemplu de interogare de bază
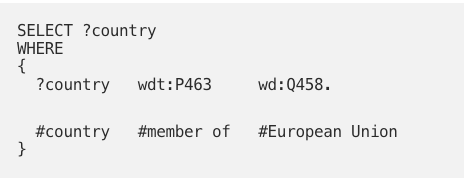
De fapt, vrem să găsim valoarea variabilei ?country, astfel încât pentru predicatul
member_of, este adevărat că member_of(?country,q458), iar q458 este ID-ul Uniunii Europene.
Un exemplu de interogare SPARQL în cadrul motorului Python:
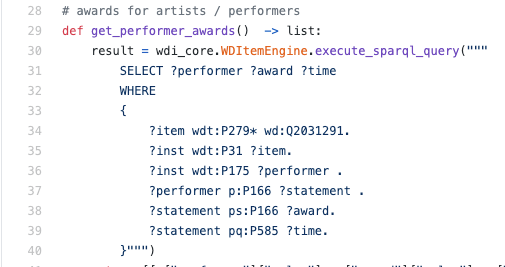
De obicei, a trebuit să citesc SPARQL, nu să scriu — în această situație, cu siguranță va fi un skill util să înțeleg limba, măcar la un nivel de bază, pentru a înțelege cum sunt extrase datele.
Există multe materiale online pentru a studia: de exemplu, aici și . De obicei, caut pe Google structuri și exemple specifice și mă descurc până acum.
Limbi logice de interogare
Mai multe informații pe această temă pot fi citite în articolul meu . Aici, vom analiza doar pe scurt de ce limbile logice sunt potrivite pentru scrierea interogărilor. În esență, RDF este doar un set de afirmații logice de tipul p(X) și h(X,Y), iar interogarea logică are următoarea formă:
output(X) :- country(X), member_of(X, "EU").
Aici vorbim despre crearea unui nou predicat output/1 (/1 înseamnă unitar), cu condiția ca pentru X să fie adevărat că country(X) — adică, X este o țară și de asemenea member_of(X, "EU").
Asta înseamnă că avem atât datele, cât și regulile în acest caz prezentate în același mod, ceea ce permite modelarea foarte ușoară și eficientă a problemelor.
Unde s-au întâlnit în industrie: un întreg proiect mare cu o companie care scrie interogări în această limbă, precum și în proiectul actual în nucleul sistemului — părea o chestiune destul de exotică, însă uneori apare.
Un exemplu de fragment de cod în limbaj logic care procesează wikidata:
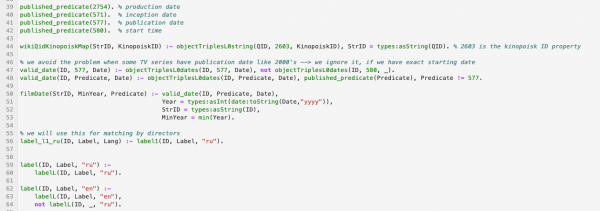
Materiale: voi oferi aici câteva linkuri către limbajul logic de programare Answer Set Programming — recomand să-l studiați exact pe acesta:
Sursa: habr.com
