

Dragi cititori, bună ziua. Astăzi vom vorbi puțin despre Apache Spark și perspectivele sale de dezvoltare.
În lumea modernă a Big Data, Apache Spark este de facto standard în dezvoltarea sarcinilor de procesare batch de date. Pe lângă aceasta, este folosit și pentru a crea aplicații de streaming care funcționează pe baza conceptului de micro-batch, procesând și livrând date în porții mici (Spark Structured Streaming). În mod tradițional, a fost parte din cadrul general Hadoop, folosindu-se de YARN ca manager de resurse (sau, în unele cazuri, Apache Mesos). Până în 2020, utilizarea sa în forma tradițională de către majoritatea companiilor este pusă sub semnul întrebării datorită absenței unor distribuții decente Hadoop — dezvoltarea HDP și CDH a fost oprită, CDH nu este suficient dezvoltat și are un cost ridicat, iar ceilalți furnizori Hadoop fie au încetat să existe, fie au un viitor incert. Prin urmare, un interes tot mai mare din partea comunității și a companiilor mari se concentrează pe lansarea Apache Spark cu ajutorul Kubernetes — devenind standard în orchestrarea containerelor și gestionarea resurselor în cloud-uri private și publice, rezolvă problema planificării inconfortabile a resurselor sarcinilor Spark pe YARN și oferă o platformă stabilă în dezvoltare, cu numeroase distribuții comerciale și open-source pentru companii de toate dimensiunile. În plus, pe valul popularității, majoritatea au reușit deja să-și configureze câteva instalări și să acumuleze expertiză în utilizarea sa, ceea ce simplifică migrarea.
Începând cu versiunea 2.3.0, Apache Spark a primit suport oficial pentru lansarea sarcinilor în clusterul Kubernetes, iar astăzi, vom discuta despre maturitatea actuală a acestei abordări, diversele sale utilizări și capcanele cu care va trebui să ne confruntăm la implementare.
În primul rând, vom analiza procesul de dezvoltare a sarcinilor și aplicațiilor bazate pe Apache Spark și vom evidenția cazurile tipice în care este necesară lansarea unei sarcini pe un cluster Kubernetes. Pentru redactarea acestui articol, se folosește OpenShift ca distribuție și vor fi furnizate comenzi relevante pentru utilitarul său de linie de comandă (oc). Pentru alte distribuții Kubernetes, pot fi utilizate comenzi corespunzătoare din utilitarul standard de linie de comandă Kubernetes (kubectl) sau echivalentele acestora (de exemplu, pentru oc adm policy).
Primul mod de utilizare - spark-submit
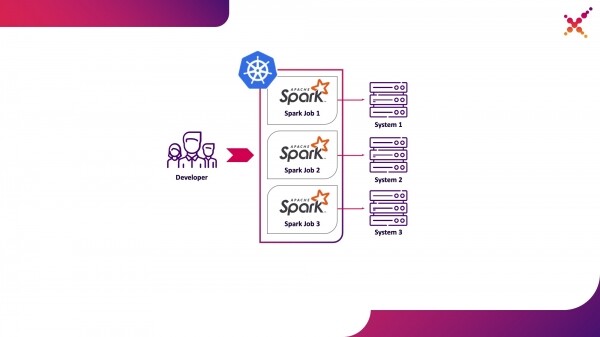
În procesul de dezvoltare a sarcinilor și aplicațiilor, dezvoltatorului îi este necesar să lanseze sarcini pentru a depana transformarea datelor. Teoretic, pentru aceste scopuri ar putea fi folosite stub-uri, dar dezvoltarea cu implicarea instanțelor reale (chiar și de test) ale sistemelor finale s-a dovedit a fi mai rapidă și de calitate superioară în acest tip de sarcini. În cazul în care depurăm pe instanțe reale ale sistemelor finale, pot exista două scenarii de lucru:
- dezvoltatorul lansează sarcina Spark local în modul standalone;

- dezvoltatorul lansează sarcina Spark pe un cluster Kubernetes în mediul de testare.
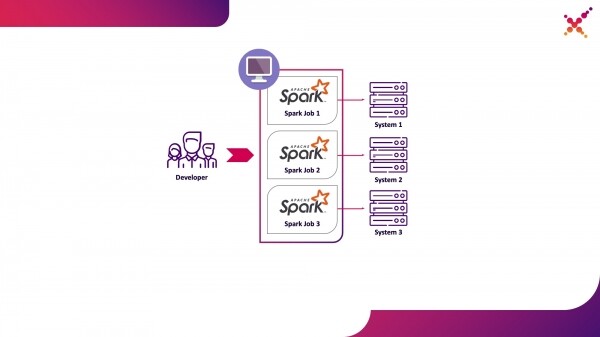
Primul mod de utilizare are drept de existență, dar implică o serie de dezavantaje:
- fiecare dezvoltator trebuie să asigure accesul din locul de muncă la toate instanțele finale necesare;
- pe mașina de lucru este necesară o cantitate suficientă de resurse pentru a lansa sarcina dezvoltată.
Al doilea mod de utilizare este lipsit de aceste dezavantaje, deoarece utilizarea clusterului Kubernetes permite alocarea unui set necesar de resurse pentru executarea sarcinilor și asigurarea accesului acestora la instanțele finale, oferind acces flexibil prin modelul de roluri Kubernetes pentru toți membrii echipei de dezvoltare. Să-l evidențiem ca primul mod de utilizare - lansarea sarcinilor Spark de pe mașina locală a dezvoltatorului pe clusterul Kubernetes în mediul de testare.
Să discutăm mai în detaliu despre procesul de configurare a Spark pentru execuția locală. Pentru a începe utilizarea Spark, trebuie să-l instalăm:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Adunăm pachetele necesare pentru a lucra cu Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Construirea completă durează mult timp, iar pentru a crea imagini Docker și a le lansa pe clusterul Kubernetes, în realitate sunt necesare doar fișierele jar din directorul „assembly/”, astfel încât putem construi doar acest subproiect:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Pentru a lansa sarcinile Spark în Kubernetes, este necesar să creăm o imagine Docker care va fi utilizată ca bază. Aici există 2 abordări:
- Imaginea Docker creată include codul executabil al sarcinii Spark;
- Imaginea creată include doar Spark și dependențele necesare, codul executabil fiind plasat de la distanță (de exemplu, în HDFS).
Pentru început, să construim imaginea Docker care conține un exemplu de test al sarcinii Spark. Pentru a crea imagini Docker, Spark are un instrument corespunzător numit „docker-image-tool”. Să consultăm ajutorul acestuia:
. /bin/docker-image-tool.sh --help
Prin intermediul acestuia se pot crea imagini Docker și se poate efectua încărcarea lor în registre externe, dar în mod implicit are o serie de dezavantaje:
- obligatoriu creează 3 imagini Docker - pentru Spark, PySpark și R;
- nu permite specificarea numelui imaginii.
De aceea, vom folosi o variantă modificată a acestui instrument, prezentată mai jos:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Prin intermediul acestuia, construim imaginea de bază Spark, care conține o sarcină de testare pentru calcularea numărului Pi folosind Spark (aici {docker-registry-url} - URL-ul registrului dvs. de imagini Docker, {repo} - numele depozitului din registru, care corespunde cu proiectul din OpenShift, {image-name} - numele imaginii (dacă se folosește o structură de triregistrate a imaginilor, de exemplu, ca în registrul de imagini integrat Red Hat OpenShift), {tag} - eticheta acestei versiuni a imaginii):
. /bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Ne autentificăm în clusterul OKD folosind instrumentul de linie de comandă (aici {OKD-API-URL} - URL-ul API-ului clusterului OKD):
oc login {OKD-API-URL}
Vom obține tokenul utilizatorului curent pentru autorizarea în Docker Registry:
oc whoami -t
Ne autentificăm în Docker Registry intern al clusterului OKD (ca parolă folosim tokenul obținut prin comanda anterioară):
docker login {docker-registry-url}
Încărcăm imaginea Docker construită în Docker Registry OKD:
. /bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Verificăm că imaginea construită este disponibilă în OKD. Pentru aceasta, deschidem în browser URL-ul cu lista imaginilor din proiectul corespunzător (aici {project} - numele proiectului din clusterul OpenShift, {OKD-WEBUI-URL} - URL-ul consolei web OpenShift) - https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Pentru a rula sarcinile, trebuie să fie creat un cont de serviciu cu privilegii pentru a lansa containere sub root (acest aspect va fi discutat ulterior):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Îndeplinim comanda spark-submit pentru a publica sarcina Spark în clusterul OKD, specificând contul de serviciu creat și imaginea Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Aici:
—name — numele sarcinii, care va contribui la formarea numelui containerelor Kubernetes;
—class — clasa fișierului executabil, apelată la începutul sarcinii;
—conf — parametrii de configurare Spark;
spark.executor.instances — numărul de executori Spark care vor fi rulați;
spark.kubernetes.authenticate.driver.serviceAccountName — numele contului de serviciu Kubernetes utilizat la rularea podurilor (pentru a defini contextul de securitate și capabilitățile în interacțiunea cu API-ul Kubernetes);
spark.kubernetes.namespace — spațiul de nume Kubernetes în care vor fi rulate podurile driver-ului și executorilor;
spark.submit.deployMode — metoda de rulare a Spark (pentru standardul spark-submit se folosește „cluster”, pentru Spark Operator și versiunile ulterioare „client”);
spark.kubernetes.container.image — imaginea Docker utilizată pentru a rula podurile;
spark.master — URL-ul API-ului Kubernetes (specificat extern pentru a facilita accesul din mașina locală);
local:// — calea către fișierul executabil Spark în interiorul imaginii Docker.
Accesăm proiectul OKD corespunzător și examinăm podurile create — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Pentru a simplifica procesul de dezvoltare, poate fi utilizat o altă opțiune în care se creează o imagine de bază comună Spark, utilizată de toate sarcinile pentru rulare, iar instantaneele fișierelor executabile sunt publicate într-un depozit extern (de exemplu, Hadoop) și sunt specifice la apelarea spark-submit sub formă de link. În acest caz, se pot rula diferite versiuni ale sarcinilor Spark fără a reconstruirea imaginilor Docker, folosind pentru publicarea imaginilor, de exemplu, WebHDFS. Trimitem o solicitare pentru crearea fișierului (aici {host} — gazda serviciului WebHDFS, {port} — portul serviciului WebHDFS, {path-to-file-on-hdfs} — calea dorită către fișier pe HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE"
În acest caz, se va obține un răspuns de tip (aici {location} — este URL-ul care trebuie utilizat pentru încărcarea fișierului):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Încărcăm fișierul executabil Spark în HDFS (aici {path-to-local-file} — calea către fișierul executabil Spark pe gazda curentă):
curl -i -X PUT -T {path-to-local-file} "{location}"
După aceea, putem efectua un spark-submit utilizând fișierul Spark încărcat pe HDFS (aici {class-name} — numele clasei care trebuie să fie executată pentru îndeplinirea sarcinii):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Este important de menționat că pentru accesul la HDFS și pentru a asigura buna funcționare a sarcinii, poate fi necesară modificarea Dockerfile-ului și a scriptului entrypoint.sh — adăugând în Dockerfile o directivă pentru copierea bibliotecilor dependente în directorul /opt/spark/jars și includerea fișierului de configurare HDFS în SPARK_CLASSPATH în entrypoint.sh.
A doua utilizare este Apache Livy
Apoi, când sarcina este dezvoltată și este necesară testarea rezultatului obținut, apare întrebarea cum să o pornim în cadrul procesului CI/CD și cum să urmărim statusul executării acesteia. Desigur, putem să o lansăm și printr-un apel local spark-submit, dar asta complică infrastructura CI/CD deoarece necesită instalarea și configurarea Spark pe agenții/runnerii serverului CI și configurarea accesului la API-ul Kubernetes. Pentru acest caz, implementarea țintă aleasă a fost utilizarea Apache Livy ca API REST pentru lansarea sarcinilor Spark, găzuit în interiorul clusterei Kubernetes. Cu ajutorul său, putem lansa sarcini Spark pe clustera Kubernetes folosind cereri cURL obișnuite, ceea ce este ușor realizabil pe baza oricărei soluții CI, iar găzduirea sa în interiorul clusterei Kubernetes rezolvă problema autentificării în interacțiunea cu API-ul Kubernetes.
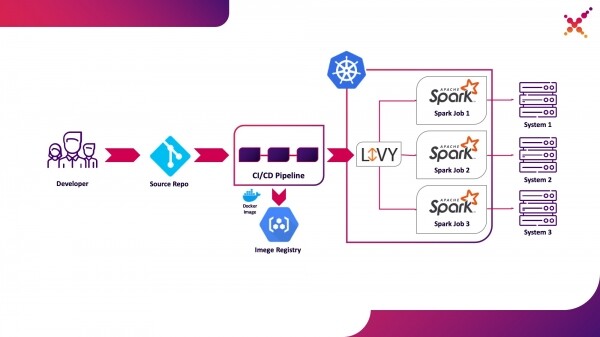
Să-l evidențiem ca a doua utilizare — lansarea sarcinilor Spark în cadrul procesului CI/CD pe clustera Kubernetes în mediul de testare.
Puțin despre Apache Livy — funcționează ca un server HTTP, oferind o interfață web și un API RESTful, permițând executarea de la distanță a spark-submit-ului, transmițând parametrii necesari. Tradițional, a fost furnizat cu distribuția HDP, dar poate fi de asemenea desfășurat în OKD sau orice altă instalare Kubernetes cu ajutorul manifestului corespunzător și a unui set de imagini Docker, de exemplu, acesta — . Pentru cazul nostru, a fost construită o imagine Docker similară, incluzând Spark versiunea 2.4.5 din următorul Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Imaginea creată poate fi construită și încărcată în depozitul Docker pe care îl aveți, de exemplu, în depozitul intern OKD. Pentru desfășurarea sa se folosește următorul manifest ({registry-url} — URL-ul registrului de imagini Docker, {image-name} — numele imaginii Docker, {tag} — eticheta imaginii Docker, {livy-url} — URL-ul dorit prin care va fi disponibil serverul Livy; manifestul „Route” se aplică în cazul în care se utilizează distribuția Kubernetes Red Hat OpenShift, în caz contrar se folosește manifestul corespunzător Ingress sau Service de tip NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
După aplicarea sa și lansarea cu succes a podului, interfața grafică Livy este disponibilă la linkul: http://{livy-url}/ui. Folosind Livy, putem publica sarcina noastră Spark, utilizând o cerere REST, de exemplu, din Postman. Un exemplu de colecție cu cereri este prezentat mai jos (în array-ul „args” pot fi transmise argumente de configurare cu variabilele necesare pentru funcționarea sarcinii lansate):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Trimite job cu jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Trimite job fără jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Vom efectua prima cerere din colecție, vom accesa interfața OKD și vom verifica dacă sarcina a fost pornită cu succes — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. În același timp, în interfața Livy (http://{livy-url}/ui) va apărea o sesiune, în cadrul căreia prin API Livy sau interfața grafică se pot urmări progresele execuției sarcinii și se pot consulta jurnalele sesiunii.
Acum să prezentăm mecanismul de funcționare al Livy. Pentru aceasta, vom studia jurnalele containerului Livy din interiorul podului cu serverul Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Din acestea se vede că, la apelarea API-ului REST Livy, în containerul denumit «livy» se execută spark-submit, similar cu ceea ce am folosit anterior (aici {livy-pod-name} este numele podului creat cu serverul Livy). În colecție este prezentată, de asemenea, a doua cerere, care permite lansarea sarcinilor cu localizarea de la distanță a fișierului executabil Spark cu ajutorul serverului Livy.
A treia variantă de utilizare — Spark Operator
Acum că sarcina a fost testată, se pune problema lansării sale regulate. Metoda nativă pentru lansarea regulată a sarcinilor în clusterul Kubernetes este entitatea CronJob, și se poate folosi, însă în prezent, utilizarea operatorilor pentru gestionarea aplicațiilor în Kubernetes are o popularitate mai mare, iar pentru Spark există un operator suficient de matur, care este folosit inclusiv în soluții la nivel Enterprise (de exemplu, Lightbend FastData Platform). Recomandăm utilizarea acestuia — versiunea stabilă actuală a Spark (2.4.5) are capacități de configurare a lansării sarcinilor Spark în Kubernetes destul de limitate, în timp ce în următoarea versiune majoră (3.0.0) este anunțată suport complet pentru Kubernetes, dar data lansării rămâne necunoscută. Spark Operator compensează această neajuns, adăugând parametrii importanți de configurare (de exemplu, montarea ConfigMap-ului cu configurația de acces la Hadoop în podurile Spark) și posibilitatea de a lansa sarcina regulat conform unui program.
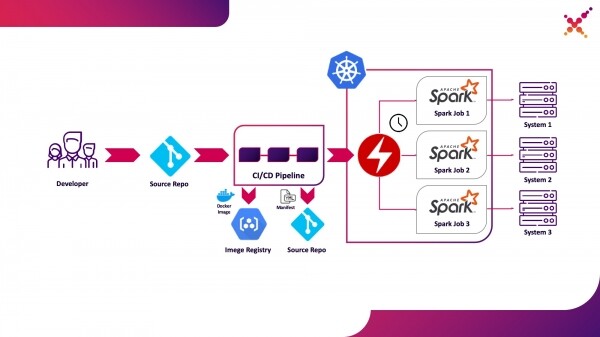
Să-l evidențiem ca a treia variantă de utilizare — lansarea regulată a sarcinilor Spark în clusterul Kubernetes în mediul de producție.
Spark Operator are sursă deschisă și este dezvoltat în cadrul Google Cloud Platform — . Instalarea sa poate fi realizată în 3 moduri:
- Prin instalarea Lightbend FastData Platform/Cloudflow;
- Folosind Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Utilizarea manifestelor din depozitul oficial (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Este important de menționat următoarele - Cloudflow include un operator cu versiunea API v1beta1. Dacă se folosește acest tip de instalare, descrierile manifestelor aplicațiilor Spark trebuie să se bazeze pe exemplele din tag-urile Git cu versiunea API corespunzătoare, de exemplu, „v1beta1-0.9.0-2.4.0”. Versiunea operatorului poate fi consultată în descrierea CRD-ului, care face parte din operator, în dicționarul „versions”:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Dacă operatorul este instalat corect, în proiectul corespunzător va apărea un pod activ cu operatorul Spark (de exemplu, cloudflow-fdp-sparkoperator în spațiul Cloudflow pentru instalarea Cloudflow) și va apărea un tip corespunzător de resurse Kubernetes cu numele „sparkapplications”. Aplicațiile Spark existente pot fi explorate cu următoarea comandă:
oc get sparkapplications -n {project}
Pentru a rula sarcini cu ajutorul Spark Operator sunt necesare 3 lucruri:
- crearea unei imagini Docker, care include toate bibliotecile necesare, precum și fișierele de configurare și executabile. În scenariul dorit, aceasta este imaginea creată în etapa CI/CD și testată pe un cluster de testare;
- publicarea imaginii Docker într-un registru accesibil din clusterul Kubernetes;
- formarea unui manifest cu tipul „SparkApplication” și descrierea sarcinii care trebuie executată. Exemple de manifeste sunt disponibile în depozitul oficial (de exemplu, ). Este important de remarcat aspectele esențiale referitoare la manifest:
- în dicționarul „apiVersion” trebuie să fie specificată versiunea API, corespunzătoare versiunii operatorului;
- în dicționarul „metadata.namespace” trebuie să fie specificat spațiul de nume în care va fi rulat aplicația;
- în dicționarul „spec.image” trebuie să fie specificată adresa imaginii Docker create în registrul accesibil;
- în dicționarul „spec.mainClass” trebuie să fie specificată clasa sarcinii Spark care trebuie executată la lansarea procesului;
- în dicționarul „spec.mainApplicationFile” trebuie să fie specificat calea către fișierul jar executabil;
- în dicționarul „spec.sparkVersion” trebuie să fie specificată versiunea Spark utilizată;
- în dicționarul „spec.driver.serviceAccount” trebuie să fie specificat contul de serviciu din cadrul spațiului de nume Kubernetes corespunzător, care va fi utilizat pentru a rula aplicația;
- în dicționarul „spec.executor” trebuie să fie specificat numărul de resurse alocate aplicației;
- În dicționarul „spec.volumeMounts”, trebuie specificat directorul local în care vor fi create fișierele locale ale sarcinii Spark.
Exemplu de formare a manifestului (aici {spark-service-account} reprezintă contul de serviciu din cadrul clusterului Kubernetes pentru executarea sarcinilor Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:////opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
În acest manifest, este specificat un cont de serviciu pentru care trebuie create legăturile de rol necesare înainte de publicarea manifestului, acordând drepturile necesare pentru interacțiunea aplicației Spark cu API-ul Kubernetes (dacă este nevoie). În cazul nostru, aplicația are nevoie de permisiuni pentru a crea Pod-uri. Să creăm legătura de rol necesară:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
De asemenea, merită menționat că în specificația acestui manifest poate fi specificat parametrul „hadoopConfigMap”, care permite indicarea unui ConfigMap cu configurația Hadoop fără necesitatea de a plasa în prealabil fișierul corespunzător în imaginea Docker. De asemenea, este potrivit pentru executarea regulată a sarcinilor — prin parametrul „schedule” se poate specifica un program de execuție pentru această sarcină.
După aceea, salvăm manifestul nostru în fișierul spark-pi.yaml și îl aplicăm pe clusterul nostru Kubernetes:
oc apply -f spark-pi.yaml
Astfel, se va crea un obiect de tip „sparkapplications”:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
În acest proces, va fi creat un pod cu aplicația, al cărei statut va fi afișat în „sparkapplications” creat. Poate fi vizualizat cu următoarea comandă:
oc get sparkapplications spark-pi -o yaml -n {project}
La finalizarea sarcinii, POD-ul va trece în starea „Completed”, care se va actualiza și în „sparkapplications”. Jurnalele aplicației pot fi vizualizate în browser sau folosind următoarea comandă (aici {sparkapplications-pod-name} este numele pod-ului sarcinii rulate):
oc logs {sparkapplications-pod-name} -n {project}
De asemenea, gestionarea sarcinilor Spark poate fi efectuată cu ajutorul utilitarului specializat sparkctl. Pentru instalarea acestuia, clonăm repositoarele cu codul sursă, instalăm Go și compilăm acest utilitar:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Să examinăm lista sarcinilor Spark în execuție:
sparkctl list -n {project}
Să creăm o descriere pentru sarcina Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Să lansăm sarcina descrisă utilizând sparkctl:
sparkctl create spark-app.yaml -n {project}
Să examinăm lista sarcinilor Spark în execuție:
sparkctl list -n {project}
Să examinăm lista evenimentelor sarcinii Spark în execuție:
sparkctl event spark-pi -n {project} -f
Să verificăm statusul sarcinii Spark în execuție:
sparkctl status spark-pi -n {project}
În concluzie, dorim să analizăm dezavantajele identificate ale utilizării versiunii stabile curente a Spark (2.4.5) în Kubernetes:
- Primul și, probabil, principalul dezavantaj este absența localizării datelor. În ciuda tuturor dezavantajelor, YARN a prezentat și avantaje, de exemplu, principiul livrării codului către date (nu datele către cod). Datorită acestui principiu, sarcinile Spark erau executate pe noduri unde se aflau datele implicate în calcule, reducând semnificativ timpul necesar livrării datelor prin rețea. Atunci când folosim Kubernetes, ne confruntăm cu necesitatea de a transporta datele implicate într-o sarcină prin rețea. În cazul în care acestea sunt suficient de mari, timpul de execuție al sarcinii poate crește considerabil, iar de asemenea, este necesar un volum mare de spațiu pe disc alocat instanțelor sarcinilor Spark pentru stocarea temporară a acestora. Acest dezavantaj poate fi redus prin utilizarea unor instrumente soft specializate, care asigură localizarea datelor în Kubernetes (de exemplu, Alluxio), dar aceasta înseamnă de fapt necesitatea de a păstra o copie întreagă a datelor pe nodurile clusterului Kubernetes.
- Al doilea dezavantaj important este securitatea. Implicit, funcțiile legate de asigurarea securității pentru executarea sarcinilor Spark sunt dezactivate, iar opțiunea de utilizare a Kerberos în documentația oficială nu este acoperită (deși parametrii corespunzători au apărut în versiunea 3.0.0, ceea ce va necesita muncă suplimentară), iar în documentația de securitate pentru utilizarea Spark (https://spark.apache.org/docs/2.4.5/security.html) sunt enumerate doar YARN, Mesos și Standalone Cluster ca registre de chei. În plus, utilizatorul sub care sunt executate sarcinile Spark nu poate fi specificat direct — stabilim doar un cont de serviciu sub care va funcționa pod-ul, iar utilizatorul este ales în funcție de politicile de securitate configurate. În acest context, fie se folosește utilizatorul root, ceea ce nu este sigur într-un mediu de producție, fie un utilizator cu un UID aleatoriu, ceea ce este inconfortabil în distribuția drepturilor de acces la date (rezolvabil prin crearea PodSecurityPolicies și legarea lor de conturile de serviciu corespunzătoare). În prezent, este rezolvat fie prin includerea tuturor fișierelor necesare direct în imaginea Docker, fie prin modificarea scriptului de pornire Spark pentru a utiliza mecanismul de stocare și obținere a secretelor, acceptat în organizația dumneavoastră.
- Executarea sarcinilor Spark cu Kubernetes se află încă în mod experimental, iar modificări semnificative în artefactele utilizate (fișiere de configurare, imagini Docker de bază și scripturi de inițializare) sunt posibile în viitor. Într-adevăr, în pregătirea materialului au fost testate versiunile 2.3.0 și 2.4.5, iar comportamentul a fost semnificativ diferit.
Așteptăm actualizări - recent a fost lansată o versiune nouă de Spark (3.0.0), care a adus modificări notabile în funcționarea Spark pe Kubernetes, păstrând totuși statutul experimental al suportului pentru acest manager de resurse. Este posibil ca următoarele actualizări să permită în sfârșit recomandarea de a renunța la YARN și de a rula sarcini Spark pe Kubernetes, fără a te teme pentru securitatea sistemului tău și fără a fi necesară ajustarea manuală a componentelor funcționale.
Fin.
Sursa: habr.com
