

În V-am vorbit despre noile funcții din update-ul 4 lansat în ianuarie pentru Veeam Backup & Replication 9.5 (VBR), unde am ales deliberat să nu menționăm backup-urile pe bandă magnetică. Discuția despre acest domeniu merită un articol separat, deoarece au fost realmente multe noutăți.
– Oameni buni din QA, veți scrie un articol?
– De ce nu!
Discurile magnetice în secolul XXI
Stocarea datelor pe benzi magnetice (cartridgi, „benzi”, așa cum le numim noi în R&D) nu se limitează la computerul învechit ZX-Spectrum, un joc pentru care putea fi încărcat în memoria RAM de 48 kb de pe în câteva minute. Într-un sfert de veac, viteza și capacitatea benzilor au crescut cu 6-7 ordine de mărime. Aceasta nu este o comparație complet corectă, iar standard nu reușește să țină pasul. Cu toate acestea, tehnologiile moderne permit înregistrarea a 12 terabiți de date pe o bandă de un kilometru (până la 30 de terabiți în modul de compresie), astfel că un dispozitiv de 160 de dolari depășește concurența în ceea ce privește costul stocării pe termen lung a unui volum mare de date, chiar și cu investițiile în echipamentele de scriere/lectură. Datele pe astfel de benzi sunt păstrate în mod fiabil timp de 15-30 de ani.
Voi aborda sub un alt unghi. În ultima vreme, au atins un nou nivel. Aceștia pot aștepta momentul potrivit în infrastructura unei companii mari săptămâni și luni, iar odată cu apariția unei noi vulnerabilități zero-day – să distrugă (nu fără ajutor uman, pentru că sunt implicați bani mari) nu doar toate datele, ci și toate backup-urile, până la care s-ar putea ajunge. Iată , când o companie a fost nevoită să plătească răscumpărătorilor. Așa-numitele air gap, adică backup-urile fizic izolate de infrastructură, au devenit, de fapt, singura salvare fiabilă împotriva unor astfel de situații. Banda magnetică este una dintre soluțiile care nu devin învechite.
Dar o simplă specificație și noutăți tehnologice de la principalii producători (IBM, HPE, Oracle, Dell) pentru protecția fiabilă a datelor nu sunt suficiente, este nevoie de un software bun. La noi în Veeam, există o întreagă echipă care se ocupă cu backup-urile pe bandă, aproximativ 10 persoane analizează zilnic, planifică, cercetează, dezvoltă și testează. Rezultatele acestei munci le-ați putut vedea în articolele anterioare (, ). Ce s-a realizat în ultimul an?
Ghid terminologic
Se pune alegerea între libertățile în relație cu limba maternă și termenii care complică citirea. Prefer prima variantă, așa că îmi cer scuze dinainte dacă unii termeni din lista de mai jos vor deranja pe cineva. Aici, de asemenea, voi reaminti pe scurt ce înseamnă fiecare termen.
Coryfeilor VBR această parte poate fi sărităJob – job – sarcina de salvare de rezervă. De fapt, tot VBR-ul se bazează pe joburi. Pe lângă backup și replicare, aceasta poate fi și copierea pe bandă magnetică (backup to tape job, job pe bandă). Voi menționa că restaurarea dintr-o copie de rezervă (restore) este tot un job, dar în acest articol acest cuvânt se va referi în mod special la backup.
Storage – storage – denumire istorică. Acestea sunt fișiere în repository (repository – depozit), care conțin copii de rezervă – complet și incrementale. Într-un storage poate fi atât o mașină virtuală, cât și mai multe.
Chain – chain – o secvență de storageuri interconectate. Pentru a restaura datele dintr-un storage incremental n, sunt necesare toate cele anterioare de la (n-1) la 1 și storage-ul complet la care face referire primul incremental.
Source, Target – source, target. Source – entitatea originală pe care o procesează jobul. În cazul backup-urilor/replicărilor, aceasta este, de regulă, o mașină virtuală în hypervisor. În cazul jobului pe bandă, source-ul este însăși jobul de backup (sau fișierele în cazul jobului file to tape). Target pentru jobul de backup este repoziția în care sunt stocate backup-urile. Pentru jobul pe bandă, aceasta este media pool.
Media pool – – un grup de suport informațional, în cazul nostru – casete. Un container logic, creat de utilizator și conținând casete din una sau mai multe biblioteci. Așadar, jobul pe bandă are întotdeauna un media pool ca target, adică datele nu sunt scrise pe o anumită casetă sau pe orice casetă din bibliotecă, ci pe un set specific de acestea. Media pool-ul are setări de timp pentru stocarea datelor, după care caseta poate fi rescrisă. Utilizatorul poate crea atât GFS-pools.
Media set – – set de casete în pool-ul media, pe care se scriu continuu backup-uri/fail-uri. Pentru pool-urile GFS, seturile media sunt legate și de interval (de exemplu, anual – yearly), casetele se rotesc doar în interiorul propriului interval.
– elemente ale bibliotecii de benzi. Unitatea citește și răsfoiește caseta, schimbătorul – este robotul care mută casetele între sloturile de stocare, sloturile de descărcare și unitate. Există și unități autonome (standalone – de sine stătător), rolul schimbătorului este îndeplinit de o persoană. Pentru unitate, este obligatoriu ca driver-ul producătorului să fie corect instalat pe mașina Windows la care este conectată biblioteca; cu schimbătorul putem lucra și fără drivere, pe SCSI nativ.
Închiriere pe bandă. Providerul este protejat – clienții sunt protejați
Așadar, hai să aruncăm cărțile pe masă. Cea mai mare caracteristică a actualizării noastre, destinat , care folosesc VBR în infrastructura lor. Dezvoltarea a început acum două ani. În curând ne-am dat seama că nu vom reuși să facem față unei astfel de sarcini serioase înainte de următoarea lansare, am luat o pauză scurtă și, în cele din urmă, am lansat caracteristica în 9.5 Update 4.
Pe scurt, acum providerii au posibilitatea de a copia backup-urile clienților lor pe benzi folosind jobul de bandă în pool-ul GFS. Acest lucru le oferă providerilor – iar aceștia sunt oameni foarte importanți pentru noi și pentru departamentul nostru comercial – două oportunități:
- să protejeze clienții lor (închiriere, tenant – chiriaș) împotriva pierderii de date din cauza ștergerii accidentale sau problemelor infrastructurale ("inundație în server room");
- să ofere chiriașilor un serviciu suplimentar de restaurare a datelor dintr-un backup vechi, care a fost șters de mult din depozitul cloud conform politicii de păstrare a datelor, dar care a rămas pe benzi.
Din perspectiva marketingului, funcționalitatea este foarte "atractivă", iar din perspectiva noastră – nu mai puțin complicată în implementare.
Dezvoltare
Principala problemă apărută – criptarea datelor. Cele mai multe backup-uri cloud sunt criptate, statisticile arată că ⅔ din numărul total. Această cifră a fost o surpriză pentru noi, am presupus că practic totul este criptat, dar nu – mulți clienți par să aibă încredere totală în providerii lor.
Paradigma este simplă: furnizorul nu ar trebui să fie capabil să decripteze datele chiriașilor săi. În cadrul acestei noi funcționalități, este necesar ca furnizorul să deschidă stocările cu backup-uri. Acest lucru este necesar pentru a muta blocurile de date, de exemplu, pentru a crea . Cel mai important, acest lucru trebuie făcut independent de chiriaș, atunci când cheile necesare nu sunt transmise furnizorului în timpul executării lucrării.
Soluția acestei probleme, implicată și într-o altă caracteristică importantă a suplimentului lansat – – constă în adăugarea unei chei suplimentare de criptare. Cheia de arhivare (Archive key) este stocată în baza de date a furnizorului într-o formă criptată. Printr-un sistem ingenios, furnizorul poate deschide stocarea, muta și recripta blocurile de date între stocări (deoarece fiecare are propria cheie), dar nu poate decripta datele în sine.
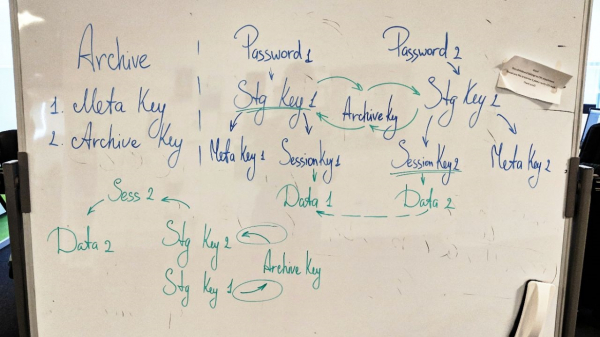
Sistem ingenios (varianta de lucru)
Adaug că toți inginerii din R&D adoră criptarea din produsul nostru, cu toate că nimeni nu cunoaște în detaliu cum funcționează. (Aici a fost și o glumă „și de ce funcționează de fapt”, dar editorii nu au lăsat-o să treacă.)
Testare
Pentru această funcționalitate au fost raportate sute de bug-uri. Cele mai dificile zone sunt criptarea, interfața cu utilizatorul și problemele la restaurare.
Din punct de vedere al testării, dificultatea a venit din variabilitatea mare, „combinatorica” tipurilor și tipurilor de lucrări chiriaș și de stocare - mă refer la atât sursa, cât și obiectivul în procesul de restaurare a backup-urilor în infrastructură. Totul se îmbină cu logica în cadrul (inclusiv noul – paralelismul și seturile media zilnice, despre care vom vorbi mai jos), și, în general, pe specificațiile neobișnuite pentru tipurile cloud. Nu uitați să adăugați generos criptarea. Dacă continuăm analogia, ne-am săturat bine de acest fel de mâncare – dar l-am degustat din toate colțurile.
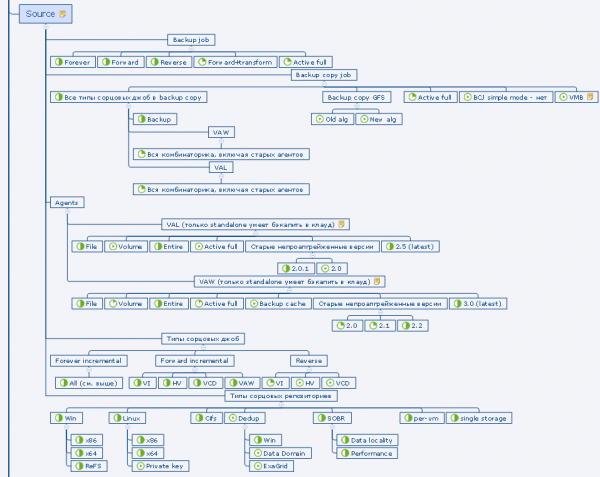
Fragmentul planului de testare
Ca rezultat
O descriere detaliată poate fi găsită în (momentan în limba engleză): , . Mă voi opri asupra punctelor principale.
Backup
Furnizorul adaugă chiriașii în jobul de tip GFS cu pool-ul ca obiectiv. Cu o licență cloud disponibilă, în a doua etapă a wizard-ului este disponibilă opțiunea TenantsEste posibil să adăugați toți chiriașii deodată sau individual, iar de asemenea, să selectați doar o anumită cotă (dar nu o subcotă) a unui chiriaș distinct. Nu este permis să se amestece în aceeași muncă backup-urile chiriașilor cu cele locale obișnuite.
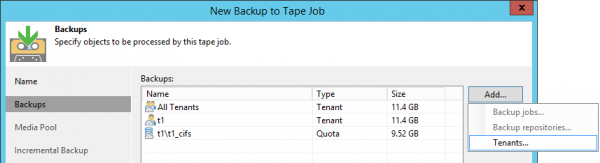
Celelalte setări sunt aproape complet identice cu o muncă obișnuită în GFS pool.
Restaurarea datelor este posibilă atât de către furnizor, cât și de către chiriașul în sine.
Restaurare de către furnizor
Se realizează printr-un nou wizard. Aici se poate merge până la o muncă separată, restaurând întreaga lanț care a fost în depozit într-o anumită zi.
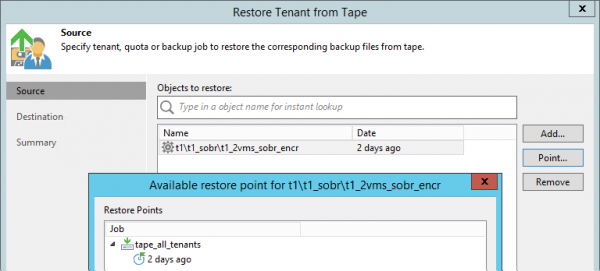
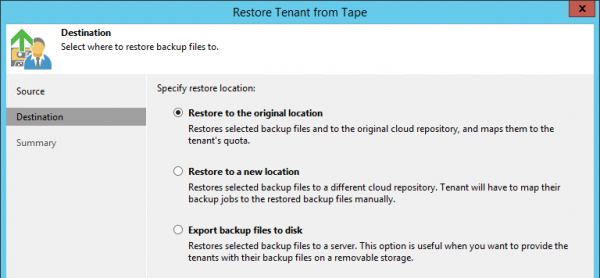
Există trei opțiuni de restaurare:
- În locația inițială. În acest caz, backup-ul original, dacă există, este șters; muncile chiriașului sunt automat reconfigurate pe lanțul restaurat. Se presupune că o astfel de restaurare va fi complet invizibilă pentru client, fiind decuplată de cloud repository pentru o scurtă perioadă de timp.
- Într-o nouă cotă/depozit. Furnizorul poate, de exemplu, să creeze un cont temporar separat pentru acest scop, pe care ulterior îl va șterge. Backup-ul apare în infrastructura chiriașului după sincronizarea cu baza furnizorului.
- Direct pe disk-ul serverului Linux sau Windows, înregistrat în infrastructura furnizorului. Ulterior, acest lanț poate fi copiat pe un stick USB și trimis chiriașului.
Restaurare de către chiriaș
Această opțiune presupune ca clientul să aibă propria infrastructură de bandă și un volum mare de date pentru restaurare. Banda cu backup-urile înregistrate poate fi trimisă fizic clientului printr-o firmă de livrare, acesta cataloghează banda pe echipamentele sale, decriptează benzile și backup-urile și lucrează cu copiile de rezervă ca și cum le-ar fi înregistrat el însuși pe bandă. Această metodă este o soluție ingenioasă pentru a evita descărcarea terabiților prin WAN.
Îmbunătățiri semnificative în GFS pool
-pools media au apărut în VBR acum doi ani, în versiunea 9.5. În actualizarea recentă, datorită introducerii funcției Tenant to tape, precum și la cererea utilizatorilor, am îmbunătățit semnificativ această funcționalitate.
Seturi media zilnice
A apărut un nou set zilnic (daily) set de medii. Acum în pool-ul GFS se pot stoca backupuri pentru fiecare zi, și nu doar complete, ci și incrementale. Acestea din urmă ocupă considerabil mai puțin spațiu și au fost realizate în scopul economisirii benzii. Se consideră că aceste casete sunt rotite constant în bibliotecă, fără a fi transportate la stocare externă. În acest context, pentru restaurarea dintr-un punct incremental, vor fi necesare casete dintr-unul dintre seturile mai vechi de medii (săptămânal, lunar, trimestrial sau anual). Activarea setului zilnic de medii nu poate fi realizată fără activarea celui săptămânal, pentru a se asigura, în cele mai multe cazuri, că pentru restaurarea dintr-o copie incrementală sunt necesare tocmai casetele săptămânale. Acestea sunt fie întotdeauna în bibliotecă, fie păstrate într-un depozit nu foarte îndepărtat.
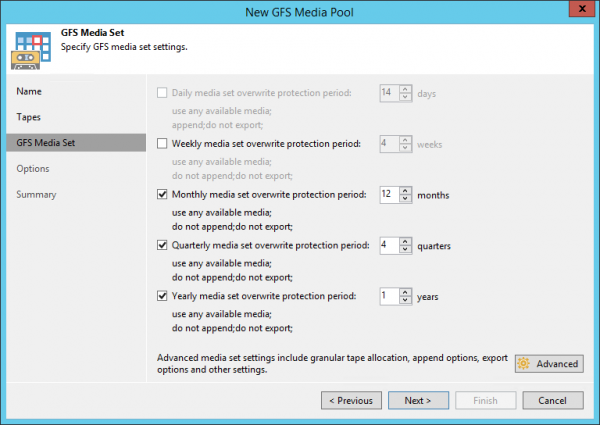
Logica de funcționare a task-urilor tape în pool-ul GFS , scriitorii tehnici nu vor nega. Dacă ar fi să rezumăm, să omitem detaliile, atunci în setul săptămânal și în cele mai vechi se copiază doar backupuri complete (inclusiv backupuri virtuale complete), câte unul pentru fiecare dată, iar în cel zilnic – toate backupurile aflate în repository pentru ziua curentă, având în vedere că jobul de backup poate fi pornit mai des decât o dată pe zi.
Paralelism, timp de start și așteptare în pool-urile GFS
Acum, în pool-urile media GFS, este posibilă scrierea paralelă a mai multor fire sau joburi pe mai multe unități ale bibliotecii (anterior era posibil doar în cele obișnuite). Aceasta se activează la pasul Opțiuni pool-ului de medii.
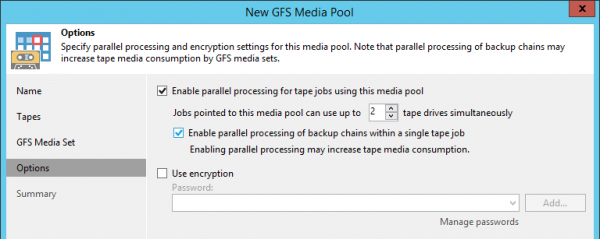
O clarificare importantă: același fișier este întotdeauna scris într-un singur fir, așa că în cazul mai multor mașini virtuale mari, se recomandă activarea , pentru ca backupul să fie format din mai multe fire.
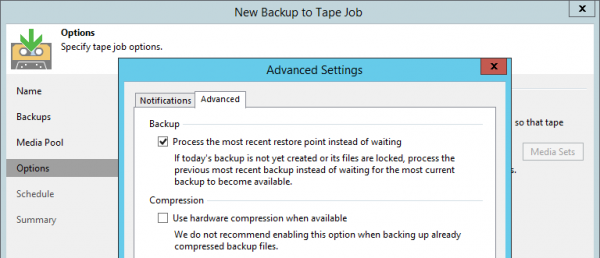
Pe deasupra, a devenit posibil să alegi timpul de start al jobului GFS. Mulți utilizatori nu apreciau pornirea la miezul nopții și așteptarea ulterioară de aproape o zi până la finalizarea jobului sursă. Acum, acest timp poate fi setat, de exemplu, la o seară târzie, când există deja ceva de copiat pe bandă. Mai mult, la solicitările utilizatorilor, am inclus în setările avansate o opțiune care anterior putea fi activată doar printr-o cheie de registru. Este suficient să alegi Procesează cel mai recent punct de restaurare în loc să aștepți – și pe casetă se copiază ceea ce este în depozit la momentul inițierii jobului de bandă (punctul de ieri, de exemplu), fără a exista așteptări.
Lucru îmbunătățit cu mai multe biblioteci.
Va fi discutată situația în care la un singur media pool au fost adăugate mai multe biblioteci. Am susținut acest lucru și anterior, dar ocazional primeam plângeri din partea clienților despre un comportament nu tocmai previzibil.
A fost
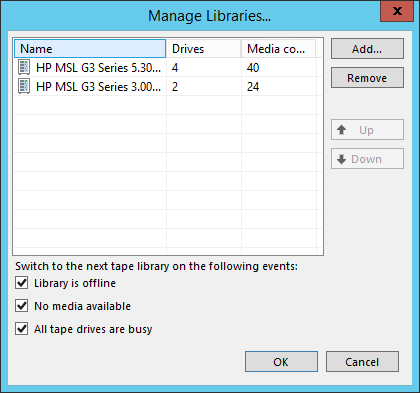
De exemplu, a fost inițiat jobul de bandă, care a ocupat două unități în prima bibliotecă, dar setările de paralelism permit utilizarea simultană a 4 unități. Ar trebui ca acest job să treacă la a doua bibliotecă a media pool-ului și să o utilizeze și pe ea, sau ar fi o risipă de resurse?
Un alt caz. A fost aleasă opțiunea de comutare în condiția „nu există benzi disponibile”, în prima bibliotecă există doar o singură bandă, dar pot fi plasate acolo toate datele. Totuși, setările permit scrierea simultan pe două benzi. Ar trebui să implicăm a doua bibliotecă în acest caz?
Am decis să punem ordine în acest domeniu, oferind posibilitatea de a configura comportamentul în mod explicit.
A devenit
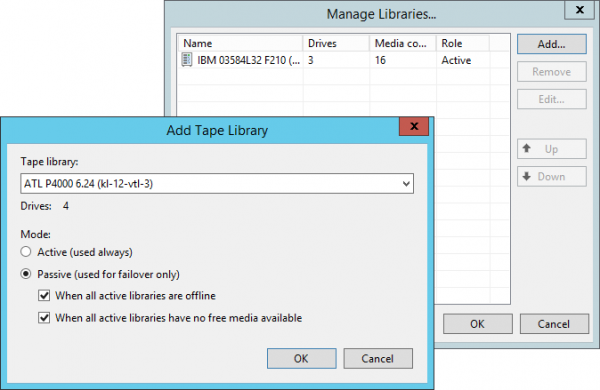
au primit roluri – activ și pasiv. Iar media pool-ului în sine i-au fost atribuite două moduri: rezistent la erori sau failover (schimbare la eroare) și scriere paralelă (paralelism). Acum, în funcție de cerințe, se poate configura media pool-ul în mod diferit.
- Dacă aveți mai multe biblioteci pe același rang și trebuie să paralelizați scrierea în ele – activați modul de scriere paralelă, pentru aceasta trebuie să atribuiți roluri active tuturor bibliotecilor. În acest caz, benzi și unități noi vor fi utilizate imediat, de îndată ce apare o necesitate, indiferent de biblioteca în care se află. Totuși, există o prioritate – mai întâi vom încerca să găsim resurse în biblioteca situată mai sus pe listă.
- Dacă există o bibliotecă principală și o unitate veche sau un drive standalone ca rezervă, activați modul failover, plasând biblioteca principală în partea de sus a listei și alegând rolul pasiv pentru dispozitivele de rezervă. Comutarea pe un astfel de dispozitiv se va face doar atunci când este cu adevărat necesar, astfel încât jobul să poată funcționa în orice fel. Această situație va fi considerată neobișnuită, pentru care va fi trimis un notificare pe email.
Există o situație mai complexă pe care momentan nu o susținem – mai multe biblioteci active în prezența uneia pasive. Feedback-ul va arăta dacă există nevoie de astfel de configurații și dacă trebuie "îmbunătățită" funcționalitatea în viitor. Practica standard.
Suport WORM
WORM – Write Once Read Many – casete care nu pot fi șterse sau rescrise , se pot adăuga doar date. Utilizarea lor obligatorie este reglementată de regulile unor organizații, de exemplu, cele care lucrează în domeniul medical. Problema principală cu aceste casete era înainte că VBR la sau înregistra un titlu care ulterior nu putea fi șters și job-urile de tip tape cădeau cu eroare în cazul unei astfel de încercări.
În Update 9.5 4 a fost implementat suport complet pentru aceste casete. Au fost adăugate pool-uri de medii WORM, atât obișnuite cât și GFS, în care pot fi plasate doar casete de acest tip.
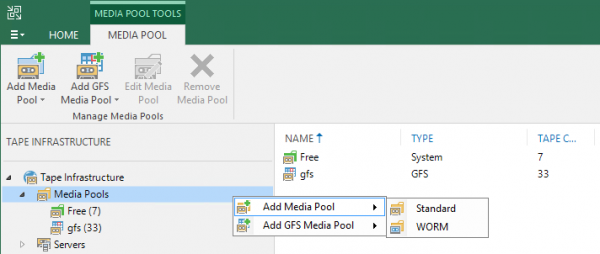
Noile casete au o pictogramă albastră, "înghețată". Din perspectiva utilizatorului, lucrul cu casetele WORM nu diferă de lucrul cu cele obișnuite.
„Wormozitatea” casetelor este determinată inițial de sufixul , dacă însă codul de bare este obișnuit sau ilizibil, informația este furnizată de driver la prima inserare a casetei. Plasarea casetelor WORM într-un pool de medii obișnuite și scrierea pe ele nu este posibilă. Din lucruri amuzante: au fost deja utilizatori care au lipit coduri de bare WORM pe casete obișnuite și s-au mirat de schimbările din infrastructura lor după actualizare.
Chipul casetei
În paralel cu implementarea casetelor nepermutable, am început să lucrăm cu . Atributele standard din chip înainte nu erau utilizate de noi, acum scriem și citim în unele dintre ele, dar nu le considerăm ca sursa principală de date. Principalul reper rămâne titlul casetei. Această decizie s-a dovedit a fi corectă: după o lună de la lansare, vedem cum "zoologicul" de hardware al utilizatorilor oferă surprize în privința lucrului cu chipul.
Backup NDMP-volume pe bandă
În încheiere – despre cea mai solicitată funcție în funcție de numărul de feedback-uri din acest Update. Backup-ul volumul NDMP pe casete a devenit disponibil. În infrastructura VBR, trebuie , după care în jobul de tape se vor putea selecta volume de pe acest host. Acestea se salvează pe benzi sub formă de fișiere cu un atribut special, pentru a le distinge de cele obișnuite la catalogare.
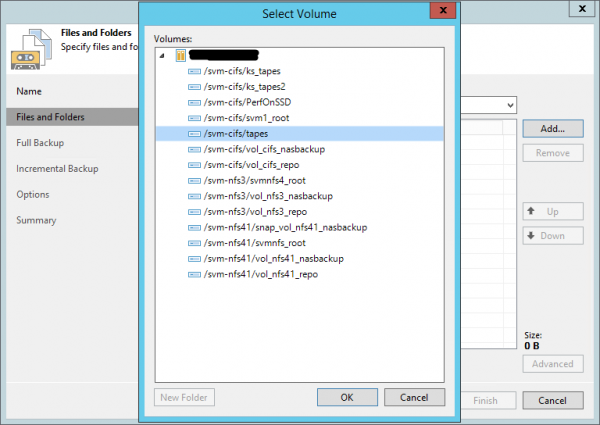
În prima implementare există anumite limitări: extensiile (extensions) nu sunt suportate, de asemenea, backup-ul și restore-ul sunt posibile doar pentru volumul complet, nu pentru fișiere individuale. Backup-ul se realizează prin (în cazul NetApp – ), aici există anumite particularități: numărul maxim de puncte incrementale este de 9, după care se forțează o copie de rezervă completă.
În concluzie
Acestea au fost doar cele mai importante noutăți în domeniul backup-ului pe bandă magnetică în VBR 9.5 Update 4. Alte modificări le voi enumera:
- posibilitatea de a stabili ordinea joburilor sursă și fișierelor în joburile de bandă;
- a fost adăugată rolul Tape Operator (utilizatorul poate face totul, cu excepția recuperării de pe bandă – pentru aceasta există Restore Operator);
- au fost adăugate măști complete include/exclude în jobul de bandă (în afara NDMP);
- s-a îmbunătățit recuperarea în jobul de bandă (folderul se restaurează cu fișierele care erau acolo în momentul backup-ului, nu cu toate cele care au fost vreodată – o funcție foarte solicitată, de altfel);
- a fost crescută viteza de restaurare a unui număr foarte mare de fișiere de pe benzi;
- s-a îmbunătățit algoritmul de selecție a următoarei benzi pentru scriere, având în vedere volumul de date scrise/lecturate pe parcursul vieții acesteia, alegând cea mai recentă;
- s-a îmbunătățit stabilitatea produsului.
Linkuri utile
Pentru diversitate, voi oferi câteva linkuri și către resurse în limba română:
- Și ne-am întors la locurile anterioare videoclipurile de prezentare „Cum funcționează” (deocamdată, în limba engleză) – le puteți viziona . Despre benzi se discută în slide-urile 95 – 102.
Sursa: habr.com
