

În 2010, compania avea 50 de servere și un model de rețea simplu: backend, frontend și firewall. Numărul serverelor a crescut, iar modelul s-a complicat: staging-uri, VLAN-uri izolate cu ACL, apoi VPN-uri cu VRF, VLAN-uri cu ACL pe L2, VRF cu ACL pe L3. Te simți confuz? De aici devine mai interesant.
Când numărul serverelor a ajuns la 16.000, a devenit imposibil să lucrezi fără lacrimi cu atât de multe segmente diverse. Așa că au venit cu o altă soluție. Au luat stiva Netfilter, au adăugat Consul ca sursă de date, rezultând un firewall rapid și distribuit. Acesta a înlocuit ACL-urile de pe routere și a fost utilizat ca firewall extern și intern. Pentru gestionarea dinamică a instrumentului, au dezvoltat un sistem BEFW, pe care l-au aplicat peste tot: de la gestionarea accesului utilizatorilor în rețeaua de producție până la izolarea segmentelor de rețea unele de altele.
Cum funcționează toate acestea și de ce ar trebui să acorzi atenție acestui sistem, va explica Ivan Agarakov () — șeful grupului de securitate infrastructurală din divizia Maintenance a centrului de dezvoltare din Minsk al companiei. Ivan este un fan al SELinux, îi place Perl, scrie cod. Ca șef al grupului ISC, lucrează regulat cu jurnalele, backup-urile și R&D, pentru a proteja Wargaming de hackeri și pentru a asigura funcționarea tuturor serverelor de jocuri din companie.
Context istoric
Înainte să explic cum am făcut asta, voi povesti cum am ajuns aici și de ce a fost nevoie de asta. Pentru a ilustra, să ne întoarcem cu 9 ani în urmă: 2010, când au apărut pentru prima dată World of Tanks. Compania Wargaming avea aproximativ 50 de servere.
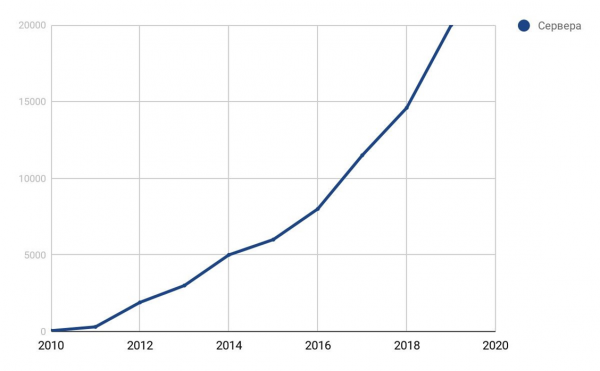
Graficul creșterii serverelor companiei.
Aveam un model de rețea. Pentru acea perioadă, acesta era optim.
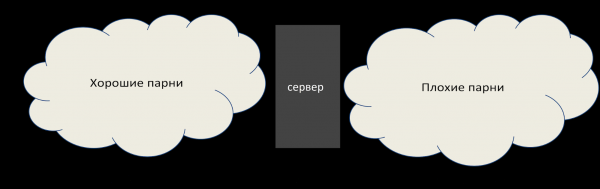
Modelul de rețea în 2010.
În frontend locuiesc răufăcătorii care vor să ne distrugă, dar există un firewall acolo. În backend nu există firewall, dar sunt 50 de servere, le știm pe toate. Totul funcționează bine.
În 4 ani, parcul de servere a crescut de 100 de ori, până la 5000. Au apărut primele rețele izolate — staging-uri: acestea nu pot accesa producția și acolo rulau frecvent lucruri care ar fi putut fi periculoase.
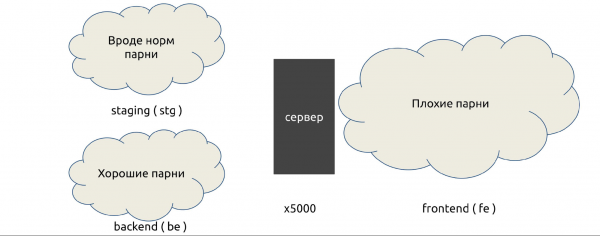
Modelul de rețea în 2014.
Din inerție am folosit aceleași echipamente, iar toată munca s-a desfășurat pe VLAN-uri izolate: pe VLAN-uri sunt scrise ACL-uri care permit sau interzic anumite conexiuni.
În 2016, numărul serverelor a ajuns la 8000. Wargaming a achiziționat alte studiouri, iar rețelele partenerilor s-au extins. Ele par a fi ale noastre, dar nu chiar: pentru parteneri, VLAN-ul adesea nu funcționa, fiind nevoie de VPN cu VRF; izolările s-au complicat. Mixul de izolări ACL a crescut.
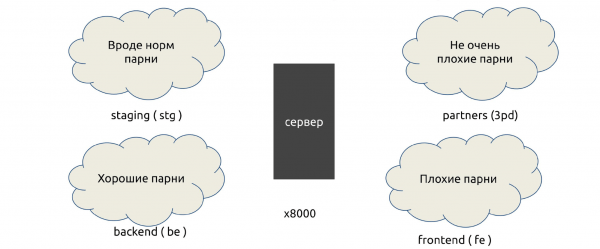
Modelul de rețea în 2016.
Până la începutul anului 2018, parcul de mașini a crescut la 16.000. Existau 6 segmente, iar celelalte nu au fost numărate, inclusiv cele închise, în care erau stocate datele financiare. Au apărut rețele de containere (Kubernetes), DevOps, rețele cloud conectate prin VPN, de exemplu, din IWS. Regulile erau foarte multe — era dureros.
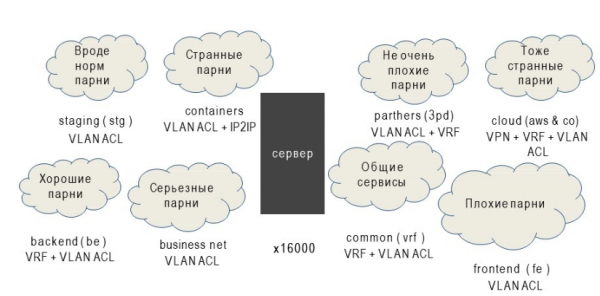
Modelul de rețea și metodele de izolare în 2018.
Pentru izolare, am folosit: VLAN cu ACL pe L2, VRF cu ACL pe L3, VPN și multe altele. Prea multe.
Probleme
Toată lumea folosește ACL și VLAN. Ceva este în neregulă? La această întrebare va răspunde Harold, ascunzând durerea.
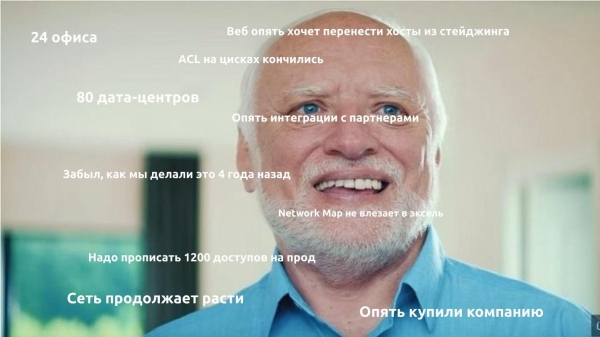
Au existat multe probleme, dar majore — cinci.
- Creșterea geometrică a prețului pentru noile reguli. Fiecare nouă regulă se adăuga mai greu decât cea anterioară, pentru că trebuia întâi văzut dacă nu exista deja o astfel de regulă.
- Nu există firewall în interiorul segmentelor. Segmentele s-au separatat cumva, iar în interior deja nu erau suficiente resurse.
- Regulile se aplicau cu întârziere. Cu mâna, un operator putea scrie o regulă locală în aproximativ o oră. Una globală dura câteva zile.
- Dificultăți în auditarea regulilor. Mai exact, nu putea fi realizat. Primele regulile au fost scrise încă din 2010, iar majoritatea autorilor lor nu mai lucrau în companie.
- Nivel scăzut de control asupra infrastructurii. Aceasta este principala problemă — nu știam bine ce se petrece cu adevărat.
Așa arăta inginerul de rețea în 2018 când auzea: „Mai avem nevoie de ceva ACL”.
Soluții
La începutul anului 2018 s-a decis să se facă ceva în această privință.
Prețul integrărilor crește constant. Punctul de plecare a fost că centrele de date mari au încetat să mai susțină VLAN-uri și ACL-uri izolate, deoarece memoria dispozitivelor s-a epuizat.
Soluția: am eliminat factorul uman și am automatizat cât mai mult accesul.
Noile reguli se aplică lent. Soluția: accelerarea aplicării regulilor, făcând-o distribuită și paralelă. Pentru aceasta, este nevoie de un sistem distribuit, astfel încât regulile să fie livrate singure, fără rsync sau SFTP pe o mie de sisteme.
Lipsa unui firewall în interiorul segmentelor. Firewall-ul din segmente a început să ne afecteze când în cadrul aceleași rețele au apărut diferite servicii. Soluția: utilizarea firewall-ului la nivel de gazdă — firewalls bazate pe gazdă. Practic, avem Linux peste tot, și peste tot există iptables, deci nu este o problemă.
Dificultăți în auditurile regulilor. Soluția: păstrarea tuturor regulilor într-un singur loc pentru revizuire și gestionare, astfel încât să putem audita totul.
Un nivel scăzut de control asupra infrastructurii. Soluția: realizarea unei inventarizări a tuturor serviciilor și acceselor între acestea.
Aceasta este mai mult un proces administrativ decât tehnic. Uneori avem 200-300 de versiuni noi pe săptămână, mai ales în timpul promoțiilor și sărbătorilor. Acestea sunt doar pentru o echipă din DevOps. Cu un astfel de număr de versiuni este imposibil să vedem și să înțelegem ce porturi, IP-uri, integrații sunt necesare. De aceea, am avut nevoie de manageri de servicii special instruiți, care să întrebe echipele: „Ce aveți și de ce ați ridicat acest serviciu?”
După tot ce am lansat, inginerul rețelistic din 2019 arăta deja așa.
Consul
Am decis că tot ce am găsit cu ajutorul managerilor de servicii va fi stocat în Consul și de acolo vom scrie regulile iptables.
Cum am decis să facem asta?
- Vom colecta toate serviciile, rețelele și utilizatorii.
- Vom crea reguli iptables pe baza acestora.
- Vom automatiza controlul.
- ….
- PROFIT.
Consul nu este un API distant, poate funcționa pe fiecare nod și scrie în iptables. Rămâne doar să ne gândim la mijloacele automate de control care vor curăța surplusul, iar cea mai mare parte a problemelor va fi rezolvată! Restul le vom rafina pe parcurs.
De ce Consul?
S-a dovedit a fi fiabil. Între 2014-15 l-am folosit ca backend pentru Vault, unde stocăm parolele.
Nu pierde date.. De-a lungul utilizării Consul nu a pierdut date niciodată în urma unei avarii. Aceasta este o mare calitate pentru sistemul de gestionare a firewall-ului.
Conexiunile P2P accelerează răspândirea modificărilor.. Cu P2P toate modificările vin rapid, nu trebuie să așteptăm ore întregi.
API REST convenabil. Am considerat și Apache ZooKeeper, dar nu are API REST, va trebui să implementăm soluții improvizate.
Funcționează atât ca un stocare de chei (KV), cât și ca un catalog (Descoperirea serviciilor).. Putem stoca serviciile, catalogul, centrele de date simultan. Acest lucru este convenabil nu doar pentru noi, ci și pentru echipele învecinate, deoarece construind un serviciu global, ne gândim la scalabilitate.
Scris în Go, care face parte din stiva Wargaming. Ne place această limbă, avem mulți dezvoltatori Go.
Un sistem ACL puternic. În Consul, prin intermediul ACL, se poate gestiona cine poate scrie și ce. Garantăm că regulile firewall-ului nu se vor intersecta cu nimic altceva și nu vom avea probleme în acest sens.
Dar Consul are și dezavantaje.
- Nu se scalează în cadrul centrului de date, dacă nu aveți versiunea business. Se scalează doar prin federare.
- Este foarte dependent de calitatea rețelei și de încărcarea serverelor. Consul nu va funcționa corespunzător pe un server aglomerat dacă există întârzieri în rețea, de exemplu, viteze instabile. Aceasta se datorează conexiunilor P2P și modelelor de distribuție a actualizărilor.
- Dificultăți cu monitorizarea disponibilității. În statusul Consul poate indica că totul este în regulă, dar de fapt a murit de mult.
Am rezolvat majoritatea acestor probleme în timpul utilizării Consul, de aceea l-am ales. Compania are planuri pentru un backend alternativ, dar am învățat să facem față problemelor și momentan trăim cu Consul.
Cum funcționează Consul
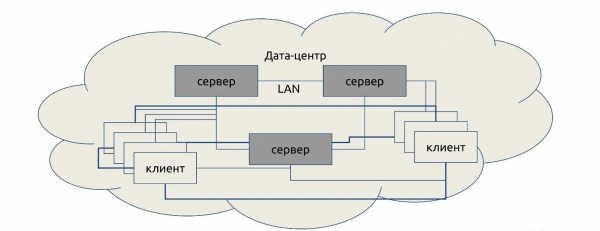
Într-un centru de date convențional vom instala servere — de la trei la cinci. Unul sau două servere nu sunt suficiente: nu vor putea organiza un consens și să decidă cine are dreptate când datele nu coincid. Mai mult de cinci nu are sens, performanța va scădea.
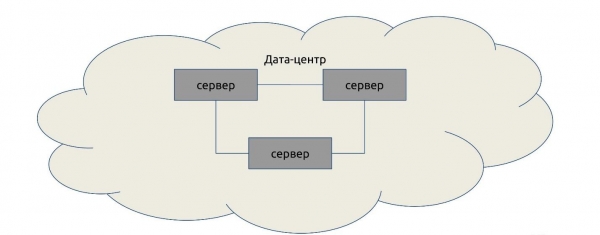
Clienții se conectează la servere în orice ordine: aceleași agenți, doar cu flag-ul server = false.
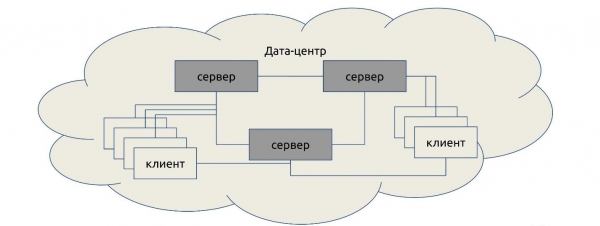
După aceasta, clienții primesc o listă de conexiuni P2P și construiesc legături între ei.
La nivel global, conectăm mai multe centre de date. Acestea se conectează, de asemenea, P2P și comunică între ele.
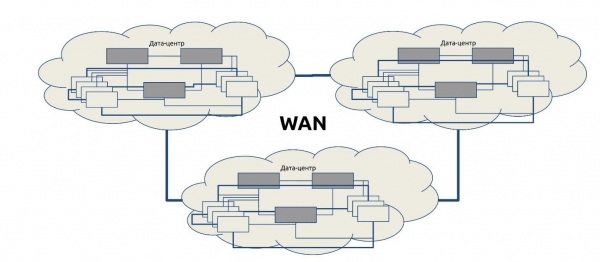
Când dorim să obținem date de la un alt centru de date, cererea merge de la server la server. Această schemă se numește protocolul Serf. Protocolul Serf, la fel ca și Consul, este o dezvoltare a HashiCorp.
Câteva fapte importante despre Consul
Consul are documentație care descrie modul său de funcționare. Voi oferi doar fapte selectate care merită să fie cunoscute.
Serverele Consul aleg un lider dintre votanți. Consul alege un lider din lista serverelor pentru fiecare centru de date, iar toate cererile merg doar la el, indiferent de numărul de servere. Deconectarea liderului nu duce la alegeri suplimentare. Dacă nu este ales un lider, cererile nu sunt gestionate de nimeni.
Ați dorit scalare orizontală? Ne pare rău, nu.
O cerere către un alt centru de date merge de la maestru la maestru, indiferent de serverul pe care a fost primită. Maestrul selectat primește 100% din sarcină, cu excepția sarcinii pentru redirecționarea cererilor. O copie actualizată a datelor există pe toate serverele din centrul de date, dar doar unul răspunde.
Singura modalitate de scalare este activarea modului stale pe client.
În modul stale se poate răspunde fără quorum. Este un mod în care renunțăm la consistența datelor, dar citim puțin mai repede decât de obicei, iar orice server răspunde. Normal, scrierea se face doar prin maestru.
Consul nu copiază datele între centrele de date. În cazul construirii unei federații, fiecare server va avea doar propriile sale date. Pentru celelalte, se va adresa întotdeauna către altcineva.
Atomicitatea operațiunilor nu este garantată în afara unei tranzacții. Amintiți-vă că nu doar voi puteți modifica ceva. Dacă doriți altfel, efectuați o tranzacție cu blocare.
Operațiile care blochează nu garantează blocarea. Cererea merge de la maestru la maestru, nu direct, așa că nu există garanții că blocarea va funcționa atunci când efectuați o blocare, de exemplu, într-un alt centru de date.
ACL-ul nu garantează accesul (în multe cazuri). ACL-ul poate să nu funcționeze deoarece este stocat într-un singur centru de date al federației — în centrul de date al ACL-ului (Primary DC). Dacă DC-ul nu vă răspunde, ACL-ul nu va funcționa.
Un maestru blocat va duce la blocarea întregii federații. De exemplu, într-o federație cu 10 centre de date, iar într-unul este o rețea proastă, iar un maestru se prăbușește. Toți cei care comunică cu el se vor bloca în cerc: cererea vine, nu există răspuns, firul se blochează. Nu veți putea ști când se va întâmpla, pur și simplu după o oră sau două, întreaga federație va cădea. Nu veți putea face nimic în legătură cu asta.
Starea, quorum-ul și alegerile sunt procesate de un fir separat. Realegerile nu vor avea loc, starea nu va arăta nimic. Credeți că aveți un Consul activ, solicitați, și nimic nu se întâmplă — nu există răspuns. Totuși, starea arată că totul este în regulă.
Ne-am confruntat cu această problemă, a trebuit să reconstrucăm părți specifice ale centrelor de date pentru a o evita.
În versiunea de afaceri a Consul Enterprise nu există unele dintre dezavantajele menționate mai sus.Are multe funcții utile: selecția votanților, distribuția, scalarea. Există un singur „dar” – sistemul de licențiere pentru sistemul distribuit este foarte scump.
Sfaturi utile: rm -rf /var/lib/consul – medicamentul universal pentru toate bolile agentului. Dacă ceva nu funcționează, pur și simplu ștergeți datele dvs. și încărcați datele dintr-o copie de rezervă. Cel mai probabil, Consul va începe să funcționeze.
BEFW
Acum să vorbim despre ce am adăugat la Consul.
– este un acronim pentru BackEndFireWall. Trebuia să numesc produsul într-un mod oarecare când am creat depozitul pentru a pune primele teste. Această denumire a rămas.
Șabloane de reguli
Regulile sunt scrise în sintaxa iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Tot ce merge pe calea BEFW, cu excepția ESTABLISHED, RELATED și localhost. Șablonul poate fi oricare, este doar un exemplu.
Ce utilitate are BEFW?
Servicii
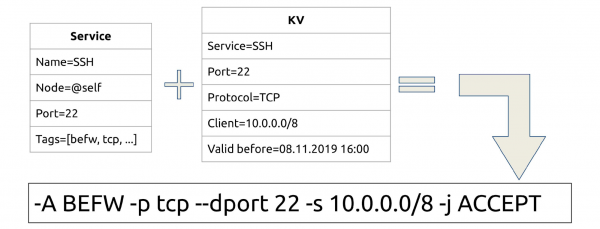
Avem un serviciu, are întotdeauna un port, nodul pe care funcționează. De la nodul nostru putem întreba local agentul și afla că avem un anumit serviciu. De asemenea, putem adăuga etichete.
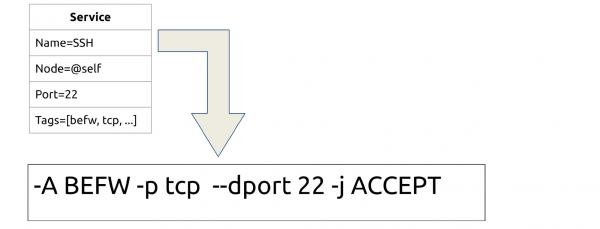
Orice serviciu care este pornit și înregistrat în Consul se transformă într-o regulă iptables. Avem SSH – deschidem portul 22. Scriptul Bash este simplu: curl și iptables, nimic mai mult.
Clienți
Cum se deschide accesul nu tuturor, ci selectiv? Adăugând listele de IP în magazinul KV în funcție de numele serviciului.
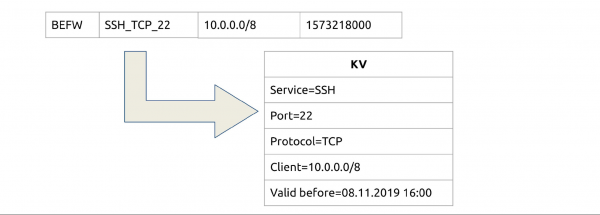
De exemplu, dorim ca toți din rețeaua zece să poată accesa serviciul SSH_TCP_22. Adăugăm un mic câmp TTL? și acum avem permisiuni temporare, de exemplu, pe o zi.
Accesuri
Conectăm serviciile și clienții: avem un serviciu, fiecare are un magazin KV pregătit. Acum dăm acces nu tuturor, ci selectiv.
Grupuri
Dacă de fiecare dată am scrie mii de IP-uri pentru accesuri, ne-am epuiza. Vom inventa grupuri – un subset separat în KV. Îl vom numi Alias (sau grupuri) și vom stoca acolo grupuri pe același principiu.
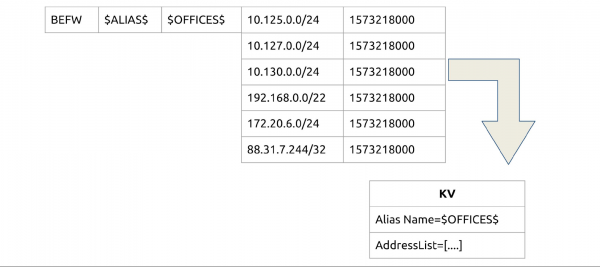
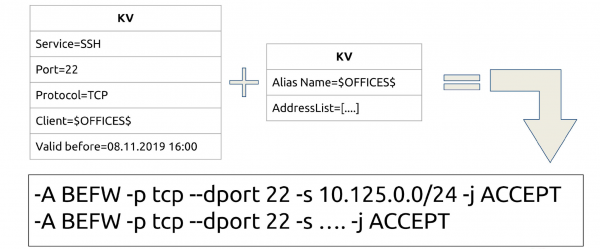
Conectăm: acum putem deschide SSH nu specific pe P2P, ci pe un întreg grup sau mai multe grupuri. De asemenea, există TTL – putem adăuga temporar în grup și elimina din grup.
Integrare
Problema noastră – factorul uman și automatizarea. Până acum am rezolvat-o astfel.
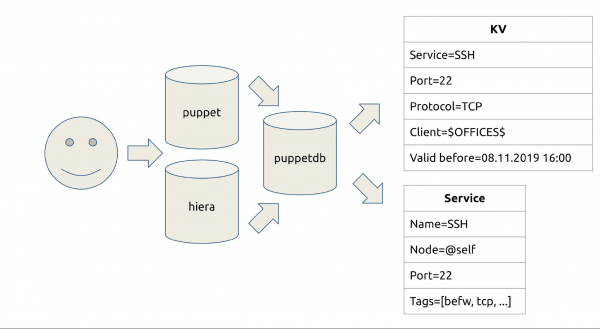
Lucrăm cu Puppet și transferăm tot ce ține de sistem (codul aplicațiilor). În puppetdb (un PostgreSQL obișnuit) se află o listă cu serviciile care sunt lansate acolo, iar acestea pot fi găsite după tipul de resursă. Acolo se poate verifica și cine face cereri către ce. De asemenea, avem un sistem de pull request și merge request pentru aceasta.
Am scris befw-sync – o soluție simplă care ajută la transferul datelor. La început, sincronizăm cookie-urile care se adresează puppetdb. Acolo este configurat un API HTTP: cerem ce servicii avem, ce trebuie să facem. Apoi facem o cerere în Consul.
Există integrare? Da: am scris reguli, am permis acceptarea Pull Request-ului. Este nevoie de un anumit port sau de a adăuga un host într-un grup? Pull Request, revizuire – fără „Caută 200 de alte ACL-uri și încearcă să faci ceva cu asta”.
Optimizare
Ping-ul localhost cu o interfață de reguli goală durează 0,075 ms.
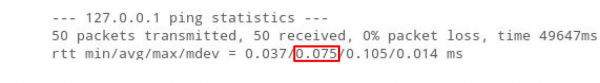
Vom adăuga în această interfață 10.000 de adrese iptables. Drept rezultat, ping-ul va crește de 5 ori: iptables este complet liniar, procesarea fiecărei adrese durează un anumit timp.
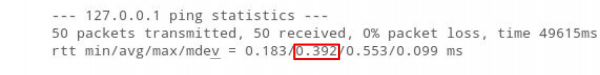
Pentru firewall-ul în care migrăm mii de ACL-uri, avem multe reguli, ceea ce introduce întârzieri. Pentru protocoalele de joc, acest lucru este neplăcut.
Dar dacă plasăm 10.000 de adrese în ipset ping-ul se va diminua chiar.
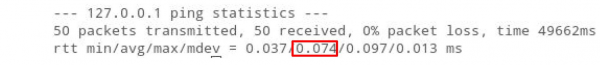
Ideea este că „O” (complexitatea algoritmului) pentru ipset este întotdeauna egală cu 1, indiferent câte reguli sunt acolo. Totuși, există o limitare – nu pot fi mai mult de 65535 de reguli. Până acum ne descurcăm cu asta: le putem combina, extinde, face două ipset-uri într-unul.
Stocare
O continuare logică a procesului de iterații este păstrarea informațiilor despre clienți pentru serviciul în ipset.
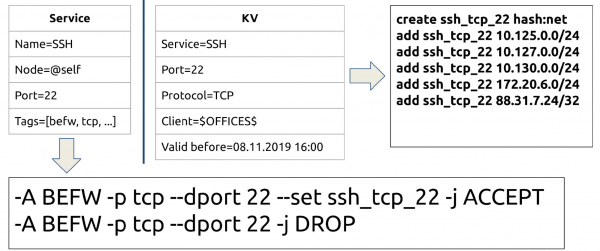
Acum avem același SSH, și nu scriem imediat 100 de IP-uri, ci definim un nume de ipset cu care trebuie să interacționăm, iar următoarea regulă ȘTERGE. Se poate reformula într-o regulă „Cine nu se află aici, acela DROP”, dar așa este mai vizibil.
Acum avem reguli și seturi. Principala sarcină este să creăm setul înainte de a scrie regula, deoarece altfel iptables nu va salva regula.
Schema generală
În formă schematică, tot ce am spus arată așa.
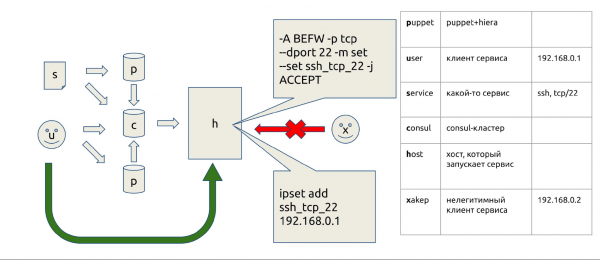
Commităm în Puppet, totul se trimite pe gazdă, serviciile sunt aici, ipset-ul acolo, iar cine nu este acolo nu este lăsat să treacă.
Permiteți & refuzați
Pentru a salva rapid lumea sau pentru a deconecta rapid pe cineva, la începutul tuturor lanțurilor am creat două ipset-uri: rules_allow și rules_deny. Cum funcționează asta?
De exemplu, cineva generează o încărcare pe web cu boturi. Mai demult trebuia să găsim IP-ul său în jurnale, să-l trimitem inginerilor de rețea pentru a găsi sursa traficului și a o bloca. Acum, lucrurile stau diferit.
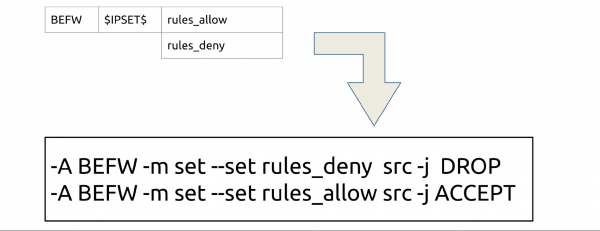
Trimitem în Consul, așteptăm 2,5 secunde, și este gata. Deoarece Consul distribuie rapid prin P2P, funcționează peste tot, în orice colț al lumii.
Odată, am oprit complet WOT, greșind cu firewall-ul. rules_allow — este asigurarea noastră împotriva unor astfel de cazuri. Dacă am greșit undeva cu firewall-ul, iar ceva este blocat, putem întotdeauna să trimitem un 0.0/0, pentru a ridica rapid totul. Apoi, vom repara manual toate problemele.
Seturi alternative
Se pot adăuga orice alte seturi în spațiu $IPSETS$.
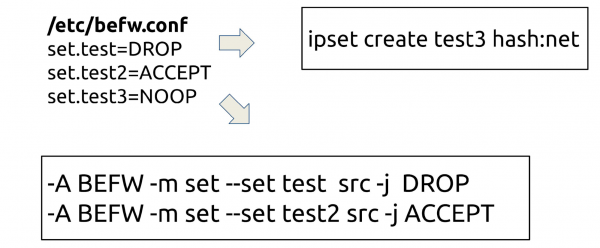
De ce? Uneori, cineva are nevoie de ipset, de exemplu, pentru a emula oprirea unei părți a clusterei. Fiecare poate aduce orice seturi, le poate numi și acestea vor fi preluate din Consul. Seturile pot participa atât în regulile iptables, cât și funcționa ca o comandă NOOP: consistența va fi menținută de demon.
Utilizatori
Mai demult era așa: utilizatorul se conecta la rețea și obținea parametrii prin domeniu. Până la apariția firewall-urilor de nouă generație, Cisco nu putea înțelege unde era utilizatorul și unde se afla IP-ul. De aceea, accesul era acordat doar prin hostname-ul mașinii.
Ce am făcut noi? Ne-am intercalat în momentul obținerii adresei. De obicei, este vorba despre dot1x, Wi-Fi sau VPN — totul trece prin RADIUS. Pentru fiecare utilizator creăm un grup după numele de utilizator și plasăm în el IP-ul cu TTL, care este egal cu dhcp.lease — imediat ce expire, regula dispare.
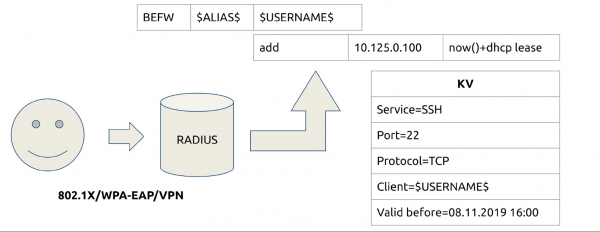
Acum putem deschide accesul la servicii, la fel ca și în alte grupuri, pe baza numelui de utilizator. Am scăpat de problemele cu hostname-urile, când acestea se schimbă, și am ridicat povara de pe umerii inginerilor de rețea, pentru că nu mai au nevoie de Cisco. Acum inginerii își notează singuri accesurile pe serverele lor.
Izolare
În paralel, am început să analizăm izolația. Managerii de servicii au realizat un inventar, iar noi am analizat toate rețelele noastre. Le vom împărți în grupuri similare, iar pe serverele necesare am adăugat grupuri, de exemplu, în deny. Acum, aceeași izolație de staging ajunge în rules_deny la producție, dar nu în producția în sine.
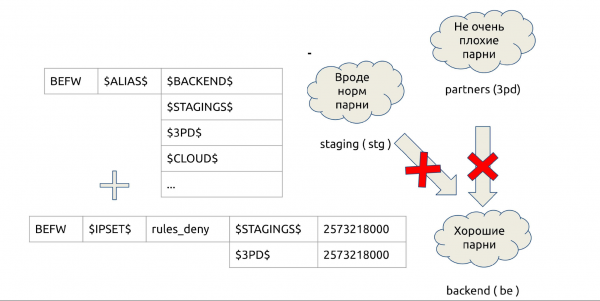
Schema funcționează rapid și simplu: eliminăm toate ACL-urile de pe servere, descărcăm echipamentele, reducând numărul VLAN-urilor izolate.
Controlul integrității
În trecut, aveam un trigger special care anunța când cineva modifica manual regula firewall-ului. Am scris un lintern imens pentru a verifica regulile firewall-ului, ceea ce era complicat. Acum, integritatea este controlată de BEFW. Acesta se asigură cu strictețe că regulile pe care le execută nu sunt schimbate. Dacă cineva modifică regulile firewall-ului, le va restabili pe cele originale. „Am ridicat rapid un proxy ca să lucrez de acasă” — astfel de opțiuni nu mai există.
BEFW controlează ipset din servicii și lista din befw.conf, regulile serviciilor în lanțul BEFW. Dar nu supraveghează alte lanțuri și reguli și alte ipset.
Protecție împotriva erorilor
BEFW salvează întotdeauna ultima stare de succes direct în structura binară state.bin. Dacă ceva nu merge bine, se reapucă întotdeauna de acest state.bin.
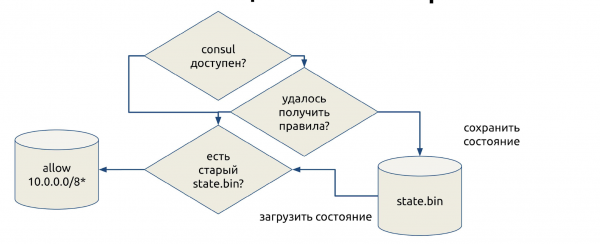
Aceasta este o asigurare împotriva funcționării instabile a Consul, când nu trimite date sau cineva greșește și folosește reguli care nu pot fi aplicate. Pentru a nu rămâne fără firewall, BEFW se va întoarce la ultima stare, dacă se va întâmpla o eroare în orice moment.
În situații critice, aceasta garantează că vom rămâne cu un firewall funcțional. Deschidem toate rețelele gri în speranța că admin-ul va veni și le va remedia. Cândva voi muta asta în configurații, dar în prezent avem doar trei rețele gri: 10/8, 172/12 și 192.168/16. În cadrul Consul-ului nostru, aceasta este o caracteristică importantă care ajută la dezvoltarea ulterioară.
Demo: în timpul prezentării, Ivan demonstrează modul de funcționare al BEFW în modul demo. Demonstrația este mai ușor de vizionat pe . Codul sursă pentru demo este disponibil .
Capcane
Voi vorbi despre bug-urile cu care ne-am confruntat.
ipset add set 0.0.0.0/0. Ce se va întâmpla dacă adaug în ipset 0.0.0.0/0? Vor fi adăugate toate IP-urile? Se va deschide accesul la internet?
Nu, vom obține un bug care ne-a costat două ore de nefuncționare. În plus, bug-ul nu funcționează din 2016, se află în RedHat Bugzilla sub numărul #1297092, iar noi l-am găsit întâmplător — din raportul dezvoltatorului.
Acum în BEFW există o regulă strictă, că 0.0.0.0/0 se transformă în două adrese: 0.0.0.0/1 și 128.0.0.0/1.
ipset restore set < file. Ce face ipset când îi spui restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Nimic de genul — face un merge, iar vechile adrese nu dispar, accesul nu este închis.
Am găsit bug-ul când testam izolația. Acum există un sistem destul de complex — în loc de restore se efectuează create temp, apoi restore flush temp și restore temp. La final swap: pentru atomicitate, pentru că dacă se realizează mai întâi flush Și în acel moment, dacă vine un anumit pachet, acesta va fi respins și ceva va merge prost. Așadar, există puțină magie neagră acolo.
consul kv get -datacenter=other. Așa cum am spus deja, ne gândim că solicităm anumite date, dar vom obține fie date, fie o eroare. Putem face asta prin Consul local, dar chiar și în acest caz va bloca ambele.
Clientul local Consul este o wrapper peste API-ul HTTP. Dar pur și simplu se blochează și nu răspunde nici la Ctrl+C, nici la Ctrl+Z, nimic, doar la kill -9 în consola alăturată. Ne-am confruntat cu asta când construiam un cluster mare. Dar nu avem în prezent o soluție, ne pregătim să corectăm această eroare în Consul.
Leader-ul Consul nu răspunde. Nu avem un master care să răspundă în data center, ne gândim: „Probabil, algoritmul de realegere va funcționa acum?”
Nu, nu va funcționa, iar monitorizarea nu va arăta nimic: Consul va spune că indicele de angajament există, liderul a fost găsit, totul este bine.
Cum ne luptăm cu asta? service consul restart în cron de fiecare oră. Dacă aveți 50 de servere - nu este nicio problemă. Când vor fi 16 000, veți înțelege cum funcționează asta.
Concluzie
În cele din urmă, am obținut următoarele avantaje:
- 100% acoperire a tuturor mașinilor Linux.
- Viteza.
- Automatizare.
- Am eliberat hardware-ul și inginerii de rețea de muncă repetitivă.
- Au apărut oportunități de integrare care sunt practic nelimitate: fie cu Kubernetes, fie cu Ansible, fie cu Python.
Dezavantaje: Consul, cu care trebuie să trăim acum, și un preț foarte ridicat al erorii. Ca exemplu, o dată am modificat ceva în listele de rețea la ora 18:00 (vârf în Rusia). Exact atunci construia izolarea pe BEFW. Am greșit undeva, cred că am indicat o mască greșită, dar totul s-a prăbușit în două secunde. Monitorizarea se activează, vine tehnicianul de suport: „Totul este căzut!” Șeful departamentului a îmbătrânit când a explicat afacerii de ce s-a întâmplat asta.
Prețul erorii este atât de ridicat încât am conceput o procedură complexă de prevenire. Dacă veți implementa asta într-o producție mare, nu trebuie să oferiți token-ul master peste Consul tuturor. Se va termina prost.
Costul. Am scris cod timp de 400 de ore singur. La suport, echipa mea de 4 persoane cheltuie 10 ore pe lună pentru toți. Comparativ cu prețul oricărui firewall de nouă generație, este gratuit.
Planuri. Planul pe termen lung este căutarea unui transport alternativ în locul sau pe lângă Consul. Poate că va fi Kafka sau ceva similar. Dar în următorii ani vom trăi pe Consul.
Planurile imediate: integrarea cu Fail2ban, cu monitorizare, cu nftables, posibil, cu alte distribuții, metrici, monitorizare extinsă, optimizare. Suportul pentru Kubernetes este, de asemenea, în planuri, deoarece deocamdată avem câteva clustere și dorință.
Încă din planuri:
- căutarea anomaliilor în trafic;
- gestionarea hartăi rețelei;
- suport pentru Kubernetes;
- compilarea pachetelor pentru toate sistemele;
- Interfața Web.
Lucrăm constant la extinderea configurației, creșterea metricilor și optimizarea.
Alăturați-vă proiectului. Proiectul a ieșit grozav, dar, din păcate, este deocamdată un proiect al unei singure persoane. Veniti la și încercați să faceți ceva: să faceți un commit, să testați, să propuneți ceva, să oferiți evaluarea dumneavoastră.
Între timp, ne pregătim pentru , care va avea loc pe 6 și 7 aprilie la Sankt Petersburg, și invităm dezvoltatorii de sisteme cu încărcături mari . Vorbitorii cu experiență știu deja ce să facă, iar începătorilor le recomandăm măcar . Participarea la conferință ca vorbitor are o serie de avantaje. Despre ce avantaje, puteți citi, de exemplu, la final .
Sursa: habr.com
