

Orice operație cu date mari necesită puteri de procesare mari. Transferul obișnuit de date dintr-o bază de date în Hadoop poate dura săptămâni sau poate costa cât o aripă de avion. Nu doriți să așteptați și să cheltuiți? Echilibrați încărcătura pe diferite platforme. Una dintre metode este optimizarea pushdown.
L-am rugat pe Alexei Ananiev, un trainer de top în Rusia pentru dezvoltarea și administrarea produselor Informatica, să ne povestească despre funcția de optimizare pushdown în Informatica Big Data Management (BDM). Ați învățat vreodată să lucrați cu produsele Informatica? Cel mai probabil, Alexei v-a explicat elementele de bază ale PowerCenter și cum să construiți mapări.
Alexei Ananiev, directorul departamentului de formare DIS Group
Ce este pushdown?
Multe dintre voi sunteți deja familiarizați cu Informatica Big Data Management (BDM). Produsul poate integra date mari din diferite surse, le poate muta între diferite sisteme, oferă acces ușor la acestea, permite profilarea lor și multe altele.
În mâini iscusite, BDM poate face minuni: sarcinile vor fi finalizate rapid și cu resurse de calcul minime.
Vreți și voi asta? Învățați să folosiți funcția de pushdown în BDM pentru a distribui sarcina de calcul între diferite platforme. Tehnologia pushdown permite transformarea unei mapări într-un script și alegerea mediu în care acest script va fi lansat. Această opțiune de alegere permite combinarea punctelor forte ale diferitelor platforme și atingerea maximelor performanțe ale acestora.
Pentru a configura mediul de execuție a scriptului, trebuie să selectați tipul de pushdown. Scriptul poate fi complet rulat pe Hadoop sau parțial distribuit între sursă și destinatar. Există 4 tipuri posibile de pushdown. O mapare nu trebuie să fie transformată într-un script (native). O mapare poate fi executată maxim pe sursă (source) sau complet pe sursă (full). De asemenea, o mapare poate fi transformată într-un script Hadoop (none).
Optimizarea pushdown
Cele 4 tipuri enumerate pot fi combinate în moduri diferite – optimizând pushdown pentru nevoile specifice ale sistemului. De exemplu, adesea este mai util să extrageți date din baza de date, folosind capacitățile sale proprii. Iar pentru a transforma datele – folosind puterea Hadoop, astfel încât să nu suprasolicitați baza de date.
Să luăm în considerare cazul în care atât sursa, cât și receptorul se află în BD, iar platforma de execuție a transformărilor poate fi aleasă: în funcție de setări, aceasta va fi Informatica, serverul BD sau Hadoop. Un astfel de exemplu va permite înțelegerea cât mai exactă a laturii tehnice a acestui mecanism. Evident, în viața reală, o astfel de situație nu apare, dar pentru a demonstra funcționalitatea, este cel mai potrivit.
Să luăm un mapping pentru citirea a două tabele dintr-o bază de date Oracle comună. Iar rezultatele citirii să fie scrise într-un tabel din aceeași bază. Schema de mapping va fi următoarea:
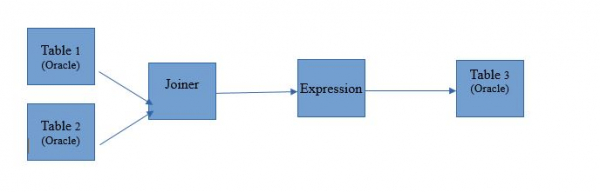
Sub forma de mapping pe Informatica BDM 10.2.1, acesta arată astfel:
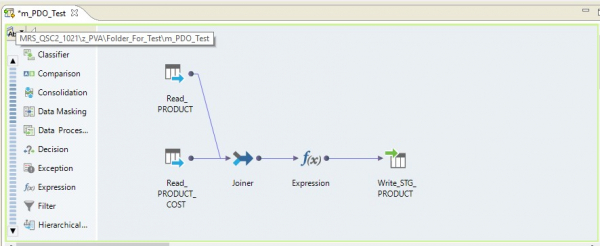
Tip pushdown – nativ
Dacă alegem tipul pushdown nativ, mappingul va fi executat pe server Informatica. Datele vor fi citite de pe serverul Oracle, transferate pe serverul Informatica, transformate acolo și trimise în Hadoop. Cu alte cuvinte, vom obține un proces ETL obișnuit.
Tip pushdown – sursă
Atunci când alegem tipul sursă, obținem posibilitatea de a distribui procesul nostru între serverul baze de date (BD) și Hadoop. La executarea procesului cu această setare, se vor trimite interogări pentru extragerea datelor din tabele. Iar restul va fi realizat sub formă de pași pe Hadoop.
Schema de execuție va arăta astfel:
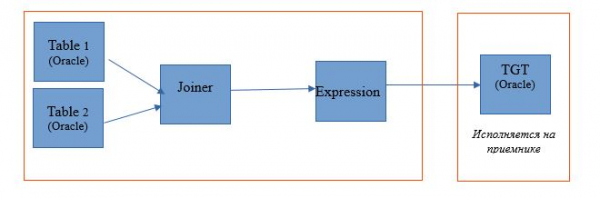
Mai jos – un exemplu de configurare a mediului de execuție.
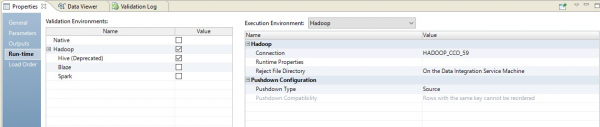
În acest caz, mappingul va fi executat în două etape. În setările sale, vom observa că s-a transformat într-un script care va fi trimis la sursă. De fapt, combinarea tabelelor și transformarea datelor va fi realizată sub formă de interogare redefinită pe sursă.
În imaginea de mai jos, vedem un mapping optimizat pe BDM, iar pe sursă – o interogare redefinită.
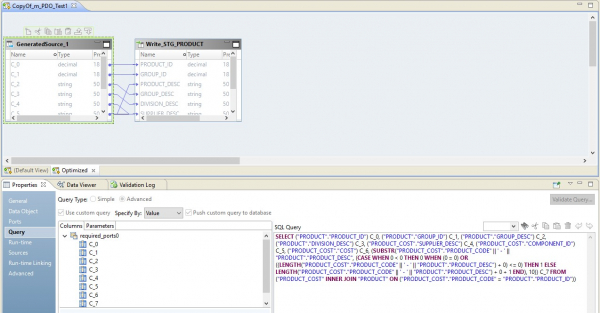
Rolul Hadoop în această configurație va consta în gestionarea fluxului de date – dirijarea lor. Rezultatul interogării va fi trimis în Hadoop. După finalizarea citirii, fișierul din Hadoop va fi scris în receptor.
Tip pushdown – total
La alegerea tipului total, mappingul se va transforma complet într-o interogare pe BD. Iar rezultatul interogării va fi trimis în Hadoop. Schema acestui proces este prezentată mai jos.
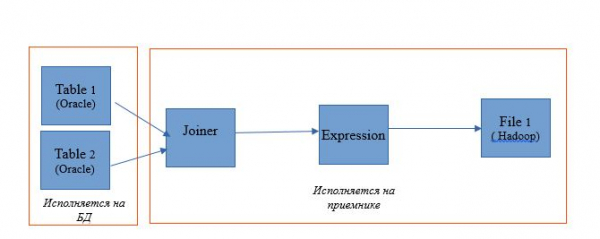
Exemplul de configurare este prezentat mai jos.
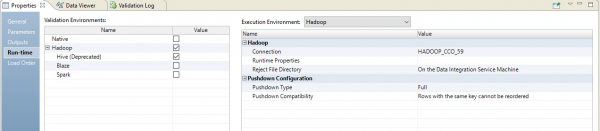
Ca rezultat, vom obține un mapping optimizat similar cu precedentul. Diferența constă doar în faptul că toată logica este transferată la receptor sub formă de redefinire a inserției sale. Exemplul de mapping optimizat este prezentat mai jos.
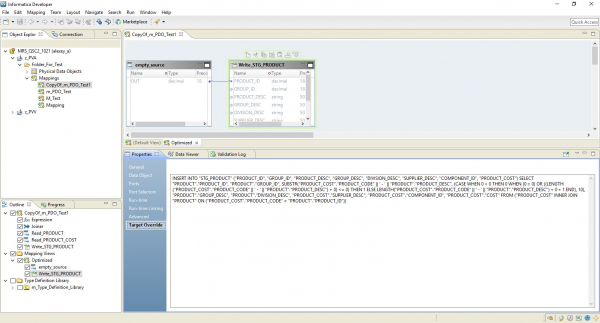
Aici, ca și în cazul anterior, Hadoop îndeplinește rolul de dirijor. Dar aici, citirea sursei se face complet, iar apoi, la nivelul receptorului, se execută logica de procesare a datelor.
Tipul pushdown – null
Și ultima variantă – tipul pushdown, în care maparea noastră se transformă într-un script pe Hadoop.
Maparea optimizată va arăta acum astfel:
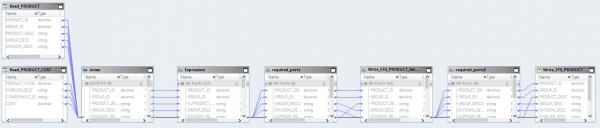
Aici, datele din fișierele sursă vor fi mai întâi citite pe Hadoop. Apoi, cu ajutorul acestuia, cele două fișiere vor fi combinate. După aceea, datele vor fi transformate și exportate în baza de date.
Înțelegând principiile optimizării pushdown, se pot organiza foarte eficient multe procese de lucru cu big data. De exemplu, recent, o mare companie a reușit să exporte în Hadoop date mari, pe care până atunci le-a colectat timp de câțiva ani, în doar câteva săptămâni.
Sursa: habr.com
