

Salut, Habr! Vă prezint traducerea articolului
.
Când vine vorba de baze de date relaționale, nu pot să nu mă gândesc că lipsește ceva. Ele sunt folosite peste tot. Există multe tipuri diferite de baze de date: de la SQLite, mic și util, până la puternica Teradata. Însă există doar câteva articole care explică cum funcționează o bază de date. Poți căuta singur cu termenul "cumfuncționeazăbazădedaterelațională" pentru a vedea câte rezultate puține sunt. Mai mult, aceste articole sunt scurte. Dacă cauți cele mai recente tehnologii la modă (BigData, NoSQL sau JavaScript), vei găsi mai multe articole aprofundate care explică cum funcționează acestea.
Sunt bazele de date relaționale prea vechi și prea plictisitoare pentru a fi explicate în afara cursurilor universitare, lucrărilor de cercetare și cărților?
Ca dezvoltator, urăsc să folosesc ceea ce nu înțeleg. Și dacă bazele de date au fost utilizate timp de peste 40 de ani, trebuie să existe un motiv. De-a lungul acestor ani, am petrecut sute de ore încercând să înțeleg cu adevărat aceste cutii negre ciudate pe care le folosesc zilnic. Baze de date relaționale sunt foarte interesante deoarece se bazează pe concepte utile și reutilizabile. Dacă ești interesat de înțelegerea unei baze de date, dar nu ai avut niciodată timp sau voință să te aprofundezi în această temă vastă, îți va plăcea acest articol.
Deși titlul acestui articol este clar, scopul acestui articol nu este de a învăța cum să folosești o bază de date. Prin urmare, ar trebui deja să știi cum să scrii o interogare simplă de unire și interogări de bază CRUD; altfel s-ar putea să nu înțelegi acest articol. Acesta este singurul lucru pe care trebuie să-l știi, voi explica tot restul.
Voi începe cu unele noțiuni de bază ale științelor computerelor, cum ar fi complexitatea temporală a algoritmilor (BigO). Știu că unii dintre voi displac această idee, dar fără ea nu veți putea înțelege subtilitățile din interiorul unei baze de date. Deoarece este un subiect uriaș, mă voi concentra pe ceea ce consider important în modul în care baza de date procesează: . Voi prezenta doar SQL o cerereconceptele de bază ale unei baze de date , astfel încât la sfârșitul articolului să ai o idee despre ce se întâmplă sub capotă., pentru ca la finalul articolului să aveți o idee despre ceea ce se întâmplă sub capotă.
Dacă acesta este un articol lung și tehnic, care include multe algoritmi și structuri de date, nu vă grăbiți să-l citiți. Anume concepte pot fi complicate pentru a fi înțelese; le puteți sări peste ele și totuși să obțineți o imagine de ansamblu.
Pentru cei mai informați dintre voi, acest articol este împărțit în 3 părți:
- Prezentarea componentelor de bază de nivel scăzut și de nivel înalt ale unei baze de date
- Prezentarea procesului de optimizare a interogărilor
- Prezentarea gestionării tranzacțiilor și a pool-ului de buffer
Revenind la bazele fundamentale
Cu mulți ani în urmă (într-o galaxie îndepărtată…), dezvoltatorii trebuiau să știe exact câte operațiuni codificau. Își știau algoritmii și structurile de date pe de rost, deoarece nu-și puteau permite să piardă CPU și memoria computerelor lor lente.
În această parte, vă voi reaminti unele dintre aceste concepte, deoarece sunt necesare pentru a înțelege baza de date. De asemenea, voi introduce conceptul de index al bazei de date.
O(1) vs O(n2)
În prezent, mulți dezvoltatori nu se îngrijesc de complexitatea temporală a algoritmilor… și au dreptate!
Dar atunci când te confrunți cu cantități mari de date (nu vorbesc de mii) sau dacă te lupți pentru milisecunde, devine critic să înțelegi acest concept. Și, după cum știți, bazele de date trebuie să se ocupe de ambele situații! Nu voi face să pierdeți mai mult timp decât este necesar pentru a prinde esența. Acest lucru ne va ajuta mai târziu să înțelegem conceptul de optimizare bazată pe cost (cost based optimization).
Conceptul
Complexitatea temporală a algoritmului este utilizată pentru a vedea cât timp va dura execuția unui algoritm pentru un anumit volum de date. Pentru a descrie această complexitate, se utilizează notația matematică big O. Această notație este folosită cu o funcție care descrie câte operațiuni are nevoie algoritmul pentru a procesa o anumită cantitate de date de intrare.
De exemplu, când spun "acest algoritm are complexitatea O (some_function() )", înseamnă că pentru a procesa o anumită cantitate de date, algoritmului îi sunt necesare some_function(a_certain_amount_of_data) operațiuni.
În plus, este important nu numărul de date**, ci cum ** crește numărul de operațiuni pe măsură ce volumul de date crește. Complexitatea temporală nu oferă un număr exact de operațiuni, ci o modalitate bună de a estima timpul de execuție.
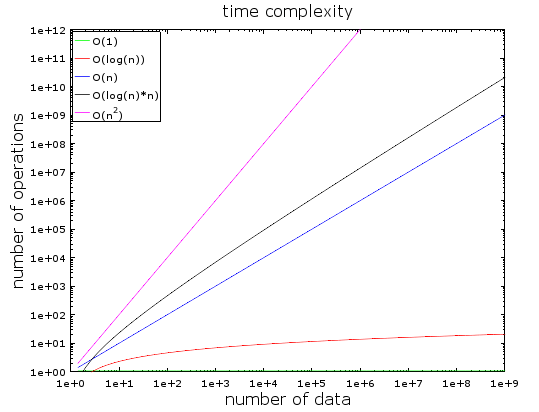
În acest grafic, puteți observa relația dintre numărul de operațiuni și volumul de date de intrare pentru diferite tipuri de complexitate temporală a algoritmilor. Am folosit o scară logaritmică pentru a le ilustra. Cu alte cuvinte, cantitatea de date crește rapid de la 1 la 1 miliard. Putem observa că:
- O(1) sau complexitatea constantă rămâne constantă (altfel nu ar fi numită complexitate constantă).
- O(log(n)) rămâne scăzută chiar și cu miliarde de date.
- Cea mai proastă complexitate este O(n2), unde numărul de operațiuni crește rapid.
- Celelalte două complexități cresc de asemenea rapid.
Exemple
Când volumul de date este mic, diferența între O(1) și O(n2) este neglijabilă. De exemplu, să presupunem că aveți un algoritm care trebuie să proceseze 2000 de elemente.
- Algoritmul O(1) vă va costa 1 operațiune
- Algoritmul O(log(n)) vă va costa 7 operațiuni
- Algoritmul O(n) vă va costa 2000 de operațiuni
- Algoritmul O(n * log(n)) vă va costa 14000 de operațiuni
- Algoritmul O(n2) vă va costa 4.000.000 de operațiuni
Diferența dintre O(1) și O(n2) pare mare (4 milioane de operațiuni), dar veți pierde maxim 2 ms, timpul necesar pentru a clipi. Într-adevăr, procesoarele moderne pot procesa . De aceea, performanța și optimizarea nu sunt o problemă în multe proiecte IT.
Așa cum am spus, este încă important să cunoașteți acest concept atunci când lucrați cu un volum mare de date. Dacă de data aceasta algoritmul trebuie să proceseze 1.000.000 de elemente (ceea ce nu este atât de mult pentru o bază de date):
- Algoritmul O(1) vă va costa 1 operațiune
- Algoritmul O(log(n)) vă va costa 14 operațiuni
- Algoritmul O(n) vă va costa 1.000.000 de operațiuni
- Algoritmul O(n * log(n)) vă va costa 14.000.000 de operațiuni
- Algoritmul O(n2) vă va costa 1.000.000.000.000 de operațiuni
Nu am făcut calcule, dar aș spune că, cu un algoritm O(n2), aveți timp să beți o cafea (chiar două!). Dacă adăugați încă 0 la volumul de date, veți avea timp să vă odihniți.
Să aprofundăm
Pentru referință:
- Căutarea într-o tabelă hash bună găsește elementul în O(1).
- Căutarea într-un copac bine echilibrat returnează rezultatul în O(log(n)).
- Căutarea într-un array returnează rezultatul în O(n).
- Cele mai bune algoritme de sortare au complexitatea O(n * log(n)).
- Un algoritm de sortare prost are complexitatea O(n2).
Notă: în părțile următoare, vom examina aceste algoritme și structuri de date.
Există mai multe tipuri de complexitate temporală a algoritmului:
- scenariul mediu
- cea mai bună variantă posibilă
- și cel mai prost scenariu
Complexitatea temporală este adesea cel mai rău scenariu.
Am vorbit doar despre complexitatea temporală a algoritmului, dar complexitatea se aplică de asemenea pentru:
- consumul de memorie al algoritmului
- consumul de intrare/ieșire pe disc al algoritmului
Desigur, există complexități și mai rele decât n2, de exemplu:
- n4: este groaznic! Unele dintre algoritmii menționați au o astfel de complexitate.
- 3n: este și mai rău! Unul dintre algoritmii pe care îi vom vedea în mijlocul acestui articol are această complexitate (și este cu adevărat utilizat în multe baze de date).
- factorial n: nu vei obține niciodată rezultatele tale, nici măcar cu un volum mic de date.
- nn: dacă te confrunți cu această complexitate, ar trebui să te întrebi dacă aceasta este cu adevărat domeniul tău de activitate ...
Notă: ți-am dat o idee, nu o definiție reală a termenului „Big O”. Poți citi acest articol pentru definiția reală (asimptotică).
MergeSort (Sortare prin fuziune)
Ce faci când trebuie să sortezi o colecție? Ce? Chem funcția sort()… Ok, răspuns bun… Dar pentru o bază de date, trebuie să înțelegi cum funcționează această funcție sort().
Există câteva algoritmi buni de sortare, așa că mă voi concentra pe cel mai important: sortarea prin fuziune. Poate că acum nu înțelegi de ce sortarea datelor este utilă, dar va trebui să o înțelegi după partea dedicată optimizării interogărilor. Mai mult, înțelegerea sortării prin fuziune ne va ajuta mai târziu să înțelegem operația de unire a bazelor de date, numită merge join (fuziune)..
Merge (fuziune)
Ca multe algoritmi utili, sortarea prin fuziune se bazează pe un truc: unirea a 2 array-uri sortate de dimensiune N/2 într-un array sortat de N elemente costă doar N operații. Această operație se numește fuziune.
Să vedem ce înseamnă acest lucru printr-un exemplu simplu:
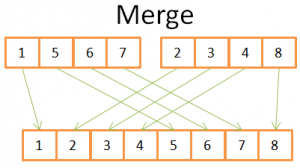
În această imagine se poate vedea că pentru a construi array-ul final sortat din 8 elemente trebuie doar să iterezi o singură dată prin cele 2 array-uri de 4 elemente. Deoarece ambele array-uri de 4 elemente sunt deja sortate:
- 1) compari cele două elemente curente din cele două array-uri (la început curent = primului)
- 2) apoi luați cel mai mic pentru a-l plasa într-un array de 8 elemente
- 3) și treceți la următorul element din array, unde ați luat cel mai mic element
- și repetați 1, 2, 3 până când ajungeți la ultimul element din unul dintre array-uri.
- Apoi luați celelalte elemente din celălalt array pentru a le plasa într-un array de 8 elemente.
Acest lucru funcționează deoarece ambele array-uri de 4 elemente sunt sortate, deci nu trebuie să "reveniți" în aceste array-uri.
Acum, când am înțeles acest truc, iată pseudocodul meu pentru merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   // apeluri recursive
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   // unind cele 2 array-uri mici sortate într-unul mare
   array result := merge(new_left_array,new_right_array);
   return result;
Sortarea prin unire împarte problema în probleme mai mici și apoi găsește rezultatele acestor probleme mai mici pentru a obține rezultatul problemei originale (notă: acest tip de algoritmi este numit divide et impera). Dacă nu înțelegi acest algoritm, nu-ți face griji; eu nu l-am înțeles prima dată când l-am văzut. Dacă poate să te ajute, văd acest algoritm ca fiind un algoritm în două faze:
- Faza de divizare, unde array-ul este împărțit în array-uri mai mici
- Faza de sortare, unde array-urile mici sunt unite (folosind unirea) pentru a forma un array mai mare.
Faza de divizare
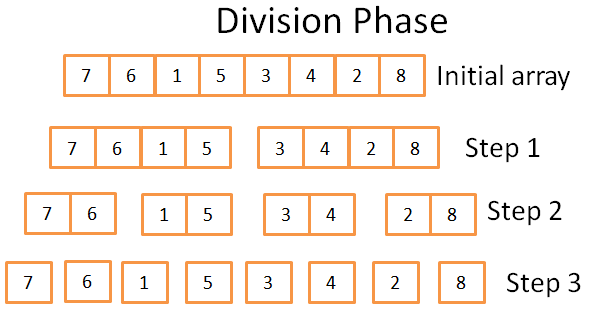
În etapa de divizare, array-ul este împărțit în array-uri unitare în 3 pași. Numărul formal de pași este log(N) (deoarece N=8, log(N) = 3).
De unde știu asta?
Sunt un geniu! Pe scurt — matematică. Ideea este că fiecare pas împarte dimensiunea array-ului inițial la 2. Numărul de pași este numărul de ori în care poți împărți array-ul inițial la 2. Aceasta este definiția exactă a logaritmului (cu baza 2).
Faza de sortare
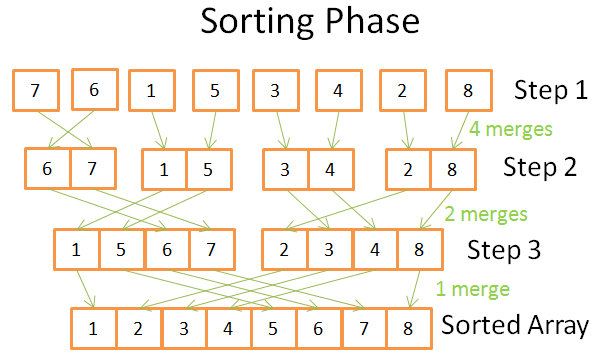
În etapa de sortare, începem cu array-uri unitare (de un singur element). La fiecare etapă aplicăm mai multe operații de unire, iar costul total este N = 8 operații:
- În prima etapă aveți 4 uniri, care costă 2 operații fiecare
- În a doua etapă aveți 2 uniri, care costă 4 operații fiecare
- În a treia etapă aveți 1 unire, care costă 8 operații
Deoarece există log(N) pași, costul total este N * log(N) operații.
Avantajele sortării prin unire
De ce este acest algoritm atât de puternic?
Pentru că:
- Îl poți schimba astfel încât să reduci cantitatea de memorie, astfel încât să nu creezi noi matrice, ci să modifici direct matricea de intrare.
Notă: acest tip de algoritmi se numește (sortare fără memorie suplimentară).
- Îl poți modifica pentru a utiliza simultan spațiul de pe disc și o cantitate mică de memorie fără costuri semnificative pentru intrare/ieșire de disc. Ideea este de a încărca în memorie doar acele părți care sunt în prezent prelucrate. Acest lucru este important când trebuie să sortezi un tabel de câțiva gigabaiți doar cu un buffer de memorie de 100 megabaiți.
Notă: acest tip de algoritmi se numește .
- Îl poți adapta pentru a rula pe mai multe procese / fire / servere.
De exemplu, sortarea prin îmbinare distribuită este unul dintre componentele cheie (care este o structură în big data).
- Acest algoritm poate transforma plumbul în aur (adevărat!).
Acest algoritm de sortare este utilizat în majoritatea (dacă nu în toate) bazelor de date, dar nu este singurul. Dacă vrei să afli mai multe, poți citi acest , care discută avantajele și dezavantajele algoritmilor de sortare comuni în baze de date.
Matrice, Arbore și Hash-Table
Acum, când înțelegem ideea de complexitate temporală și sortare, trebuie să-ți vorbesc despre 3 structuri de date. Este important pentru că ele sunt baza bazelor de date moderne. Voi introduce de asemenea conceptul de index al bazei de date.
Array
Matrice bidimensională – cea mai simplă structură de date. O tabelă poate fi privită ca o matrice. De exemplu:
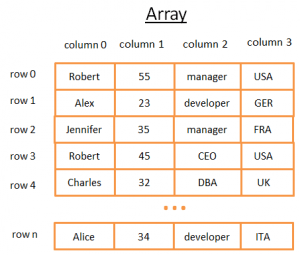
Această matrice 2-D reprezintă un tabel cu rânduri și coloane:
- Fiecare rând reprezintă o entitate
- Coloanele stochează proprietăți care descriu entitatea.
- Fiecare coloană stochează date de un anumit tip (integer, string, dată …).
Este atât de convenabil să stochezi și să vizualizezi datele, totuși, atunci când trebuie să găsești o anumită valoare, aceasta nu este potrivită.
De exemplu, dacă vrei să găsești toți băieții care lucrează în Regatul Unit, va trebui să verifici fiecare rând pentru a determina dacă acel rând aparține Regatului Unit. Aceasta îți va costa N operații, unde N — numărul de linii, ceea ce nu este rău, dar poate exista o cale mai rapidă? Acum este timpul să ne familiarizăm cu arborii.
Notă: cele mai multe baze de date moderne oferă array-uri extinse pentru stocarea eficientă a tabelelor: tabele organizate pe heap și tabele organizate pe index. Dar acest lucru nu rezolvă problema căutării rapide a unei condiții specifice într-un grup de coloane.
Arborele și indexul bazei de date
Arborele binar de căutare este un arbore binar cu o proprietate specială, cheia din fiecare nod trebuie să fie:
- mai mare decât toate cheile stocate în subarborele stâng
- mai mică decât toate cheile stocate în subarborele drept
Să vedem ce înseamnă asta vizual
Ideea
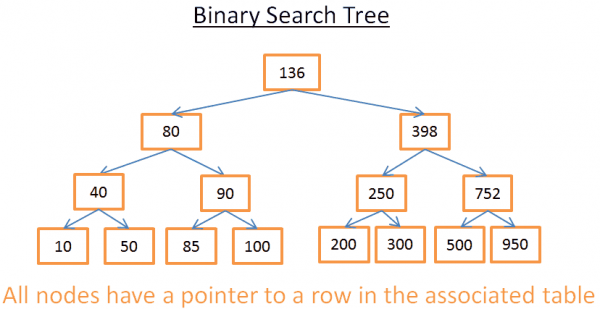
Acest arbore are N = 15 elemente. Să presupunem că caut 208:
- Încep de la rădăcină, a cărei cheie este 136. Deoarece 136 < 208, mă uit la subarborele drept al nodului 136.
- 398 > 208, prin urmare, mă uit la subarborele stâng al nodului 398
- 250 > 208, prin urmare, mă uit la subarborele stâng al nodului 250
- 200 < 208, prin urmare, mă uit la subarborele drept al nodului 200. Dar 200 nu are subarbore drept, valoarea nu există (pentru că, dacă ar exista, ar fi în subarborele drept al lui 200).
Acum, să zicem că caut 40
- Încep de la rădăcină, a cărei cheie este 136. Deoarece 136 > 40, mă uit la subarborele stâng al nodului 136.
- 80 > 40, prin urmare, mă uit la subarborele stâng al nodului 80
- 40= 40, nodul există. Extrageți identificatorul de linie din nod (acesta nu este prezent în desen) și mă uit în tabel pentru identificatorul de linie dat.
- Cunoașterea identificatorului de linie îmi permite să știu exact unde se află datele în tabel și, prin urmare, pot să le obțin instantaneu.
În cele din urmă, ambele căutări îmi vor costa numărul de niveluri din arbore. Dacă citiți cu atenție secțiunea despre sortarea prin îmbinare, ar trebui să observați că aici sunt log(N) niveluri. Așadar, costul căutării este log(N), nu rău!
Întoarcem la problema noastră
Dar acest lucru este foarte abstract, așa că să revenim la problema noastră. În loc de un simplu integer, imaginați-vă un string care reprezintă țara cuiva în tabelul anterior. Să presupunem că aveți un arbore care conține câmpul "country" (coloana 3) din tabel:
- Dacă doriți să știți cine lucrează în Regatul Unit
- mă uitați la arbore pentru a obține nodul care reprezintă Regatul Unit
- în interiorul "UKnode" veți găsi locația înregistrărilor angajaților din Regatul Unit.
Această căutare va costa log(N) operații în loc de N operații dacă folosești direct un array. Ceea ce ai expus mai devreme a fost indexul bazei de date.
Poți construi un arbore index pentru orice grup de câmpuri (string, număr, 2 stringuri, număr și string, dată…) atâta timp cât ai o funcție de comparare a cheilor (adică a grupurilor de câmpuri) astfel încât să poți stabili ordinea între chei (ceea ce este valabil pentru orice tip de bază de date).
B+TreeIndex
Deși acest arbore funcționează bine pentru a obține o valoare specifică, există o PROBLEMĂ MARE atunci când trebuie să obții mai multe elemente între două valori. Aceasta va costa O(N) deoarece va trebui să examinezi fiecare nod din arbore și să verifici dacă se află între aceste două valori (de exemplu, cu o parcurgere ordonată a arborelui). Mai mult, această operațiune nu este convenabilă pentru I/O de disc, deoarece va trebui să citești întregul arbore. Trebuie să găsim o modalitate eficientă de a efectua o interogare pe interval. Pentru a rezolva această problemă, bazele de date moderne folosesc o versiune modificată a arborelui anterior numită B+Tree. În arborele B+Tree:
- numai cele mai joase noduri (frunze) păstrează informația (locația rândurilor în tabelul asociat)
- celelalte noduri sunt aici pentru a ruti către nodul corect în timpul căutării.
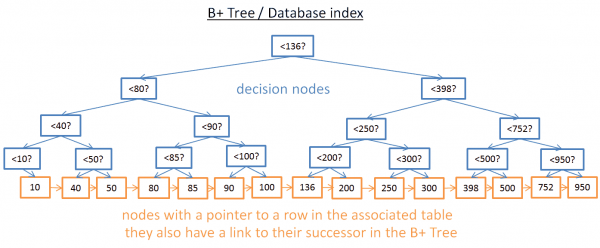
După cum poți observa, aici sunt mai multe noduri (de două ori). De fapt, ai noduri suplimentare, denumite „noduri de decizie”, care te ajută să găsești nodul corect (care păstrează locația rândurilor în tabelul asociat). Dar complexitatea căutării rămâne O(log(N)) (mai este doar un alt nivel). Diferența majoră este că nodurile de la nivelul inferior sunt legate de succesorii lor.
Cu acest B+Tree, dacă cauți valori între 40 și 100:
- Trebuie doar să cauți 40 (sau cea mai apropiată valoare de după 40, dacă 40 nu există), așa cum ai procedat cu arborele anterior.
- Apoi, adună succesorii lui 40, folosind referințele directe la succesorii săi, până ajungi la 100.
Să presupunem că ai găsit M succesori, iar arborele are N noduri. Căutarea unui nod specific costă log(N) la fel ca în arborele anterior. Dar, odată ce ai obținut acest nod, vei obține M succesori în M operații cu referințe la succesorii lor. Această căutare costă doar M+log(N) operațiuni în comparație cu N operațiuni din arborele anterior. Mai mult, nu va trebui să citiți întregul arbore (doar M + log (N) noduri), ceea ce înseamnă o utilizare mai mică a discului. Dacă M este mic (de exemplu, 200 de rânduri) și N este mare (1.000.000 de rânduri), aceasta va face O DIFERENȚĂ MARE.
Dar aici sunt noi probleme (din nou!). Dacă adăugați sau ștergeți un rând din baza de date (și, prin urmare, din indexul asociat B+Tree):
- trebuie să mențineți ordinea între nodurile din arborele B+Tree, altfel nu veți putea găsi nodurile dintr-un arbore nesortat.
- trebuie să păstrați numărul minim posibil de niveluri în B+Tree, în caz contrar complexitatea temporală în O(log(N)) devine O(N).
Cu alte cuvinte, B+Tree trebuie să fie autoordonat și echilibrat. Din fericire, aceasta este posibilă cu operațiuni inteligente de ștergere și inserare. Dar asta costă mult: inserarea și ștergerea în arborele B+ sunt costisitoare în O(log(N)). Iată de ce unii dintre voi ați auzit că utilizarea unui număr prea mare de indecși nu este o idee foarte bună. Într-adevăr, încetiniți inserarea / actualizarea / ștergerea rapidă a unui rând în tabel, deoarece baza de date trebuie să actualizeze indecșii tabelului cu o operațiune costisitoare O(log(N)) pentru fiecare index. Mai mult, adăugarea de indecși înseamnă o încărcare mai mare pentru managerul de tranzacții (va fi descris la sfârșitul articolului).
Pentru informații mai detaliate, puteți consulta articolul de pe Wikipedia despre . Dacă doriți un exemplu de implementare a B+Tree în baza de date, consultați și de la dezvoltatorul principal MySQL. Ambele se concentrează pe modul în care InnoDB (motorul MySQL) gestionează indecșii.
Notă: cititorul mi-a spus că, din cauza optimizărilor la nivel scăzut, arborele B+ trebuie să fie complet echilibrat.
Hashtable (Tabel de dispersie)
Ultima noastră structură de date importantă este tabelul de dispersie. Este foarte util când doriți să căutați rapid valori. Mai mult, înțelegerea tabelului de dispersie ne va ajuta mai târziu să înțelegem operația generală de unire cu baza de date, numită unire prin dispersare ( hash join). Această structură de date este, de asemenea, utilizată de baza de date pentru a stoca anumite lucruri interne (de exemplu, tabel de blocare sau pool de buffer, vom vedea aceste două concepte mai târziu).
Tabelul hash este o structură de date care găsește rapid un element după cheia sa. Pentru a construi un tabel hash, trebuie să definiți:
- cheia pentru elementele dumneavoastră
- funcția hash pentru chei. Hash-urile calculate ale cheilor oferă locația elementelor (numite segmente ).
- funcția pentru compararea cheilor. Odată ce ați găsit segmentul corect, trebuie să căutați elementul dorit în interiorul segmentului, folosind această comparație.
Un exemplu simplu
Să luăm un exemplu vizual:
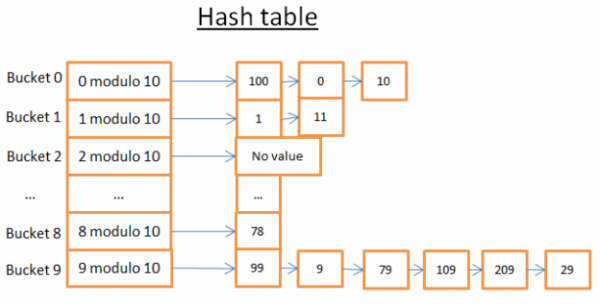
Acest tabel hash are 10 segmente. Deoarece sunt leneș, am reprezentat doar 5 segmente, dar știu că sunteți deștepți, așa că vă las să imaginați celelalte 5 singuri. Am folosit o funcție hash bazată pe modul 10 al cheii. Cu alte cuvinte, păstrez doar cifra finală a cheii elementului pentru a găsi segmentul său:
- dacă cifra finală este 0, elementul ajunge în segmentul 0,
- dacă cifra finală este 1, elementul ajunge în segmentul 1,
- dacă cifra finală este 2, elementul ajunge în segmentul 2,
- …
Funcția de comparare pe care am folosit-o este pur și simplu egalitatea între două numere întregi.
Să presupunem că doriți să obțineți elementul 78:
- Tabelul hash calculează codul hash pentru 78, care este 8.
- Tabelul hash caută în segmentul 8, iar primul element găsit este 78.
- Îți returnează elementul 78
- Căutarea costă doar 2 operații (una pentru calcularea valorii funcției hash și alta pentru căutarea elementului în interiorul segmentului).
Acum, să presupunem că doriți să obțineți elementul 59:
- Tabelul hash calculează codul hash pentru 59, care este 9.
- Tabelul hash caută în segmentul 9, primul element găsit este 99. Deoarece 99!=59, elementul 99 nu este elementul corect.
- Folosind aceeași logică, se ia al doilea element (9), al treilea (79), …, ultimul (29).
- Elementul nu a fost găsit.
- Căutarea a costat 7 operații.
O funcție hash bună
După cum vedeți, în funcție de valoarea pe care o căutați, costul nu este același!
Dacă acum schimb funcția hash bazată pe modul 1.000.000 al cheii (adică, luând ultimele 6 cifre), a doua căutare va costa doar 1 operație, deoarece în segmentul 000059 nu există elemente. Sarcina reală este de a găsi o funcție hash bună care să creeze segmente care conțin un număr foarte mic de elemente..
În exemplul meu, găsirea unei funcții hash bune este ușoară. Dar acesta este un exemplu simplu; găsirea unei funcții hash bune devine mai complicată atunci când cheia:
- string (de exemplu - numele de familie)
- 2 strings (de exemplu - numele de familie și prenumele)
- 2 stringuri și o dată (de exemplu - numele de familie, prenumele și data nașterii)
- …
Cu o funcție hash bună, căutarea în tabela hash se face în O(1).
Matrice vs tabel hash
De ce să nu folosești o matrice?
Hm, o întrebare bună.
- Un tabel hash poate fi parțial încărcat în memorie, iar restul segmentelor pot rămâne pe disc.
- Cu o matrice, trebuie să folosești un spațiu continuu în memorie. Dacă încarci o tabelă mare este foarte complicat să găsești suficient spațiu continuu.
- Pentru un tabel hash, poți selecta cheia dorită (de exemplu, țara și numele de familie al persoanei).
Pentru informații suplimentare, poți citi articolul despre , care este o implementare eficientă a tabelului hash; nu trebuie să înțelegi Java pentru a înțelege conceptele prezentate în acest articol.
Sursa: habr.com
