

Acest articol este scris pentru a ajuta cititorul să aleagă soluția potrivită și să înțeleagă diferențele dintre diversele SDS, cum ar fi Gluster, Ceph și Vstorage (Virtuozzo).
În text se folosesc linkuri către articole cu o expunere mai detaliată a anumitor probleme, așa că descrierile vor fi cât mai concise, folosind doar punctele cheie, fără informații inutile și introductive pe care le puteți descoperi pe cont propriu în spațiul online.
De fapt, subiectele abordate necesită un ton specific al textului, dar în lumea modernă tot mai mulți oameni nu doresc să citească mult))), așa că poate fi citit pe scurt pentru a face o alegere, iar dacă e ceva neclar, pot fi explorate linkurile sau căutate cuvintele necunoscute))), iar acest articol este ca o acoperire transparentă pentru aceste subiecte profunde, arătând conținutul – principalele puncte cheie ale fiecărei soluții.
Gluster
Începem cu Gluster, care este folosit intens de către producătorii de platforme hiperconvergente cu SDS bazate pe open source pentru medii virtuale, și poate fi găsit pe site-ul RedHat la secțiunea storage, unde se oferă două opțiuni SDS: Gluster sau Ceph.
Gluster constă dintr-un cadru de traducători – servicii care gestionează toate sarcinile de distribuire a fișierelor etc. Brick – serviciul care deserveste un disc, Volume – volum (pool) – care împreună aceste brick-uri. Apoi urmează un serviciu de distribuire a fișierelor în grupuri prin funcția DHT (tabel de hash distribuit). Nu vom include serviciul de Sharding în descriere, deoarece în linkurile de mai jos va fi prezentată descrierea problemelor legate de acesta.
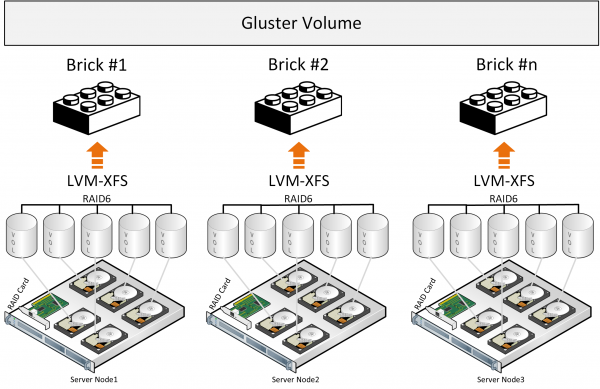
La scriere, fișierul este stocat integral în brick și o copie a acestuia este scrisă în paralel pe brick-ul de pe serverul secundar. Ulterior, un al doilea fișier va fi scris în a doua grupare din două brick-uri (sau mai multe) de pe servere diferite.
Dacă fișierele au dimensiuni aproximativ egale și volumul va consta doar dintr-un singur grup, totul este în regulă, însă în alte condiții, descrierile vor evidenția următoarele probleme:
- spațiul în grupuri este folosit inegal, ceea ce depinde de dimensiunile fișierelor, iar dacă într-un grup nu există suficient loc pentru a scrie fișierul – veți obține o eroare, fișierul nu va fi scris și nu va fi redistribuit în alt grup;
- în timpul scrierii unui fișier, IO se desfășoară doar pe un singur grup, celelalte stând inactive;
- nu se poate obține IO pentru întregul volum în timpul scrierii unui fișier;
- și concepția generală pare mai puțin performantă din cauza lipsei distribuirii datelor pe blocuri, unde este mai simplu să se realizeze un echilibru și să se rezolve problema distribuirii uniforme, în loc de cum este acum, fișierul se plasează în brich integral.
Din descrierea oficială se creează involuntar înțelegerea că Gluster funcționează ca un stocare de fișiere deasupra unui RAID hardware clasic. Au existat încercări de a dezvolta fracturarea (Sharding) fișierelor în blocuri, dar totul este un supliment care impune pierderi de performanță la deja existentul abordare arhitecturală, plus utilizarea unor componente liber distribuite cu limitări în performanță precum Fuse. Nu există servicii de metadate, ceea ce limitează capacitățile de performanță și reziliență a stocării la distribuirea fișierelor pe blocuri. Poate fi observată o performanță mai bună în configurația „Distributed Replicated” și numărul de noduri trebuie să fie de cel puțin 6 pentru a organiza o replicare fiabilă 3 cu o distribuție optimă a sarcinii.
Aceste concluzii sunt de asemenea legate de descrierea experienței utilizării și la compararea cu , precum și este o descriere a experienței în a ajunge la o înțelegere a acestei configurații mai performante și mai fiabile
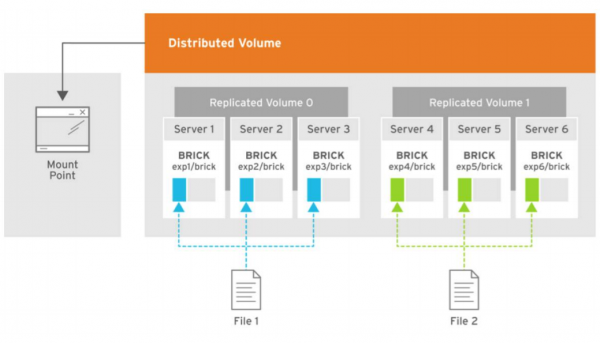
În imagine este prezentată distribuția sarcinii la scrierea a două fișiere, unde copiile primului fișier sunt distribuite pe primele trei servere, care sunt grupate în grupul volume 0, iar trei copii ale celui de-al doilea fișier se plasează în al doilea grup volume 1 din trei servere. Fiecare server are un disc.
Concluzia generală este că Gluster poate fi utilizat, dar cu înțelegerea că vor exista limitări în performanță și reziliență, care creează dificultăți în anumite condiții ale soluției hiperconvergente, unde resursele sunt necesare și pentru sarcini de calcul în medii virtuale.
Există de asemenea anumite cifre de performanță ale Gluster care pot fi obținute în anumite condiții, limitându-se în
Ceph
Acum să analizăm Ceph din descrierile arhitecturii pe care am reușit De asemenea, există o comparație între , unde se poate înțelege imediat că Ceph este recomandat să fie desfășurat pe servere separate, deoarece serviciile sale necesită toate resursele hardware în condiții de sarcină.
Arhitectură mai complicat decât Gluster și există servicii precum serviciile de metadate, dar întregul set de componente este destul de complex și nu foarte flexibil pentru utilizarea sa într-o soluție de virtualizare. Datele sunt organizate în blocuri, ceea ce pare mai performant, dar există, în ierarhia tuturor serviciilor (componentelor), pierderi și latență în condiții de încărcare și de urgență, de exemplu următoarea
Din descrierea arhitecturii, inima este CRUSH, care determină locul de stocare a datelor. Următoarea este PG – o abstracție destul de complexă (grup logic) de înțeles. PG-urile sunt necesare pentru a face CRUSH mai eficient. Scopul principal al PG-urilor este gruparea obiectelor pentru a reduce consumul de resurse, a îmbunătăți performanța și scalabilitatea. Addrisi obiectele direct, individual, fără a le grupa în PG ar fi foarte costisitor. OSD este serviciul pentru fiecare disc individual.
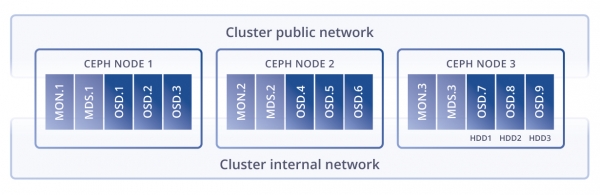
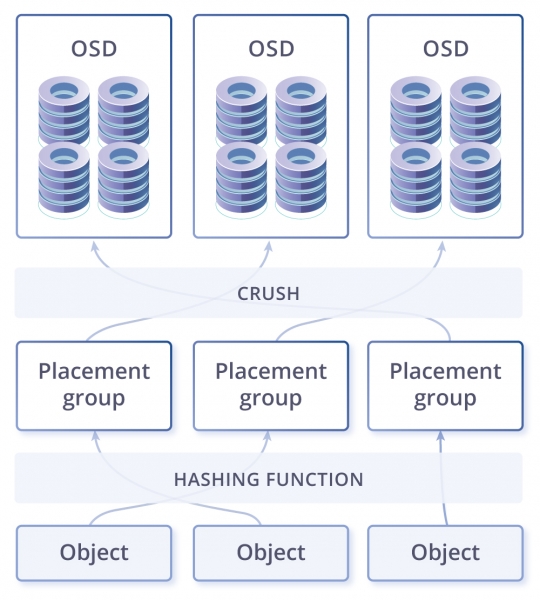
Un cluster poate avea unul sau mai multe pool-uri de date cu scopuri diferite și cu setări diferite. Pool-urile sunt împărțite în grupuri de plasare. Grupurile de plasare stochează obiectele la care clienții se adresează. Această nivel logic se încheie și începe cel fizic, deoarece fiecare grup de plasare este asociat cu un disc principal și mai multe discuri-replici (câte exact depinde de factorul de replicare al pool-ului). Cu alte cuvinte, la nivel logic, un obiect este stocat într-un anumit grup de plasare, iar la nivel fizic – pe discurile asociate. În același timp, discurile pot fi localizate fizic pe noduri diferite sau chiar în centre de date diferite.
În acest sistem, grupurile de plasare par a fi un nivel necesar pentru flexibilitatea întregii soluții, dar în același timp și un veriga suplimentară în această lanț, ceea ce inevitabil duce la gânduri despre pierderi de performanță. De exemplu, atunci când scrie date, sistemul trebuie să le împartă în aceste grupuri și apoi la nivel fizic pe discul principal și pe discurile pentru replicare. Asta înseamnă că funcția hash funcționează la căutarea și inserarea unui obiect, dar există un efect secundar – costuri foarte mari și limitări pe reconstruirea hash-ului (când se adaugă sau se elimină un disc). O altă problemă a hash-ului este plasarea strictă a datelor, care nu poate fi schimbată. Deci, dacă un disc se confruntă cu o sarcină crescută, sistemul nu are posibilitatea de a nu scrie pe el (alegând un alt disc), funcția hash obligă plasarea datelor conform unei reguli, indiferent de cât de rău este pentru disc, astfel încât Ceph consumă multă memorie la reconstruirea PG în cazul de auto-repair sau extinderea stocării. Concluzia este că Ceph funcționează bine (chiar dacă lent), dar doar când nu sunt scalări, situații de urgență sau actualizări.
Există, desigur, opțiuni pentru îmbunătățirea performanței prin intermediul caching-ului și tiering-ului de cache, dar pentru asta este necesar un hardware bun și tot vor exista pierderi. Dar, în ansamblu, Ceph pare mai atrăgător decât Gluster pentru producție. De asemenea, utilizarea acestor produse necesită un factor important – un nivel ridicat de competențe, experiență și profesionalism, cu un accent puternic pe Linux, deoarece este foarte important să fie implementat, configurat și întreținut corect, ceea ce impune și mai multe responsabilități și presiuni asupra administratorului.
Vstorage
Arhitectura devine și mai interesantă în cazul , care poate fi utilizată împreună cu hipervizorul pe aceleași noduri, pe același , dar este foarte important să fie configurat corect pentru a obține o performanță bună. Așadar, implementând un astfel de produs din cutie pe o configurație oarecare, fără a ține cont de recomandările conform arhitecturii, va fi foarte ușor, dar nu eficient.
Ce poate coexista cu serviciile hipervizorului kvm-qemu sunt doar câteva servicii, unde se găsește o ierarhie optimizată compactă de componente: serviciul clientului montat prin FUSE (modificat, nu open source), serviciul de metadate MDS (Metadata service), serviciul de blocuri de date Chunk service, care la nivel fizic echivalează cu un singur disc și cam atât. Desigur, pentru viteză, este optim să folosești o schemă de toleranță la eșec în două replici, dar dacă apelez la caching și jurnale pe discuri SSD, atunci codificarea rezistentă la erori (erase coding sau raid6) poate fi accelerată bine pe o schemă hibridă sau chiar mai bine pe all flash. Cu EC (erase coding) există un dezavantaj: la modificarea unui bloc de date, este necesar să se recalculeze sumele de paritate. Pentru a evita pierderile în această operațiune, Ceph scrie în EC în mod întârziat și pot apărea probleme de performanță la anumite cereri, când, de exemplu, este nevoie să se calculeze toate blocurile, iar în cazul cu Virtuozzo Storage, scrierea blocurilor modificate se face folosind abordarea „sistem de fișiere structurat pe jurnal”, ceea ce minimizează costurile de calcul al parității. Pentru a aproxima opțiunile cu accelerarea muncii cu EC și fără, există – cifrele pot fi approximate, depind de coeficientul de precizie al producătorului echipamentului, dar rezultatul calculelor ajută foarte bine la planificarea configurației.
O schemă simplă a componentelor de stocare nu înseamnă că aceste componente nu consumă dar dacă socotești toate cheltuielile din timp, atunci poți conta pe colaborarea de lângă hipervizor.
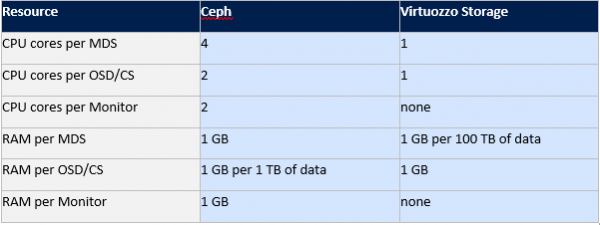
Există o schemă de comparație a consumului de resurse hardware de către serviciile Ceph și Virtuozzo storage.
Dacă anterior puteai compara Gluster și Ceph pe baza articolelor vechi, folosind cele mai importante pasaje din ele, cu Virtuozzo este mai complicat. Articole despre acest produs nu sunt foarte multe și informațiile pot fi extrase doar din documentația pe sau în limba rusă, având în vedere că Vstorage este utilizat în unele soluții hiperconvergente în companii precum și Acronis.
Voi încerca să ajut cu descrierea acestei arhitecturi, de aceea textul va fi puțin mai lung, dar pentru a înțelege documentația este nevoie de mult timp, iar documentația existentă poate fi folosită doar ca un ghid prin revizuirea cuprinsului sau căutarea după cuvânt cheie.
Să considerăm procesul de scriere într-o configurație hibridă de hardware cu componentele descrise mai sus: scrierea începe pe acel nod de la care a fost inițiată de client (serviciul punctului de montare FUSE), dar componenta master a serviciului de metadate (MDS) va direcționa desigur clientul direct către serviciul de chunk necesar (serviciul de stocare a blocurilor CS), ceea ce înseamnă că MDS nu participă la procesul de scriere, ci pur și simplu direcționează către serviciul de chunk necesar. În general, se poate aduce o analogie a scrierii cu turnarea apei în butoaie. Fiecare butoi reprezintă un bloc de date de 256MB.
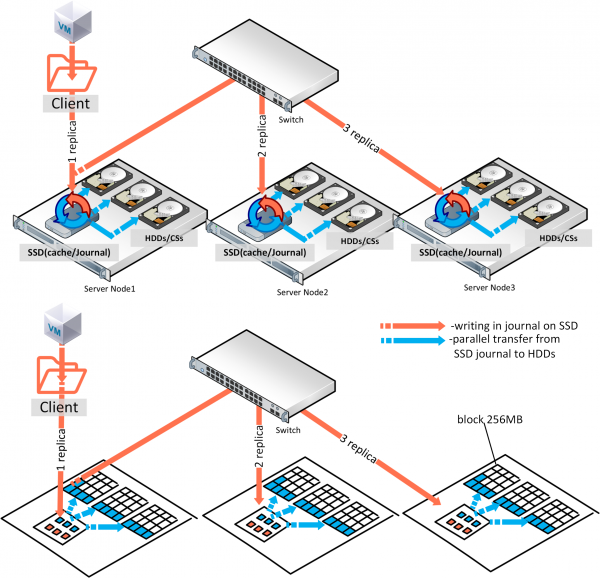
Așadar, un disc reprezintă o anumită cantitate de astfel de butoaie, adică volumul discului împărțit la 256MB. Fiecare copie se toarnă pe un nod, iar a doua aproape simultan pe un alt nod etc. Dacă avem trei replici și avem discuri SSD pentru cache (pentru citire și jurnalele de scriere), confirmarea scrierii va avea loc după scrierea jurnalului în SSD, iar descărcarea paralelă din SSD va continua pe HDD, într-un fel de mod în fundal. În cazul celor trei replici, confirmarea scrierii va fi după confirmarea din partea SSD-ului de pe al treilea nod. Ar putea părea că suma vitezei de scriere a celor trei SSD-uri poate fi împărțită la trei și vom obține viteza de scriere a unei replici, dar scrierea copiilor se desfășoară în paralel, iar latenta rețelei este de obicei mai mare decât cea a SSD-urilor, iar, în esență, performanța scrierii va depinde de rețea. Din această cauză, pentru a observa IOPS reale este necesar să se încarce corect întreg Vstorage după , adică să se testeze o încărcare reală, nu doar memoria și cache-ul, unde trebuie să se ia în considerare dimensiunea corectă a blocului de date, numărul de fire și așa mai departe.
Jurnalul de înregistrare menționat mai sus pe SSD funcționează astfel: de îndată ce datele ajung în el, sunt citite imediat de serviciu și scrise pe HDD. Există mai multe servicii de metadate (MDS) pe cluster, iar numărul acestora este determinat de cvorum, care funcționează conform algoritmului Paxos. Din perspectiva clientului, punctul de montare FUSE este un folder al stocării clusterului, care este vizibil simultan pentru toate nodurile clusterului, fiecare nod având un client montat pe acest principiu, astfel încât fiecare nod are acces la această stocare.
Pentru performanța oricăruia dintre abordările menționate mai sus, este foarte important, în etapa de planificare și desfășurare, să se configureze corect rețeaua, unde va exista un echilibru datorat agregării și o lățime de bandă a canalului de rețea bine aleasă. În agregare, este important să se aleagă corect modul de hashing și dimensiunile cadrelor. De asemenea, există o diferență semnificativă față de SDS-urile menționate anterior, aceasta fiind fuse cu tehnologia fast path în Virtuozzo Storage. Aceasta, pe lângă fuse-urile modernizate, spre deosebire de celelalte soluții open source, adaugă semnificativ IOPS-uri și permite să nu te limitezi la scalarea orizontală sau verticală. În general, comparativ cu arhitecturile menționate mai sus, aceasta pare a fi mai puternică, dar pentru acest avantaj este necesar să achiziționezi licențe, spre deosebire de Ceph și Gluster.
În concluzie, putem sublinia clasamentul top trei: prima poziție în ceea ce privește performanța și fiabilitatea arhitecturii este ocupată de Virtuozzo Storage, a doua de Ceph și a treia de Gluster.
Criteriile pentru alegerea Virtuozzo Storage sunt: un set optim de componente arhitecturale, fuse modernizat sub acest principiu cu fast path, un set flexibil de configurație hardware, un consum mai mic de resurse și posibilitatea de a fi utilizat împreună cu compute (calculări/virtualizare), deci este complet potrivit pentru o soluție hiperconvergentă, din cadrul căreia face parte. A doua poziție este ocupată de Ceph, deoarece este o arhitectură mai performantă decât Gluster, datorită operării pe blocuri, precum și a scenariilor mai flexibile și a posibilității de a funcționa în clustere de dimensiuni mai mari.
În planuri există dorința de a scrie o comparație între vSAN, Space Direct Storage, Vstorage și Nutanix Storage, testarea Vstorage pe echipamente HPE, Huawei, precum și scenarii de integrare a Vstorage cu sisteme externe de stocare hardware, așa că, dacă articolul v-a plăcut, ar fi bine să primim feedback de la voi, care ar putea întări motivația pentru noi articole ținând cont de observațiile și dorințele voastre.
Sursa: habr.com
