

Introducere
Așa s-a întâmplat că la locul meu de muncă actual am fost nevoit să mă familiarizez cu această tehnologie. Voi începe cu o mică introducere. La o întâlnire recentă, echipa noastră a fost informată că trebuie să creăm o integrare cu o sistem cunoscut. Prin integrare se înțelegea că acest sistem cunoscut ne va trimite cereri prin HTTP pe un anumit endpoint, iar noi, ciudat dar adevărat, vom trimite înapoi răspunsuri sub formă de mesaje SOAP. Pare totul simplu și trivial. Din aceasta rezultă că trebuie...
Sarcină
Să creăm 3 servicii. Primul dintre ele — Serviciul de actualizare a bazei de date. Acest serviciu, atunci când primește date noi dintr-un sistem extern, actualizează datele în baza de date și generează un fișier în format CSV, pentru a-l trimite sistemului următor. Se apelează endpoint-ul celui de-al doilea serviciu — Serviciul de transport prin FTP, care primește fișierul trimis, îl validează și îl stochează în spațiul de fișiere prin FTP. Al treilea serviciu — Serviciul de transmitere a datelor către consumator, funcționează asincron cu primele două. Acesta primește o cerere din partea unui sistem extern, pentru a obține fișierul despre care s-a vorbit mai sus, ia fișierul de răspuns gata, îl modifică (actualizează câmpurile id, description, linkToFile) și trimite un răspuns sub formă de mesaj SOAP. Așadar, pe scurt, imaginea este următoarea: primele două servicii își încep activitatea doar atunci când au venit date pentru actualizare. Al treilea serviciu funcționează constant, deoarece există mulți consumatori de informații, aproximativ 1000 de cereri pentru a obține date pe minut. Serviciile sunt disponibile tot timpul și instanțele lor sunt plasate în medii diferite, cum ar fi test, demo, preprod și prod. Mai jos este prezentată schema de funcționare a acestor servicii. Voi explica imediat că unele detalii au fost simplificate pentru a evita complexitatea excesivă.
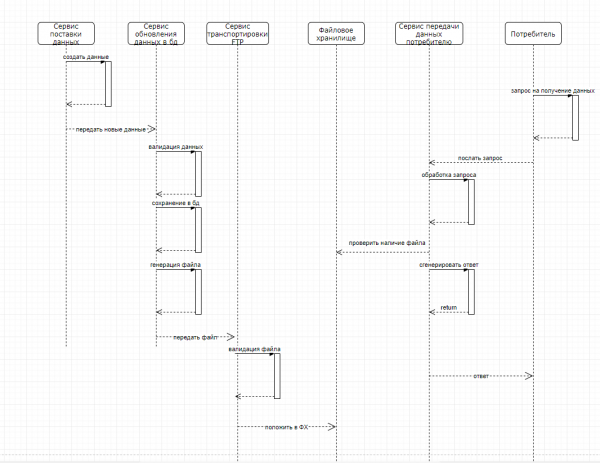
Întreprindere tehnică
În planificarea soluției, am decis mai întâi să dezvoltăm aplicații pe Java, folosind frameworkul Spring, cu un balancer Nginx, o bază de date Postgres și alte tehnologii variate. Având în vedere că timpul alocat dezvoltării soluției tehnice permitea explorarea altor abordări pentru această sarcină, ne-am îndreptat atenția către tehnologia modernă Apache NIFI, populară în anumite cercuri. Voi menționa că această tehnologie ne-a ajutat să identificăm cele 3 servicii. În acest articol, va fi descrisă dezvoltarea serviciului de transport al fișierului și a serviciului de livrare a datelor către consumatori; totuși, dacă articolul va avea succes, voi scrie și despre serviciul de actualizare a datelor în baza de date.
Ce este asta
NIFI este o arhitectură distribuită pentru încărcarea rapidă și procesarea datelor în paralel, având un număr mare de pluginuri pentru surse și transformări, versionarea configurațiilor și multe altele. Un avantaj plăcut este că este foarte ușor de utilizat. Procesele triviale, cum ar fi getFile, sendHttpRequest și altele, pot fi reprezentate sub formă de pătrate. Fiecare pătrat reprezintă un anumit proces, al cărui interacțiune poate fi observată în imaginea de mai jos. Documentația detaliată despre interacțiunea și configurarea proceselor este scrisă , pentru cei care vorbesc rusă — . Documentația explică excelent cum să dezarhivezi și să pornești NIFI, precum și cum să creezi procese, adică pătratele
Ideea de a scrie acest articol s-a născut după o căutare îndelungată și structurarea informațiilor obținute într-o formă coerentă, precum și dorința de a ușura puțin viața dezvoltatorilor viitori.
Exemplu
Un exemplu de interacțiune între modulele de tip pătrat a fost discutat. Schema generală este destul de simplă: primim o solicitare HTTP (teoretic cu un fișier în corpul cererii. Pentru a demonstra capabilitățile NIFI, în acest exemplu, cererea inițiază un proces de obținere a fișierului din FS local), apoi trimitem un răspuns de confirmare că cererea a fost primită, iar în paralel se demarează procesul de obținere a fișierului din FS și ulterior procesul de mutare a acestuia prin FTP în FS. Este important de menționat că procesele interacționează între ele prin intermediul așa-numitului flowFile. Aceasta este baza entității în NIFI, care stochează atributele și conținutul. Conținutul reprezintă datele care sunt prezentate sub formă de fișier de flux. Cu alte cuvinte, dacă ați obținut un fișier dintr-un mod pătrat și îl transferați într-altul, conținutul va fi fișierul dumneavoastră.
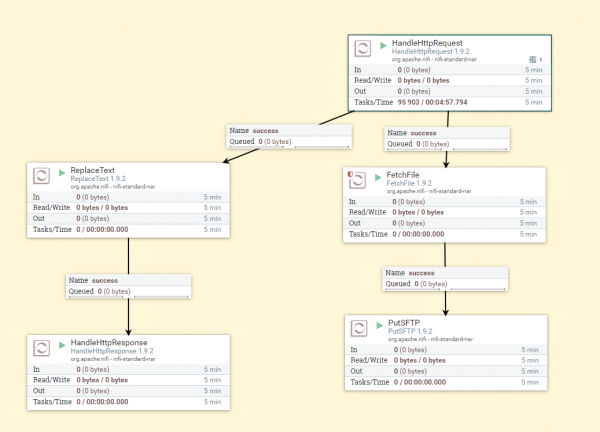
După cum puteți observa, această imagine ilustrează procesul general. HandleHttpRequest - primește cererile, ReplaceText - generează corpul răspunsului, HandleHttpResponse - returnează răspunsul. FetchFile - obține fișierul din stocarea de fișiere și îl transferă modulului PutSftp - care plasează acest fișier pe FTP, la adresa specificată. Acum, să discutăm mai în detaliu despre acest proces.
În acest caz, request-ul reprezintă punctul de plecare. Să examinăm parametrii săi de configurare.
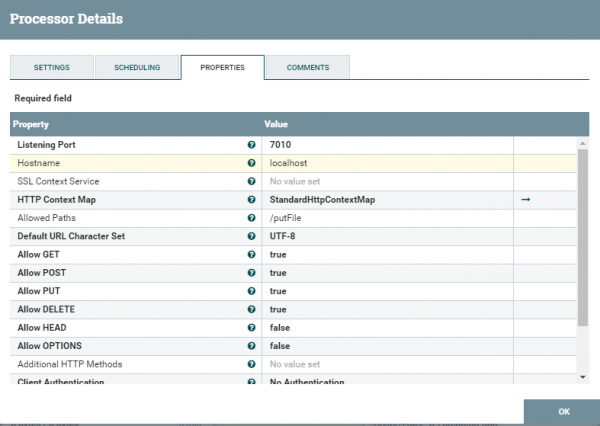
Aici totul este destul de simplu, cu excepția StandartHttpContextMap - este un serviciu care permite trimiterea și primirea cererilor. Mai multe detalii și exemple pot fi vizualizate aici -
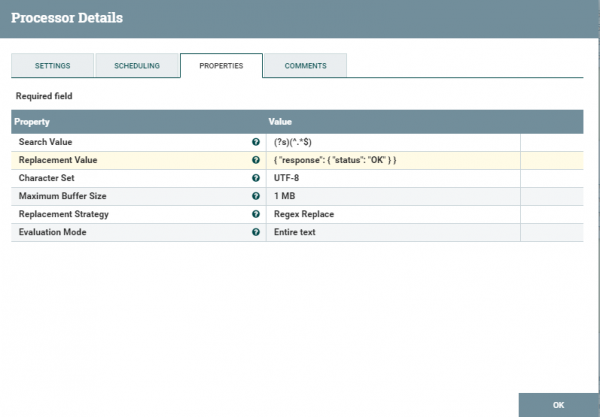
În continuare, să examinăm parametrii de configurare ai modulului ReplaceText. Este important să ne concentrăm asupra ReplacementValue - acesta este ceea ce va reveni utilizatorului sub formă de răspuns. În settings, se poate ajusta nivelul de logging, iar logurile pot fi consultate {unde am desfășurat nifi}/nifi-1.9.2/logs, acolo există și parametrii failure/success - bazându-ne pe acești parametri, putem controla procesul în ansamblu. Adică, în cazul în care procesarea textului a fost de succes, se va iniția procesul de trimitere a răspunsului utilizatorului, iar în caz contrar, vom înregistra doar un proces eșuat.
În proprietățile HandleHttpResponse, nu există nimic special de menționat, în afară de statusul la crearea cu succes a răspunsului.
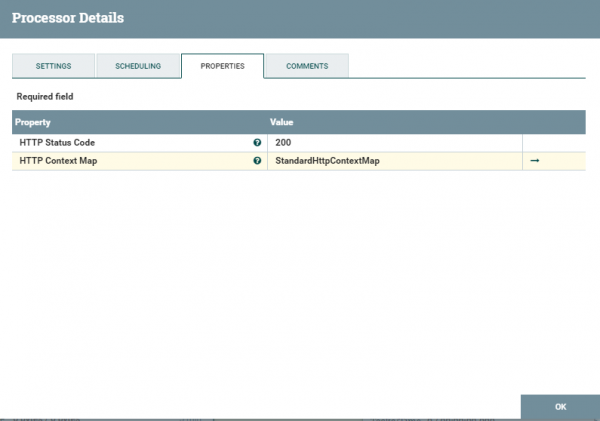
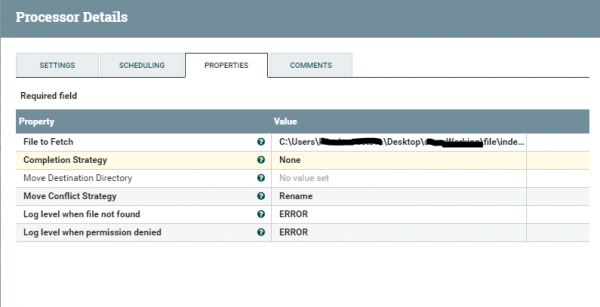
Am discutat despre cereri și răspunsuri - să trecem mai departe la obținerea fișierului și plasarea acestuia pe serverul FTP. FetchFile - obține fișierul de la calea specificată în setări și îl trimite la procesul următor.
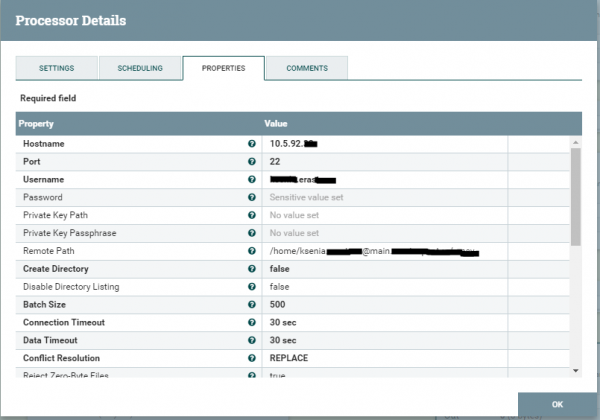
Și apoi, pătratul PutSftp - plasează fișierul în stocarea de fișiere. Parametrii de configurare îi putem vedea mai jos.
Este important de menționat că fiecare pătrat reprezintă un proces distinct, care trebuie să fie inițiat. Am discutat despre cel mai simplu exemplu, care nu necesită personalizări complexe. În continuare, vom analiza un proces puțin mai complicat, unde vom scrie puțin pe groovy.
Un exemplu mai complex
Serviciul de transfer de date către consumator s-a dovedit a fi puțin mai complicat datorită procesului de modificare a mesajelor SOAP. Procesul general este ilustrat în figura de mai jos.
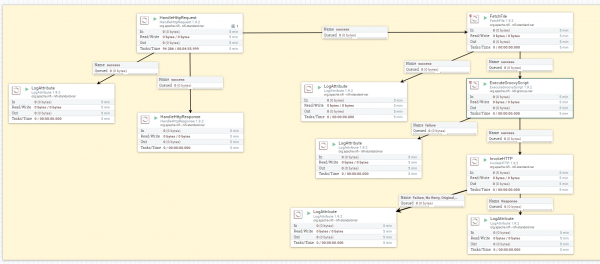
Aici, ideea nu este foarte complicată: am primit o solicitare de la consumator, care avea nevoie de date, am trimis un răspuns că am primit mesajul, am inițiat procesul de obținere a fișierului răspuns, apoi l-am editat conform unei logici specifice, după care am transmis fișierul consumatorului sub forma unui mesaj SOAP pe server.
Cred că nu are sens să descriem din nou pătratele pe care le-am văzut mai sus - să trecem direct la altele noi. Dacă este necesar să editați un fișier și pătratele obișnuite, cum ar fi ReplaceText, nu se potrivesc, va trebui să scrieți propriul script. Acest lucru se poate face folosind pătratul ExecuteGroogyScript. Setările sale sunt prezentate mai jos.
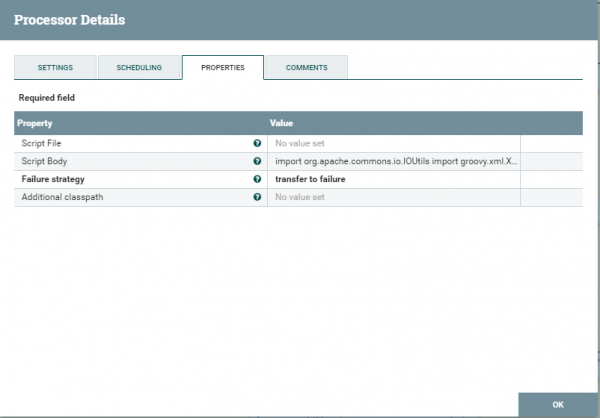
Există două opțiuni pentru încărcarea scriptului în acest bloc. Prima este prin încărcarea fișierului cu scriptul. A doua este prin inserarea scriptului în scriptBody. Din câte știu, blocul executeScript suportă mai multe limbaje de programare — unul dintre ele este groovy. Îi voi dezamăgi pe dezvoltatorii Java — nu se pot scrie scripturi în astfel de blocuri folosind Java. Pentru cei care își doresc foarte mult — trebuie să creați un bloc personalizat și să-l introduceți în sistemul NIFI. Întreaga operațiune vine cu niște dansuri elaborate pe care nu le vom aborda în cadrul acestui articol. Am ales limbajul groovy. Mai jos este un script de test care pur și simplu actualizează incremental id-ul din mesajul SOAP. Este important de menționat că luați fișierul din flowFile, îl actualizați, fără a uita că trebuie să-l puneți înapoi, actualizat. De asemenea, merită menționat că nu toate bibliotecile sunt conectate. Este posibil să trebuiască să importați una dintre biblioteci. O altă problemă este că scriptul din acest bloc este destul de greu de debitat. Există o modalitate de a te conecta la JVM NIFI și de a începe procesul de depanare. Personal, am rulat o aplicație locală și am simulat obținerea fișierului din sesiune. Am făcut și depanare local. Erorile care apar la încărcarea scriptului sunt destul de ușor de căutat pe Google și sunt scrise de însuși NIFI în jurnal.
import org.apache.commons.io.IOUtils
import groovy.xml.XmlUtil
import java.nio.charset.*
import groovy.xml.StreamingMarkupBuilder

def flowFile = session.get()
if (!flowFile) return
try {
    flowFile = session.write(flowFile, { inputStream, outputStream ->
        String result = IOUtils.toString(inputStream, "UTF-8");
        def recordIn = new XmlSlurper().parseText(result)
        def element = recordIn.depthFirst().find {
            it.name() == 'id'
        }

        def newId = Integer.parseInt(element.toString()) + 1
        def recordOut = new XmlSlurper().parseText(result)
        recordOut.Body.ClientMessage.RequestMessage.RequestContent.content.MessagePrimaryContent.ResponseBody.id = newId

        def res = new StreamingMarkupBuilder().bind { mkp.yield recordOut }.toString()
        outputStream.write(res.getBytes(StandardCharsets.UTF_8))
} as StreamCallback)
     session.transfer(flowFile, REL_SUCCESS)
}
catch(Exception e) {
    log.error("Error during processing of validate.groovy", e)
    session.transfer(flowFile, REL_FAILURE)
}
Practic, aici se încheie personalizarea blocului. Ulterior, fișierul actualizat este transmis către un bloc care se ocupă cu trimiterea fișierului pe server. Mai jos sunt prezentate setările acestui bloc.
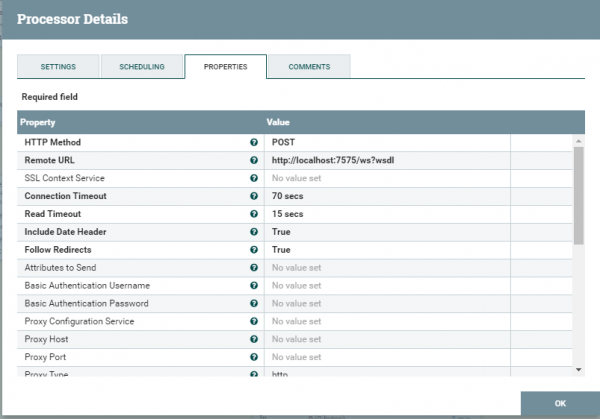
Descriem metoda prin care va fi transmis mesajul SOAP. Specificăm unde. Apoi, trebuie să indicăm că este vorba despre un mesaj SOAP.
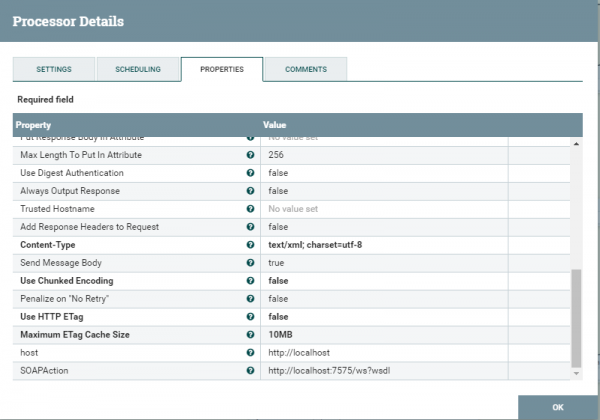
Adăugăm câteva proprietăți precum host și action (soapAction). Salvăm, verificăm. Mai multe detalii despre cum să trimitem cereri SOAP pot fi găsite
Am analizat câteva scenarii de utilizare a proceselor NIFI. Cum interacționează și care este beneficiul real al acestora. Exemplele discutate sunt de test și se diferențiază puțin de ceea ce se întâlnește în producție. Sper că acest articol va fi puțin util dezvoltatorilor. Mulțumesc pentru atenție. Dacă aveți întrebări, nu ezitați să scrieți. Voi încerca să răspund.
Sursa: habr.com
