

În fața ta se află din nou o sarcină de detectare a obiectelor. Prioritatea este viteza de lucru cu o acuratețe acceptabilă. Ia arhitectura YOLOv3 și ajustează-o. Acuratețea (mAp75) trebuie să fie peste 0.95. Dar viteza de rulare este încă scăzută. Drace.
Astăzi vom ocoli cuantizarea. Iar sub titlu vom analiza Model Pruning — tăierea părților redundante ale rețelei pentru a accelera Inferența fără a pierde acuratețea. Vizual — de unde, cât și cum se poate tăia. Vom discuta despre cum să facem acest lucru manual și unde se poate automatiza. La final — un repository pe keras.
Introducere
La fostul meu loc de muncă, Macroscop din Perm, am dobândit o obicei — să urmăresc întotdeauna timpul de execuție al algoritmilor. Iar timpul de rulare al rețelelor trebuie verificat întotdeauna printr-un filtru de adecvare. De obicei, soluțiile de vârf nu trec acest filtru, ceea ce m-a dus la Pruning.
Pruning-ul este o temă veche despre care s-a vorbit la în 2017. Ideea principală este reducerea dimensiunii rețelei antrenate fără a pierde acuratețea prin eliminarea diferitelor noduri. Sună grozav, dar rar aud de aplicarea sa. Probabil că lipsește implementările, nu există articole în limba română sau pur și simplu toată lumea crede că pruning-ul este un know-how și tace.
Dar hai să discutăm despre
O privire în biologie
Îmi place când în Deep Learning apar idei din biologie. Lor, ca și evoluției, le putem acorda încredere (știai că ReLU este foarte similară cu ?)
Procesul de Model Pruning este de asemenea apropiat de biologie. Reacția rețelei poate fi comparată cu plasticitatea creierului. Există câteva exemple interesante în cartea :
- Creierul unei femei care a avut de la naștere doar o jumătate s-a reprogramat singur pentru a îndeplini funcțiile jumătății lipsă.
- Un băiat și-a împușcat o parte din creier care răspundea la vedere. În timp, alte părți ale creierului au preluat aceste funcții. (nu ne străduim să repetăm)
Astfel, din modelul tău se pot tăia părți din convoluțiile slabe. În cel mai rău caz, convoluțiile rămase vor ajuta la înlocuirea celor tăiate.
Îți place Transfer Learning sau înveți de la zero?
Varianta numărul unu. Folosești Transfer Learning cu Yolov3, Retina, Mask-RCNN sau U-Net. Dar, cel mai adesea, nu trebuie să recunoaștem 80 de clase de obiecte, ca în COCO. În practica mea, ne limităm la 1-2 clase. Se poate presupune că arhitectura pentru 80 de clase este excesivă. Se conturează ideea că trebuie să micșorăm arhitectura. Însă, ne-ar plăcea să facem asta fără a pierde greutățile pre-antrenate existente.
Varianta numărul doi. Poate ai multe date și resurse de calcul sau pur și simplu ai nevoie de o arhitectură super personalizată. Nu contează. Dar înveți rețeaua de la zero. Ordinea obișnuită este să ne uităm la structura datelor, să alegem o arhitectură EXCESIVĂ ca putere și să acoperim dropout-urile pentru a evita supraînvățarea. Am văzut dropout-uri de 0.6, Karl.
În ambele cazuri, rețeaua poate fi micșorată. Ne-am motivat. Acum mergem să înțelegem ce înseamnă tăierea (pruning).
Algoritmul general
Am decis că putem elimina convoluțiile. Pare destul de simplu:
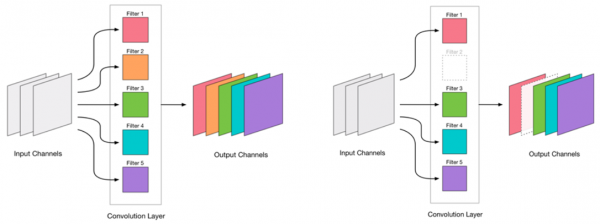
Eliminarea oricărei convoluții este un stres pentru rețea, care de obicei duce la o creștere a erorii. Pe de o parte, această creștere a erorii este un indicator al cât de corect eliminăm convoluțiile (de exemplu, o creștere mare sugerează că facem ceva greșit). Dar o mică creștere este acceptabilă și de multe ori este eliminată printr-un mic reantrenament cu un LR scăzut. Adăugăm un pas de reantrenare:
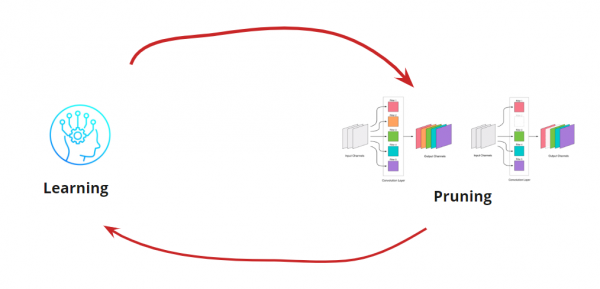
Acum trebuie să înțelegem când vrem să oprim ciclul nostru de ÎnvățareTăiere. Aici pot exista variante exotice, când trebuie să micșorăm rețeaua la o dimensiune și o viteză de procesare specifică (de exemplu, pentru dispozitive mobile). Cu toate acestea, cea mai frecventă variantă este continuarea ciclului până când eroarea depășește o limită acceptabilă. Adăugăm o condiție:
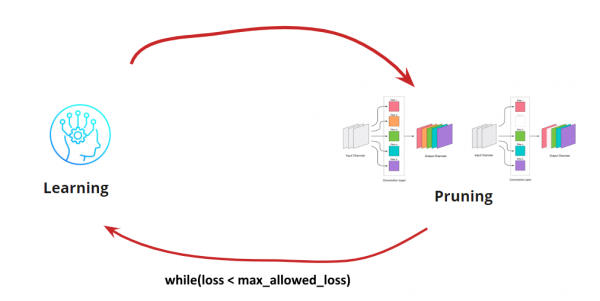
Așadar, algoritmul devine clar. Rămâne să analizăm cum să determinăm convoluțiile care trebuie eliminate.
Căutarea convoluțiilor care pot fi eliminate.
Trebuie să eliminăm unele convoluții. A încerca să „spargi” orice — este o idee proastă, chiar dacă va funcționa. Dar, având mintea, putem gândi și încerca să selectăm convoluțiile „slabe” pentru eliminare. Există mai multe opțiuni:
- . Ideea este că convoluțiile cu valori mici ale greutăților contribuie puțin la decizia finală.
- Cea mai mică măsură L1 având în vedere media și deviația standard. Completăm cu evaluarea caracterului distribuției.
- . O definiție mai exactă a convoluțiilor insignifiante, dar care necesită mult timp și resurse.
- Altele
Fiecare opțiune are dreptul la viață și are propriile caracteristici de implementare. Aici vom discuta opțiunea cu cea mai mică măsură L1
Proces manual pentru YOLOv3
Arhitectura inițială conține blocuri reziduale. Dar, oricât de eficiente ar fi pentru rețelele adânci, ne vor crea unele dificultăți. Problema este că nu putem elimina convoluțiile cu indici diferiți în aceste straturi:
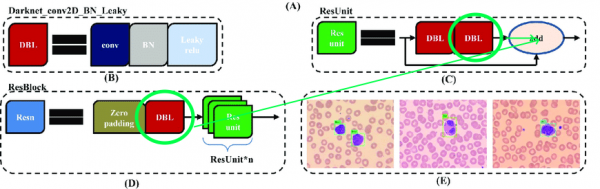
Prin urmare, vom defini straturile din care putem elimina liber convoluțiile:

Acum să construim ciclul de lucru:
- Extragem activările
- Estimăm cât de multe să eliminăm
- Eliminăm
- Învățăm timp de 10 epoci cu LR=1e-4
- Testăm
Este util să extragem convoluțiile pentru a evalua ce parte putem elimina într-un anumit pas. Exemple de extragere:
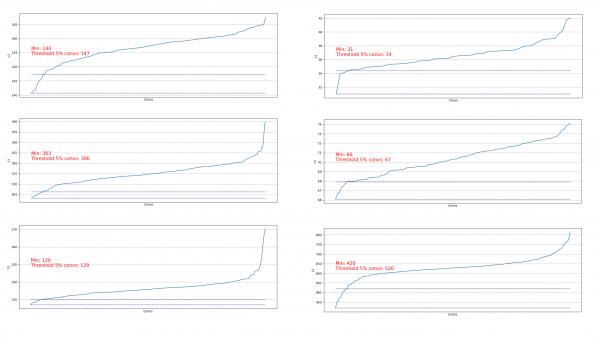
Vedem că aproape peste tot 5% din convoluții au o normă L1 foarte scăzută și le putem elimina. La fiecare pas, această extragere s-a repetat și s-a evaluat din ce straturi și câte putem elimina.
Întregul proces a fost finalizat în 4 pași (aici și în toată parte cu numere pentru RTX 2060 Super):
| Pasul | mAp75 | Numărul de parametri, mii | Dimensiunea rețelei, mb | Față de inițial, % | Timpul de rulare, ms | Condiția de tăiere |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% din total |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% din total |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% pentru straturile cu 400+ convoluții |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% pentru straturile cu 100+ convoluții |
La pasul 2, a apărut un efect pozitiv — dimensiunea batch-ului a crescut la 4, ceea ce a accelerat considerabil procesul de reînvățare.
La pasul 4, procesul a fost oprit, deoarece reînvățarea prelungită nu a ridicat mAp75 la valorile anterioare.
În cele din urmă, am reușit să accelerăm inferența cu 15%, să reducem dimensiunea cu 35% și să nu pierdem din precizie.
Automatizarea pentru arhitecturi mai simple
Pentru arhitecturi mai simple ale rețelelor (fără blocuri condiționale de tip add, concatenate și rezidual), este suficient să ne orientăm asupra procesării tuturor straturilor convoluționale și să automatizăm procesul de eliminare a convoluțiilor.
Această variantă am implementat-o .
Totul este simplu: aveți nevoie doar de funcția de pierdere, optimizer și generatoare de batch-uri:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Dacă este necesar, puteți modifica parametrii configurațiilor:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # numărul de epoci pentru antrenamentul între pașii de pruning
    "stop_loss": 0.1, # pierdere pentru oprirea procesului
    "pruning_percent_step": 0.05, # parte din convs de șters la fiecare pas de pruning
    "pruning_standart_deviation_part": 0.2 # deplasare pentru a limita partea de pruning
}
De asemenea, a fost implementată o limitare pe baza deviației standard. Scopul este de a restricționa partea eliminată, excluzând convoluțiile cu măsuri L1 „suficiente”:
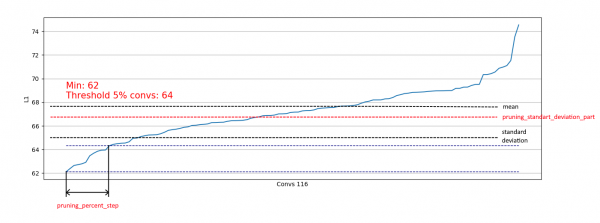
Astfel, permitem eliminarea doar a convoluțiilor slabe din distribuțiile asemănătoare celei drepte și nu influențăm eliminarea din distribuțiile asemănătoare celei stângi:
Pe măsură ce distribuția se apropie de normală, coeficientul pruning_standart_deviation_part poate fi ales din:
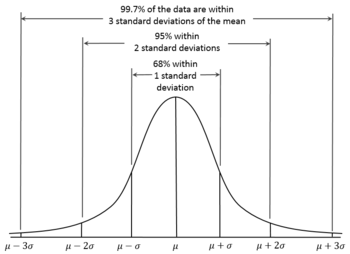
Recomand o toleranță de 2 sigma. Sau se poate să nu se țină cont de această particularitate, lăsând valoarea < 1.0.
La ieșire, obținem un grafic al dimensiunii rețelei, pierderilor și timpului de rulare a rețelei pe tot parcursul testului, normalizate la 1.0. De exemplu, aici dimensiunea rețelei a fost redusă aproape la jumătate fără pierderi de calitate (o rețea convoluțională mică cu 100k parametri):
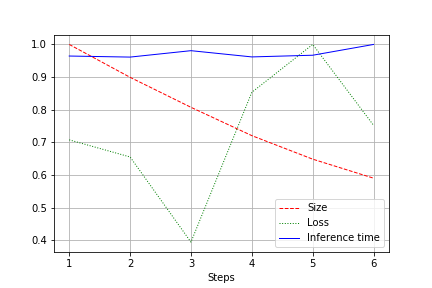
Viteza de rulare este supusă fluktuatiilor normale și practic nu s-a schimbat. Acest lucru are o explicație:
- Numărul de convoluții se schimbă de la confortabil (32, 64, 128) la cele mai puțin convenabile pentru plăcile video — 27, 51 etc. Aici pot greși, dar cel mai probabil acest lucru influențează.
- Arhitectura nu este lată, dar este secvențială. Reducând lățimea, nu afectăm adâncimea. Astfel, reducem încărcarea, dar nu schimbăm viteza.
Prin urmare, îmbunătățirea s-a tradus în reducerea sarcinii CUDA cu 20-30% în timpul rulării, dar nu în reducerea timpului de rulare
Concluzii
Să reflectăm. Am analizat 2 variante de pruning — pentru YOLOv3 (când trebuie să lucrăm manual) și pentru rețele cu arhitecturi mai simple. Se observă că în ambele cazuri se poate obține o reducere a dimensiunii rețelei și o accelerare fără pierderi de precizie. Rezultatele sunt:
- Reducerea dimensiunii
- Accelerarea rulării
- Reducerea sarcinii CUDA
- Ca urmare, ecologicitatea (Optimizăm utilizarea viitoare a resurselor computaționale. Undeva, se bucură cineva )
Appendix
- După pasul de pruning, se poate continua cu cuantizarea (de exemplu, cu TensorRT)
- Tensorflow oferă posibilități pentru . Funcționează.
- vreau să dezvolt și voi fi bucuros să primesc ajutor
Sursa: habr.com
