

Compania Google a lansat codec-ul audio Lyra V2, care folosește metode de învățare automată pentru a atinge calitatea maximă a transmisiei vocale utilizând canale de comunicație foarte lente. Noua versiune se distinge prin trecerea la o nouă arhitectură de rețea neurală, suport pentru platforme suplimentare, funcționalități extinse de gestionare a bitrate-ului, îmbunătățirea performanței și atingerea unei calități audio superioare. Implementarea de referință a codului este scrisă în C++ și este distribuită sub licența Apache 2.0.
În ceea ce privește calitatea datelor vocale transmise la viteze mici, Lyra depășește semnificativ codec-urile tradiționale care folosesc metode de procesare a semnalelor digitale. Pentru a obține o calitate ridicată a transmisiunii vocale în condiții de volum limitat de informație transmisă, alături de metodele obișnuite de compresie a sunetului și de conversie a semnalelor, în Lyra se aplică un model vocal bazat pe un sistem de învățare automată, care permite recrearea informațiilor lipsă pe baza caracteristicilor tipice ale vocii.
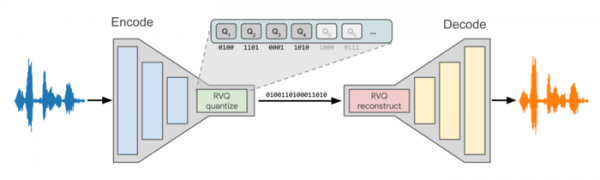
Codec-ul include un encoder și un decoder. Algoritmul de funcționare al encoder-ului constă în extragerea parametrilor datelor vocale la fiecare 20 de milisecunde, comprimarea acestora și transmiterea către receptor prin rețea cu un bitrate între 3.2kbps și 9.2kbps. De partea receptorului, decoder-ul folosește un model generativ pentru a recrea semnalul vocal original pe baza parametrilor audio transmiși, care includ spectrograma mel-logaritmică, luând în considerare caracteristicile energiei vocii în diferite intervale de frecvență și pregătite ținând cont de modelul percepției auditive umane.
În Lyra V2 a fost folosit un nou model generativ bazat pe rețeaua neurală convoluțională SoundStream, care se distinge prin cerințe scăzute de resurse de calcul, permițând decodificarea în timp real chiar și pe sisteme mai puțin puternice. Modelul utilizat pentru generarea sunetului a fost antrenat folosind mii de ore de înregistrări vocale în peste 90 de limbi. Pentru executarea modelului se folosește TensorFlow Lite. Performanța implementării propuse este suficientă pentru codificarea și decodificarea vocii pe smartphone-uri de nivel de preț scăzut.
Pe lângă utilizarea unui alt model generativ, noua versiune se remarcă prin includerea în arhitectură a codec-ului de legături cu cuantizatorul RVQ (Residual Vector Quantizer), care este realizat de partea expeditorului înainte de transmiterea datelor și de partea receptorului după primirea datelor. Cuantizatorul transformă parametrii furnizați de codec în seturi de pachete, codificând informația în funcție de bitrate-ul selectat. Pentru a asigura un nivel diferit de calitate, sunt prevăzute cuantizatoare pentru trei bitrate-uri (3.2 kps, 6 kbps și 9.2 kbps), cu cât bitrate-ul este mai mare, cu atât calitatea este mai bună, dar cerințele de lățime de bandă sunt mai ridicate.
Noua arhitectură a permis reducerea întârzierilor de transmitere a semnalului de la 100 la 20 de milisecunde. Spre comparație, codec-ul Opus pentru WebRTC a demonstrat întârzieri de 26.5 ms, 46.5 ms și 66.5 ms la bitrate-uri testate. De asemenea, performanța encoder-ului și decoder-ului a crescut semnificativ — comparativ cu versiunea anterioară, s-a observat o accelerație de până la 5 ori. De exemplu, pe smartphone-ul Pixel 6 Pro, noul codec realizează codificarea și decodificarea unei eșantionări de 20 de milisecunde în 0.57 ms, ceea ce este de 35 de ori mai rapid decât este necesar pentru transmiterea în timp real.
În plus față de performanță, s-a reușit și îmbunătățirea calității restaurării sunetului — pe scală MUSHRA, calitatea vocii la bitrate-urile de 3.2 kbps, 6 kbps și 9.2 kbps, utilizând codec-ul Lyra V2, corespunde bitrate-urilor de 10 kbps, 13 kbps și 14 kbps folosind codec-ul Opus.
Sursa: opennet.ro
