

Cercetarea științifică este, probabil, cea mai interesantă parte a învățământului nostru. Ideea este de a încerca să ne facem o experiență în direcția aleasă încă din timpul facultății. De exemplu, studenții de la specializările Software Engineering și Machine Learning merg adesea să facă lucrări de cercetare în companii (în principal, JetBrains sau Yandex, dar nu numai).
În acest post, voi povesti despre proiectul meu în domeniul Computer Science. În cadrul lucrării, am studiat și implementat practic abordările pentru a rezolva una dintre cele mai cunoscute probleme NP-grele: problema acoperirii vârfului.
În prezent, se dezvoltă foarte rapid o abordare interesantă pentru problemele NP-grele - algoritmii parametrici. Voi încerca să vă introduc în subiect, să vă vorbesc despre câțiva algoritmi parametrici simpli și să descriu o metodă puternică care m-a ajutat foarte mult. Rezultatele mele le-am prezentat la competiția PACE Challenge: de-a lungul testelor deschise, soluția mea ocupă locul trei, iar rezultatele finale vor fi cunoscute pe 1 iulie.
Despre mine
Mă numesc Vasili Alfiorev, acum finalizez anul trei la NIU HSE - Sankt Petersburg. Mă pasionează algoritmii încă din școală, când am studiat la școala 179 din Moscova și am participat cu succes la olimpiade de informatică.
Un număr finit de specialiști în algoritmi parametrici intră într-un bar...
Exemplul este preluat din cartea
Imaginați-vă că sunteți un agent de securitate într-un bar dintr-un oraș mic. În fiecare vineri, jumătate din oraș vine la barul dumneavoastră pentru a se relaxa, ceea ce vă dă multe bătăi de cap: trebuie să expulzați clienții agitați pentru a preveni scandalurile. La un moment dat, vă săturați de asta și decideți să luați măsuri preventive.
Deoarece orașul dumneavoastră este mic, știți exact care perechi de clienți au o probabilitate mare să se certe dacă ajung împreună în bar. Aveți o listă de n oameni care vor veni în seara asta în bar. Deci, decideți să nu lăsați să intre anumiți cetățeni astfel încât nimeni să nu se bată. În același timp, conducerea nu vrea să piardă profitul și va fi nemulțumită dacă nu lăsați să intre mai mult de k oameni.
Din păcate, problema cu care vă confruntați este o problemă clasică NP-grele. Ați putea-o cunoaște ca , sau despre problema acoperirii vârfului. Pentru astfel de probleme, în general, nu există algoritmi care să funcționeze într-un timp acceptabil. Dacă vrem să fim precisi, atunci ipoteza ETH (Exponential Time Hypothesis), care nu a fost demonstrată, sugerează că această problemă nu poate fi rezolvată într-un timp  , adică nu există nimic mai bun decât metoda de încercare exhaustivă. De exemplu, să presupunem că urmează să vină n = 1000 de oameni în bar. Atunci încercarea exhaustivă ar genera
 variante, ceea ce reprezintă aproximativ
 — extrem de multe. Din fericire, conducerea dumneavoastră v-a impus o limitare k = 10, astfel că numărul de combinații pe care trebuie să le examinați este mult mai mic: numărul submulțimilor din zece elemente este
 . Aceasta este deja mai bine, dar tot nu va putea fi contabilizat într-o zi, nici pe un cluster puternic.
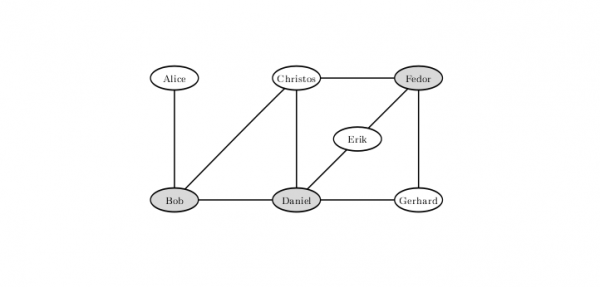
Pentru a exclude posibilitatea unei bătăi în această configurație de relații tensionate între clienții barului, trebuie să nu-l lăsați pe Bob, Daniel și Fiodor. Nu există soluții în care să rămână doar doi în afară.
Asta înseamnă că ar trebui să ne predăm și să-i lăsăm pe toți să intre? Să luăm în considerare alte opțiuni. De exemplu, am putea să nu-i lăsăm doar pe cei care ar putea să se bată cu un număr foarte mare de oameni. Dacă cineva poate să se bată măcar cu k + 1 alte persoane, atunci cu siguranță nu ar trebui să-l lăsăm să intre — altfel va trebui să-i refuzăm pe toți k + 1 orașenii cu care ar putea să se bată, ceea ce va deranja cu siguranță conducerea.
Să presupunem că ați eliminat pe toți cei pe care îi puteți, conform acestui principiu. Atunci toți ceilalți pot să se bată cu mai mult de k oamenii. Îndepărtând din ei k persoane, puteți preveni cu nu mai mult de  conflicte. Asta înseamnă că, dacă mai mult de
 oameni participă la măcar un conflict, atunci cu siguranță nu veți putea preveni toate. Deoarece, sper că este evident, oamenii complet neconflictați îi veți lăsa cu siguranță să intre, atunci trebuie să examinați toate submulțimile de dimensiune zece din două sute de oameni. Aceștia sunt aproximativ
 , iar un astfel de număr de operațiuni poate fi deja examinat pe un cluster.
Dacă putem primi fără probleme persoane care nu sunt în conflict, ce ne facem cu cei care participă la un singur conflict? De fapt, putem să-i primim și pe ei, închizând ușa în fața adversarului. Adevărat, dacă Alice este în conflict doar cu Bob, atunci, dacă îl primim pe Alice, nu vom pierde: Bob ar putea avea alte conflicte, iar Alice cu siguranță nu are. Cu atât mai mult, este lipsit de sens să nu-i primim pe amândoi. După astfel de operațiuni, rămân nu mai mult de  oaspeți cu soarta nerezolvată: în total avem
 conflicte, fiecare având câte două persoane implicate, iar fiecare participând la cel puțin două. Asta înseamnă că rămâne de evaluat doar
 opțiuni, ceea ce poate fi calculat în jumătate de zi pe un laptop.
De fapt, prin raționamente simple putem obține condiții și mai atractive. Să observăm că este esențial să rezolvăm toate disputele, adică să alegem din fiecare pereche în conflict cel puțin o persoană pe care nu o vom primi. Să luăm în considerare un astfel de algoritm: să luăm orice conflict, să eliminăm un participant și să reluăm recursiv de la rest, apoi să eliminăm pe celălalt și să facem la fel. Deoarece la fiecare pas eliminăm pe cineva, arborele de recursivitate al acestui algoritm este un arbore binar de adâncime k, deci algoritmul funcționează în  , unde n — numărul de vârfuri și m — numărul de muchii. În exemplul nostru, aceasta este în jur de zece milioane, ceea ce poate fi calculat în câteva fracțiuni de secundă, nu doar pe un laptop, ci chiar și pe un telefon mobil.
Exemplul de mai sus este un exemplu de algoritm parametrizat. Algoritmii parametrizați sunt algoritmi care funcționează în timp f(k) poly(n), unde p — polinom, f — o funcție calculabilă arbitrară, iar k — un parametru care, foarte probabil, va fi mult mai mic decât dimensiunea problemei.
Toate raționamentele până la acest algoritm oferă exemplul kernelizării — una dintre tehnicile comune pentru crearea algoritmilor parametrizați. Kernelizarea reprezintă reducerea dimensiunii unei sarcini la o valoare limitată de o funcție a parametrului. Sarcina obținută este adesea denumită nucleu. Astfel, din raționamente simple despre gradele vârfurilor, am obținut un nucleu quadratic pentru problema Vertex Cover, parametrizată în funcție de dimensiunea răspunsului. Există și alți parametri care pot fi aleși pentru această problemă (de exemplu, Vertex Cover Above LP), dar vom discuta exact acest parametru.
Pace Challenge
Competiție (Provocarea Algoritmilor Parametrizați și Experimentele Computaționale) a fost înființată în 2015 pentru a stabili o legătură între algoritmii parametrizați și abordările utilizate în practică pentru a rezolva probleme computaționale. Primele trei competiții au fost dedicate găsirii lățimii arborilor grafurilor (), găsirii arborelui lui Steiner () și găsirii unui set de vârfuri care taie ciclurile (). În acest an, una dintre problemele în care participanții au putut să își încerce forțele a fost problema de acoperire a vârfurilor menționată mai sus.
Competiția câștigă popularitate de la an la an. Dacă ne bazăm pe date preliminare, anul acesta, doar în competiția de rezolvare a problemei de acoperire a vârfurilor au participat 24 de echipe. Este important de menționat că competiția nu durează câteva ore, nici măcar o săptămână, ci câteva luni. Echipele au oportunitatea de a studia literatura, de a veni cu o idee originală și de a încerca să o implementeze. Practic, această competiție reprezintă o muncă de cercetare. Ideile celor mai eficiente soluții și premierea câștigătorilor vor avea loc în cadrul conferinței (Simpozion Internațional pe Calcul Parametrizat și Exact) în cadrul celei mai mari adunări anuale de algoritmi din Europa . Mai multe informații despre competiție pot fi găsite la , iar rezultatele anilor anteriori sunt disponibile .
Schema de soluție
Pentru a aborda problema acoperirii vârfului, am încercat să aplic algoritmi parametrizați. Aceștia constau, de obicei, din două părți: reguli de simplificare (care ideal ar trebui să conducă la kernelizare) și reguli de ramificare. Reguli de simplificare sunt preprocesarea intrării într-un timp polinomial. Scopul aplicării acestor reguli este reducerea problemei la o problemă echivalentă de dimensiuni mai mici. Reguli de simplificare reprezintă cea mai costisitoare parte a algoritmului, iar aplicarea acestei părți duce la un timp total de execuție  în loc de un timp polinomial simplu. În cazul nostru, regulile de ramificare se bazează pe faptul că pentru fiecare vârf trebuie să luăm în considerare fie acesta, fie vecinul său.
Schema generală este următoarea: aplicăm regulile de simplificare, apoi alegem un vârf și facem două apeluri recursive: în primul luăm acest vârf în considerare, iar în al doilea luăm toți vecinii săi. Asta numim a ne ramifica (branched) după acest vârf.
În această schema va fi adăugat exact o singură completare în următorul paragraf.
Idei pentru regulile de ramificare
Să discutăm despre cum să alegem vârful pe care va avea loc ramificarea.
Ideea principală este foarte avară din punct de vedere algoritmic: să luăm vârful cu gradul maxim și să ne ramificăm exact pe acesta. De ce pare că este mai bine așa? Pentru că în a doua ramură a apelului recursiv astfel vom elimina foarte multe vârfuri. Se poate estima că va rămâne un graf mic și vom lucra rapid pe acesta.
Această abordare, combinată cu tehnicile simple de kernelizare discutate anterior, se dovedește a fi eficientă, rezolvând teste de dimensiuni de câteva mii de vârfuri. Totuși, de exemplu, funcționează slab pentru grafuri cubice (adică grafuri în care gradul fiecărui vârf este egal cu trei).
Există și o altă idee, bazată pe o gândire destul de simplă: dacă graful este neconectat, problema pe componentele sale de conectivitate poate fi rezolvată independent, combinând răspunsurile la final. Aceasta, de altfel, este modificarea promisă anterior în schemă, care va accelera semnificativ soluția: anterior, în astfel de cazuri lucram cu produsul timpilor de calcul pentru răspunsurile componentelor, iar acum lucrăm cu suma. Iar pentru a accelera ramificarea, trebuie să transformăm graful conectat într-unul neconectat.
Cum să facem asta? Dacă în grafic există un punct de articulație, trebuie să ne branșăm exact pe el. Punctul de articulație este un vârf, iar eliminarea sa face ca graficul să piardă conexiunea. Toate punctele de articulație dintr-un grafic pot fi găsite folosind un algoritm clasic în timp liniar. Această abordare accelerează semnificativ branșarea.
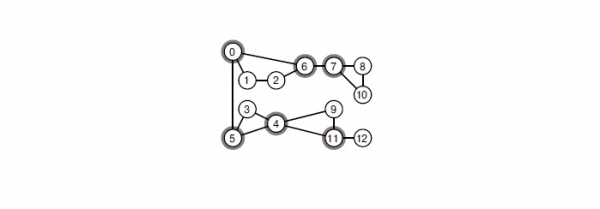
La eliminarea oricărei dintre vârfurile marcate, graficul se va descompune în componente de conexiune.
Acest lucru îl vom face, dar ne dorim mai mult. De exemplu, să căutăm în grafic tăieturi mici de vârf și să efectuăm descompunerea pe vârfuri din acestea. Cea mai eficientă metodă pe care o cunosc pentru a găsi tăietura minimă globală a vârfului este utilizarea arborilor Gomory-Hu, care se construiesc în timp cubic. În cadrul PACE Challenge, dimensiunea tipică a graficului este de câteva mii de vârfuri. În aceste condiții, în fiecare vârf al recursivității ar trebui să executăm miliarde de operațiuni. Se dovedește că este pur și simplu imposibil să rezolvăm problema în timpul alocat.
Să încercăm să optimizăm soluția. Tăietura minimă a vârfului între o pereche de vârfuri poate fi găsită cu orice algoritm care construiește fluxul maxim. Putem rula un asemenea algoritm pe o astfel de rețea , în practică acesta funcționează foarte rapid. Am o suspiciune că teoretic se poate demonstra o estimare a timpului de execuție  , care este deja destul de acceptabil.
Am încercat de mai multe ori să caut tăieturi între perechi de vârfuri aleatoare și să iau cea mai bine echilibrată. Din păcate, în testele deschise ale PACE Challenge, acest lucru a dat rezultate slabe. Am comparat cu un algoritm care s-a concentrat pe vârfurile cu grad maxim, rulându-l cu o limitare a adâncimii de căutare. După algoritmul care a încercat să găsească tăietura în acest fel, au rămas grafuri mai mari. Aceasta se datorează faptului că tăieturile obținute erau foarte dezechilibrate: eliminând 5-10 vârfuri, reușeam să îndepărtez doar 15-20.
Merită observat că în articolele despre cele teoretic cele mai rapide algoritme sunt folosite tehnici de selecție a vârfurilor mult mai avansate pentru descompunere. Aceste tehnici au o implementare foarte complexă și de multe ori evaluări slabe în ceea ce privește timpul și memoria. Nu am reușit să extrag dintre ele ceva acceptabil pentru practică.
Cum să aplicăm regulile de simplificare
Avem deja idei de kernelizare. Îmi amintesc:
- Dacă există un vârf izolat, elimină-l.
- Dacă există un vârf de grad 1, îl eliminăm și luăm vecinul său ca răspuns.
- Dacă există un vârf de grad cel puțin k + 1, îl luăm ca răspuns.
Cu primele două e totul clar, dar cu a treia există o mică șmecherie. Dacă în problema glumei cu barul ni s-a dat o limită superioară pe k, în PACE Challenge trebuie doar să găsim o acoperire minimă a vârfurilor. Aceasta este o transformare tipică a problemelor de căutare (Search Problem) în probleme de decizie (Decision Problem), adesea între cele două tipuri de probleme nu se face distincție. În practică, dacă scrii un rezolvitor pentru problema acoperirii vârfurilor, diferența poate fi semnificativă. De exemplu, ca în punctul trei.
Din perspectiva implementării, se pot folosi două metode. Primul abordare se numește Iterative Deepening. Acesta constă în: putem începe cu o limită inferioară rezonabilă pentru răspuns și apoi să rulez algoritmul nostru, utilizând această limită ca limită superioară a răspunsului, fără a coborî în recursie mai jos decât această limită. Dacă am găsit un răspuns, acesta este garantat optim, altfel putem crește această limită cu unu și să reluăm executarea.
Cealaltă abordare este de a păstra un răspuns optim curent și de a căuta un răspuns de dimensiune mai mică, modificând acest parametru atunci când este găsit k pentru a reduce ramificările inutile în căutare.
După câteva experimente nocturne, m-am oprit la combinația acestor două metode: mai întâi, îmi rulez algoritmul cu o limită asupra adâncimii căutării (ajustând-o astfel încât să dureze un timp neglijabil în comparație cu soluția principală) și folosesc cea mai bună soluție găsită ca limită superioară a răspunsului — adică aceea k.
Vârfurile de grad 2
Ne-am clarificat cu vârfurile de grad 0 și 1. Se pare că este posibil să facem același lucru și cu vârfurile de grad 2, dar pentru aceasta grafurile vor necesita operații mai complexe.
Pentru a explica acest lucru, trebuie cumva să desemnăm vârfurile. Să numim un vârf de grad 2 vârf v, iar vecinii săi — vârfuri x și Stabiliți o parolă și păstrați-o în siguranță!. Apoi, vom avea două cazuri.
- Când x și Stabiliți o parolă și păstrați-o în siguranță! — vecinii. Atunci putem lua ca răspuns x și Stabiliți o parolă și păstrați-o în siguranță!, iar v eliminăm. Și, într-adevăr, din acest triunghi, trebuie să luăm cel puțin două vârfuri ca răspuns și cu siguranță nu vom pierde dacă luăm x și Stabiliți o parolă și păstrați-o în siguranță!: probabil mai au vecini, iar v aceștia nu au.
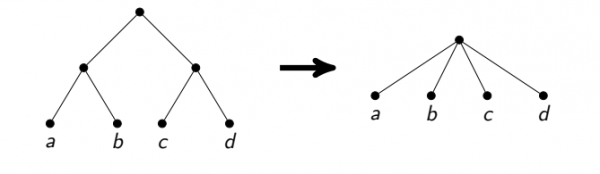
- Când x și Stabiliți o parolă și păstrați-o în siguranță! — nu vecinii. Atunci se afirmă că toate cele trei vârfuri pot fi unite într-unul singur. Ideea este că, în acest caz, există un răspuns optim, în care vom lua fie v, fie ambele vârfuri x și Stabiliți o parolă și păstrați-o în siguranță!. Însă, în primul caz, va trebui să luăm în considerare toți vecinii x și Stabiliți o parolă și păstrați-o în siguranță!, iar în al doilea nu este neapărat. Acest lucru corespunde exact cazurilor când nu luăm în considerare vârful unit și când îl luăm. Rămâne doar să observăm că în ambele cazuri răspunsul acestei operații scade cu unu.
Merită menționat că această abordare este destul de greu de implementat cu precizie într-un timp liniar corect. Unirea vârfurilor este o operație complexă, trebuie să copiеm listele vecinilor. Dacă nu ne ocupăm cu atenție, putem obține un timp de execuție asimptotic suboptimal (de exemplu, dacă după fiecare unire copiem multe arce). M-am oprit pe căutarea de căi întregi din vârfuri de gradul 2 și analiza multor cazuri particulare, precum cicluri din astfel de vârfuri sau din toate acele vârfuri, cu excepția unuia.
În plus, trebuie să ne asigurăm că această operație este reversibilă, astfel încât în timpul revenirii din recursivitate să refacem graful în forma sa inițială. Pentru a asigura acest lucru, nu am curățat listelor de arce ale vârfurilor unite, după care știam pur și simplu care arce trebuie să fie direcționate. Această implementare a grafurilor necesită, de asemenea, atenție, dar asigură un timp liniar corect. Iar pentru grafuri cu câteva zeci de mii de arce, se încadrează perfect în cache-ul procesorului, ceea ce oferă avantaje semnificative de viteză.
Nucleul liniar
În final, cea mai interesantă parte a nucleului.
Pentru început, să ne amintim că în grafurile bipartite, acoperirea minimă a vârfurilor poate fi căutată în  . Pentru aceasta, trebuie folosit algoritmul pentru a găsi acolo o pereche maximă, apoi să folosim teorema .
Ideea nucleului liniar este următoarea: mai întâi descompunem graful, adică în locul fiecărui vârf v creăm două vârfuri  și
 , iar în locul fiecărui arc u — v creăm două arce
 și
 Graful obținut va fi bipartit. Să găsim o acoperire minimă a vârfului. Unele vârfuri din graful inițial vor apărea de două ori, altele o singură dată, iar unele – deloc. Teorema Nemhauser-Trotter afirmă că în acest caz putem elimina vârfurile care nu au apărut deloc și să luăm în considerare pe cele care au apărut de două ori. Mai mult, aceasta spune că dintre vârfurile rămase (cele care au apărut o singură dată) trebuie să luăm în considerare cel puțin jumătate.
Tocmai am învățat să lăsăm în grafic nu mai mult de 2k vârfuri. Și, într-adevăr, dacă în răspunsul rămas se află cel puțin jumătate din toate vârfurile, atunci în total nu pot fi mai multe vârfuri decât 2k.
Aici am reușit să fac un mic pas înainte. Este clar că nucleul construit astfel depinde de ce acoperire minimă a vârfului din graful bipartit am ales. Îmi doresc să aleg astfel încât numărul vârfurilor rămase să fie minim. În trecut, acest lucru se putea face doar în timpul  . Eu am găsit o implementare a acestui algoritm în timp
 , astfel încât acest nucleu poate fi căutat în grafuri cu sute de mii de vârfuri în fiecare etapă a ramificării.
Rezultatul
Practic, soluția mea funcționează bine pe teste cu câteva sute de vârfuri și câteva mii de muchii. Pe astfel de teste, este destul de realist să ne așteptăm că soluția va fi găsită în jumătate de oră. Probabilitatea găsirii unei soluții într-un timp acceptabil crește, de principiu, dacă în grafic sunt destul de multe vârfuri de grad mare, de exemplu, grad 10 sau mai mult.
Pentru a participa la competiție, soluțiile trebuiau trimise la . Judecând după tabloul prezentat acolo Rezultatele pe testele închise vor fi cunoscute pe 1 iulie.
Cercetarea științifică, probabil, este cea mai interesantă parte a studiului nostru. Ideea este să încercăm încă din universitate să ne testăm abilitățile în direcția aleasă.
Sursa: habr.com
