

Articolul echipei Stitch Fix sugerează utilizarea unui abordare a studiilor clinice de eficiență non-inferioritate în testele A/B de marketing și produse. Această abordare este cu adevărat aplicabilă atunci când testăm o nouă soluție care are beneficii greu măsurabile prin teste.
Cel mai simplu exemplu este reducerea costurilor. De exemplu, automatizăm procesul de programare a primei lecții, dar nu dorim să afectăm semnificativ conversia generală. Sau testăm modificări care se concentrează pe un segment de utilizatori, având în același timp grijă să ne asigurăm că conversiile pentru celelalte segmente nu scad semnificativ (când testăm mai multe ipoteze, nu uităm de corecții).
Alegerea limitei corecte de non-inferioritate adaugă dificultăți suplimentare în etapa de proiectare a testului. Întrebarea despre cum se alege Δ nu este foarte bine clarificată în articol. Se pare că această alegere nu este complet transparentă și în studiile clinice. Publicațiile medicale despre non-inferioritate arată că doar în jumătate dintre publicații alegerea limitei este justificată, iar aceste justificări sunt de multe ori ambigue sau insuficient detaliate.
În orice caz, această abordare pare interesantă, deoarece reducerea dimensiunii necesare a eșantionului poate crește viteza testării și, astfel, viteza de luare a deciziilor. — Daria Mukhina, analist de produs al aplicației mobile Skyeng.
Echipa Stitch Fix îi place să testeze lucruri diferite. Întreaga comunitate tehnologică, în general, îi place să realizeze teste. Care versiune a site-ului atrage mai mulți utilizatori – A sau B? Generația A a modelului de recomandări aduce mai mulți bani decât versiunea B? Aproape întotdeauna, pentru a verifica ipotezele, folosim cea mai simplă abordare din cursul de bază al statisticii:
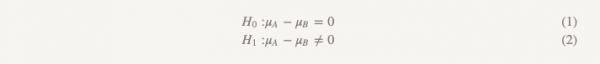
Deși rareori folosim acest termen, această formă de testare se numește „verificarea ipotezei de superioritate”. Cu această abordare, presupunem că între cele două variante nu există nicio diferență. Ne menținem această idee și renunțăm la ea doar în cazul în care datele obținute sunt suficient de convingătoare pentru a face acest lucru – adică demonstrează că una dintre variante (A sau B) este mai bună decât cealaltă.
Verificarea ipotezei de superioritate este potrivită pentru a rezolva multe probleme. Lansăm versiunea B a modelului de recomandare doar dacă este evident mai bună decât versiunea A utilizată. Dar, în unele cazuri, această abordare nu funcționează atât de bine. Să analizăm câteva exemple.
1) Utilizăm un serviciu terț, care ajută la identificarea cardurilor bancare false. Am găsit un alt serviciu, care costă semnificativ mai puțin. Dacă serviciul mai ieftin funcționează la fel de bine ca cel pe care îl folosim acum, îl vom alege. Nu trebuie neapărat să fie mai bun decât serviciul utilizat.
2) Dorim să renunțăm la sursa de date A și să o înlocuim cu sursa de date B. Am putea amâna renunțarea la A, dacă B oferă rezultate foarte slabe, dar continuarea utilizării lui A nu se mai dovedește posibilă.
3) Ne-ar plăcea să trecem de la abordarea de modelareA la abordarea B nu pentru că ne așteptăm la rezultate mai bune de la B, ci pentru că aceasta ne oferă o flexibilitate operațională mai mare. Nu avem motive să credem că B va fi mai rău, dar nu ne vom face tranziția dacă va fi așa.
4) Am realizat câteva modificări calitative în designul site-ului web (versiunea B) și considerăm că această versiune este superioară versiunii A. Nu ne așteptăm la schimbări în conversie sau în orice indicatori cheie de performanță pe care îi evaluăm de obicei pentru site. Dar credem că există avantaje în parametrii care fie sunt inelucrați, fie tehnologiile noastre nu sunt suficiente pentru a-i măsura.
În toate aceste cazuri, cercetarea superiorității nu este cea mai potrivită soluție. Dar majoritatea specialiștilor în astfel de situații o folosesc ca opțiune implicită. Realizăm cu atenție experimentul pentru a determina corect dimensiunea efectului. Dacă ar fi adevărat că versiunile A și B funcționează foarte asemănător, există probabilitatea că nu vom reuși să respingem o ipoteză nulă. Concluzionăm că A și B funcționează în general la fel? Nu! Imposibilitatea de a respinge ipoteza nulă și acceptarea ipotezei nule nu sunt același lucru.
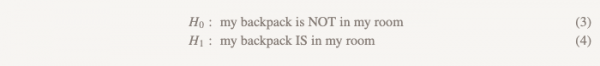
Calculările volumului de eșantion (pe care, desigur, le-ați efectuat) se realizează, de obicei, cu limite mai stricte pentru eroarea de tip I (probabilitatea respingerii greșite a ipotezei nule, adesea numită alfa) decât pentru eroarea de tip II (probabilitatea de a nu respinge ipoteza nulă, dat fiind că ipoteza nulă este greșită, adesea numită beta). Valoarea tipică pentru alfa este 0,05, în timp ce valoarea tipică pentru beta este 0,20, ceea ce corespunde unei puteri statistice de 0,80. Aceasta înseamnă că putem să nu descoperim influența reală a magnitudinii pe care am menționat-o în calculele noastre de putere, cu o probabilitate de 20%, iar aceasta este o lacună semnificativă în informație. Ca exemplu, să luăm aceste ipoteze:
H0: rucsacul meu NU este în camera mea (3)
H1: rucsacul meu este în camera mea (4)
Dacă am căutat în camera mea și am găsit rucsacul meu — excelent, pot să resping ipoteza nulă. Dar dacă am examinat camera și nu am reușit să găsesc rucsacul meu (figura 1), ce concluzie ar trebui să trag? Sunt sigur că nu este acolo? Am căutat suficient de atent? Ce se întâmplă dacă am căutat doar 80% din cameră? A trasa concluzia că rucsacul nu este cu siguranță în cameră ar fi o decizie pripită. Nu este de mirare că nu putem "accepta ipoteza nulă".
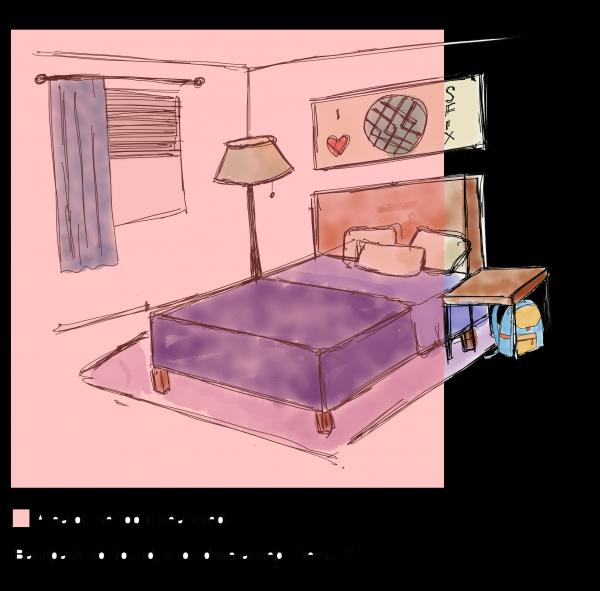
Zona pe care am căutat-o
Nu am găsit rucsacul — ar trebui să acceptăm ipoteza nulă?
Figura 1. A căuta 80% din cameră este aproximativ același lucru cu a efectua un studiu cu o putere de 80%. Dacă nu ați găsit rucsacul după ce ați examinat 80% din cameră, se poate trasa concluzia că acesta nu este acolo?
Așadar, ce ar trebui să facă un specialist în date în această situație? Puteți crește semnificativ puterea studiului, dar atunci va fi nevoie de un eșantion mult mai mare, iar rezultatul va fi în continuare nesatisfăcător.
Din fericire, astfel de probleme au fost studiate de mult în lumea cercetărilor clinice. Medicamentul B este mai ieftin decât medicamentul A; se preconizează că medicamentul B va provoca mai puține efecte adverse decât medicamentul A; medicamentul B este mai ușor de transportat, deoarece nu trebuie păstrat la frigider, în timp ce medicamentul A trebuie. Să verificăm ipoteza eficienței egale. Este necesar să arătăm că versiunea B este la fel de bună ca versiunea A — cel puțin în cadrul unei limite predefinite de „eficiență minimă”, Δ. Încă puțin și vom discuta mai în detaliu despre cum să stabilim această limită. Dar acum să presupunem că aceasta este diferența minimă, care este semnificativă din punct de vedere practic (în contextul studiilor clinice, acest lucru se numește în general semnificație clinică).
Ipotezele de eficiență minimă răstoarnă totul pe dos:
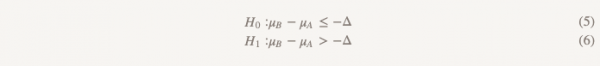
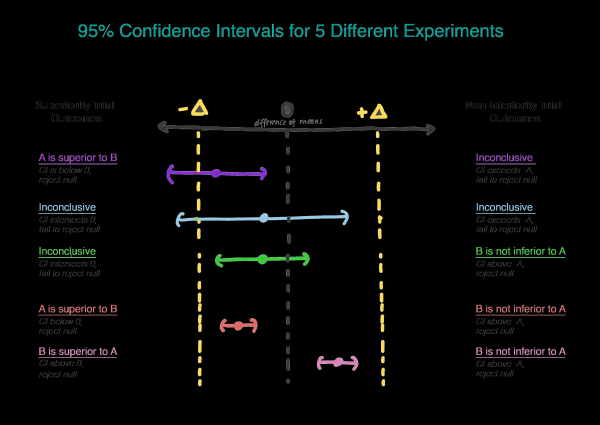
Acum, în loc să presupunem că nu există nicio diferență, presupunem că versiunea B este mai slabă decât versiunea A, și ne vom menține această presupunere până când vom demonstra că nu este adevărat. Exact acest moment este când are sens să utilizăm testarea ipotezei unidirecționale! În practică, acest lucru poate fi realizat construind un interval de încredere și stabilind dacă intervalul este, într-adevăr, mai mare decât Δ (Figura 2).
Alegerea Δ
Cum se alege corect Δ? Procesul de alegere a lui Δ implică o fundamentare statistică și o evaluare subiectivă. În lumea studiilor clinice există recomandări normative care indică faptul că delta ar trebui să reprezinte cea mai mică diferență clinic semnificativă — o diferență care va avea relevanță în practică. Iată o citat dintr-un ghid european cu care te poți verifica: „Dacă diferența a fost aleasă corect, intervalul de încredere, care se află complet între –∆ și 0…, este încă suficient pentru a demonstra eficiența minimă. Dacă acest rezultat pare inacceptabil, înseamnă că ∆ nu a fost ales corespunzător.”
Delta nu trebuie să depășească valoarea efectului versiunii A față de adevăratul control (placebo / lipsa tratamentului), deoarece aceasta se dovedește că versiunea B este mai slabă decât controlul adevărat, demonstrând în același timp „o eficiență nu mai mică”. Să presupunem că atunci când a fost introdusă versiunea A, a fost înlocuită de versiunea 0 sau funcția deloc nu exista (vezi figura 3).
Din rezultatele testării ipotezei de superioritate a fost identificată valoarea efectului E (adică presupus μ^A−μ^0=E). Acum A este noul nostru standard, iar noi dorim să ne asigurăm că B nu este inferior lui A. O altă modalitate de a scrie μB−μA≤−Δ (ipoteza nulă) este μB≤μA−Δ. Dacă presupunem că aceasta este egală sau depășește E, atunci μB ≤ μA−E ≤ placebo. Acum vedem că estimarea noastră pentru μB depășește complet μA−E, ceea ce dezminte complet ipoteza nulă și ne permite să concluzionăm că B nu este inferior lui A, dar în același timp μB poate fi ≤ μ placebo, ceea ce nu este ceea ce ne dorim. (figura 3).
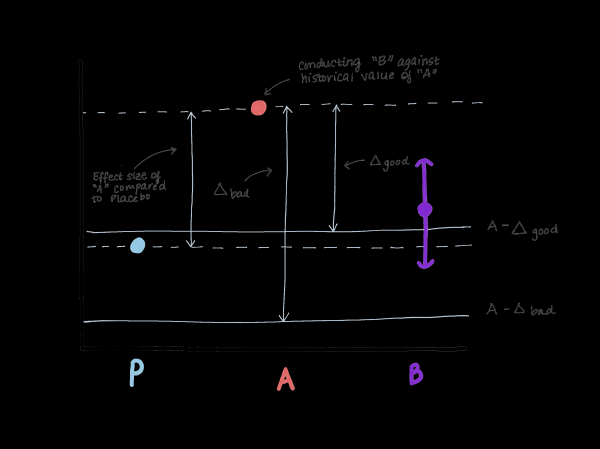
Figura 3. Demonstrarea riscurilor alegerii limitei de eficiență nu mai mică. Dacă limita este prea mare, s-ar putea concluziona că B nu este inferior lui A, dar în același timp nu este diferit de placebo. Nu vom schimba un medicament care este evident mai eficient decât placebo (A) cu un medicament care are aceeași eficiență ca placebo.
Alegerea α
Să trecem la alegerea α. Se poate folosi valoarea standard α = 0,05, dar aceasta nu este tocmai corect. De exemplu, când cumperi ceva online și folosești mai multe coduri de reducere, deși acestea nu ar trebui să se combine - pur și simplu dezvoltatorul a făcut o eroare, iar tu ai scăpat. Conform regulilor, valoarea α ar trebui să fie egală cu jumătate din valoarea α utilizată în testarea ipotezei de superioritate, adică 0,05 / 2 = 0,025.
Dimensiunea eșantionului
Cum să evaluezi dimensiunea eșantionului? Dacă crezi că adevărata diferență a mediei între A și B este 0, atunci calculul dimensiunii eșantionului va fi similar cu cel din testarea ipotezei de superioritate, cu excepția faptului că înlocuiești dimensiunea efectului cu limita de eficiență nu mai mică, cu condiția să folosești αnu mai mică = 1/2αsuperioritate (αnon-inferiority=1/2αsuperiority). Dacă aveți motive să credeți că opțiunea B ar putea fi puțin mai slabă decât opțiunea A, dar doriți să demonstrați că aceasta nu este mai slabă cu mai mult de Δ, atunci aveți noroc! De fapt, aceasta reduce dimensiunea eșantionului, deoarece este mai ușor să demonstrezi că B este mai slab decât A, dacă consideri cu adevărat că este puțin mai slab și nu echivalent.
Exemplu de decizie
Să presupunem că doriți să treceți la versiunea B cu condiția ca aceasta să fie mai slabă decât versiunea A cu nu mai mult de 0,1 puncte pe o scară de 5 puncte a satisfacției clienților… Să abordăm această problemă folosind ipoteza de superioritate.
Pentru a verifica ipoteza de superioritate, am calcula dimensiunea eșantionului în felul următor:
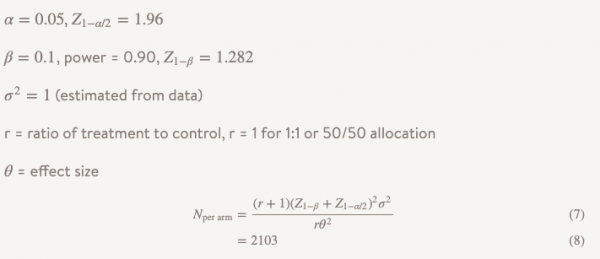
Adică, dacă aveți 2103 observații în grup, puteți fi 90 % sigur că veți descoperi un efect de 0,10 sau mai mult. Dar dacă valoarea de 0,10 este prea mare pentru dvs., poate nu merită să verificați ipoteza de superioritate. Poate că, pentru fiabilitate, veți decide să efectuați o cercetare pentru o dimensiune mai mică a efectului, cum ar fi 0,05. În acest caz, va fi nevoie de 8407 observații, adică eșantionul va crește de aproape 4 ori. Dar ce se întâmplă dacă ne menținem dimensiunea inițială a eșantionului, dar creștem puterea la 0,99, astfel încât să nu avem îndoieli dacă obținem un rezultat pozitiv? În acest caz, n pentru un grup ar fi 3676, ceea ce este deja mai bine, dar crește dimensiunea eșantionului cu mai mult de 50 %. Și, în final, tot nu vom putea respinge ipoteza nulă, ci doar nu vom obține un răspuns la întrebarea noastră.
Ce-ar fi dacă, în schimb, am verifica ipoteza de eficiență nu mai mică?
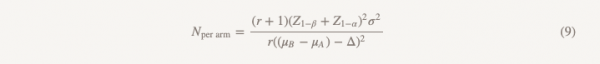
Dimensiunea eșantionului va fi calculată după aceeași formulă, cu excepția numitorului.
Diferitele aspecte față de formula utilizată la verificarea ipotezei de superioritate sunt următoarele:
— Z1−α/2 este înlocuit cu Z1−α, dar dacă respectați regulile, înlocuiți α = 0,05 cu α = 0,025, adică este același număr (1,96)
— în numitor apare (μB−μA)
— θ (mărimea efectului) este înlocuită cu Δ (limita eficienței nu mai mici)
Dacă presupunem că µB = µA, atunci (µB − µA) = 0 și calculul dimensiunii eșantionului pentru limita de eficiență minimă este exact ceea ce am obține prin calcularea superiorității pentru magnitudinea efectului 0,1, excelent! Putem desfășura un studiu de aceeași amploare cu ipoteze diferite și o abordare diferită a concluziilor și vom obține răspunsul la întrebarea la care vrem cu adevărat să răspundem.
Acum să presupunem că de fapt nu considerăm că µB = µA și
credem că µB este puțin mai slab, poate cu 0,01 unități. Aceasta crește numitorul nostru, reducând dimensiunea eșantionului pentru grup la 1737.
Ce se întâmplă dacă versiunea B este de fapt mai bună decât versiunea A? Refuzăm ipoteza nulă că B este mai slab decât A cu mai mult de Δ și acceptăm ipoteza alternativă că B, dacă este mai slab, nu este mai slab decât Δ și poate fi mai bun. Încercați să introduceți această concluzie într-o prezentare interfuncțională și vedeți ce iese (serios, încercați). Într-o situație în care trebuie să ne orientăm pe termen lung, nimeni nu vrea să accepte „mai rău nu mai mult decât Δ și, poate, mai bun”.
În acest caz, putem desfășura un studiu numit foarte concis „testarea ipotezei că una dintre opțiuni depășește cealaltă sau îi cedează”. Acesta folosește două seturi de ipoteze:
Primul set (la fel ca la testarea ipotezei de eficiență minimă):
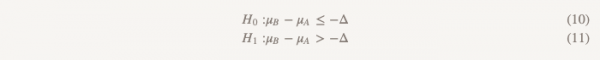
Al doilea set (la fel ca la testarea ipotezei de superioritate):
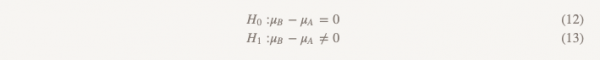
Testăm a doua ipoteză doar dacă prima este respinsă. Prin testarea secvențială, menținem nivelul total de erori de tip I (α). În practică, acest lucru poate fi realizat prin crearea unui interval de încredere de 95% pentru diferența dintre medii și verificarea pentru a determina dacă întregul interval depășește -Δ. Dacă intervalul nu depășește -Δ, nu putem respinge zero și ne oprim. Dacă întregul interval depășește într-adevăr -Δ, vom continua și vom verifica dacă intervalul conține 0.
Există un alt tip de studii pe care nu l-am discutat – studiile de echivalență.
Studii de acest tip pot fi înlocuite cu studii pentru verificarea ipotezei de eficacitate similară și invers, dar au o diferență importantă. Testul pentru verificarea ipotezei de eficacitate similară are ca scop să demonstreze că varianta B este cel puțin la fel de bună ca A. Studiul de echivalență are ca scop să demonstreze că varianta B este cel puțin la fel de bună ca A, iar A este la fel de bun ca B, ceea ce este mai complicat. Practic, încercăm să determinăm dacă întreg intervalul de încredere pentru diferența medie se află între −Δ și Δ. Aceste studii necesită un eșantion mai mare și sunt realizate mai rar. Așadar, data viitoare când veți realiza un studiu în care scopul dumneavoastră principal este să vă asigurați că noua versiune nu este mai slabă, nu acceptați „imposibilitatea de a respinge ipoteza nulă”. Dacă doriți să verificați o ipoteză cu adevărat importantă, luați în considerare diverse opțiuni.
Sursa: habr.com
