

Sistemele de informații moderne sunt destul de complexe. Complexitatea lor este, în mare măsură, determinată de complexitatea datelor procesate. Această complexitate a datelor se manifestă adesea prin diversitatea modelurilor de date utilizate. De exemplu, atunci când datele devin „mari”, una dintre caracteristicile care provoacă neplăceri nu este doar volumul lor („volume”), ci și diversitatea lor („variety”).
Dacă până acum nu găsiți nicio slăbiciune în raționamente, continuați să citiți.
Cuprins
Persistența poliglotă
Cele spuse mai sus duc la situația în care, chiar și în cadrul unei singure sisteme, uneori este necesar să se folosească mai multe SGBD-uri diferite pentru stocarea datelor și rezolvarea diverselor sarcini de procesare a acestora, fiecare dintre ele sprijină propriul său model de date. Cu un impuls de la M. Fowler, o serie de cărți cunoscute și unul dintre Agile Manifesto, această situație a fost denumită stocare multivalentă „(polyglot persistence)”.
Fowler oferă și exemplul de organizare a stocării datelor într-o aplicație complet funcțională și foarte solicitată în domeniul comerțului electronic.
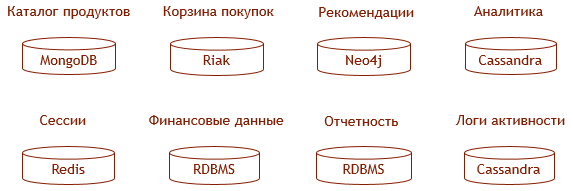
Acest exemplu este, desigur, oarecum exagerat, dar se pot găsi unele considerații în favoarea alegerii unui SGBD sau altul pentru scopuri specifice, de exemplu, .
Este clar că a fi „slujitor” într-un astfel de zoo nu este ușor.
- Volumul de cod care efectuează salvarea datelor crește proporțional cu numărul de SGBD-uri utilizate; volumul de cod care sincronizează datele - bine, dacă nu este proporțional cu pătratul acestui număr.
- Costurile legate de asigurarea caracteristicilor enterprise (scalabilitate, reziliență, disponibilitate ridicată) pentru fiecare dintre SGBD-urile utilizate cresc exponențial cu numărul SGBD-urilor utilizate.
- Nu este posibil să asiguri caracteristicile enterprise ale subsistemului de stocare în ansamblul său - în special tranzacționalitatea.
Din perspectiva directorului zoo-ului, totul arată astfel:
- Creșterea costurilor licențelor și suportului tehnic din partea producătorului SGBD-ului.
- Creșterea personalului și prelungirea termenelor.
- Pierderi financiare directe sau sancțiuni din cauza neconcordanței datelor.
Există o creștere semnificativă a costului total de proprietate al sistemului (TCO). Există vreo soluție pentru situația de „stocare multiplă”?
Multimodalitate
Termenul „stocare multiplă” a intrat în uz în 2011. Conștientizarea problemelor abordării și căutarea de soluții au durat câțiva ani, iar în 2015, analistul Gartner a formulat răspunsul:
- Din „»:
Viitorul SGBD-urilor, arhitecturilor și modurilor de utilizare — multimodalitatea.
- Din „»:
Cele mai importante SGBD-uri operaționale vor oferi mai multe modele — relaționale și nerelaționale — într-o singură platformă.
Se pare că de data aceasta, analiștii Gartner nu s-au înșelat în prognoză. Dacă vizitați pagina cu SGBD-urilor pe DB-Engines, se poate observa că majoritatea liderilor se poziționează ca SGBD-uri multimodale. Același lucru se poate observa și pe pagina cu orice rating specific.mareÎn tabelul de mai jos sunt culmea SGBD-uri — lideri în fiecare dintre ratingurile specifice, care afirmă că sunt multimodale. Pentru fiecare SGBD sunt indicate modelul inițial suportat (cândva singurul) și modelele susținute acum. De asemenea, sunt incluse SGBD-uri care se prezintă ca „multimodale din start”, care nu au, conform declarațiilor creatorilor, niciun model inițial moștenit.
Modelul inițial
| Baza de date relațională | Modelele suplimentare | Graf, document |
|---|---|---|
| Oracle | Relațional | MS SQL |
| Graf*, document | Relațional | MS SQL |
| PostgreSQL | Relațional | MarkLogic |
| Document | Graf, relațional | Cheie-valoare, graf* |
| MongoDB | Graf, relațional | DataStax |
| Wide-column | Document, graf | Cheie-valoare |
| Redis | Document, graf* | Graf, document, relațional |
| ArangoDB | — | MS SQL |
| OrientDB | — | Note la tabel |
| Azure CosmosDB | — | Note la tabel |
Stelele din tabel indică afirmații care necesită precizări:
SGBD-ul PostgreSQL nu suportă modelul de date graf, însă un astfel de produs îi suportă,
- bazat pe acesta Referitor la MongoDB, este mai corect să se vorbească despre existența operatorilor grafici în limbajul de interogare (
- $lookup, Referitor la Redis, se are în vedere o extensie
- Se referă la extensia pentru Redis .
Mai departe, pentru fiecare dintre clase, vom arăta cum este implementat suportul pentru mai multe modele în SGBD-ul din această clasă. Vom considera cele mai importante modelele: relațional, documentar și grafic, iar prin exemplele unor SGBD specifice, vom arăta cum sunt realizate «modelele lipsă».
SGBD-uri multimodale bazate pe modelul relațional
Principalele SGBD de astăzi sunt cele relaționale, iar prognoza lui Gartner nu ar fi putut fi considerată realizată dacă SGBD-urile relaționale nu ar fi demonstrat progrese în direcția multimodalității. Și acestea demonstrează. În prezent, considerațiile conform cărora o SGBD multimodal ar fi ca un briceag elvețian, cu care nu poți face nimic bine, pot fi direcționate direct către Larry Ellison.
Autorului, însă, îi place mai mult implementarea multimodalității în Microsoft SQL Server, pe exemplul căruia va fi descrisă suportul pentru SGBD-urile relaționale ale modelului documentar și celor grafice.
Modelul documentar în MS SQL Server
Despre cum este implementat suportul pentru modelul documentar în MS SQL Server, pe Habr au fost deja două articole excelente, voi rezuma pe scurt și voi adăuga comentarii:
Modul de suport al modelului documentar în MS SQL Server este destul de tipic pentru SGBD-urile relaționale: documentele JSON sunt propuse a fi stocate în câmpuri text obișnuite. Suportul pentru modelul documentar constă în furnizarea de operatori speciali pentru analiza acestui JSON:
- pentru extragerea valorilor scalare ale atributelor,
- pentru extragerea subdocumentelor.
Al doilea argument al ambilor operatori este o expresie într-o sintaxă asemănătoare JSONPath.
Abstract, se poate spune că documentele stocate în acest fel nu sunt «entități de primă clasă» în SGBD-ul relațional, spre deosebire de tupluri. Concret, în MS SQL Server nu există în prezent indecși pe câmpurile documentelor JSON, ceea ce complică operațiunile de unire a tabelelor pe baza valorilor acestor câmpuri și chiar selectarea documentelor pe aceste valori. Cu toate acestea, este posibil să se creeze un câmp calculat și un index pe acesta.
În plus, MS SQL Server oferă posibilitatea de a construi ușor un document JSON din conținutul tabelelor folosind operatorul — o posibilitate, într-un sens cunoscut, opusă stocării obișnuite. Este evident că, indiferent de cât de rapidă ar fi o bază de date RDBMS, această abordare contravine ideologiei bazelor de date documentare, care, în esență, stochează răspunsuri gata pentru întrebările populare și poate rezolva doar problemele de confort în dezvoltare, dar nu și pe cele de performanță.
În cele din urmă, MS SQL Server permite abordarea inversă față de construirea documentelor: poate dezvolta JSON în tabele folosind . Dacă documentul nu este complet plat, va fi necesar să folosești UNPIVOT.
Modelul grafic în MS SQL Server
Suportul pentru modelul grafic (LPG) este implementat în Microsoft SQL Server într-un mod destul de : se propune utilizarea unor tabele speciale pentru stocarea nodurilor și pentru stocarea arcelor graficului. Aceste tabele sunt create folosind expresiile CREATE TABLE AS NODE și CREATE TABLE AS EDGE corespunzător.
Tabelele de tipul întâi sunt asemănătoare tabelelor obișnuite pentru stocarea înregistrărilor, cu singura distincție externă că în tabel există un câmp sistematic $node_id — un identificator unic în cadrul bazei de date pentru nodul grafic.
În mod similar, tabelele de tipul doi au câmpuri sistemice $from_id și $to_id, înregistrările din aceste tabele definesc în mod evident relațiile între noduri. Pentru stocarea relațiilor fiecărui tip se folosește o tabelă separată.
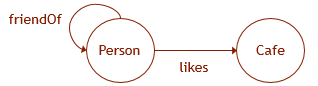 Să ilustrăm cele spuse cu un exemplu. Să presupunem că datele grafice au o schemă ca în imaginea prezentată. Atunci, pentru a crea structura corespunzătoare în baza de date, trebuie să executăm următoarele comenzi DDL:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Specificitatea principală a acestor tabele constă în faptul că în interogările către ele este posibil să se utilizeze modele grafice cu o sintaxă similară Cypher (de altfel, „*” și altele de acest tip nu sunt încă acceptate). Pe baza măsurătorilor de performanță, se poate de asemenea presupune că metoda de stocare a datelor în aceste tabele este diferită de mecanismul de stocare a datelor în tabele obișnuite și optimizată pentru a realiza astfel de interogări grafice.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
În plus, este destul de greu să nu se utilizeze aceste modele grafice atunci când se lucrează cu astfel de tabele, deoarece în interogările SQL obișnuite, pentru a rezolva probleme analogice, va fi nevoie de eforturi suplimentare pentru a obține identificatorii «grafici» ai nodurilor sistemului ($node_id, $from_id, $to_id; din același motiv, interogările pentru inserarea datelor nu sunt incluse aici deoarece ar fi prea voluminoase).
Concluzionând descrierea realizărilor modelelor documentare și grafice în MS SQL Server, aș sublinia că astfel de realizări ale unei modele deasupra alteia nu par a fi fericite, în primul rând din perspectiva designului lingvistic. Este necesar să se extindă un limbaj cu altul, limbajele nu sunt complet «ortogonale», iar regulile de combinare pot fi destul de ciudate.
SGBD-uri multimodale bazate pe modelul documentar
În această secțiune, doresc să ilustrez implementarea multimodalității în DBMS-uri documentare folosind exemplul nu celei mai populare dintre ele, MongoDB (așa cum s-a spus, în ea există doar operatori grafici condiționați $graphLookup și ), decât despre suportul pentru modelul grafic, deși, desigur, introducerea lor a necesitat anumite optimizări la nivelul stocării fizice în direcția suportului pentru modelul grafic., care nu funcționează pe colecțiile partajate), ci folosind un DBMS mai matur și «enterprise» .
Așadar, să presupunem că colecția conține un set de documente XML de următorul tip (MarkLogic permite de asemenea stocarea documentelor JSON):
John
  Smith
Modelul relațional în MarkLogic
Reprezentarea relațională a colecției de documente poate fi creată folosind (conținutul elementelor valoare în exemplul de mai jos poate fi orice XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
La reprezentarea creată se poate adresa printr-o interogare SQL (de exemplu, prin ODBC):
SELECT name, surname FROM Person WHERE name="John"Din păcate, reprezentarea relațională creată prin șablon de mapare este disponibilă doar pentru citire. Când se procesează o interogare pe ea, MarkLogic va încerca să utilizeze . Anterior, în MarkLogic existau și reprezentări relaționale limitate, complet și disponibile pentru scriere, dar acum sunt considerate învechite.
Modelul grafic în MarkLogic
Cu suport pentru modelul grafic (RDF), situația este destul de asemănătoare. Din nou, cu ajutorul se poate crea o reprezentare RDF a colecției de documente din exemplul de mai sus:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Se poate adresa o interogare SPARQL graficului RDF obținut:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Spre deosebire de modelul relațional, modelul grafic MarkLogic este susținut prin două alte metode:
- DBMS-ul poate fi un depozit RDF de date complet funcțional (triplele vor fi denumite în contrast cu cele descrise mai sus ).
- RDF poate fi pur și simplu inclus în documente XML sau JSON (iar triplele vor fi denumite ). Probabil, aceasta este o alternativă la mecanismele
idrefși altele.
O idee bună despre cum este „de fapt” totul în MarkLogic oferă , în acest sens este de nivel inferior, deși scopul său este mai degrabă invers — de a încerca să se abstreze de modelul de date utilizat, asigurând o funcționare consistentă cu datele în diferite modele, tranzacționalitate etc.
SGBD-uri multimodale „fără model principal”
Pe piață sunt de asemenea DBMS-uri care se poziționează ca fiind inițial multimodale, fără niciun model principal moștenit. Printre acestea se numără , (din 2018, compania-dezvoltator aparține SAP) și (serviciu parte a platformei cloud Microsoft Azure).
De fapt, modelele „principale” în ArangoDB și OrientDB există. În ambele cazuri, sunt modele proprii de date, care sunt generalizări ale modelului documentar. Generalizările constau în principal în facilitarea posibilității de a efectua interogări de natură grafică și relațională.
Aceste modele sunt singurele disponibile pentru utilizare în SGBD-urile indicate, iar pentru a lucra cu ele sunt destinate limbaje proprii de interogare. Desigur, astfel de modele și SGBD-uri sunt promițătoare, însă lipsa compatibilității cu modelele și limbajele standard face imposibilă utilizarea acestor SGBD-uri în sistemele moștenite — înlocuirea SGBD-urilor deja utilizate acolo.
Despre ArangoDB și OrientDB a mai fost un articol minunat pe Habr: .
ArangoDB
ArangoDB declară suportul pentru modelul grafic de date.
Nodurile graficului în ArangoDB sunt documente obișnuite, iar muchiile sunt documente de tip special, având alături de câmpurile sistemice obișnuite (_key, _id, _rev) câmpuri sistemice _from și _to. Documentele în SGBD-urile de documente sunt tradițional grupate în colecții. Colecțiile de documente care reprezintă muchii, în ArangoDB, se numesc colecții edge. Apropo, documentele colecțiilor edge sunt, de asemenea, documente, așa că muchiile în ArangoDB pot acționa și ca noduri.
Datele originale
Să considerăm că avem o colecție persons, documentele căreia arată astfel:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Să mai avem și o colecție cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Atunci colecția likes poate arăta astfel:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Interogări și rezultate
O interogare în stil grafic în limbajul AQL utilizat în ArangoDB, care returnează informații despre cine ce cafea îi place, arată astfel:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
În stil relațional, când mai degrabă „calculăm” relațiile, nu le stocăm, această interogare poate fi rescrisă astfel (apropos, fără colecția likes s-ar fi putut evita):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Rezultatul în ambele cazuri va fi același:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Încă interogări și rezultate
Dacă pare că formatul rezultatului de mai sus este mai caracteristic pentru un SGBD relațional decât pentru unul documentar, poți încerca următoarea interogare (sau poți utiliza ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Rezultatul va avea următorul aspect:
[
  { "person" : "Alisa" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
La baza implementării modelului grafic peste documentar în OrientDB se află câmpurile documentelor ar trebui să aibă, pe lângă valori scalare mai mult sau mai puțin standard, și valori de tipuri precum LINK, LINKLIST, LINKSET, LINKMAP și LINKBAG. Valorile acestor tipuri sunt linkuri sau colecții de linkuri către ai documentelor.
Identificatorul de document atribuit de sistem are un "sens fizic", indicând poziția înregistrării în bază, și arată aproximativ astfel: @rid : #3:16. Astfel, valorile proprietăților referință sunt cu adevărat mai degrabă indicii (ca în modelul grafic), nu condiții de selecție (ca în relațional).
Ca și în ArangoDB, în OrientDB muchiile sunt reprezentate ca documente separate (deși, dacă o muchie nu are propriile proprietăți, poate fi , iar pentru ea nu va exista un document separat).
Datele originale
Într-un format similar cu al bazei de date OrientDB, datele din exemplul anterior pentru ArangoDB ar arăta aproximativ astfel:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alisa",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Așa cum vedem, nodurile păstrează și informații despre muchiile intrante și externe. API-ul documentelor pentru integritatea referințelor trebuie să fie monitorizat manual, în timp ce Graph API își asumă această responsabilitate. Să vedem însă cum arată apelurile către OrientDB în limbajele de interogare "pure", care nu sunt integrate în limbaje de programare.
Interogări și rezultate
O interogare, similară cu cea din exemplul pentru ArangoDB, în OrientDB arată astfel:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Rezultatul va fi obținut în următorul format:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Dacă formatul rezultatului pare din nou prea "relațional", trebuie să eliminăm linia cu :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Limbajul de interogare OrientDB poate fi caracterizat ca SQL cu inserții asemănătoare Gremlin. În versiunea 2.2 a apărut o formă de interogare asemănătoare Cypher, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Formatul rezultatului va fi același ca în interogarea anterioară. Gândiți-vă la ce ar trebui să eliminați pentru a-l face mai "relațional", așa cum era în prima interogare.
Azure CosmosDB
Într-o măsură mai mică, cele spuse mai sus despre ArangoDB și OrientDB se aplică Azure CosmosDB. CosmosDB oferă următoarele API-uri de acces la date: SQL, MongoDB, Gremlin și Cassandra.
API-ul SQL și API-ul MongoDB sunt utilizate pentru accesul la date în modelul documentar. API-ul Gremlin și API-ul Cassandra sunt pentru accesul la date în modelele grafic și coloanal, respectiv. Datele din toate modelele sunt stocate în formatul modelului intern CosmosDB: („atom-record-sequence”), care este de asemenea apropiat de cel documentar.
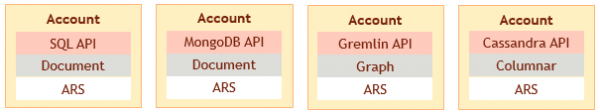
Dar modelul de date ales de utilizator și API-ul utilizat sunt stabilite în momentul creării contului în serviciu. Nu este posibil să accesați datele încărcate într-un model în formatul unui alt model, ceea ce ar fi ilustrat printr-un desen de genul:
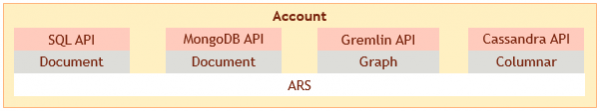
Astfel, multimodalitatea în Azure CosmosDB reprezintă, în prezent, doar o posibilitate de a utiliza mai multe baze de date, care susțin diverse modele, de la același furnizor, ceea ce nu rezolvă toate problemele stocării variate.
SGBD-uri multimodale bazate pe modelul grafic?
Este demn de menționat că pe piață nu există încă SGBD-uri multimodale care să aibă la bază un model grafic (cu excepția multimodalității ce suportă simultan două modele grafice: RDF și LPG; vezi despre aceasta în ). Cele mai mari dificultăți sunt întâmpinate în implementarea unui model de documente pe o structură grafică, nu relațională.
Întrebarea despre cum să implementăm un model relațional pe o structură grafică a fost discutată încă din primele zile ale acesteia. Cum , de exemplu, :
Nu există nimic inerent în abordarea grafică care să împiedice crearea unei straturi (de exemplu, prin indexare adecvată) pe o bază de date grafică care să permită o viziune relațională cu (1) recuperarea tuplurilor din perechile obișnuite de cheie-valoare și (2) gruparea tuplurilor după tipul de relație.
În implementarea modelului de documente pe o structură grafică, trebuie să avem în vedere, de exemplu, următoarele:
- Elementele unui array JSON sunt considerate ordonate, dar cele care provind din vârful unei muchii a graficului nu sunt;
- Datele din modelul de documente sunt de obicei denormalizate, nu vrem totuși să păstrăm mai multe copii ale aceluiași document încorporat, iar subdocumentele nu au de obicei identificatori;
- Pe de altă parte, ideologia bazelor de date de tip document este aceea că documentele sunt „agregate” complete, care nu trebuie reconstruite de fiecare dată. Este necesar să se asigure în modelul grafic posibilitatea de a obține rapid un subgrafic corespunzător unui document complet.
Puțină publicitate
Autorul articolului este implicat în dezvoltarea SGBD-ului NitrosBase, al cărui model intern este grafic, iar modelele externe – relațional și de documente – sunt reprezentările sale. Toate modelele sunt egale: practic orice date sunt accesibile în oricare dintre ele folosind un limbaj de interogare natural pentru acesta. Mai mult, în orice reprezentare datele pot fi schimbate. Modificările se vor reflecta în modelul intern și, prin urmare, și în celelalte reprezentări.
Cum arată corespondența modelelor în NitrosBase – voi descrie, sper, într-unul dintre articolele următoare.
Concluzie
Sper că contururile generale ale a ceea ce se numește multimodalitate au devenit oarecum clare cititorului. SGBD-urile multimodale sunt destul de diferite între ele, iar „suportul pentru mai multe modele” poate arăta diferit. Pentru a înțelege ce se numește „multimodalitate” în fiecare caz particular, este util să răspundem la următoarele întrebări:
- Se vorbește despre suportul pentru modele tradiționale sau despre un anumit model „hibrid”?
- Sunt modelele „egale în drepturi”, sau una dintre ele este supusă altora?
- Sunt „indiferente” modelele una față de cealaltă? Poate datele scrise într-un model să fie citite în altul sau chiar să fie suprascrise?
Cred că răspunsul la întrebarea privind relevanța sistemelor de gestionare a bazelor de date multimodale poate fi deja unul pozitiv, dar este interesant de știut care dintre aceste tipuri vor fi mai căutate în viitorul apropiat. Se pare că vor fi mai solicitate sistemele de gestionare a bazelor de date multimodale care suportă modele tradiționale, în primul rând cel relațional; popularitatea sistemelor de gestionare a bazelor de date multimodale care oferă noi modele, ce combină avantajele diferitelor tradiționale, este un subiect pentru viitorul mai îndepărtat.
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
Utilizați sisteme de gestionare a bazelor de date multimodale?
Nu folosim, stocăm totul într-o singură SGBD și într-un singur model
Folosim capacitățile multimodale ale SGBD tradiționale
Practicați stocarea poliglotă (polyglot persistence)
Folosim noi SGBD multimodale (Arango, Orient, CosmosDB)
Au votat 19 de utilizatori. S-au abținut 4 utilizatori.
Sursa: habr.com
