

Este amuzant cum povestea lansărilor modelelor deschise pentru transformarea sugestiilor în text în imagini, dezvoltate și antrenate de compania Stability AI, seamănă cu o serie de succese și eșecuri ale versiunilor de sistem de operare Microsoft. După faimosul succes al XP, amintim, a apărut problematicul Vista; apoi minunatul „7” — iar după el, Windows 8, lipsit de foloase. La Stable Diffusion, după o versiune inițial neatractivă, dar îmbunătățită treptat de entuziaști, 1.5, a urmat versiunea SD 2.0, care a fost evident un eșec — un eșec, de fapt, deoarece a inclus un encoder OpenCLIP atipic pentru astfel de modele. din . În cadrul acestei selecții, au fost exclude nu doar referințele vizuale inadecvate (NSFW), ci și operele de artă și ilustrațiile realizate de artiști renumiți, cum ar fi binecunoscutul Greg Rutkowski. Tocmai acest aspect i-a enervat pe entuziaști: pentru SD 1.5, chiar și în varianta inițială, fără aplicarea unor checkpoint-uri atent antrenate, funcționau perfect sugestiile simple cu stiluri — „peisaj epic medieval fantastic, în stilul lui Greg Rutkowski” — rezultatul fiind impresionant, în timp ce SD 2.0 a încetat să „recunoască” numele celor mai bine cunoscuți ilustratori, ale căror drepturi de autor asupra operelor create sunt în continuare valabile și care nu s-au sinchisit să ofere aceste opere pentru antrenarea IA. A fost necesar să folosești mai multe cuvinte pentru a descrie dorințele, iar cu sugestiile prea lungi, modelul se descurca prost.
S-au așezat — s-au ridicat, s-au așezat — s-au ridicat
În combinație cu un codificator modificat (transformatorul care convertește sugestiile textuale în jeturi digitale, cu care modelul lucrează ulterior), imposibilitatea de a aplica stiluri numite a lipsit pur și simplu entuziaștii de motivația de a îmbunătăți „două”. Chiar așa: aici a fost necesar să înțelegem, în paralel, cum să adaptăm tehnica deja utilizată pentru sugerarea mesajelor la noul codificator și să reînvățăm modelul să recunoască acele imagini și teme cu care creatorii nu l-au familiarizat în etapa inițială de antrenament - iar diferențele calitative față de „1.5” în imagini generate de „2” totuși nu erau garantate. Da, a avut loc o avansare calitativă de la dimensiunea standard SD 1.5 de 512×512 pixeli la 768×768, dar până atunci comunitatea folosea deja upscalere, outpaintere și alte unelte pentru a crește dimensiunile imaginilor finale, așa că SD 2.0 a trecut, în mare parte, neobservată. (dezvoltat de OpenAI și utilizat, printre altele, în proiectul DALL-E) — codul său este, de asemenea, deschis, dar baza de date pe care a fost antrenat, , este proprietară. În plus, dimensiunea standard a canvasului a crescut de la «Oversize» la 1024×1024, plus a apărut o serie de îmbunătățiri suplimentare - așa că entuziaștii s-au apucat cu plăcere de îmbunătățirea sa. Și în prezent, SDXL (da, au apărut recent derivate mai puțin exigente față de „hardware”, cum ar fi și ) poate fi considerat cu încredere cel mai popular generator de imagini AI cu cod deschis. Totuși, susținătorii pasionați ai SD 1.5 contestă acest lucru în mod argumentat, subliniind că instrumente atât de importante precum ControlNet, în SDXL .
Și astfel, începând cu 12 iunie 2024, odată cu „lansarea în sălbăticie” a codului modelului care permite generarea locală, ar fi trebuit să vină vremea versiunii „deschise” SD 3 - mai exact, (SD3M sau SD3 2B) cu 2 miliarde de parametri operativi. Așadar, să reamintim, acest număr corespunde numărului total de greutăți pe intrările tuturor perceptronilor modelului. Cu mult înainte, în aprilie, Stability AI a finalizat și a oferit pentru utilizare comercială varianta cu 8 milioane de parametri , aceasta fiind SD3 8B. La SDXL 1.0, reamintim, — , totuși SD3M, conform dezvoltatorilor, este . Se refereau la faptul că, având cerințe mai mici decât „Oversize” în ceea ce privește memoria video, aceasta ar trebui să furnizeze imagini „cu un nou nivel de fotorealism” chiar și în răspuns la sugestii simple. Printre avantajele „trio-ului” s-au numărat, de asemenea, „calitatea fără precedent a tipografiei textului generat în imaginile generate”, „înțelegerea aprofundată a sugestiilor prin colaborarea a trei codificatori” și „gata pentru reantrenare eficientă chiar și pe seturi de date limitate”.
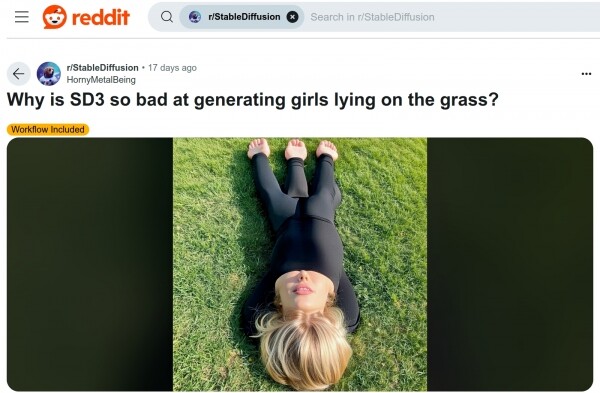
Era de așteptat ca comunitatea entuziștilor, având la dispoziție noua jucărie așteptată de mult timp, să se apuce să o îmbunătățească cu aceeași ardoare ca în cazul „Mitelor” și „Oversize” pe vremuri. Totuși, încă de la început, lucrurile nu au mers cum trebuie: SD3M a reușit în primele ore după publicarea fișierelor modelului pe Hugging Face și Civitai audiența sa, și asta de două ori. Prima dată — o idiosincrazie inexplicabilă față de sugestii care includeau o frază aparent inofensivă „ținând la / în iarbă” (lying on/in the grass); a doua — formulări extrem de vagi în termenii și condițiile acordului de utilizare, cu care nu s-au descurcat nici avocații profesioniști. Și deși din perspectiva unui entuziast obișnuit, acest ultim aspect pare nesemnificativ, pe dezvoltarea ulterioară a modelului, exact partea legală a problemei se va reflecta în cel mai direct mod — până la punctul în care ar putea să nu urmeze nicio dezvoltare.
Creațiile anterioare Stable Diffusion cu cod deschis (mai precis, cu valori deschise ale greutăților rețelei neuronale, disponibile pentru descărcare gratuită și execuție locală), cum ar fi SDXL, au fost însoțite de una dintre tipicile pentru modelele generative cu caracteristici precum „licență de autor nelimitată, globală, neexclusivă, gratuită, nerespinsă, irrevocabilă pentru reproducere, pregătire, demonstrări publice, performanțe publice, sublicențiere și distribuție a materialelor suplimentare atât ale modelului în sine, cât și a derivatelor sale”. „Troika” prevede două tipuri de licențiere: — cu formulări destul de relaxante precum „Stability AI vă oferă o licență neexclusivă, globală, netransferabilă, care nu poate fi sublicențiată, revocabilă, gratuită și limitată pentru proprietatea intelectuală” — și .
Iar iarba nu va duce la bine
După o perioadă scurtă, comunitatea a ajuns la concluzia că . Și, în esență, a declarat un boicot împotriva companiei dezvoltatoare, neavând chef să piardă timp și resurse pentru a antrena o modelă evident neterminat și imperfect rafinată — conștientizând că Stability AI poate, în orice moment, dintr-o simplă capriciu a mediatorilor săi, să retragă licența acordată anterior unui anumit entuziast care efectuează această antrenare. Contractul de licență este formulat astfel încât cei care îl studiază, neavând pregătirea juridică, să aibă impresia că, odată cu retragerea acordului pentru utilizare comercială a SD3M, fostul său titular ar fi obligat să ștergă toate derivatele create din proprietatea intelectuală licențiată, inclusiv modelele antrenate (LoRA, versiuni textuale, întregi checkpoint-uri) și derivativele acestora (citat: „La încetarea acestui Acord, veți șterge și veți opri utilizarea oricărui Produs Software sau Lucrări Derivate”) — adică roadele muncii altor persoane care au folosit aceste modele derivate ca punct de plecare pentru propria lor lucrare; și, în plus, neplătite de nimeni, realizate din pură entuziasm.
Curând după ce valul de indignare pe această temă a atins înălțimi stratosferice, au început să apară mesaje din partea juriștilor profesioniști, Și că recenzia cu interdicția ulterioară de utilizare ar trebui să se refere doar la anumite produse auxiliare cu cod închis, pe care Stability AI le va transmite utilizatorului comercial (de exemplu, pentru a accelera și optimiza aceeași preantrenare SD3M), — însă compania nu a oferit până acum clarificări finale în acest sens. Iar faptul că există un asemenea tăcere apăsătoare de trei săptămâni (la momentul redactării acestui articol) de la apariția „troicii” în acces deschis, afectează reputația dezvoltatorului mult mai grav decât iarba — generată de creația sa care înfățișează fete.
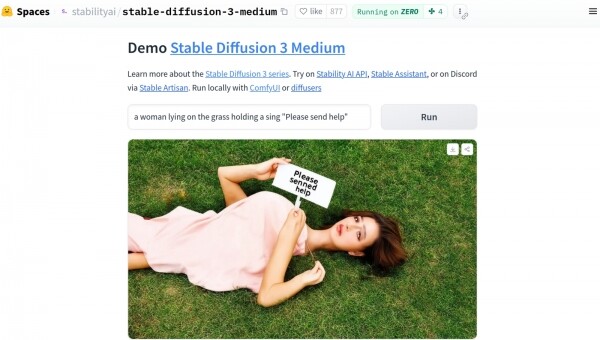
Cât despre binecunoscuta iarba, care a reușit să devină, în doar câteva ore, un meme , iar apoi pe aproape toate platformele mai mult sau mai puțin relevante de pe internet, s-a dovedit că prezența în sugestie a unei fraze precum „o fată întinsă pe iarbă” duce la apariția în rezultatele „troicii” nu doar a halucinațiilor, ci și a unor născociri de coșmar ale unei fantezii bolnave — în sens medical — a artiștilor și cineaștilor specializați în body horror (vă implorăm, dacă rațiunea și viața vă sunt dragi, — feriți-vă de asemenea și nu încercați să introduceți această frază în bara de căutare a imaginilor fără filtrul de siguranță dezactivat). Totuși, imaginile cu oameni în picioare — și într-o măsură mai mică, ce stau — ies „troicii” cu un patru cu plus convingător, iar portretele uneori sunt impecabile; cel puțin, nu mai proaste decât ale modelului de bază SDXL 1.0, — problema constă în felul unui tabu intern legat de poziția orizontală a corpului uman.
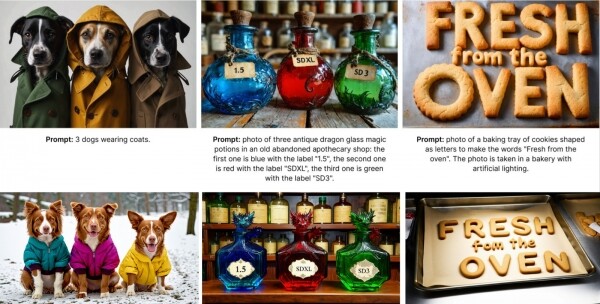
Judecând după comentariul lui Emad Mostaque, fondatorul și fostul (până în martie 2024) șef al Stability AI, care a părăsit compania pentru a , violența brutală asupra SD3M chiar înainte de deschiderea acesteia pentru utilizare limitată necomercială (API-ul modelului mai mare SD3 8B pentru generare online, amintim, , dar greutățile acesteia rămân ascunse) a fost o consecință a dorinței actualei conduceri de a asigura siguranța — , formulate încă din martie anul acesta ca . În cadrul acestei politici, utilizarea modelului generativ SD3M interzice utilizatorilor să „comită, promoveze, faciliteze, încurajeze, planifice, inciteze sau contribuie la violența, terorismul sau crearea de conținut care incită la ură, discriminând sau amenințând un grup protejat de oameni (fie că este vorba de sex, etnie, identitate sau orientare sexuală, religie sau altele)”, așa că nu vrem imagini cu urși panda, așa cum îi găsești când luptă cu dragoni furioși! Doar pisicuțe în pălării amuzante, câini în jachete drăguțe, sticle cu conținut misterios și fursecuri proaspăt scoase din cuptor!
Din punct de vedere tehnic, poate că simplificarea modelului a constat în excluderea din setul de date de antrenament a imaginilor cu oameni întinși și alte imagini care ar putea sugera o interpretare indecentă, - și astfel, acum „trei” pur și simplu „nu înțelege” semnificația cuvântului „a sta întins”. Sau poate arhitectura actualizată SD3 a permis identificarea suficient de sigură a greutăților pe perceptroni activati în timpul generării de imagini „nesigure”, iar aceste greutăți au fost pur și simplu resetate selectiv înainte de lansare, având ca efect secundar „halucinația forțată”. Probabil, : codificatorul traduce corect textul în tokeni, dar în spațiul latent „dezinfectat” acești tokeni nu mai indică un lucru specific, - și, prin urmare, pixelii rezultanți se așază pe imagine într-un mod aleatoriu.
Având în vedere disponibilitatea API-ului pentru modelul SD3 8B complet, dar închis, de câteva luni și asigurările entuziaste ale managerilor media de la Stability AI că modelul „compactificat” 2B , entuziaștii desenului AI au întâmpinat lansarea publică a greutăților SD3M pe 12 iunie cu mult entuziasm: . În prezent, este în continuare posibil să o obții, chiar dacă printr-o cale puțin mai complicată decât cea obișnuită pentru checkpoint-urile SDXL și SD 1.5. De fapt, calea obișnuită este să te adresezi site-ului Civitai, de unde majoritatea modelelor sunt descărcate fără înregistrare, dar din 17 iunie și până în momentul în care acest articol a fost transmis pentru tipar, pagina dedicată «trio» de pe acest site . Iar motivul este unul: licența comercială pentru SD3M este formulată într-un limbaj atât de neclar, încât chiar și avocații de la Civitai au luat o pauză pentru a o studia mai atent. Deoarece dacă un anumit entuziast antrenează pe PC-ul său LoRA pentru «trio» și o publică pe Civitai, iar Stability AI decide că rezultatul este necorespunzător și îi revocă licența celui vinovat, — cum ar trebui să procedeze site-ul-gazdă? Acesta nu doar că găzduiește checkpoint-uri, grafice auxiliare și modele, dar oferă și vizitatorilor posibilitatea de a genera imagini în cloud și de a antrena aceleași LoRA, inversiuni textuale și altele. În general, până la pronunțarea instanței, fișierele modelului propriu-zis și cele trei convertizoare de text în tokeni incluse în pachet pot fi obținute doar .
Să ne apucăm de treabă
Adevărul este că există un detaliu: pentru a avea acces la linkurile de descărcare, trebuie să te autentifici pe site și apoi să confirmi acceptarea menționatului mai devreme acord de licență draconian — totuși, această procedură este gratuită și complet accesibilă din Rusia. În total, sunt disponibile patru opțiuni de modele (models) propriu-zise și patru conversoare de sugestii textuale în tokeni (encoders), plus trei grafice standard pentru execuția în mediu de lucru ComfyUI, :
modele:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
codificatori:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
grafice:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
În cadrul acestei „Ateliere”, ne vom limita la modelul de bază sd3_medium.safetensors (4,2 GB), trei codificatori — clip_g.safetensors (1,3 GB), clip_l.safetensors (234 MB) și t5xxl_fp8_e4m3fn.safetensors (4,7 GB), precum și la ciclul de lucru sd3_medium_example_workflow_multi_prompt.json. Motivul este că pe mașina noastră de testare este instalată, să reamintim, o placă video GeForce GTX 1070 cu 8 GB de memorie video RAM, iar în acest volum nu pot fi încărcate modele mai mari cu toate transformatoarele integrate deodată. La punctele de control bazate pe SD 1.5 și SDXL, codificatorii sunt în mod implicit încorporați în fișierul principal, dar în acest caz acești transformatori sunt trei, având, în total, peste 6 GB, astfel că împreună cu modelul în sine depășește 10 GB; iar dacă luăm în considerare versiunea pe 16 biți a codificatorului T5XXL, va fi necesară o placă video și mai puternică. În varianta în care mai întâi sunt încărcate în memoria video transformatoarele de text în tokenuri, iar apoi modelul care lucrează cu aceste tokenuri, se poate folosi chiar și un adaptor grafic de 6 GB. Din acest punct de vedere, modul „trei” câștigă fără îndoială față de un punct de control tipic SDXL de 5-7 GB.
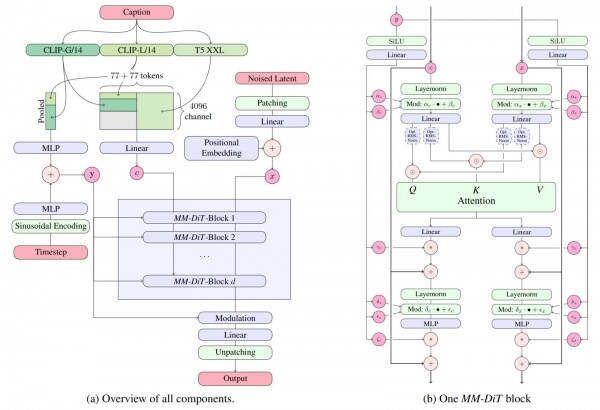
SD3M reprezintă un model bazat pe transformatoarele de difuzie multimodale () — și astfel se diferențiază fundamental de dezvoltările anterioare ale Stability AI (și nu numai ale acesteia), care se bazează pe „Atelierul” nu este locul pentru a studia în profunzime diferența dintre aceste abordări ale generării de imagini prin IA; să spunem doar că , capacitatea sa de a lucra cu un număr mai mare de tokenuri (ceea ce, la rândul său, le permite operatorilor să formuleze sugestii textuale destul de detaliate, iar sistemului — să le urmeze cu precizie), precum și o calitate mai bună a imaginilor obținute la final. SD3 8B este capabil să genereze imagini pe o pânză de 4 Mpix (2048×2048 pixeli), precum și în astfel de parametri ca reproducerea textului în imagine, precizia corespondenței imaginii obținute cu sugestia textului și estetica vizuală generală. Transformarea textului în vectori de tokenuri se face aici prin intermediul a trei codificatori ( și un T5-XXL — „T5”, de altfel, de la ) — și, în general, nu sunt obligați să lucreze cu același prompt.
Dar destule introduceri: să ne ocupăm de ceea ce este dedicat „Atelierului”, — generarea de imagini pe baza modelului SD3M. Vom folosi pentru aceasta, așa cum s-a menționat, mediul de lucru ComfyUI, pe care îl putem descărca . Să subliniem că această variantă este disponibilă doar pentru execuția pe adaptoare grafice NVIDIA sau direct pe CPU AMD sau Intel (ceea ce va fi, desigur, de câteva ori mai lent): proprietarii de plăci grafice AMD rocm și pytorch, care pot fi instalate prin managerul de pachete pip.
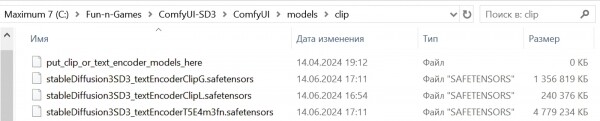
După finalizarea instalării mediului de lucru, ar trebui să plasăm fișierele .safetensors descărcate anterior: modelele — în directorul ComfyUImodelscheckpoints, conversorii de text în tokeni — în ComfyUImodelsclip. Și — putem începe!
E timpul să accelerăm
Merită menționat că AUTOMATIC1111, bine cunoscut cititorilor anterioarelor „Ateliere” pe tema desenării AI, a obținut la sfârșitul lunii iunie , totuși în ComfyUI suportul pentru noul model rămâne cel mai complet. Nu este surprinzător — deoarece până de curând, autorul „monstrului de paste”, cunoscut comunității de entuziaști sub numele de ComfyAnonimous, sau pur și simplu Comfy, , unde a lucrat, în special, la mediul de lucru intern folosit de dezvoltatori. Așa cum vom vedea un pic mai târziu, cea mai recentă versiune ComfyUI arată cu adevărat că autorul său are anumite informații privilegiate despre cum este structurat și funcționează acest model controversat — informații pe care creatorii altor medii de lucru pentru execuția locală a Stable Diffusion 3 Medium, din motive evidente, nu pot să le prezinte.
Instalarea ComfyUI în versiune portabilă pe Windows este foarte simplă: după descărcarea arhivei ZIP corespunzătoare E suficient să-l dezarhivezi într-un director convenabil; de preferat, desigur, pe un volum logic bazat pe SSD, nu pe HDD, având în vedere schimbul între unitate și memorie, ținând cont de ciclurile viitoare de încărcare și descărcare a modelului chiar și pentru generarea unei singure imagini (mai întâi, mediu trebuie să plaseze în memoria video convertoarele de text în tokeni, apoi să curețe memoria video și să încarce efectiv SD3M) se așteaptă a fi mai mare, cu cât mai puțină memorie video are la dispoziție acest computer. Apropo, instalarea portabilă este benefică și prin independența sa completă: nimic — cu excepția cantității de spațiu liber pe discul logic — nu împiedică desfășurarea locală a oricâtor copii ComfyUI, pentru a experimenta cu diverse extensii, fără teama de a strica deja o sistemă bine ajustată și care funcționează excelent.
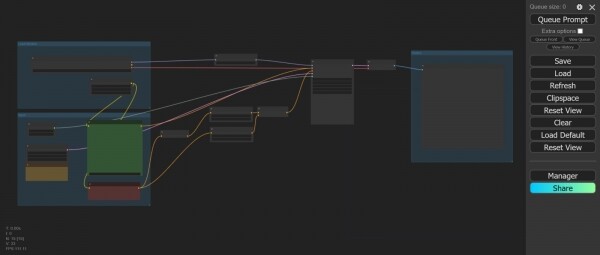
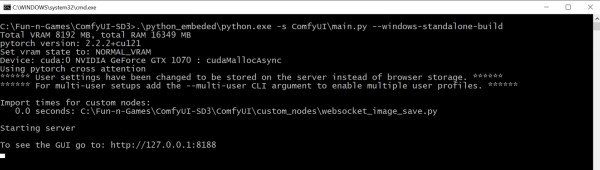
Asigurându-te că fișierul modelului principal SD3M fără encoder de text în tokeni (fișierul stableDiffusion3SD3_sd3Medium.safetensors, 4,2 GB) este plasat în subdirectorul checkpoints (în cazul instalării noastre de test, calea completă este C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), iar cele trei modele ale encoderului (fișierele stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors și stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors; 1,3 GB, 234 MB și 4,7 GB respectiv) — în subdirectorul clip (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), poți lansa mediul de lucru printr-un dublu clic pe fișierul run_nvidia_gpu.bat din directorul rădăcină (în cazul nostru C:Fun-n-GamesComfyUI-SD3). După pornirea serverului, în fereastra de comandă Windows care apare, în browserul implicit se va deschide automat o nouă filă (aceasta este presupusă de setările fișierului BAT), unde la adresa 127.0.0.1/8188 va fi disponibil interfața web. (deși doar într-o primă aproximare) «monstrul spaghetă».
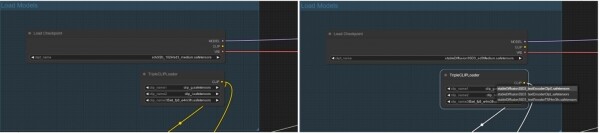
În principiu, dacă aveți la dispoziție o placă video NVIDIA mai modernă (din generația RTX, nu GTX, chiar și cu 6 GB de RAM video), puteți încărca imediat în mediul de lucru fluxul de lucru de bază realizat de ComfyAnonimous, despre care s-a vorbit deja, — fișierul comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json cu mai multe feronerie pentru introducerea sugestiilor, câte una pentru fiecare dintre cele trei codificatoare, — și să lucrați cu el. Totuși, va trebui mai întâi să aduceți numele a patru fișiere de model (în nodurile lor de încărcare) în conformitate cu cele disponibile. Autorul acestui flux de lucru a operat, evident, la locul său de muncă (în Stability AI, așa cum s-a menționat anterior) cu fișierele locale disponibile, care aveau denumiri puțin diferite, astfel că, dacă apăsați butonul „Queue Prompt” în interfața spartaneană ComfyUI imediat după încărcarea fluxului de lucru, mediul de lucru va returna un mesaj de eroare.
Teren de trei culturi pentru generarea AI
Totuși, aceasta nu este dificil de corectat: mult mai descurajant este faptul că placa noastră GTX 1070, care a văzut zile mai bune, procesează SD3M într-un mod extrem de lent — generarea imaginii durează între 27-30 de secunde pentru fiecare iterație, iar, având în vedere că parametrul „Steps” din fluxul de lucru de bază este setat la „28”, timpul necesar este nejustificat de mare. Prin urmare, să facem o mică optimizare — să folosim modulul Python venv (), care este destinat, printre altele, să accelereze munca modelelor AI generative. În kitul de livrare al versiunii portabile ComfyUI nu este inclus, , care se reduc la desfășurarea unui mediu Python complet pe PC-ul local — și activarea modulului necesar din acest mediu.
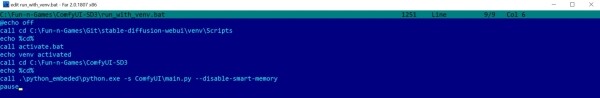
Să sperăm că cititorii care ne urmăresc „Atelierele” deja au o instalare activă a AUTOMATIC1111 pe mașinile lor. În acest caz, totul este mult mai simplu: modulul venv este deja desfășurat acolo, iar tot ce trebuie să faceți pentru a-l activa la pornirea mediului de lucru ComfyUI este să . Pentru început, trebuie să opriți serverul, făcând clic pe fereastra acestuia și apăsând „Ctrl” + „C”, apoi introduceți „y” pentru confirmare; după aceea, copiați fișierul BAT run_nvidia_gpu.bat într-un nou fișier numit, de exemplu, run_with_venv.bat. Fișierul de pornire original este destul de succint — acesta apelează pur și simplu o copie portabilă a Python cu parametrul —windows-standalone-build:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
Acest parametru nu este foarte clar — el presupune anumite optimizări, care, cel mai probabil, sunt destinate plăcilor grafice NVIDIA mai recente și, prin urmare, pot complica viața celor care încă își păstrează loialitatea față de vechile GTX. Din acest motiv, vom elimina —windows-standalone-build din linia de comandă și ne vom despărți și de altă optimizare modernă — managerul de memorie „inteligent”, smart memory, care , fără a le descărca. Acest lucru accelerează într-adevăr generarea imaginilor IA, totuși, în același timp, transformă computerul nostru moral învechit într-un sistem monopolic — nu putem naviga pe web, nu putem juca, nici măcar nu putem lucra cu documente și e-mailuri pe PC, în paralel cu activitatea mediu de lucru. Așadar, pentru cei care nu dispun de un computer dedicat pentru arta IA, un astfel de fișier BAT pentru a lansa ComfyUI (nu doar cu scopul de a genera imagini cu SD3M, de altfel — este perfect potrivit și pentru SDXL):
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
întâlnește %
call activate.bat
echo venv activated
call cd C:Fun-n-GamesComfyUI-SD3
întâlnește %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Aici se presupune că instalarea portabilă a ComfyUI a fost realizată în directorul C:Fun-n-GamesComfyUI-SD3, iar AUTOMATIC1111 a fost anterior instalat în C:Fun-n-GamesGitstable-diffusion-webui. Numeroasele „echo” sunt necesare doar pentru a monitoriza vizual dacă schimbarea directorilor se desfășoară normal și comenzile necesare sunt executate — după ce totul va fi optimizat, acestea pot fi eliminate din fișierul BAT.
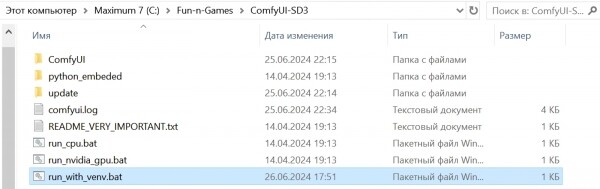
Repornim mediu de lucru, de această dată făcând dublu clic pe run_with_venv.bat. Deoarece anterior am închis doar serverul și nu am modificat interfața web, în tab-ul corespunzător ar trebui să rămână aceeași diagramă de bază ComfyUI cu numele modelelor corectate. Să ne uităm la partea dreaptă a acesteia: acolo se află nodul „Preview Image”, care nu salvează imaginea finalizată pe disc, ci o demonstrează doar. Dacă rulăm de fiecare dată diagrama pentru a genera strict o singură imagine, evaluând-o vizual, modificând parametrii și reluând, aceasta este o variantă funcțională: imaginea dorită poate fi salvată întotdeauna manual făcând clic dreapta pe ea. Dar dacă se efectuează multe generații succesive în mediu de lucru, ar fi mai bine ca rezultatele lor să fie acumulate automat în memorie permanentă (în directorul ComfyUIoutput în mod implicit).
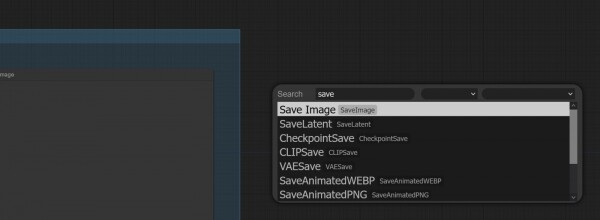
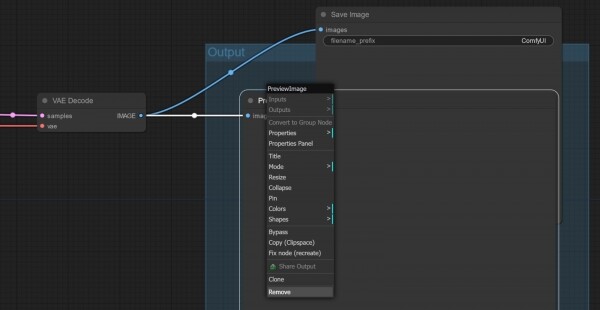
Așadar, este mai bine să schimbăm imediat nodul „Preview Image” cu „Save Image”. Pentru aceasta, facem dublu clic cu butonul stâng pe orice zonă liberă a diagramei – se va deschide o fereastră de selectare a nodurilor cu o linie de căutare. În această linie, vom începe să scriem „Save…” – și practic imediat vom vedea denumirea căutată. Apoi, nu rămâne decât să facem clic pe ea și să conectăm intrarea nodului apărut la ieșirea „IMAGE” a nodului „VAE Decode”, la care inițial a fost conectat „Preview Image”. Iar „Preview Image” poate fi ulterior eliminată – pur și simplu o selectăm făcând clic pe titlu și apăsăm tasta „Del” de pe tastatură.
Și acum – este momentul să rulăm diagrama de bază creată de ComfyAnonimous (cu corecturile noastre modeste) în execuție. Iată ce rezultă:
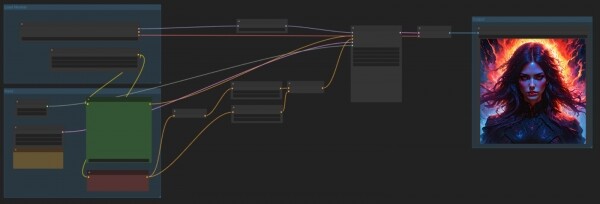
O imagine foarte impresionantă, cu chiar un pic de atmosferă, – și nu ai spune că a fost creată cu aceeași model, care complet distruge instrucțiunile de a ilustra oameni întinși pe iarbă. În același timp, sistemul funcționează destul de bine – aproximativ 5-6 secunde pe iterație pentru o imagine cu o suprafață de 1 Mpix pe GTX 1070 poate fi considerat un rezultat decent. Spre comparație: același PC în aceeași ComfyUI, cu același fișier BAT, generează imagini SDXL de dimensiuni similare, consumând aproximativ 6-7 secunde pe fiecare iterație, astfel încât „trei” poate fi considerată mai puțin exigentă cu echipamentul PC-ului pe care se desfășoară generarea IA.
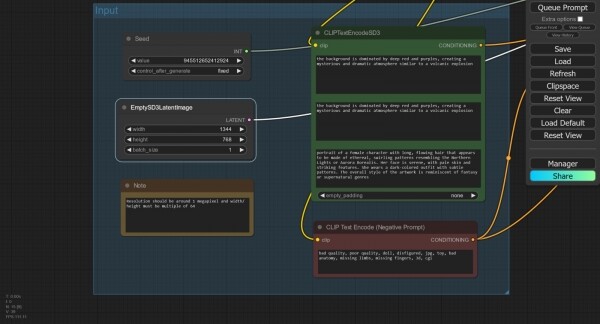
Să ajustăm acum dimensiunile pânzei. Aproape de nodul „EmptySD3LatentImage”, care le determină, se află un nod de referință „Note” care este „gol” (adică, neconectat de nici o parte), unde se află o importantă reamintire: suprafața totală a imaginii în cazul SD3M ar trebui să fie de aproximativ 1 MPix, din care ar trebui să alegem dimensiunile laturilor pânzei rectangulare. Atunci, să le setăm la 1344×768 — de fapt, aproximativ 1,03 MPix se va obține.
Să observăm: mai sus se află nodul „Seed”, unde este setată, de fapt, valoarea inițială, în acest caz „945512652412924”, și se indică faptul că aceasta nu ar trebui să se schimbe după generare (parametrul „fixed”).
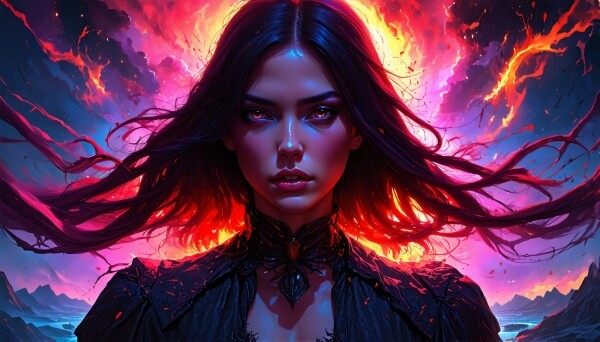
Vom executa aceeași ciclogramă cu aceeași valoare inițială, dar pentru pânza dreptunghiulară. Se observă imediat că timpul de execuție în general este mai scurt, deși viteza de redare a rămas aceeași — mai puțin de 6 secunde pe iterație. Și acest lucru este logic: deoarece sugestiile textuale nu s-au schimbat, nu este necesar să încărcați din nou codificatorul(rii) pentru acestea. Imaginea la ieșire, desigur, diferă puțin de prima, pătrată, dar nu esențial — compoziția generală, așa cum era de așteptat, a fost păstrată.
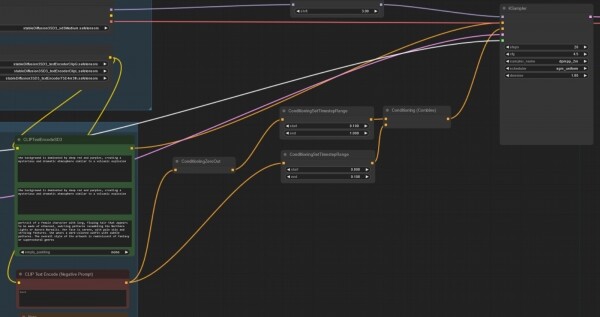
Acum să ne concentrăm asupra nodurilor „CLIPTextEncodeSD3” și „CLIP Text Encode (Negative Prompt)”. Primul se remarcă prin faptul că conține trei câmpuri de introducere; dacă eliminăm textul din acestea, vor fi vizibile notițele pentru ce codificatoare sunt destinate — de sus în jos, acestea sunt CLIP G, CLIP L și T5XXL. În trecut, noduri asemănătoare nu existau în ComfyUI, din motive evidente. Ciclograma de referință conține sugestii scurte, repetitive pentru primele două câmpuri textuale (pentru codificatoarele CLIP G și CLIP L) și una mult mai extinsă pentru al treilea — T5XXL. Este evident că conținutul acestor câmpuri poate fi manipulat în diverse limite, iar studiul modului în care modificarea textului din ele influențează imaginea finală reprezintă o sarcină complexă, dar extrem de captivantă. Totuși, din motive care vor deveni clare puțin mai târziu, nu ne vom ocupa în mod direct de aceasta pentru moment.
În nodul „CLIP Text Encode (Negative Prompt)”, pe de altă parte, nu este nimic special, — dar apreciați cât de complicat este drumul de la acesta la intrarea corespunzătoare „conditioning” a nodului principal „KSampler”! Acest drum se bifurcă, iar una dintre ramurile sale (superioară, în acest caz) indică faptul că, începând cu 10% din pașii de generație și până la finalizarea acestora, sistemul nu va lua în considerare deloc sugestia negativă (parcurgerea drumului prin nodul „ConditioningZeroOut” înseamnă exact anularea condiției). Pe de altă parte, a doua ramură trimite sugestia negativă (de asemenea, condiționată cu greutate de jumătate) pentru o procesare ulterioară fără modificări — dar doar în primii 10% din numărul total de pași de generație.
Departe și neclar
Încă o dată: primii 10%, adică 3 din 28 de pași alocați în acest caz, sugestia negativă este transmisă către nodul „KSampler”, care este ocupat cu formarea imaginii în spațiul latent (în spațiul pixelilor, adică într-o imagine perceptibilă omului, rezultatul acesteia este tradus de următorul nod, „VAE Decoder”), în mod normal: ramura superioară (cu anularea condiției) este inactivă, funcționează doar ramura inferioară. Ceilalți 90% din pași (25 din 28 în cazul nostru) nu utilizează deloc sugestia negativă: este activă tocmai ramura superioară de transmisie a condițiilor — cu anularea acestora, — iar mișcarea pe ramura inferioară este blocată de parametrul limită al nodului „ConditioningSetTimestepRange”. Acum este clar de ce unii comentatori afirmă că , — efectul acestora (dacă luăm în considerare exact această ciclogramă de referință și presupunem că aceleași reguli se aplică pe site-urile cu generație online pe modelul SD3 Medium) este minim.
Și totuși există: dacă pur și simplu conectezi direct ieșirea nodului „CLIP Text Encode (Negative Prompt)” la intrarea corespunzătoare a „KSampler” (sau marchezi toate nodurile intermediare cu condiții pe acest drum ca fiind „de ignorat”, „Bypass”, ceea ce va duce la același efect), calitatea imaginii finale se va deteriora semnificativ. Acest lucru poate fi considerat, de altfel, ca o dovadă indirectă a „necoacerii” SD3M, deoarece a regla puterea și relevanța sugestiilor negative ar fi trebuit, în mod strict, să fie în puterea dezvoltatorilor chiar înainte de a publica greutățile modelului în acces deschis. Cele două ramuri ingenios stabilite ale condițiilor de aplicare a sugestiilor negative sunt un fel de patch, și în acest sens la așteptările exagerate promovate de departamentul de marketing al Stability AI în legătură cu această, par pe deplin justificate.
Lipsa unui ghid oficial, măcar sumar, pentru utilizarea SD3M a dus la răspândirea pe internet a zvonurilor că acest model Ceea ce, desigur, nu este adevărat, dar oricum, aplicarea acestor sugestii trebuie făcută într-un mod diferit În special, entuziștii susțin cu seriozitate că adăugarea de descrieri detaliate cât mai multor obscenități în câmpul negativ (da-da, vechiul bun „nsfw, nude” nu este suficient — va trebui să ne străduim serios în imaginație) chiar și celebrei fete care stă pe iarbă. Dacă este așa sau nu — nu putem afla fără o analiză atentă (însă nu este sigur că o marcă „18+” în antetul site-ului nostru va proteja publicația de procese din partea apărătorilor moralei, dacă ne riscăm să publicăm „minunea-sugestie” compusă de entuziaști — deși aceasta este în engleză). Această situație amuzantă amintește de , prin care — exact pentru că conțineau descrieri destul de detaliate despre ce și cum nu ar trebui să facă creștinii onorabili — au ajuns până la noi măcar fragmente de dovezi scrise despre credințele și obiceiurile Rusiei precreștine.
Acum, sperăm că este mai clar de ce aprofundarea în studiul SD3M în acest stadiu nu pare a fi cea mai înțeleptă utilizare a eforturilor și timpului. Acolo există cu adevărat multe de discutat și explorat: de la parametrii de generare destul de stringent recomandați în nodul „KSampler” (CFG — 4,5-5,0; numărul de pași — aproximativ 28; perechea sampler/scheduler — exclusiv dpmpp_2m/sgm_uniform, altfel calitatea ieșirii scade semnificativ); până la variația considerabilă a calității subiective a generațiilor cu exact aceleași parametrii inițiali, dar cu apeluri diferite; și eliminarea temutului „blestem al întinderii în/asupra ierbii” (pentru care deja ); și, în esență, clarificarea asupra căror parametrii de generare influențează fiecare dintre cei trei convertoare de text în tokeni — și cum, manipulându-i, să obții opere adevărate de artă generată de AI (dacă este posibil cu „troica”, bineînțeles).
Cu atât mai mult cu cât demiterea lui Emad Mostaque în martie și a lui ComfyAnonimous în iunie, , — nu sunt singurele neplăceri care au lovit Stability AI. Potrivit Reuters, citând The Information, acest start-up britanic a schimbat literalmente (la momentul scrierii acestui articol) din nou noului director fiind Prem Akkaraju, un susținător cunoscut al unei grup global de investitori IT — iar aceștia, la rândul lor, sunt pregătiți să investească în companie o sumă considerabilă în numerar (). Situația Stability AI ca structură de afaceri este în mod clar instabilă; mulți entuziaști dezamăgiți îi prezic un sfârșit apropiat — și în această situație, este greu de așteptat o muncă atentă din partea companiei, chiar și pentru erori atât de evidente.
Politica de licențiere nelocalizată împiedică, din păcate, comunitatea să finalizeze SD3M, așa cum s-a întâmplat cu SD 1.5 și SDXL. Cel puțin, checkpoint-urile derivate și instrumentele precum LoRA pentru ultimele două modele vor rămâne garantat disponibile pentru execuția locală, chiar și când (și dacă) Stability AI își va încheia drumul ca structură comercială. Îndată după eșecul zdrobitor al „trio-ului”, au început să răsune din ce în ce mai multe voci pe forumurile de specialitate în sprijinul creării unui proiect non-profit pentru dezvoltarea unui model generativ pentru transformarea textului în imagini, bazat pe crowdfunding — iar în prezent acest demers începe să se contureze sub numele . Deja și-au exprimat disponibilitatea de a se alătura acestuia Invoke (una dintre platformele pentru generarea online de IA, orientată spre studiouri profesionale), Comfy Org (echipa care se ocupă de suportul și dezvoltarea ComfyUI), Civitai (care nu necesită prezentări) și echipa din spatele LAION (baza de date cu imagini annotate, pe care majoritatea acestor modele se antrenează).
Așadar, în perspectiva apropiată, noile lansări din „Atelier” vor fi, cel mai probabil, orientate spre lucrul cu acele modele pentru care comunitatea a reușit deja să creeze un set larg de îmbunătățiri și instrumente suplimentare — pentru „polutorkă” și „Oversize”. Poate că vremea triumfului SD3M va veni în cele din urmă — însă astăzi este greu de prezis când anume. Între timp, cei interesați pot descărca arhiva cu generațiile SD3M menționate în acest articol (ciclogramile sunt integrate direct în fișierele PNG; este suficient să tragi imaginea pe câmpul de lucru ComfyUI din „Explorer”-ul Windows pentru a reproduce întreaga ordine și parametrele generației) . Poate că cineva dintre cititorii noștri va reuși să descopere mai devreme decât utilizatorii de pe Reddit și Hugging Face o modalitate optimă de distribuire a textului pe cele trei câmpuri de sugestie, de exemplu?
Materiale pe această temă:
.
.
.
.
.
Sursa: 3dnews.ru
