

Un grup de cercetători de la universități din SUA, Australia și Israel a propus o nouă tehnică de atac prin canale laterale pentru a exploata vulnerabilitățile din clasa Spectre în browserele bazate pe motorul Chromium. Atacul, care a primit numele de cod Spook.js, permite, prin executarea codului JavaScript, să ocolească mecanismul de izolare a site-urilor și să citească conținutul întregului spațiu de adresare al procesului curent, adică să obțină acces la datele paginilor deschise în alte tab-uri, dar procesate într-un singur proces.
Deoarece Chrome rulează diferite site-uri în procese separate, posibilitatea de a efectua atacuri practice este limitată la serviciile care permit utilizatorilor diferiți să-și plaseze paginile. Metoda permite, de pe pagina în care atacatorul poate încorpora codul său JavaScript, să determine existența altor pagini deschise de utilizator din același site și să extragă informații confidențiale din acestea, cum ar fi datele de autentificare sau informațiile bancare introduse de sistemul de autocompletare în formularele web. Ca demonstrație, s-a arătat cum se poate ataca un blog străin pe serviciul Tumblr, dacă proprietarul său deschide într-un alt tab blogul atacatorului, găzduit în același serviciu.
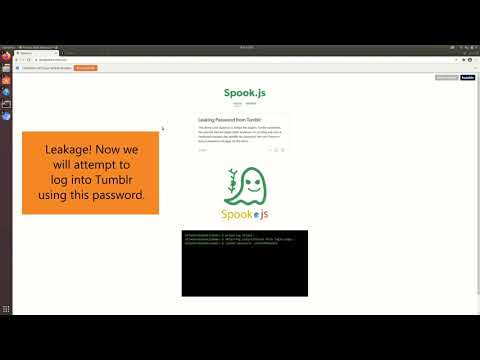
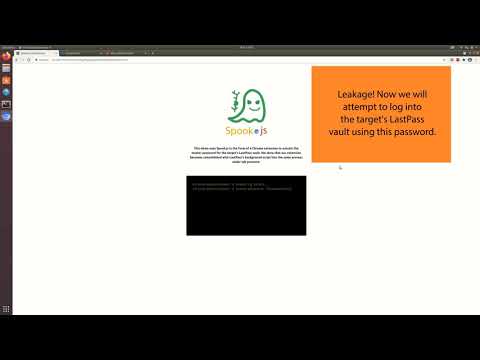
O altă variantă de aplicare a metodei este atacul asupra extensiilor de browser, care permite, la instalarea unei extensii controlate de atacatori, extragerea de date din alte extensii. Ca exemplu, s-a demonstrat cum, instalând o extensie malițioasă, se pot extrage informații confidențiale din managerul de parole LastPass.
Cercetătorii au publicat un prototip de exploit care funcționează în Chrome 89 pe sisteme cu CPU Intel i7-6700K și i7-7600U. La crearea exploit-ului au fost folosite prototipuri de cod JavaScript anterior publicate de compania Google pentru atacurile din clasa Spectre. Se menționează că cercetătorilor le-a reușit să pregătească exploit-uri funcționale pentru sistemele bazate pe procesoare Intel și Apple M1, care permit organizarea citirii memoriei cu o viteză de 500 de biți pe secundă și o precizie de 96%. Se estimează că metoda este aplicabilă și pentru procesoarele AMD, dar nu s-a reușit pregătirea complet funcțională a unui exploit.
Atacul este aplicabil oricăror browsere bazate pe motorul Chromium, inclusiv Google Chrome, Microsoft Edge și Brave. Cercetătorii consideră, de asemenea, că metoda poate fi adaptată pentru a funcționa cu Firefox, dar din moment ce motorul Firefox diferă semnificativ de Chrome, lucrările pentru crearea unui exploat similar au fost lăsate pentru viitor.
Pentru a proteja împotriva atacurilor legate de execuția speculativă a instrucțiunilor prin intermediul browserului, Chrome a implementat segmentarea spațiului de adrese — izolarea sandbox permite rularea JavaScript doar cu pointere de 32 de biți și împarte memoria handlerelor în heap-uri neintersectante de 4GB. Pentru a organiza accesul la întregul spațiu de adrese al procesului și a evita limita de 32 de biți, cercetătorii au folosit tehnica Type Confusion, care forțează motorul JavaScript să proceseze un obiect cu un tip incorect, permițând astfel generarea unui pointer de 64 de biți bazat pe combinația a două valori de 32 de biți.
Esenta atacului este că, în timpul procesării unui obiect malițios special format în motorul JavaScript, se creează condiții care duc la execuția speculativă a instrucțiunilor care accesează un array. Obiectul este ales astfel încât câmpurile controlate de atacatori să fie plasate într-o zonă unde este utilizat un pointer de 64 de biți. Deoarece tipul obiectului malițios nu corespunde tipului array-ului procesat, în condiții normale, astfel de acțiuni sunt blocate în Chrome prin mecanismul de deoptimizare a codului folosit pentru accesul la array-uri. Pentru a rezolva această problemă, codul pentru atacul Type Confusion este mutat într-un bloc condițional „if”, care nu se activează în condiții normale, dar este executat în modul speculativ, în cazul unei preziceri greșite a procesorului privind ramificarea ulterioară.
În final, procesorul accesează speculativ un pointer de 64 de biți generat și își revine după ce determină o prognoză eșuată, dar urmele execuției rămân în cache-ul general și pot fi recuperate prin metode de determinare a conținutului cache-ului prin canale externe, care analizează modificările timpului de acces pentru datele pe care le are în cache și cele care nu sunt în cache. Pentru analiza conținutului cache-ului în condițiile unei precizii insuficiente a temporizatorului disponibil în JavaScript, se aplică metoda propusă de Google, care păcălește strategia de înlocuire a datelor din cache Tree-PLRU folosită în procesoare și permite, prin creșterea numărului de cicluri, să se augmenteze semnificativ diferența de timp între prezența și absența valorii în cache.
Sursa: opennet.ro
