

A fost publicat un ghid detaliat pentru optimizarea mediului Linux pentru a atinge o performanță maximă în procesarea cererilor HTTP. Metodele propuse au permis creșterea performanței handler-ului JSON bazat pe biblioteca libreactor în mediul Amazon EC2 (4 vCPU) de la 224.000 de cereri API pe secundă, utilizând setările standard ale Amazon Linux 2 cu kernel 4.14, până la 1,2 milioane de cereri pe secundă după optimizare (o creștere de 436%), precum și o reducere a întârzierilor în procesarea cererilor cu 79%. Metodele propuse nu sunt specifice libreactor și funcționează cu alte servere http, inclusiv nginx, Actix, Netty și Node.js (libreactor a fost folosit în teste deoarece soluția bazată pe acesta a arătat cea mai bună performanță).
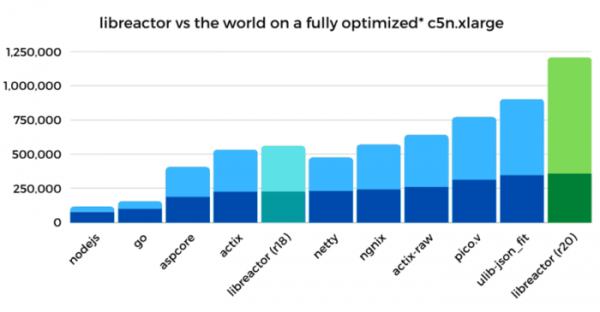
Optimizările principale:
- Optimizarea codului libreactor. Ca bază a fost folosită varianta R18 din setul Techempower, care a fost îmbunătățită prin eliminarea codului pentru limitarea numărului de nuclee CPU utilizate (optimizarea a permis o accelerare de 25-27%), compilarea în GCC cu opțiunile „-O3” (creștere de 5-10%) și „-march-native” (5-10%), înlocuirea apelurilor read/write cu recv/send (5-10%) și reducerea costurilor utilizând pthreads (2-3%). Creșterea totală a performanței după optimizarea codului a fost de 55%, iar capacitatea de procesare a crescut de la 224k req/s la 347k req/s.
- Dezactivarea protecției împotriva vulnerabilităților cauzate de execuția speculativă a instrucțiunilor. Utilizarea opțiunilor la încărcarea nucleului „nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off” a permis creșterea performanței cu 28%, iar capacitatea de procesare a crescut de la 347k req/s la 446k req/s. Creșterea individuală de la parametrul „nospectre_v1” (protecția împotriva Spectre v1 + SWAPGS) a fost de 1-2%, „nospectre_v2” (protecția împotriva Spectre v2) - 15-20%, „pti=off” (Spectre v3/Meltdown) - 6%, „mds=off tsx_async_abort=off” (MDS/Zombieload și TSX Asynchronous Abort) - 6%. Setările pentru protecția împotriva atacurilor L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass și SRBDS au rămas neschimbate, deoarece nu au influențat performanța, deoarece nu s-au intersectat cu configurația testată (de exemplu, specifice pentru KVM, virtualizarea încorporată și alte modele de CPU).
- Dezactivarea mecanismelor de audit și blocare a apelurilor de sistem prin comanda „auditctl -a never,task” și specificarea opțiunii „—security-opt seccomp=unconfined” la pornirea containerului docker. Creșterea totală a performanței a fost de 11%, iar capacitatea de procesare a crescut de la 446k req/s la 495k req/s.
- Dezactivarea iptables/netfilter prin descărcarea modulelor nucleului asociate. Ideea de a dezactiva firewall-ul, care nu era folosit în soluția specifică a serverului, a fost impulsionată de rezultatele profilării, conform cărora funcția nf_hook_slow consuma 18% din timp. Se menționează că nftables funcționează mai eficient decât iptables, dar în Amazon Linux continuă să fie utilizat iptables. După dezactivarea iptables, creșterea performanței a fost de 22%, iar lățimea de bandă a crescut de la 495k req/s la 603k req/s.
- Reducerea migrației handler-elor între diferitele nuclee CPU pentru a îmbunătăți eficiența utilizării cache-ului procesor. Optimizarea a fost realizată atât la nivelul legării proceselor libreactor la nuclee CPU (CPU Pinning), cât și prin fixarea handler-elor de rețea ale nucleului (Receive Side Scaling). De exemplu, a fost dezactivat irqbalance și legarea explicită a cozii la CPU a fost setată în /proc/irq/$IRQ/smp_affinity_list. Pentru a folosi același nucleu CPU pentru procesarea procesului libreactor și a cozii de rețea pentru pachetele care sosesc, a fost utilizat un handler BPF propriu, conectat prin setarea flag-ului SO_ATTACH_REUSEPORT_CBPF la crearea socket-ului. Pentru a lega cozii de pachete care ies la CPU, au fost modificate setările /sys/class/net/eth0/queues/tx-<n>/xps_cpus. Creșterea totală a performanței a fost de 38%, iar lățimea de bandă a crescut de la 603k req/s la 834k req/s.
- Optimizarea gestionării întreruperilor și utilizarea polling-ului. Activarea modului adaptive-rx în driverul ENA și manipularea sysctl net.core.busy_read au permis creșterea performanței cu 28% (lățimea de bandă a crescut de la 834k req/s la 1.06M req/s, iar latențele au scăzut de la 361μs la 292μs).
- Dezactivarea serviciilor sistemice care cauzează blocaje inutile în stiva de rețea. Dezactivarea dhclient și instalarea adrese IP manually a dus la o creștere a performanței de 6%, iar lățimea de bandă a crescut de la 1.06M req/s la 1.12M req/s. Motivul influenței dhclient asupra performanței este în analiza traficului utilizând socket-uri raw.
- Combaterea Spin Lock. Trecerea stivei de rețea în modul „noqueue” prin sysctl „net.core.default_qdisc=noqueue” și „tc qdisc replace dev eth0 root mq” a dus la o creștere a performanței de 2%, iar lățimea de bandă a crescut de la 1.12M req/s la 1.15M req/s.
- Optimizări finale minore, cum ar fi dezactivarea GRO (Generic Receive Offload) cu comanda „ethtool -K eth0 gro off” și înlocuirea algoritmului de control al congestiei cubic cu reno folosind sysctl „net.ipv4.tcp_congestion_control=reno”. Creșterea generală a performanței a fost de 4%. Lățimea de bandă a crescut de la 1.15M req/s la 1.2M req/s.
Pe lângă optimizările implementate, articolul discută și metode care nu au dus la creșterea așteptată a performanței. De exemplu, s-au dovedit a fi ineficiente:
- Execuția separată a libreactor nu a avut o performanță diferită față de rularea în container. Înlocuirea writev cu send, creșterea maxevents în epoll_wait, experimentele cu versiunile și flagurile GCC (efectul fiind vizibil doar pentru flagurile „-O3” și „-march-native”) nu au avut impact.
- Actualizarea nucleului Linux la versiunile 4.19 și 5.4, folosirea planificatorilor SCHED_FIFO și SCHED_RR, manipulările cu sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 și clocksource=tsc nu au influențat performanța.
- În driverul ENA, activarea modurilor Offload (segmentation, scatter-gather, rx/tx checksum), compilarea cu flagul „-O3” și aplicarea parametrilor ena.rx_queue_size și ena.force_large_llq_header nu au avut efect.
- Modificările în stiva de rețea nu au dus la creșterea performanței:
- Dezactivarea IPv6: ipv6.disable=1
- Dezactivarea VLAN: modprobe -rv 8021q
- Dezactivarea verificării sursei pachetului
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (efect negativ)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- A fost publicat un ghid detaliat pentru optimizarea mediului Linux pentru a obține performanțe maxime în procesarea cererilor HTTP.
Sursa: opennet.ro
