

Proiectul OpenAI, care se ocupă de dezvoltarea proiectelor accesibile în domeniul inteligenței artificiale, a publicat realizările legate de sistemul de recunoaștere vocală Whisper. Se afirmă că pentru vorbirea în limba engleză, sistemul oferă niveluri de fiabilitate și precizie a recunoașterii automate apropiate de recunoașterea umană. Codul pentru implementarea de referință bazată pe framework-ul PyTorch și un set de modele deja antrenate, gata de utilizare, sunt disponibile public. Codul este deschis sub licența MIT.
Pentru antrenarea modelului, au fost utilizate 680.000 de ore de date vocale, adunate din mai multe colecții, acoperind diferite limbi și domenii tematice. Aproximativ 1/3 din datele vocale folosite pentru antrenare provin din limbi diferite de engleză. Sistemul propus procesează corect situații precum pronunția cu accent, prezența zgomotelor de fond și utilizarea jargonului tehnic. În plus față de transcrierea vorbirii în text, sistemul poate, de asemenea, să traducă vorbirea din orice limbă în limba engleză și să detecteze apariția vorbirii în fluxul audio.
Modelele sunt create în două reprezentări: un model pentru limba engleză și un model multilingv, care suportă, printre altele, limbile română, ucraineană și belarusă. Fiecare reprezentare este divizată în 5 variante, diferite prin dimensiune și numărul de parametri acoperiți în model. Cu cât dimensiunea este mai mare, cu atât mai mare este precizia și calitatea recunoașterii, dar și cerințele pentru dimensiunea memoriei video GPU sunt mai mari, iar performanța este mai redusă. De exemplu, varianta minimă include 39 de milioane de parametri și necesită 1 GB de memorie video, în timp ce varianta maximă include 1550 de milioane de parametri și necesită 10 GB de memorie video. Varianta minimă este de 32 de ori mai rapidă decât cea maximă.
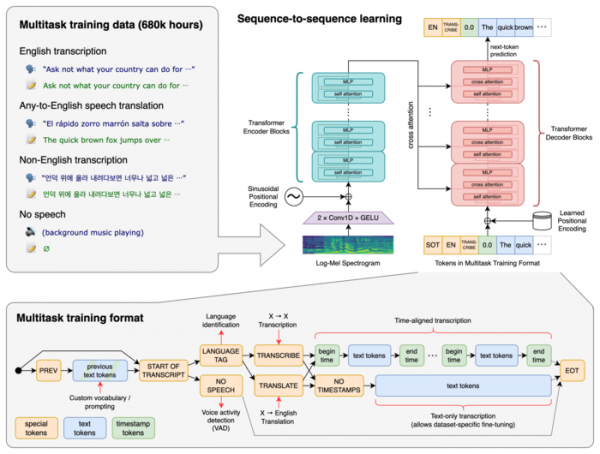
Sistemul utilizează arhitectura rețelei neuronale "Transformer", care include un encoder și un decoder interconectați. Sunetul este împărțit în fragmente de 30 de secunde, care sunt transformate în spectrograma log-Mel și trimise encoder-ului. Rezultatul activității encoder-ului este transmis către decoder, care prezice o reprezentare textului amestecată cu token-uri speciale, permițând rezolvarea, într-un model comun, a unor sarcini precum determinarea limbii, contabilizarea cronologiei pronunțării frazelor, transcrierea vorbirii în diferite limbi și traducerea în limba engleză.
Sursa: opennet.ro
