

Am făcut-o!
„Scopul acestui curs este să te pregătim pentru viitorul tău tehnic.”
 Salut, Habr. Îți amintești de articolul grozav (+219, 2588 la favorite, 429k citiri)?
Așadar, la Hamming (da, da, autocontrolat și autocorectabil ) există o întreagă , scrisă pe baza lecțiilor sale. O tradusim, pentru că omul știe ce vorbește.
Aceasta nu este doar o carte despre IT, este o carte despre stilul de gândire al unor oameni incredibil de cool. „Nu este doar un impuls de gândire pozitiv; descrie condițiile care cresc șansele de a realiza lucruri mărețe.”
Mulțumiri lui Andrei Pahomov pentru traducere.
Teoria Informației a fost dezvoltată de C. E. Shannon la sfârșitul anilor 1940. Conducerea Laboratoarelor Bell a insistat să o numească „Teoria Comunicării”, deoarece este un nume mult mai precis. Din motive evidente, denumirea „Teoria Informației” are un impact semnificativ mai mare asupra publicului, așa că Shannon a ales-o, și aceasta este denumirea cunoscută și astăzi. Numele sugerează că teoria se ocupă cu informația, ceea ce o face importantă, pe măsură ce ne adâncim în epoca informațională. În acest capitol voi aborda câteva concluzii esențiale ale acestei teorii, oferind dovezi nu riguroase, ci mai degrabă intuitive pentru unele dintre afirmațiile acestei teorii, pentru a înțelege cu adevărat ce este „Teoria Informației”, unde poți să o aplici și unde nu.
În primul rând, ce este „informația”? Shannon identifică informația cu incertitudinea. El a ales logaritmul negativ al probabilității unui eveniment ca măsură cantitativă a informației pe care o obții atunci când se produce un eveniment cu probabilitatea p. De exemplu, dacă îți spun că în Los Angeles este o vreme cețoasă, atunci p este aproape de 1, ceea ce, în mare parte, nu ne oferă multe informații. Dar dacă îți spun că în iunie în Monterey plouă, atunci acest mesaj va conține incertitudine și va avea mai multă informație. Un eveniment cert nu conține informație, deoarece log 1 = 0.
Să ne oprim aici pentru mai multe detalii. Shannon a considerat că măsura cantitativă a informației trebuie să fie o funcție continuă a probabilității unui eveniment p, iar pentru evenimente independente, aceasta ar trebui să fie aditivă – cantitatea de informație obținută prin realizarea a două evenimente independente ar trebui să fie egală cu cantitatea de informație obținută prin realizarea unui eveniment combinat. De exemplu, rezultatul aruncării unei zaruri și al unei monede este de obicei considerat ca fiind evenimente independente. Să traducem ceea ce s-a spus mai sus în limbajul matematic. Dacă I (p) este cantitatea de informație conținută într-un eveniment cu probabilitatea p, atunci, pentru un eveniment comun care constă din două evenimente independente x cu probabilitatea p1 și y cu probabilitatea p2, obținem
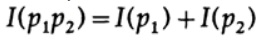
(x și y sunt evenimente independente)
Aceasta este ecuația funcțională a lui Cauchy, valabilă pentru toate p1 și p2. Pentru a rezolva această ecuație funcțională, să presupunem că
p1 = p2 = p,
acest lucru ne dă
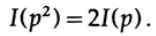
Dacă p1 = p2 și p2 = p, atunci
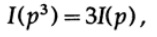
și așa mai departe. Extinzând acest proces, folosind metoda standard pentru exponenturi, pentru toate numerele raționale m / n, se adeverește următorul lucru
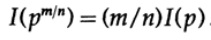
Din presupusa continuitate a măsurii informației, rezultă că funcția logaritmică este singura soluție continuă a ecuației funcționale a lui Cauchy.
În teoria informației, se acceptă că baza logaritmului este 2, prin urmare, o alegere binară conține exact 1 bit de informație. Prin urmare, informația este măsurată conform formulei
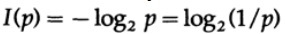
Să ne oprim și să analizăm ce s-a întâmplat mai sus. În primul rând, noi nu am definit conceptul de "informație", am definit doar formula măsurii sale cantitative.
În al doilea rând, această măsură depinde de incertitudine, și, deși este suficient de bună pentru mașini — de exemplu, sisteme telefonice, radio, televiziune, computere etc. — aceasta nu reflectă relația normală a oamenilor cu informația.
În al treilea rând, aceasta este o măsură relativă, depinde de starea curentă a cunoștințelor tale. Dacă te uiți la un flux de "numere aleatorii" dintr-un generator de numere aleatorii, presupui că fiecare număr următor este incert, dar, dacă știi formula pentru calcularea „numărului aleatoriu”, următorul număr va fi cunoscut și, prin urmare, nu va conține informație.
Astfel, definiția dată de Shannon pentru informație se potrivește în multe cazuri pentru mașini, dar pare să nu corespundă înțelesului uman al acestui cuvânt. Exact din acest motiv, „Teoria informației” ar fi trebuit numită „Teoria comunicației”. Cu toate acestea, este deja prea târziu pentru a schimba definițiile (datorită cărora teoria și-a câștigat popularitatea inițială și care încă îi fac pe oameni să creadă că această teorie se ocupă cu „informația”), așa că suntem nevoiți să ne conformăm cu ele, dar trebuie să înțelegeți clar cât de departe este definiția informației dată de Shannon de sensul său comun. Informația lui Shannon se ocupă cu ceva complet diferit, și anume cu incertitudinea.
Iată despre ce trebuie să te gândești atunci când propui o terminologie. Cât de bine se aliniază definiția propusă, de exemplu, definiția informației dată de Shannon, cu ideea ta inițială și cât de mult se deosebește? Aproape nu există un termen care să reflecte exact viziunea ta anterioară asupra conceptului, dar în cele din urmă, termenologia folosită reflectă sensul conceptului, așa că formalizarea cuiva prin definiții clare introduce întotdeauna un anumit zgomot.
Să considerăm un sistem a cărui alfabet este format din simboluri q cu probabilitățile pi. În acest caz numărul mediu de informație în sistem (valoarea sa așteptată) este egal cu:
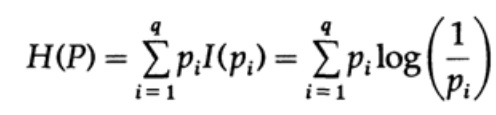
Aceasta se numește entropia sistemului cu distribuția de probabilitate {pi}. Folosim termenul „entropie” pentru că aceeași formă matematică apare în termodinamică și mecanica statistică. Din acest motiv, termenul „entropie” creează în jurul său o aură de importanță, care, în cele din urmă, nu este justificată. Aceeași formă matematică a înregistrării nu implică o interpretare identică a simbolurilor!
Entropia distribuției de probabilitate joacă un rol principal în teoria codificării. Inegalitatea Gibbs pentru două distribuții de probabilitate diferite pi și qi este unul dintre rezultatele importante ale acestei teorii. Așadar, trebuie să demonstrăm că
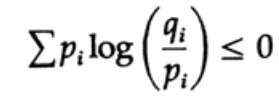
Demonstrația se bazează pe graficul evident, fig. 13.I, care arată că
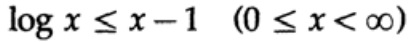
egalitatea este atinsă doar pentru x = 1. Aplicăm inegalitatea la fiecare summand al sumei din partea stângă:
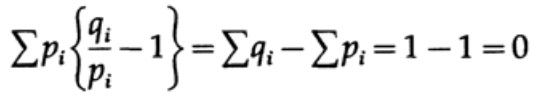
Dacă alfabetul sistemului de comunicație constă din q simboluri, luând în considerare probabilitatea de transmitere a fiecărui simbol qi = 1/q și prin substituirea lui q, obținem din inegalitatea Gibbs.
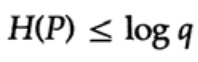
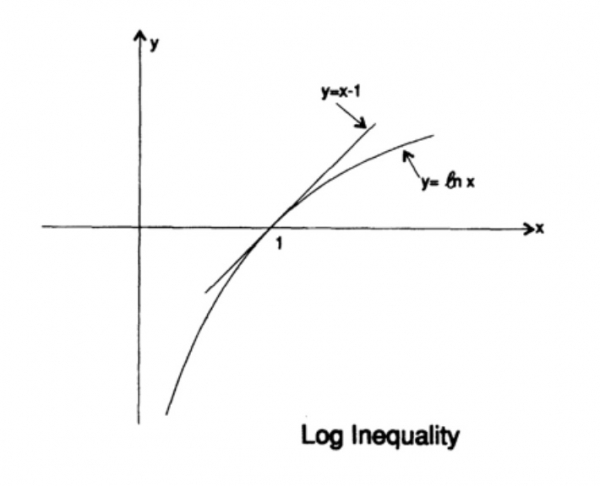
Figura 13.I
Aceasta spune că, dacă probabilitatea de transmitere a tuturor simbolurilor q este uniformă și egală cu 1/q, atunci entropia maximă este ln q; în caz contrar, inegalitatea este valabilă.
În cazul unui cod univoc decodificabil, avem inegalitatea Kraft.
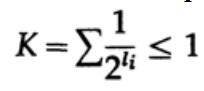
Acum, dacă vom defini pseudoprobabilitățile
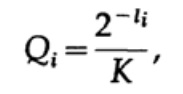
unde este finită 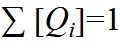 = 1, ceea ce urmează din inegalitatea Gibbs,
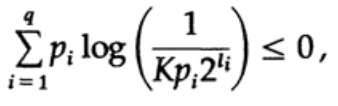
și aplicând puțină algebră (amintiți-vă că K ≤ 1, deci putem omite termenul logaritmic, și poate îmbunătăți inegalitatea mai târziu), vom obține
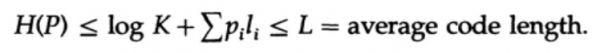
unde L este lungimea medie a codului.
Astfel, entropia este limita minimă pentru orice cod pe simboluri cu o lungime medie a cuvântului codificat L. Aceasta este teorema lui Shannon pentru un canal fără zgomot.
Acum să luăm în considerare teorema principală despre constrângerile sistemelor de comunicație, în care informația este transmisă sub formă de flux de biți independenți și este prezent zgomot. Se subînțelege că probabilitatea de transmitere corectă a unui bit P > 1/2, iar probabilitatea ca valoarea bitului să fie inversată în timpul transmiterii (să apară o eroare) este Q = 1 - P. Pentru comoditate, să presupunem că erorile sunt independente și probabilitatea de eroare este aceeași pentru fiecare bit trimis - adică există „zgomot alb” în canalul de comunicație.
Avem un flux lung de n biți, codificat într-un singur mesaj - o extindere n-dimensională a unui cod pe un bit. Valoarea n o vom defini mai târziu. Să considerăm mesajul format din biți n ca un punct în spațiul n-dimensional. Deoarece avem un spațiu n-dimensional - și pentru simplificare vom presupune că fiecare mesaj are o probabilitate egală de apariție - există M mesaje posibile (M va fi definit mai târziu), prin urmare, probabilitatea oricărui mesaj trimis este

(expeditor)
Grafica 13.II
Haideți să discutăm despre conceptul de lățimea de bandă a canalului. Fără a intra în detalii, lățimea de bandă a canalului este definită ca volumul maxim de informație care poate fi transmis în mod fiabil printr-un canal de comunicație, având în vedere utilizarea codificării celei mai eficiente. Nu există dovezi că printr-un canal de comunicație poate fi transmisă mai multă informație decât capacitatea sa. Acest lucru poate fi demonstrat pentru un canal simetric binar (pe care îl folosim în cazul nostru). Capacitatea canalului, în cazul trimiterii bit cu bit, este dată de
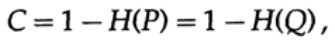
unde, ca și înainte, P este probabilitatea de absență a erorii în orice bit trimis. Când se trimit n biți independenți, capacitatea canalului este definită ca
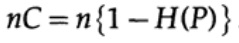
Dacă ne aflăm aproape de lățimea de bandă a canalului, atunci trebuie să trimitem aproape aceeași cantitate de informație pentru fiecare dintre simbolurile ai, i = 1, …, M. Având în vedere că probabilitatea de apariție a fiecărui simbol ai este 1 / M, vom obține
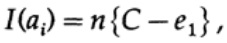
când trimitem oricare dintre cele M mesaje echiprobabile ai, avem
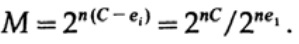
Când trimitem n biți, ne așteptăm la apariția a nQ erori. În practică, pentru un mesaj format din n biți, vom avea aproximativ nQ erori în mesajul primit. La valori mari ale n, variația relativă (variația = lățimea distribuției,)
distribuția numărului de erori va fi tot mai îngustă pe măsură ce n crește.
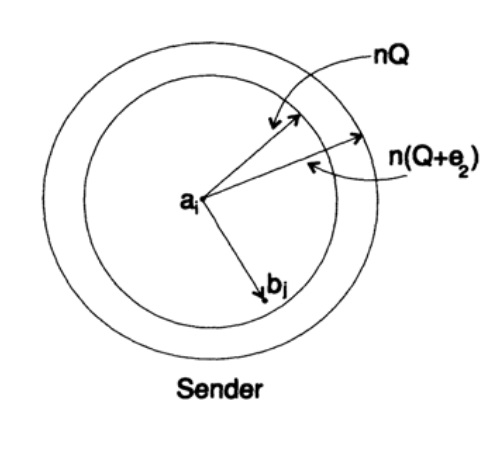
Așadar, din partea emițătorului, iau mesajul ai pentru a-l trimite și trasesez o sferă în jurul său cu un raadius de
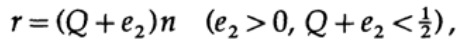
care este puțin mai mare cu o valoare egală cu e2 decât numărul așteptat de erori Q (figura 13.II). Dacă n este suficient de mare, atunci există o probabilitate cât se poate de mică ca punctul mesaj bj de la receptor să depășească această sferă. Să schițăm situația așa cum o văd eu din perspectiva emițătorului: avem orice raze de la mesajul trimis ai la mesajul recepționat bj, cu o probabilitate de eroare egală (sau aproape egală) cu distribuția normală, atingând maximul în nQ. Pentru orice e2 dat, există un n atât de mare încât probabilitatea ca punctul obținut bj să depășească sfera mea va fi cât se poate de mică.
Acum să analizăm aceeași situație din perspectiva dumneavoastră (fig. 13.III). Pe partea receptorului există o sferă S(r) de același raion r în jurul punctului acceptat bj în spațiul n-dimensional, astfel încât, dacă mesajul acceptat bj se află în interiorul sferei mele, atunci mesajul trimis de mine ai se află în interiorul sferei dumneavoastră.
Cum poate apărea o eroare? O eroare poate apărea în cazurile descrise în tabelul de mai jos:
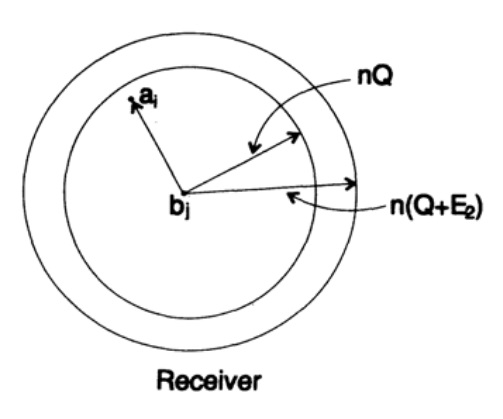
Figura 13.III
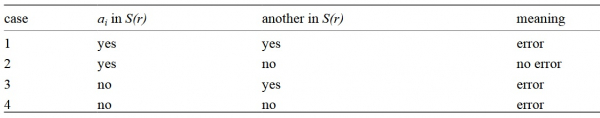
Aici vedem că, dacă în sfera construită în jurul punctului acceptat există cel puțin un alt punct corespunzător unui mesaj trimis necodificat posibil, atunci la transmitere a apărut o eroare, deoarece nu puteți determina care dintre aceste mesaje a fost transmis. Mesajul trimis nu conține erori, doar dacă punctul corespunzător lui se află în sferă și nu există alte puncte posibile în acest cod care să se afle în aceeași sferă.
Avem o ecuație matematică pentru probabilitatea de eroare Pe, dacă a fost trimis mesajul ai
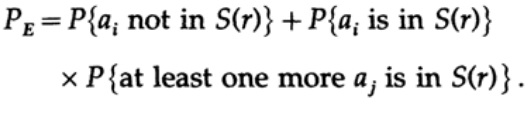
Putem elimina primul factor din al doilea termen, considerându-l 1. Astfel obținem o inegalitate
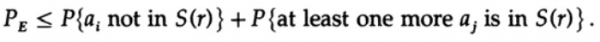
Este evident că
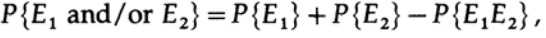
prin urmare
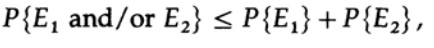
aplicăm din nou la ultimul termen din dreapta
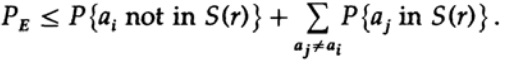
Considerând n suficient de mare, primul termen poate fi considerat oricât de mic, de exemplu, mai mic decât o anumită valoare d. Prin urmare, avem
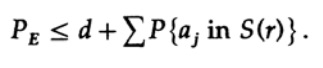
Acum să analizăm cum poate fi construit un cod simplu de substituție pentru codarea M mesaje formate din n biți. Fără nici o idee despre cum să construim codul (codurile cu corectarea erorilor nu au fost încă inventate), Shannon a ales codarea aleatoare. Aruncați o monedă pentru fiecare dintre cei n biți în mesaj și repetați procesul pentru M mesaje. În total trebuie să realizați nM aruncări de monedă, deci sunt posibile

cuvinte de cod, având aceeași probabilitate ½nM. Desigur, procesul aleator de creare a unui dicționar de coduri înseamnă că există o probabilitate de apariție a dublurilor, precum și a punctelor de cod care vor fi apropiate una de cealaltă și, prin urmare, vor fi sursa probabilităților de erori. Trebuie demonstrat că, dacă acest lucru nu se întâmplă cu o probabilitate mai mare decât orice nivel de eroare ales mic, atunci n dat este suficient de mare.
Momentul decisiv este că Shannon a mediat toate cărțile de coduri posibile pentru a găsi eroarea medie! Vom folosi simbolul Av [.], pentru a desemna valoarea medie a multor posibile dicționare de coduri aleatorii. Averajul constantei d, bineînțeles, dă o constantă, deoarece pentru a mediat, fiecare termen coincide cu orice alt termen din sumă.
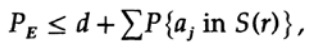
care poate fi crescut (M–1 devine M)
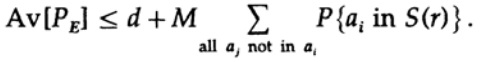
Pentru orice mesaj specific, în medierea tuturor cărților de coduri, codificarea parcurge toate valorile posibile, deci probabilitatea medie ca punctul să se afle în sferă este raportul dintre volumul sferei și volumul total al spațiului. Volumul sferei în acest caz
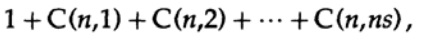
unde s=Q+e2 < 1/2 și ns trebuie să fie un număr întreg.
Ultimul termen din sumă este cel mai mare. Să estimăm întâi valoarea sa folosind formula lui Stirling pentru factoriale. Apoi ne vom uita la coeficientul de reducere al termenului dinainte, rețineți că acest coeficient crește pe măsură ce mergem spre stânga, și prin urmare putem: (1) limita valoarea sumei cu suma unei progresii geometrice cu acest coeficient inițial, (2) extinde progresia geometrică de la ns termeni până la un număr infinit de termeni, (3) calcula suma progresiei geometrice infinite (algebra standard, nimic esențial) și în final obține limita (pentru un n suficient de mare):
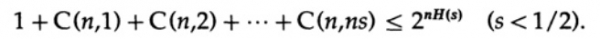
Observați cum entropia H(s) a apărut în identitatea binomială. Rețineți că dezvoltarea în seria Taylor H(s)=H(Q+e2) oferă o estimare obținută luând în considerare doar prima derivată și ignorând toate celelalte. Acum să adunăm expresia finală:
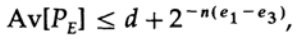
unde
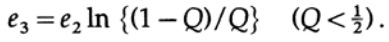
Tot ce trebuie să facem este să alegem e2, astfel încât e3 < e1, și atunci ultimul termen va fi cât de mic dorim, pentru un n suficient de mare. Prin urmare, eroarea medie PE poate fi obținută cât de mică dorim, atunci când capacitatea canalului este cât se poate de aproape de C.
Dacă valoarea medie pentru toate codurile are o eroare destul de mică, atunci cel puțin un cod trebuie să fie potrivit, prin urmare, există cel puțin un sistem de codificare adecvat. Acesta este un rezultat important obținut de Shannon – „teorema lui Shannon pentru canale cu zgomot”, deși trebuie remarcat că el a demonstrat acest lucru pentru un caz mult mai general decât pentru simplul canal binar simetric utilizat de mine. Pentru cazul general, calculele matematice sunt mult mai complexe, dar ideile nu sunt atât de diferite, așa că foarte des, prin exemplul unui caz particular, se poate dezvălui adevăratul sens al teoremei.
Să criticăm rezultatul. Am repetat de mai multe ori: „Pentru n suficient de mari”. Dar cât de mare trebuie să fie n? Foarte, foarte mare, dacă doriți cu adevărat să fiți aproape în același timp de capacitatea canalului și să fiți siguri de transmisia corectă a datelor! Atât de mare, încât de fapt veți fi nevoiți să așteptați foarte mult timp pentru a acumula un mesaj dintr-un număr atât de mare de biți, încât să-l codificați ulterior. În acest timp, dimensiunea dicționarului codului aleator va fi pur și simplu uriașă (deoarece un astfel de dicționar nu poate fi reprezentat într-o formă mai scurtă decât lista completă a tuturor biților Mn, având în vedere că n și M sunt foarte mari)!
Codurile de corecție a erorilor evită așteptarea unui mesaj foarte lung, cu codificarea și decodificarea ulterioară prin cărți de coduri foarte mari, deoarece evită cărțile de coduri ca atare și folosesc în schimb calcule obișnuite. În teoria simplă, astfel de coduri pierd, de obicei, capacitatea de a se apropia de capacitatea canalului și, în același timp, de a menține o frecvență a erorilor destul de mică, dar, atunci când codul corectează un număr mare de erori, acestea dau rezultate bune. Cu alte cuvinte, dacă dedicați o capacitate a canalului pentru corecția erorilor, trebuie să utilizați capacitatea de corecție a erorilor în majoritatea timpului, adică în fiecare mesaj trimis trebuie corectat un număr mare de erori, altfel pierdeți această capacitate degeaba.
Totuși, teorema demonstrată mai sus nu este lipsită de sens! Aceasta arată că sistemele eficiente de transmitere trebuie să utilizeze scheme de codificare bine gândite pentru șiruri de biți foarte lungi. Un exemplu sunt sateliții care au zburat dincolo de planetele exterioare; pe măsură ce se îndepărtează de Pământ și de Soare, sunt nevoiți să corecteze un număr din ce în ce mai mare de erori în blocurile de date: unii sateliți folosesc panouri solare, care oferă aproximativ 5 W, alții folosesc surse de alimentare nucleare, oferind o putere similară. Puterea slabă a sursei de alimentare, dimensiunile reduse ale antenelor emițătoare și ale celor de recepție de pe Pământ, distanța mare pe care semnalul trebuie să o parcurgă - toate acestea necesită utilizarea de coduri cu un nivel ridicat de corecție a erorilor pentru construirea unui sistem de comunicație eficient.
Să ne întoarcem la spațiul n-dimensional pe care l-am folosit în demonstrarea de mai sus. Discutând despre acesta, am arătat că aproape tot volumul sferei este concentrat în jurul suprafeței externe - astfel, este aproape sigur că semnalul trimis se va afla la suprafața sferei construite în jurul semnalului recepționat, chiar și pentru un raza relativ mică a acelei sfere. Așadar, nu este surprinzător că semnalul recepționat, după corectarea unui număr aleatoriu de erori, nQ, se dovedește a fi la orice distanță dorită de semnalul fără erori. Capacitatea canalului de comunicație pe care l-am examinat anterior este cheia pentru înțelegerea acestui fenomen. Observați că sferele construite pentru codurile Hamming cu corecție a erorilor nu se suprapun. Un număr mare de dimensiuni practic ortogonale în spațiul n-dimensional arată de ce putem încadra M sfere în spațiu cu o suprapunere minimă. Dacă presupunem o suprapunere mică, oricât de mică, aceasta putând duce doar la un număr redus de erori la decodare, se poate obține o plasare densă a sferelor în spațiu. Hamming a garantat un anumit nivel de corecție a erorilor, Shannon - o probabilitate scăzută de eroare, dar păstrând în același timp capacitatea reală a canalului de comunicație cât mai apropiată de capacitatea canalului, ceea ce codurile Hamming nu pot realiza.
Teoria informației nu vorbește despre cum să proiectăm un sistem eficient, ci indică direcția către sisteme de comunicație eficiente. Este un instrument valoros pentru construirea sistemelor de comunicare între mașini, dar, după cum s-a menționat anterior, nu are o legătură semnificativă cu modul în care oamenii schimbă informații între ei. Gradul în care moștenirea biologică se aseamănă cu sistemele tehnice de comunicare este pur și simplu necunoscut, prin urmare în prezent nu este clar cât de aplicabilă este teoria informației genelor. Nu avem altceva de făcut decât să încercăm, iar dacă succesul ne va arăta un caracter similar celor ale mașinilor, eșecul va indica alte aspecte esențiale ale naturii informației.
Să ne detasăm puțin. Am văzut că toate definițiile inițiale, în mai mare sau mai mică măsură, trebuie să exprime esența credințelor noastre originale, dar acestea sunt supuse unei anumite câtități de distorsionare, și din acest motiv devin inaplicabile. Este tradițional acceptat că, în cele din urmă, definiția pe care o folosim defineste de fapt esența; dar, aceasta ne arată doar cum să gestionăm lucrurile și nu oferă nimic semnificativ. Abordarea postulațională, atât de apreciată în cercurile matematice, lasă de dorit în practică.
Acum vom examina un exemplu de teste IQ, unde definiția este atât de ciclică pe cât doriți, și, în consecință, ne conduce la confuzie. Se creează un test care, se presupune, ar trebui să măsoare inteligența. Apoi este revizuit, pentru a-l face cât mai coerent posibil, și apoi este publicat și calibrat printr-o metodă simplă astfel încât „inteligența” măsurată să se dovedească a fi distribuită normal (desigur, conform curbei de calibrare). Toate definițiile trebuie verificate, nu doar atunci când sunt propuse pentru prima dată, ci și mult mai târziu, când sunt folosite în concluziile trase. În ce măsură limitele definițiilor se potrivesc sarcinii solve? Cât de des definițiile date în anumite condiții încep să fie aplicate în condiții suficient de diferite? Acest lucru se întâmplă destul de frecvent! În științele umaniste, cu care inevitabil te vei confrunta în viața ta, se întâmplă mai des.
Astfel, unul dintre obiectivele acestei prezentări despre teoria informației, pe lângă demonstrarea utilității sale, a fost să te avertizeze asupra acestui pericol sau să demonstreze cum să o folosești pentru a obține rezultatul dorit. A fost observat de mult timp că definițiile inițiale determină ceea ce găsești în final, într-o măsură mult mai mare decât pare. Definițiile inițiale necesită o mare atenție nu doar în orice nouă situație, ci și în domeniile cu care lucrezi de mult timp. Acest lucru te va ajuta să înțelegi în ce măsură rezultatele obținute sunt o tautologie și nu ceva util.
Povestea cunoscută a lui Eddington vorbește despre oameni care prindeau pești în mare cu un vis. Studiind dimensiunea peștilor pe care i-au prins, au determinat dimensiunea minimă a peștelui care trăiește în mare! Concluzia lor a fost determinată de instrumentul folosit, nu de realitate.
Continuarea urmează...
Cine vrea să ajute cu traducerea, formatarea și publicarea cărții — scrieți-mi în privat sau pe e-mail magisterludi2016@yandex.ru
Apropo, am lansat și traducerea unei alte cărți grozave — )
În special căutăm pe cei care ne pot ajuta să traducem . (traducem câte 10 minute, primele 20 au fost deja preluate)
Conținutul cărții și capitolele traduse
- Intro la Arta de a Face Știință și Inginerie: Învățând să Învăț (28 martie 1995)
- „Fundamentele Revoluției Digitale (Discrete)” (30 martie 1995)
- „Istoria Calculatoarelor — Hardware” (31 martie 1995)
- „Istoria Calculatoarelor — Software” (4 aprilie 1995)
- „Istoria Calculatoarelor — Aplicații” (6 aprilie 1995)
- „Inteligența Artificială — Partea I” (7 aprilie 1995)
- „Inteligența Artificială — Partea II” (11 aprilie 1995)
- „Inteligența Artificială III” (13 aprilie 1995)
- „Spațiul N-Dimensional” (14 aprilie 1995)
- „Teoria Codificării — Reprezentarea Informației, Partea I” (18 aprilie 1995)
- „Teoria Codificării — Reprezentarea Informației, Partea II” (20 aprilie 1995)
- „Coduri de Corectare a Erorilor” (21 aprilie 1995)
- „Teoria Informației” (25 aprilie 1995)
- „Filtre Digitale, Partea I” (27 aprilie 1995)
- „Filtre Digitale, Partea II” (28 aprilie 1995)
- „Filtre Digitale, Partea III” (2 mai 1995)
- „Filtre Digitale, Partea IV” (4 mai 1995)
- „Simulare, Partea I” (5 mai 1995)
- „Simulare, Partea II” (9 mai 1995)
- „Simulare, Partea III” (11 mai 1995)
- „Fibră Optică” (12 mai 1995)
- „Învățare Asistată de Calculator” (16 mai 1995)
- „Matematică” (18 mai 1995)
- „Mecanica Cuantică” (19 mai 1995)
- „Creativitate” (23 mai 1995). Traduce:
- „Experți” (25 mai 1995)
- „Date Incredibile” (26 mai 1995)
- „Ingineria Sistemelor” (30 mai 1995)
- „Obții ceea ce măsori” (1 iunie 1995)
- (2 iunie 1995) traducem în secțiuni de câte 10 minute
- Hamming, „Tu și Cercetarea Ta” (6 iunie 1995).
Cine vrea să ajute cu traducerea, formatarea și publicarea cărții — scrieți-mi în privat sau pe e-mail magisterludi2016@yandex.ru
Sursa: habr.com
