

SciPy (pronunțat ca „sai pai”) este un pachet de proceduri matematice aplicate, bazat pe extensia Numpy Python. Cu SciPy, o sesiune interactivă Python se transformă într-un mediu complet de procesare a datelor și prototipare a sistemelor complexe, similar cu MATLAB, IDL, Octave, R-Lab și SciLab. Astăzi vreau să discut pe scurt despre cum ar trebui să aplicăm unele algoritmi de optimizare cunoscuți din pachetul scipy.optimize. O documentație mai detaliată și actualizată privind utilizarea funcțiilor poate fi întotdeauna obținută cu ajutorul comenzii help() sau prin Shift+Tab.
Introducere
Pentru a scuti pe mine și cititorii de căutarea și citirea surselor originale, linkurile către descrierile metodelor vor fi în principal pe Wikipedia. În general, această informație este suficientă pentru a înțelege metodele în linii mari și condițiile de aplicare a acestora. Pentru a înțelege esența metodelor matematice, ne orientăm către linkuri către publicații mai autorizate, care pot fi găsite la sfârșitul fiecărui articol sau în motorul de căutare preferat.
Astfel, modulul scipy.optimize include implementarea următoarelor proceduri:
- Minimizarea condiționată și necondiționată a funcțiilor scalare de mai multe variabile (minim) utilizând diferite algoritmi (simplexul Nelder-Mead, BFGS, gradienti conjugați ai lui Newton, și )
- Optimizarea globală (de exemplu: , )
- Minimizarea reziduurilor (least_squares) și algoritmi de ajustare a curbelor cu MNC nelinear (curve_fit)
- Minimizarea funcțiilor scalare de o variabilă (minim_scalar) și căutarea rădăcinilor (root_scalar)
- Soluționare multidimensională a sistemului de ecuații (root) utilizând diferite algoritmi (hibridul Powell, sau metode la scară mare, cum ar fi ).
În acest articol, ne vom concentra doar asupra primului punct din această listă.
Minimizarea necondiționată a funcției scalare de mai multe variabile
Funcția minim din pachetul scipy.optimize oferă o interfață generală pentru a rezolva problemele de minimizare condiționată și necondiționată a funcțiilor scalare de mai multe variabile. Pentru a-i demonstra funcționalitatea, ne va fi necesară o funcție potrivită de mai multe variabile pe care o vom minimiza în moduri diferite.
Pentru aceste scopuri, funcția Rosenbrock de N variabile, care are forma:

Deși funcția Rosenbrock și matricele sale Jacobi și Hessian (prima și a doua derivată, respectiv) sunt deja definite în pachetul scipy.optimize, să o definim noi înșine.
import numpy as np

def rosen(x):
    """Funcția Rosenbrock"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Pentru a ilustra, să reprezentăm în 3D valorile funcției Rosenbrock în funcție de două variabile.
Codul pentru reprezentare
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Configurăm graficul 3D
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Stabilim unghiul de vedere
ax.view_init(45, 30)

# Creăm datele pentru grafic
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Desenăm suprafața
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
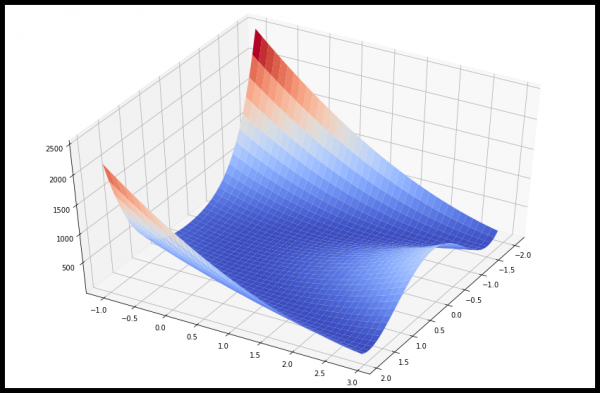
Știind dinainte că minimul este 0 atunci când  , să luăm în considerare exemple despre cum să determinăm valoarea minimă a funcției Rosenbrock prin diferite proceduri din scipy.optimize.
Metoda simplă Nelder-Mead
Să presupunem că avem un punct inițial x0 în spațiul cu 5 dimensiuni. Să găsim cel mai apropiat punct de minimul funcției Rosenbrock folosind algoritmul (algoritmul este specificat ca valoare a parametrului method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 339
Evaluări ale funcției: 571
[1. 1. 1. 1. 1.]Metoda simplex este cea mai simplă modalitate de a minimiza o funcție clar definită și suficient de netedă. Nu necesită calcularea derivatelor funcției, fiind suficient să furnizezi doar valorile acesteia. Metoda Nelder-Mead este o alegere bună pentru problemele simple de minimizare. Cu toate acestea, deoarece nu folosește estimări ale gradientului, poate necesita mai mult timp pentru a găsi minimul.
Metoda Powell
O altă metodă de optimizare în care se calculează doar valorile funcțiilor este . Pentru a o folosi, trebuie să setăm method = 'powell' în funcția minim.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 19
Evaluări ale funcției: 1622
[1. 1. 1. 1. 1.]Algoritmul Broyden-Fletcher-Goldfarb-Shanno (BFGS)
Pentru a obține o convergență mai rapidă către soluție, procedura utilizează gradientul funcției țintă. Gradientul poate fi specificat ca o funcție sau calculat folosind diferențe de ordinul întâi. În orice caz, metoda BFGS necesită de obicei mai puține apeluri de funcție decât metoda simplex.
Să găsim derivata funcției Rosenbrock într-o formă analitică:


Această expresie este valabilă pentru derivatele tuturor variabilelor, cu excepția primei și ultimei, care sunt definite ca:


Să ne uităm la o funcție Python care calculează acest gradient:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: - 2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm-xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1-xm)
    der [0] = -400 * x [0] * (x [1] -x [0] ** 2) - 2 * (1-x [0])
    der [-1] = 200 * (x [-1] -x [-2] ** 2)
    return der
Funcția de calculare a gradientului este specificată ca valoare a parametrului jac al funcției minim, așa cum este arătat mai jos.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 25
Evaluări ale funcției: 30
Evaluări ale gradientului: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]Algoritmul gradientelor conjugate (Newton)
Algoritm este o metodă modificată a lui Newton.
Metoda lui Newton se bazează pe aproximitatea funcției într-o zonă locală cu un polinom de gradul doi:

unde  este matricea derivatelor de ordinul doi (matricea Hessiană).
Dacă Hessiana este pozitiv definită, atunci minimul local al acestei funcții poate fi găsit prin egalarea gradientului nul al formei pătratice cu zero. Rezultatul va fi o expresie:

Hessianul invers este calculat folosind metoda gradientelor conjugate. Exemplul de utilizare a acestei metode pentru minimizarea funcției Rosenbrock este prezentat mai jos. Pentru a utiliza metoda Newton-CG, trebuie definită o funcție care calculează Hessianul.
Hessianul funcției Rosenbrock în formă analitică este egal cu:


unde  și
 , definește matricea
 .
Celelalte elemente nenule ale matricei sunt egale cu:


De exemplu, în spațiul de cinci dimensiuni N = 5, matricea Hessiană pentru funcția Rosenbrock are forma unei benzi:

Codul care calculează acest Hessian împreună cu codul pentru minimizarea funcției Rosenbrock folosind metoda gradientelor conjugate (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea funcției curente: 0.000000
Iterații: 24
Evaluări ale funcției: 33
Evaluări ale gradientului: 56
Evaluări ale hessianului: 24
[1. 1. 1. 0.99999999 0.99999999]Exemplu cu definirea funcției de produs al hessianului și al unui vector arbitrar
În problemele reale, calcularea și stocarea întregii matrice Hessian poate necesita resurse semnificative de timp și memorie. Totuși, nu este necesar să definim însăși matricea Hessian, deoarece pentru procedura de minimizare avem nevoie doar de un vector care este produsul hessianului cu un alt vector arbitrar. Din perspectiva computațională, este mult mai preferabil să definim imediat o funcție care returnează rezultatul produsului hessianului cu un vector arbitrar.
Să considerăm funcția hess, care ia ca prim argument vectorul de minimizare, iar ca al doilea argument un vector arbitrar (alături de altele argumentele funcției minimizate). În cazul nostru, calcularea produsului hessianului funcției Rosenbrock cu un vector arbitrar nu este foarte complicată. Dacă p — vectorul arbitrar, atunci produsul  are următoarea formă:

Funcția care calculează produsul hessianului și al unui vector arbitrar este transmisă ca valoare a argumentului hessp funcției minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Optimizarea s-a încheiat cu succes.
         Valoarea funcției curente: 0.000000
         Iterații: 24
         Evaluări ale funcției: 33
         Evaluări ale gradientului: 56
         Evaluări ale hessianului: 66
Algoritmul de regiune de încredere (trust region) al gradientelor conjugate (Newton)
O condiționare proastă a matricei Hessian și direcții de căutare incorecte pot face ca algoritmul gradientelor conjugate Newton să fie ineficient. În astfel de cazuri, se preferă (trust-region) a gradientelor conjugate Newton.
Exemplu cu definirea matricei Hessian:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 20
Evaluări ale funcției: 21
Evaluări ale gradientului: 20
Evaluări ale hessianului: 19
[1. 1. 1. 1. 1.]Exemplu cu funcția produsului hessian și a unui vector arbitrar:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 20
Evaluări ale funcției: 21
Evaluări ale gradientului: 20
Evaluări ale hessianului: 0
[1. 1. 1. 1. 1.]Metode de tip Krylov
Similar metodei trust-ncg, metodele de tip Krylov sunt bine adaptate pentru a rezolva probleme de mari dimensiuni, deoarece utilizează doar produse matricează-vector. Esența lor constă în rezolvarea problemei într-o zonă de încredere, limitată de un subspațiu Krylov tăiat. Pentru problemele nedefinite, este preferabil să se utilizeze această metodă, deoarece necesită un număr mai mic de iterații nenonimale datorită unui număr mai mic de produse matricează-vector pentru fiecare subproblemă, comparativ cu metoda trust-ncg. În plus, soluția subproblemelor cuadratice este obținută cu o precizie mai mare decât prin metoda trust-ncg.
Exemplu cu definirea matricei Hessian:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Optimizarea s-a încheiat cu succes.
         Valoarea curentă a funcției: 0.000000
         Iterații: 19
         Evaluări ale funcției: 20
         Evaluări ale gradientului: 20
         Evaluări ale hessianului: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Exemplu cu funcția produsului hessian și a unui vector arbitrar:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Optimizarea s-a încheiat cu succes.
         Valoarea curentă a funcției: 0.000000
         Iterații: 19
         Evaluări ale funcției: 20
         Evaluări ale gradientului: 20
         Evaluări ale hessianului: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritmul de soluție aproximativă în zona de încredere
Toate metodele (Newton-CG, trust-ncg și trust-krylov) sunt bine adaptate pentru a rezolva probleme de mari dimensiuni (cu mii de variabile). Aceasta se datorează faptului că algoritmul de gradient conjugat care stă la baza lor implică găsirea aproximativă a matricii inverse Hessiene. Soluția este obținută iterativ, fără o descompunere explicită a hessianului. Deoarece este necesar să se definească doar funcția pentru produsul hessianului și un vector arbitrar, acest algoritm este deosebit de bun pentru lucrul cu matrice sparse (diagonale bandate). Aceasta asigură costuri de memorie reduse și o economie semnificativă de timp.
În cazul problemelor de dimensiune medie, costurile de stocare și factorizare a hessianului nu sunt critice. Aceasta înseamnă că se poate obține o soluție într-un număr mai mic de iterații, rezolvând subproblemele domeniului de încredere aproape exact. Pentru aceasta, unele ecuații neliniare sunt rezolvate iterativ pentru fiecare subproblemă pătratică. Astfel de soluții necesită de obicei 3 sau 4 factorizări Cholesky ale matricei Hessian. Ca rezultat, metoda converge într-un număr mai mic de iterații și necesită mai puține evaluări ale funcției țintă în comparație cu alte metode implementate ale domeniului de încredere. Acest algoritm implică doar determinarea matricei Hessian complete și nu suportă utilizarea funcției de produs a hessianului cu un vector arbitrar.
Exemplu de minimizare a funcției Rosenbrock:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimizarea s-a încheiat cu succes.
Valoarea curentă a funcției: 0.000000
Iterații: 13
Evaluări ale funcției: 14
Evaluări ale gradientului: 13
Evaluări ale hessianului: 14
array([1., 1., 1., 1., 1.])Pe această notă, cred că ne vom opri. În articolul următor voi încerca să discut cele mai interesante aspecte ale minimizării condiționate, aplicațiile minimizării în soluționarea problemelor de aproxime, minimizarea funcției unei variabile, minimizatori arbitrare și găsirea rădăcinilor unui sistem de ecuații cu ajutorul pachetului scipy.optimize.
Sursa:
Sursa: habr.com
