

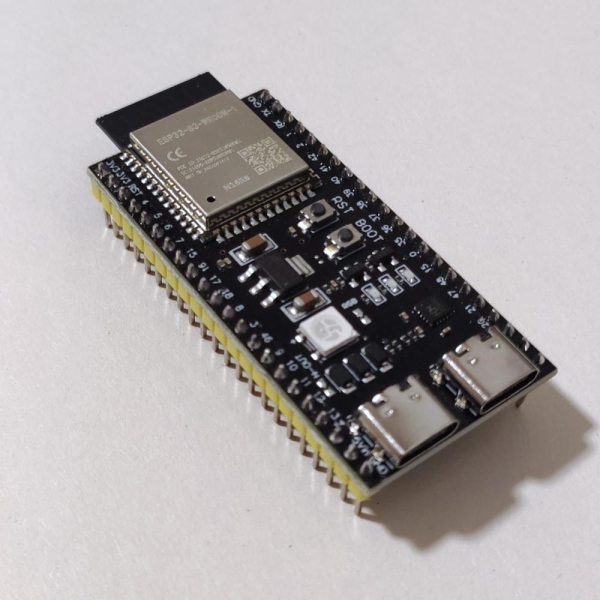
Dezvoltatorul Viacheslav Serbov, cunoscut sub pseudonimul slvDev, a demonstrat realizează o generare complet locală de text pe microcontrolerul ESP32-S3. Modelul său lingvistic conține 28,9 milioane de parametri și produce aproximativ 9,9 tokeni pe secundă, fără a apela la servere sau alte resurse de calcul externe. Poveștile scurte generate sunt afișate pe un display OLED conectat.
Proiect esp32-ai a fost testat pe modulul ESP32-S3 N16R8, care dispune de 512 KB SRAM integrat, 8 MB PSRAM și 16 MB memorie flash. Modelul cuantificat la patru biți ocupă 14,9 MB. În depozitul sunt publicate codul sursă al mediului de execuție în C, unelte pentru antrenament și cuantificare a modelului, firmware, teste și scenarii de încărcare pe placă.
Celor 28,9 milioane de parametri nu trebuie să li se facă comparații directe cu numărul de parametri ai LLM-urilor obișnuite de birou. Conform raportului detaliat al dezvoltatorului, modelul este format dintr-un nucleu de calcul dens de aproximativ 559 de mii de parametri, un strat de ieșire de 3,1 milioane de parametri și o tabelă de reprezentări vectoriale stratificate de aproximativ 25 de milioane de parametri. Această din urmă componentă asigură cea mai mare parte din dimensiunea formală a modelului, dar nu este procesată integral la generarea fiecărui token.
Modelul utilizează trei niveluri de memorie. Datele cele mai frecvent utilizate se află în SRAM intern, stratul de ieșire, cache-ul KV și buffer-ele temporare în PSRAM, iar tabelul de 25 de milioane de parametri rămâne în memoria flash și este accesibil printr-o mapare în spațiul de adresare. Pentru fiecare token, sunt citite doar aproximativ șase rânduri, cu un volum total de aproximativ 450 de bytes.
Un astfel de dispozitiv se bazează pe tehnologia Per-Layer Embeddings, aplicată de Google în Gemma 3n. Conform documentației Google, parametrii PLE pot fi stocați în afara memoriei active a modelului și adăugați în procesul de inferență pe măsură ce sunt procesate straturile individuale. În esp32-ai, această abordare este transferată în ierarhia de memorie a microcontrolerului, unde SRAM-ul rapid este deosebit de limitat.
Prima versiune corectă a mediei de execuție scrise în C genera doar 0,57 tokeni pe secundă. După plasarea stratului de ieșire în PSRAM, trecerea la activări pe 8 biți, distribuirea calculelor între cele două nuclee Xtensa LX7 și alte optimizări, întârzierea a fost redusă la 94,9 ms pe pasul modelului. Viteza finală măsurată a atins 9,88 tokeni pe secundă, luând în considerare întregul proces de generare. Principala limitare acum este lățimea de bandă PSRAM la citirea stratului de ieșire.
Modelul este antrenat pe un set de date sintetic TinyStories, constând din povești simple în limba engleză cu un vocabular limitat. Prin urmare, este capabil să continue fraze și să compună povești scurte și coerente, dar nu este destinat să răspundă la întrebări, să execute instrucțiuni, să programeze sau să reproducă cunoștințe exacte. Dezvoltatorul consideră că această muncă reprezintă în primul rând o demonstrație a plasării eficiente a modelului în memoria microcontrolerului, nu un chatbot autonom finalizat.
În documentația actuală, autorul subliniază separat că esp32-ai este o dezvoltare de sine stătătoare. Proiectele llama2.c Andrei Karpathy și un lansare anterioară a modelului de 260.000 de parametri pe ESP32-S3 sunt menționate doar ca repere și exemple ale lucrărilor anterioare: codul, punctele de control și metodologia nu sunt preluate direct din acestea. Codul sursă esp32-ai este distribuit sub licența MIT.
Sursa: linux.org.ru
