

În iunie anul acesta, în micul oraș elvețian Rapperswil, a avut loc pentru a zecea oară evenimentul numit . De data aceasta, s-au reunit peste cinci sute de iubitori ai Haskell-ului, de la începători la pionierii limbajului. Deși organizatorii numesc acest eveniment hackathon, totuși nu este o conferință sau un hackathon în sensul clasic. Formatul său se diferențiază de cele tradiționale pentru programatori. Am aflat despre ZuriHac dintr-o întâmplare fericită, am participat și acum considerăm că este datoria noastră să povestim despre această descoperire neobișnuită!
Despre noi
Acest articol a fost pregătit de doi studenți din anul al III-lea al programului „Matematică aplicată și informatică” al HSE din Saint Petersburg: Vasili Alfiorov și Elizaveta Vasilenko. Fascinația pentru programarea funcțională a început pentru amândoi cu seria de prelegeri susținută de D. N. Moskvin în anul II al universității. În prezent, Vasili participă la programul Google Summer of Code, în cadrul căruia lucrează la implementarea grafurilor algebrice în limbajul Haskell sub îndrumarea echipei proiectului . Elizaveta a aplicat abilitățile dobândite în programarea funcțională în lucrarea sa de licență, dedicată implementării algoritmului de anti-unificare, cu aplicare ulterioară în teoria tipurilor.
Formatul evenimentului
Publicul țintă include proprietarii proiectelor open source, programatori dornici să participe la dezvoltarea lor, cercetători în programarea funcțională și pur și simplu persoane pasionate de Haskell. Anul acesta, la locul desfășurării – universitatea HSR Hochschule für Technik Rapperswil – s-au adunat dezvoltatori din peste cincizeci de proiecte open source în limbajul Haskell din întreaga lume, pentru a-și prezenta produsele și a atrage oameni noi în dezvoltarea acestora.
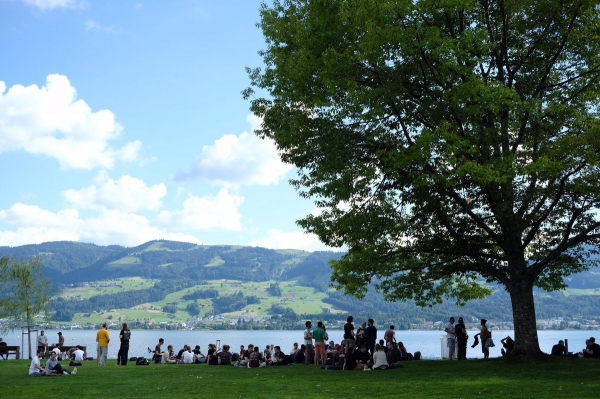
Fotografii din Twitter
Schema este foarte simplă: trebuie să scrieți din timp câteva propoziții despre proiectul vostru și să le trimiteți organizatorilor, care vor publica informațiile despre proiectul vostru pe pagina evenimentului. În plus, în prima zi, autorii proiectelor au câte treizeci de secunde pentru a povesti foarte pe scurt de la scenă despre ceea ce fac și ce trebuie să facă. Apoi, persoanele interesate îi caută pe autori și îi întreabă în detaliu despre sarcini.
Deocamdată nu avem propriile proiecte deschise, dar ne dorim foarte mult să contribuim la cele deja existente, așa că ne-am înregistrat ca participanți obișnuiți. În decurs de trei zile, am lucrat cu două grupuri de dezvoltatori. Se pare că studierea comună a codului și comunicarea live face interacțiunea dintre autorii proiectului și contribuabili foarte productivă – la ZuriHac am reușit să ne familiarizăm cu domenii noi pentru noi și am putut ajuta două echipe complet diferite, finalizând câte o sarcină în fiecare dintre proiecte.
Pe lângă experiența valoroasă, la ZuriHac au fost susținute și câteva prelegeri și ateliere. Ne-au rămas în memorie în special două prelegeri. În prima dintre ele, Andrei Mohov de la Universitatea Newcastle a vorbit despre functori aplicați selectivi — o clasă de tipuri care ar trebui să fie intermediară între functorii aplicați și monade. În cealaltă prelegere, unul dintre fondatorii Haskell-ului, Simon Peyton Jones, a discutat despre cum funcționează inferența tipurilor în compilatorul GHC.
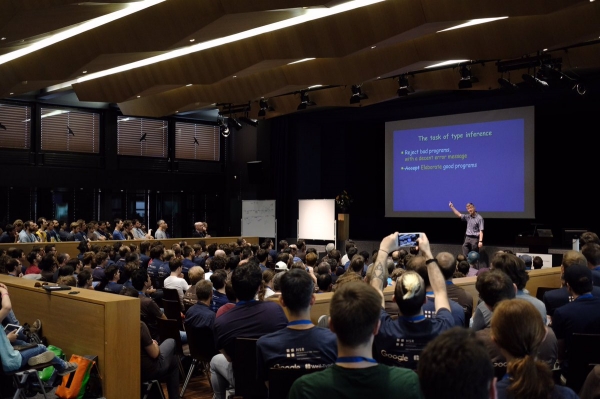
Prelegerea lui Simon Peyton Jones. Foto din Twitter
Atelierele susținute în timpul hackathon-ului au fost împărțite în trei categorii în funcție de nivelul de pregătire al participanților. Sarcinile propuse pentru cei care s-au alăturat dezvoltării proiectelor erau, de asemenea, marcate cu niveluri de dificultate. Comunitatea mică, dar unită de programatori funcționali primește cu bucurie în rândurile sale începătorii. Totuși, pentru a înțelege prelegerile lui Andrei Mohov și Simon Peyton Jones, ne-a fost foarte util cursul de programare funcțională urmat la universitate.
Atât pentru participanții obișnuiți, cât și pentru autorii de proiecte, înregistrarea la eveniment este gratuită. Ne-am depus cererile de participare la începutul lunii iunie, după care am fost rapid transferați de pe lista de așteptare în lista celor confirmați.
Acum vă vom vorbi despre proiectele la dezvoltarea căror am participat.
Pandoc
— este un convertor universal de documente de text, de fapt — din orice format în orice alt format. De exemplu, din docx în pdf, sau din Markdown în MediaWiki. Autorul său, John MacFarlane, este profesor de filosofie la Universitatea Californiană din Berkeley. În general, Pandoc este destul de cunoscut, iar unii dintre cunoscuții noștri au fost surprinși când au aflat că Pandoc este scris în Haskell.
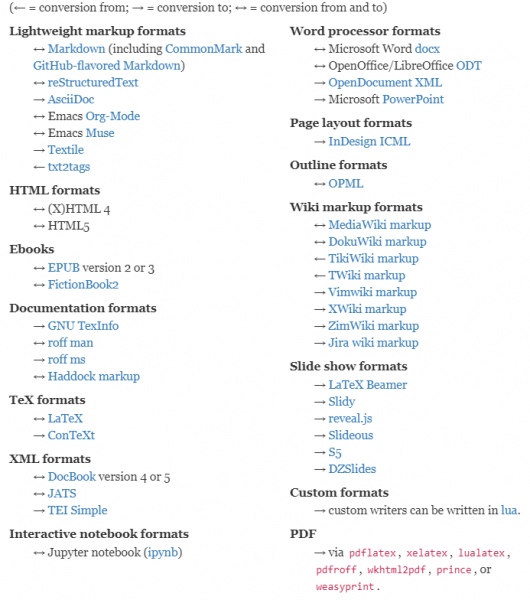
Lista formatelor de documente acceptate de Pandoc. Pe site există, de asemenea, un grafic complet, dar această imagine nu poate fi inclusă în articol.
Desigur, în Pandoc nu este implementată o conversie directă pentru fiecare pereche de formate. Pentru a sprijini un număr atât de extins de transformări, se folosește o soluție arhitecturală standard: mai întâi, întregul document este tradus într-o reprezentare intermediară specială, iar apoi, pe baza acestei reprezentări interne, este generat un document într-un alt format. Reprezentarea internă este numită de dezvoltatori „AST”, care se deschide ca Abstract Syntax Tree, sau . Poți vizualiza reprezentarea intermediară foarte simplu: trebuie doar să specifici ca format de ieșire „native”
$ cat example.html
<h1>Hello, World!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Bună,",Space,Str "Lume!"]]
Cei care au lucrat cel puțin puțin cu Haskell pot deja, din acest exemplu mic, să presupună că Pandoc este scris în Haskell: ieșirea acestei comenzi reprezintă structurile interne ale Pandoc sub formă de șir, create în mod similar cu ceea ce se face de obicei în Haskell, de exemplu, în biblioteca standard.
Așadar, aici se poate observa că reprezentarea internă este o structură recursivă, în care fiecare nod intern conține o listă. De exemplu, la cel mai înalt nivel este o listă formată dintr-un singur element - un titlu de primul nivel cu atributele “hello-world”,[],[]. În interiorul acestui titlu este ascuns o listă care conține șirul “Hello,”, un spațiu și șirul “World!”.
După cum se poate observa, reprezentarea internă nu diferă semnificativ de HTML. Aceasta reprezintă un arbore, unde fiecare nod intern oferă informații despre formatarea descendenților săi, iar în frunzele sale se află conținutul propriu-zis al documentului.
Dacă ne scufundăm în nivelul de implementare specifică, tipul de date pentru întregul document este definit astfel:
data Pandoc = Pandoc Meta [Block]Aici Block este exact vârful intern despre care s-a vorbit mai sus, iar Meta este metainformația despre document, precum titlul, data creării, autorii - pentru diferite formate, aceasta este diferită, iar Pandoc încearcă, pe cât posibil, să păstreze aceste informații atunci când se transformă dintr-un format în altul.
Aproape toate constructorii de tip Block — de exemplu, Header sau Para (paragraf) — acceptă ca argumente atribute și o listă de noduri de nivel inferior — în general Inline. De exemplu, Space sau Str sunt constructori de tip Inline, iar tag-ul HTML
devine de asemenea un Inline special. Nu vedem sensul de a prezenta o definiție completă a acestor tipuri, dar menționăm că o astfel de definiție poate fi consultată aici. .
Este interesant că tipul Pandoc este un monoid. Asta înseamnă că există un document gol și că documentele pot fi combinate între ele. Acest lucru este util atunci când scriem Reader-e — putem împărți documentul în părți printr-o logică arbitrara, analiza fiecare parte separat, și apoi reunii totul într-un singur document. În acest proces, meta-informația se va aduna din toate părțile documentului simultan.
La conversia, să spunem, din LaTeX în HTML, mai întâi un modul special, numit LaTeXReader, transformă documentul de intrare în AST, apoi un alt modul, numit HTMLWriter, convertește AST-ul în HTML. Datorită acestei arhitecturi nu trebuie să scriem un număr pătratic de conversii — este suficient să scriem un Reader și un Writer pentru fiecare nou format, iar toate perechile posibile de conversii vor fi susținute automat.
Este evident că o astfel de arhitectură are și dezavantajele sale, prevăzute de mult timp de specialiști în domeniul arhitecturii software-ului. Cel mai semnificativ este costul modificărilor în arborele sintactic. Dacă modificarea este suficient de serioasă, va trebui să schimbi codul în toate Reader-ele și Writer-ele. De exemplu, una dintre provocările cu care se confruntă dezvoltatorii Pandoc este suportul pentru formate complexe de tabele. În prezent, Pandoc poate gestiona doar cele mai simple tabele, cu antet, coloane și valori în fiecare celulă. De exemplu, atributul colspan în HTML va fi pur și simplu ignorat. Una dintre cauzele acestui comportament este lipsa unei scheme unice de reprezentare a tabelelor în toate sau măcar multe formate — prin urmare, nu este clar în ce formă ar trebui stocate tabelele în reprezentarea internă. Dar chiar și după alegerea unei reprezentări concrete, va trebui să schimbi absolut toate Reader-ele și Writer-ele care suportă lucrul cu tabelele.
Limbajul Haskell a fost ales nu doar din dragostea profundă a autorilor pentru programarea funcțională. Haskell este cunoscut pentru capabilitățile sale extinse în procesarea textelor. Un exemplu este biblioteca — o bibliotecă care folosește activ conceptele programării funcționale — monoizi, monade, functori aplicați și alternativi — pentru a scrie parseri generali. Toată puterea Parsec poate fi observată în HaskellWiki, unde este analizat un parser complet pentru un limbaj de programare imperativ simplu. Desigur, Parsec este folosit în mod activ și în Pandoc.
Dacă ar trebui să descriem pe scurt, monadele sunt folosite pentru parsarea secvențială, când la început se analizează un element, urmat de altul. De exemplu, în acest exemplu:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Mai întâi trebuie să citim spațiul alb, iar apoi statement — care are de asemenea tipul Parser Stmt.
Functorii alternativi sunt folosiți pentru a face rollback în cazul în care parsarea nu reușește. De exemplu,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Asta înseamnă că trebuie fie să încercăm să citim statement în paranteze, fie să încercăm în mod secvențial să citim mai multe statement-uri.
Functorii aplicați sunt folosiți în principal ca drumuri scurte pentru monade. De exemplu, să presupunem că funcția tok citește un anumit token (aceasta este o funcție reală din LaTeXReader). Să analizăm această combinație
const tok tokAceasta va citi două token-uri consecutiv și va returna primul dintre ele.
Pentru toate aceste clase, Haskell are operatori simbolici frumoși, ceea ce face programarea Reader-ilor să semene cu arta ASCII. Uitați-vă la acest cod minunat.
Întreaga noastră muncă a fost legată de LaTeXReader. Sarcina lui Vasily a fost să sprijine comenzile mbox și hbox, utile în scrierea pachetelor în LaTeX. Responsabilitatea Elizabethei a fost să sprijine comanda epigraph, care permite formatarea epigrafelor în documentele LaTeX.
Hatrace
În sistemele de operare de tip UNIX, apelul de sistem ptrace este adesea implementat. Este util pentru depanarea și simularea mediilor programelor, permițând urmărirea apelurilor de sistem efectuate de program. De exemplu, utilitatea foarte utilă strace utilizează în interiorul său tocmai ptrace.
Hatrace este o bibliotecă care oferă o interfață pentru ptrace în Haskell. Problema este că ptrace este foarte complex și utilizarea lui directă este destul de dificilă, mai ales din limbajele funcționale.
Hatrace, la pornire, funcționează ca strace și acceptă argumente similare. Diferența față de strace este că este și o bibliotecă, oferind o interfață mai simplă decât ptrace.
Folosind hatrace, am reușit să identificăm un bug neplăcut în compilatorul Haskell GHC — atunci când este omorât în momente necorespunzătoare, acesta generează fișiere obiect incorecte și nu le recompilă la repornire. Scriptarea apelurilor de sistem a permis reproducerea garantată a erorii la o singură rulare, când omorurile aleatorii reproducau eroarea în aproximativ două ore.
Am adăugat în bibliotecă interfețe pentru apelurile de sistem — Elizaveta a adăugat brk, iar Vasili a adăugat mmap. Ca rezultat al muncii noastre, este mai simplu și mai exact să folosești argumentele acestor apeluri de sistem atunci când utilizezi biblioteca.
Sursa: habr.com
