

În perioada 30 noiembrie - 1 decembrie, la Nizhny Novgorod s-a desfășurat. Participanții au fost invitați să creeze un prototip de soluție de produs folosind Intel OpenVINO toolkit. Organizatorii au propus o listă de teme orientative pentru alegerea sarcinii, dar decizia finală a rămas la latitudinea echipelor. De asemenea, a fost încurajată utilizarea modelelor care nu sunt incluse în produs.
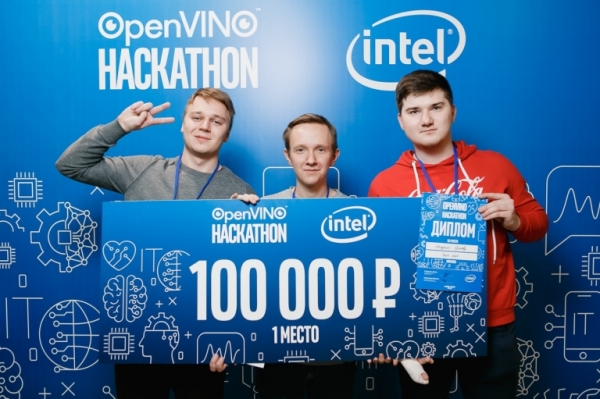
În acest articol vom vorbi despre cum ne-am creat propriul prototip de produs, cu care am câștigat în final locul întâi.
La hackathon au participat mai bine de 10 echipe. Este plăcut că unele dintre acestea au venit din alte regiuni. Locul de desfășurare a hackathon-ului a fost complexul "Kremlinskii na Pochaine", unde erau expuse fotografii vechi ale Nizhny Novgorodului, atmosfera a fost plăcută! (Amintesc că, în prezent, biroul central al companiei Intel se află tocmai în Nizhny Novgorod). Participanții aveau la dispoziție 26 de ore pentru codare, iar la final trebuiau să-și prezinte soluția. Un avantaj suplimentar a fost organizarea unei sesiuni demo, pentru a ne asigura că tot ce ne-am propus a fost într-adevăr realizat și nu a rămas doar o idee în prezentare. Iar merch, snacks, mâncare, toate au fost la dispoziție!
În plus, compania Intel a pus la dispoziție, la cerere, camere, Raspberry PI, Neural Compute Stick 2.
Alegerea sarcinii
Una dintre cele mai dificile părți ale pregătirii pentru hackathonul cu temă liberă este alegerea sarcinii. Ne-am decis imediat să venim cu ceva ce nu există încă în produs, deoarece în anunț se menționa că acest lucru este încurajat.
Analizând , care sunt incluse în produs în versiunea actuală, ajungem la concluzia că majoritatea dintre ele rezolvă diverse sarcini de viziune computerizată. De altfel, este foarte greu să găsești o sarcină din domeniul viziunii computerizate pe care să nu o poți rezolva folosind OpenVINO, iar dacă reușești să propui una, este dificil să găsești modele pre-antrenate în acces liber. Așa că am decis să explorăm și o altă direcție - în direcția procesării și analizei vorbirii. Ne gândim la o sarcină interesantă legată de recunoașterea emoțiilor prin vorbire. Trebuie menționat că există deja un model în OpenVINO care determină emoțiile unei persoane pe baza feței, dar:
- În teorie, se poate crea un algoritm combinat care va funcționa atât pe baza sunetului, cât și pe baza imaginii, ceea ce ar trebui să crească precizia.
- Camerele au, de obicei, un unghi de vedere îngust; pentru a acoperi o zonă mare, este nevoie de mai multe camere, sunetul nu are o astfel de limitare.
Dezvoltăm ideea: să luăm ca bază conceptul pentru segmentul retail. Se poate determina satisfacția clientului la casele magazinelor. Dacă cineva dintre clienți este nemulțumit de servicii și începe să vorbească mai tare, se poate apela imediat la administrator pentru ajutor.
În acest caz, trebuie adăugat recunoașterea vocală a persoanelor; acest lucru ne va permite să deosebim angajații magazinului de clienți și să generăm analize pentru fiecare individ. De asemenea, se va putea analiza comportamentul angajaților magazinului, evaluând atmosfera din echipă, ceea ce sună destul de bine!
Formulăm cerințele pentru soluția noastră:
- Dimensiune mică a dispozitivului țintă
- Funcționare în timp real
- Preț scăzut
- Scalabilitate ușoară
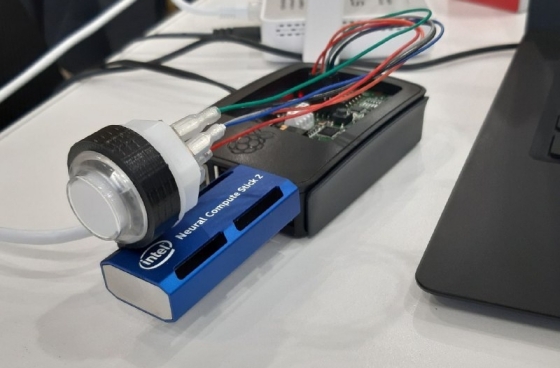
În consecință, alegem Raspberry Pi 3 ca dispozitiv țintă cu .
Este important de menționat o caracteristică esențială a NCS - funcționează cel mai bine cu arhitecturi CNN standard; dacă va fi necesar să rulați un model cu straturi personalizate, așteptați-vă la o optimizare de nivel inferior.
Aici devine simplu: trebuie să obținem un microfon. Un microfon USB obișnuit va face, deși nu va arăta bine împreună cu RPI. Dar și aici soluția este la îndemână. Pentru înregistrarea vocii, decidem să folosim placa Voice Bonnet din setul , pe care este montat un microfon stereo.
Descărcăm Raspbian din și îl transferăm pe un stick USB, testând că microfonul funcționează cu următoarea comandă (aceasta va înregistra audio timp de 5 secunde și îl va salva într-un fișier):
arecord -d 5 -r 16000 test.wavPrecizez că microfonul este foarte sensibil și captează bine zgomotele. Pentru a corecta acest lucru, vom intra în alsamixer, vom alege dispozitivele Capture și vom scădea nivelul semnalului de intrare la 50-60%.
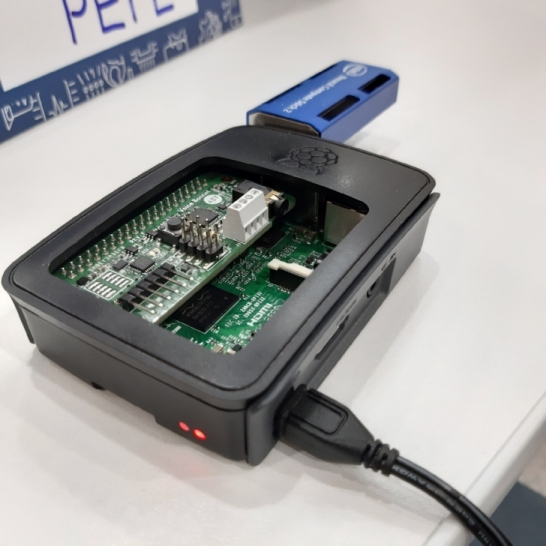
Modificăm carcasa cu un șmirghel și totul se potrivește; putem chiar să o închidem cu un capac.
Adăugăm un buton-indicator.
În timpul descompunerii kitului AIY Voice Kit, ne amintim că există un buton RGB, a cărui iluminare poate fi controlată programatic. Căutăm „Google AIY Led” și găsim documentația:
De ce să nu folosim acest buton pentru a afișa emoția recunoscută? Avem doar 7 clase, iar butonul are 8 culori, ceea ce este perfect!
Conectăm butonul prin GPIO la Voice Bonnet, încărcăm bibliotecile necesare (acestea sunt deja instalate în distribuția de la AIY projects).
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Vom crea un dict în care fiecare emoție va corespunde unei culori sub formă de Tuple RGB și un obiect al clasei aiy.leds.Leds, prin care vom actualiza culoarea:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted': (255, 0, 255), 'surprised': (255, 255, 0)}
leds = Leds()
Și, în sfârșit, după fiecare nouă predicție a emoției, vom actualiza culoarea butonului conform acesteia (după cheie).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))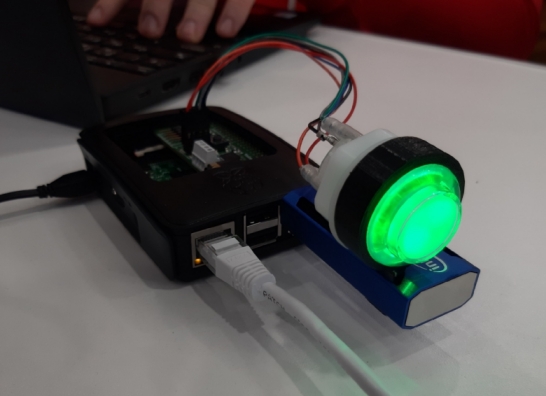
Butonule, apune!
Lucrăm cu vocea
Vom folosi pyaudio pentru a captura fluxul de la microfon și webrtcvad pentru a filtra zgomotul și detecta vocea. În plus, vom crea o coadă, în care vom adăuga și extrage fragmente cu voce.
Deoarece webrtcvad are o limitare asupra dimensiunii fragmentului care poate fi procesat — acesta trebuie să fie de 10/20/30 ms, iar antrenarea modelului pentru recunoașterea emoțiilor (așa cum vom afla mai departe) a avut loc pe un set de date de 48kHz, vom captura chuck-uri de dimensiunea 48000×20ms/1000×1 (mono) = 960 bytes. Webrtcvad va returna True/False pentru fiecare dintre aceste chuck-uri, ceea ce corespunde prezenței sau absenței vocii în chuck.
Vom implementa următoarea logică:
- Vom adăuga în listă acele chuck-uri în care există voce; dacă nu există voce, incrementăm contorul chuck-urilor goale.
- Dacă contorul chuck-urilor goale >= 30 (600 ms), ne uităm la dimensiunea listei de chuck-uri acumulate; dacă aceasta > 250, atunci adăugăm în coadă, dacă nu, considerăm că lungimea înregistrării nu este suficientă pentru a fi procesată de modelul de identificare a vorbitorului.
- Dacă totuși contorul chuck-urilor goale este încă < 30, iar dimensiunea listei de chuck-uri acumulate a depășit 300, atunci vom adăuga fragmentul în coadă pentru o predicție mai precisă. (deoarece emoțiile au tendința de a se schimba în timp)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
A sosit timpul să căutăm modele pre-antrenate disponibile public, mergem pe github, căutăm pe google, dar ținem minte că avem o limitare privind arhitectura utilizată. Aceasta este o parte destul de complicată, deoarece trebuie să testăm modelele pe datele noastre de intrare, iar în plus, să le convertim în formatul intern OpenVINO — IR (Reprezentarea Intermediară). Am încercat aproximativ 5-7 soluții diferite de pe github, iar dacă modelul pentru recunoașterea emoțiilor a funcționat imediat, recunoașterea pe baza vocii a necesitat mai mult timp — acolo sunt utilizate arhitecturi mai complexe.
Ne oprim la următoarele:
- Emoții din voce —
Funcționează pe următorul principiu: audio este tăiat în fragmente de dimensiuni definite, pentru fiecare dintre aceste fragmente extragem și apoi le introducem în CNN - Recunoașterea pe baza vocii —
Aici, în loc de MFCC, lucrăm cu spectrogramă, după FFT introducem semnalul în CNN, unde la ieșire obținem o reprezentare vectorială a vocii.
Mai departe vom discuta despre conversia modelului, să începem cu teoria. OpenVINO include mai multe module:
- Open Model Zoo, din care pot fi utilizate și incluse modele în produsul nostru
- Model Optimizer, prin care putem reconverti un model din diverse formate de framework-uri (Tensorflow, ONNX etc.) în formatul Reprezentării Intermediare, cu care vom lucra mai departe
- Inference Engine permite rularea modelelor în format IR pe procesoare Intel, cipuri Myriad și acceleratoare Neural Compute Stick
- Cea mai eficientă versiune OpenCV (cu suport pentru Inference Engine)
Fiecare model în format IR este descris de două fișiere: .xml și .bin.
Modelele sunt convertite în format IR prin Model Optimizer astfel:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepermite alegerea formatului de date cu care va lucra modelul. Sunt acceptate FP32, FP16, INT8. Alegerea tipului optim de date poate aduce un bun câștig de performanță.
--input_shapeindică dimensiunea datelor de intrare. Posibilitatea de a-o schimba dinamic pare să existe în API-ul C++, dar nu am săpat atât de adânc și pentru unul dintre modele am fixat-o.
Apoi, vom încerca să încărcăm deja modelul convertit în format IR prin modulul DNN în OpenCV și să facem forward pe el.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Ultima linie în acest caz permite redirecționarea calculelor către Neural Compute Stick, dar calculele se realizează în mod implicit pe procesor, însă în cazul Raspberry Pi aceasta nu va funcționa, va fi nevoie de stick.
Apoi, logica este următoarea: vom împărți audio în feroncle de dimensiuni specifice (în cazul nostru este de 0.4s), fiecare dintre aceste feroncle este convertit în MFCC, care vor fi ulterior alimentați către rețea:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Apoi vom lua clasa cea mai frecvent întâlnită pentru toate feronclele. O soluție simplă, dar pentru hackathon nu trebuie să ne complicăm prea mult, doar dacă avem timp. Avem mult de lucru, așa că mergem mai departe — ne ocupăm de recunoașterea vocală. Trebuie să facem un fel de bază în care să fie stocate spectrogramele vocii preînregistrate. Deoarece timpul este scurt, rezolvăm această problemă cum putem.
Anume, creăm un script pentru înregistrarea unei porțiuni de voce (funcționează exact ca în descrierea de mai sus, doar că atunci când este întrerupt cu tastatura va salva vocea într-un fișier).
Încercăm:
python3 voice_db/record_voice.py test.wavÎnregistrăm vocile mai multor persoane (în cazul nostru trei membri ai echipei)
Apoi, pentru fiecare voce înregistrată, executăm transformata rapidă Fourier, obținem spectrogramă și o salvăm sub formă de numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Detalii în fișierul
create_base.py
În final, la rularea scriptului principal, la început vom obține embedding-uri din aceste spectrograme:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)După ce primim încorporarea din segmentul auzit, putem determina cui aparține, luând distanța cosinus între fragment și toate vocile din bază (cu cât este mai mică, cu atât este mai probabil) — pentru demo am setat un prag de 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
În final, voi menționa că viteza de inferență a fost rapidă și permitea adăugarea a încă 1-2 modele (pentru un eșantion de 7 secunde, inferența dura 2.5). Nu am reușit să adăugăm modele noi și ne-am concentrat pe scrierea prototipului aplicației web.
Aplicație web
Un punct important: luăm cu noi routerul de acasă și ne configurăm rețeaua locală, ajută la conectarea dispozitivelor și laptopurilor prin rețea.
Backend-ul reprezintă un canal de mesaje între front-end și Raspberry Pi, bazat pe tehnologia websocket (http peste protocol tcp).
Primul pas este obținerea informațiilor procesate de la Raspberry, adică predicțiile ambalate în json, care pe parcursul drumului lor sunt salvate în baza de date, pentru a putea forma statistici despre mediul emoțional al utilizatorului pe o perioadă. Ulterior, acest pachet este trimis la front-end, care folosește o subscripție și primește pachetele de la endpoint-ul websocket. Întregul mecanism backend este construit în limbajul golang, alegerea a fost făcută deoarece se potrivește bine pentru sarcini asincrone, cu care goroutines se descurcă foarte bine.
La accesarea endpoint-ului, utilizatorul se înregistrează și este adăugat în structură, apoi se obține mesajul său. Atât utilizatorul, cât și mesajul sunt adăugate într-un hub comun, din care mesajele sunt trimise mai departe (la front-end-ul abonat), iar dacă utilizatorul închide conexiunea (Raspberry sau front-end), atunci subscripția sa este anulată și este eliminat din hub.
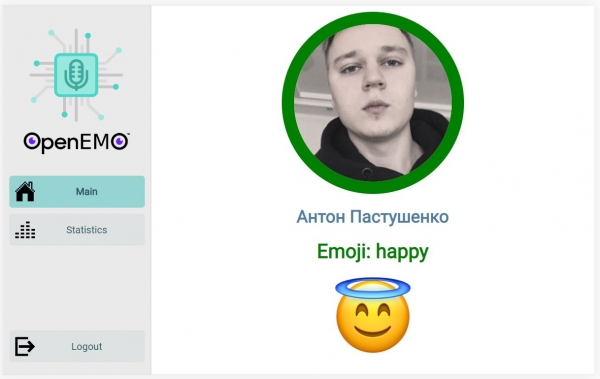
Așteptăm conectarea cu backend-ulFront-end este o aplicație web scrisă în JavaScript, utilizând biblioteca React pentru a accelera și simplifica procesul de dezvoltare. Scopul acestei aplicații este de a vizualiza datele obținute prin algoritmi rulați pe partea de back-end și, în mod direct, pe Raspberry Pi. Pe pagină există rutare pe secțiuni, realizată cu ajutorul react-router, dar cea mai mare interes e pe pagina principală, unde un flux continuu de date sosește în timp real de la server prin tehnologia WebSocket. Raspberry Pi detectează vocea, determină apartenența la o anumită persoană din baza de date înregistrată și trimite lista de probabilitate clientului. Clientul afișează cele mai recente date relevante, arată avatarul persoanei care a vorbit cu cea mai mare probabilitate în microfon, precum și emoția cu care pronunță cuvintele.

Pagina principală cu predicții actualizateConcluzie
Nu am reușit să finalizăm totul așa cum ne-am dorit, pur și simplu nu am avut timp, așa că speranța noastră principală era la demo, că totul va funcționa. În prezentare s-a discutat despre modul în care este organizat totul, ce modele au fost utilizate și cu ce probleme s-au confruntat. A urmat o parte de demo — experții s-au plimbat prin sală în mod aleator și s-au apropiat de fiecare echipă pentru a vedea prototipul funcțional. Ne-au pus întrebări și noi, fiecare a răspuns pe partea sa, iar pe laptop am lăsat web-ul, și totul a funcționat exact cum ne așteptam.
Voi menționa că costul total al soluției noastre a fost de 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (se poate utiliza placa respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Cum să îmbunătățim:
- Folosirea înregistrării de la client — a cere să citească textul pe care îl generăm aleatoriu
- Adăugarea altor câteva modele: prin voce se poate determina sexul și vârsta
- Separarea vocilor care sună simultan (diarizare)
Repozitariu:

Obosiți, dar fericițiÎn încheiere, vreau să mulțumesc organizatorilor și participanților. Dintre proiectele altor echipe, soluția pentru monitorizarea locurilor de parcare libere ne-a plăcut cel mai mult. Pentru noi a fost o experiență extrem de interesantă de a ne adânci în produs și de a dezvolta. Sper că în regiunile noastre vor avea loc tot mai multe evenimente interesante, inclusiv în tematica AI.
Sursa: habr.com
