

În acest articol, vom analiza exercițiile teoretice ale transformării funcției de regresie liniare în funcția de transformare logit inversă (cunoscuta și ca funcția de răspuns logistic). Apoi, folosind arsenalul metodei maximului de verosimilitate, conform modelului de regresie logistică, vom deriva funcția de pierdere Logistic Loss, sau, cu alte cuvinte, vom determina funcția prin care în modelul de regresie logistică sunt ajustate parametrii vectorului de greutăți  .
Planul articolului:
- Vom repeta despre dependența liniară dintre două variabile
- Vom evidenția necesitatea transformării funcției de regresie liniare
 în funcției de răspuns logistic
- Vom efectua transformările și vom deriva funcției de răspuns logistic
- Vom încerca să înțelegem de ce metoda celor mai mici pătrate este deficitară în ajustarea parametrilor funcții Logistic Loss
- Vom folosi metoda maximului de verosimilitate pentru a determina funcția de ajustare a parametrilor :
5.1. Cazul 1: funcția Logistic Loss pentru obiecte cu desemnarea claselor 0 și 1:
5.2. Cazul 2: funcția Logistic Loss pentru obiecte cu desemnarea claselor -1 și +1:
 în funcției de răspuns logistic

 funcții Logistic Loss
 :


Articolul abundă de exemple simple, în care toate calculele pot fi efectuate cu ușurință verbal sau pe hârtie; în unele cazuri, poate fi necesar un calculator. Așadar, pregătiți-vă 🙂
Acest articol este în primul rând destinat datasciențiștilor cu un nivel de cunoștință elementar în conceptele de bază ale învățării automate.
Articolul va include, de asemenea, cod pentru graficare și calcule. Întregul cod este scris în limbajul python 2.7. Voi explica din timp despre «noutatea» versiunii utilizate — aceasta este o condiție a participării la cunoscutul curs de la Yandex pe o platformă de educație online bine cunoscută Coursera, și, după cum se poate presupune, materialul este pregătit pe baza acestui curs.
01. Dependența liniară
Este absolut legitim să ne întrebăm — ce legătură are dependența liniară cu regresia logistică?
Este simplu! Regresia logistică este unul dintre modelele care aparțin clasificatorului liniar. Pe scurt, scopul unui clasificator liniar este de a prezice valorile țintă  din variabile (regresori)
 . Se consideră că dependența dintre trăsăturile
 și valorile țintă
 linear. Hence the name of the classifier — linear. If we generalize very roughly, the logistic regression model is based on the assumption of a linear relationship between features
 și valorile țintă
 . Here it is — the connection.
In the studio, the first example is about the linear relationship of the variables being studied. While preparing the article, I came across an example that many are already quite familiar with — the dependence of current strength on voltage ('Applied Regression Analysis', N.Draper, G.Smith). We will also consider it here.
In accordance with Ohm's law:
 , unde
 — current strength,
 — voltage,
 — resistance.
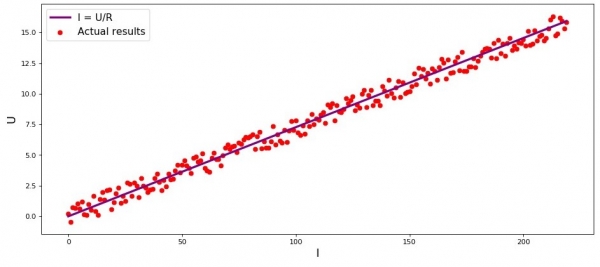
If we did not know Ohm's law, we could find the relationship empirically by changing  and measuring
 , keeping
 constant. We would then see that the graph of the dependence
 de la
 gives a more or less straight line passing through the origin. We said 'more or less' because, although the relationship is actually precise, our measurements may contain small errors, and hence the points on the graph may not lie strictly on the line but be scattered around it randomly.
Chart 1 'Dependence  de la
 »
Code for plotting the chart
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Actual results')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. The necessity of transforming the linear regression equation
Let's consider another example. Imagine that we are working in a bank and our task is to determine the likelihood of a borrower's loan repayment based on certain factors. To simplify the task, we will consider only two factors: the borrower's monthly salary and the monthly payment amount for loan repayment.
The task is very conditional, but with this example, we will be able to understand why applying funcției de regresie liniare, is not sufficient for its solution, and also learn what transformations need to be applied to the function.
Revenim la exemplu. Este clar că, cu cât salariul este mai mare, cu atât debitorul va putea direcționa lunar o sumă mai mare pentru rambursarea creditului. Totuși, pentru un anumit interval de salarii, această dependență va fi destul de liniară. De exemplu, să luăm un interval de salarii de la 60.000 R până la 200.000 R și să presupunem că, în cadrul acestui interval, dependența între suma plăților lunare și salariu este liniară. Să presupunem că pentru intervalul menționat, s-a identificat că raportul salariu la plată nu poate scădea sub 3 și că debitorului trebuie să-i rămână în rezervă 5.000 R. Numai în acest caz, vom considera că debitorul va returna creditul băncii. Atunci, ecuația regresiei liniare va avea forma:

unde  ,
 ,
 ,
 — salariul
 -ului debitor,
 — plata pentru credit
 -ului debitor.
Înlocuind în ecuație salariul și plata creditului cu parametrii fixați  se poate lua o decizie cu privire la aprobat sau refuzat creditul.
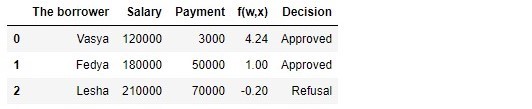
Aducându-ne înainte, să menționăm că, având în vedere parametrii dați,  funcția de regresie liniară, aplicată în funcția de răspuns logistic va returna valori mari, ceea ce va îngreuna realizarea calculelor pentru determinarea probabilităților de rambursare a creditului. De aceea, se propune reducerea coeficientului nostru, să spunem, cu 25.000 de ori. Din această transformare a coeficientelor, decizia de acordare a creditului nu se va schimba. Să reținem acest aspect pentru viitor, iar acum, pentru a fi și mai clar despre ce este vorba, să analizăm situația cu trei debitori potențiali.
Tabelul 1 „Debitorii potențiali”
Cod pentru generarea tabelului
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Debitorul':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salariu':np.array([120000,180000,210000]),
       'Plată':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salariu']*w_1 + df['Plată']*w_2

decizie = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Aprobat'
        decizie.append(dec)
    else:
        dec = 'Refuz'
        decizie.append(dec)

df['Decizie'] = decizie

df[['Debitorul', 'Salariu', 'Plată', 'f(w,x)', 'Decizie']]
Conform datelor din tabel, Vasya, cu un salariu de 120.000 R, dorește un credit pe care să-l ramburseze lunar cu 3.000 R. Am stabilit că, pentru aprobarea creditului, salariul lui Vasya trebuie să fie de trei ori mai mare decât plata, și să mai rămână 5.000 R. Această cerință este îndeplinită de Vasya:  . Rămâne chiar 106.000R. În ciuda faptului că la calcul
 am redus coeficienturile
 de 25.000 de ori, rezultatul a fost același — creditul poate fi aprobat. Fedya va primi, de asemenea, un credit, în timp ce lui Lesha, deși câștigă cel mai mult, va trebui să-și tempera apetitul.
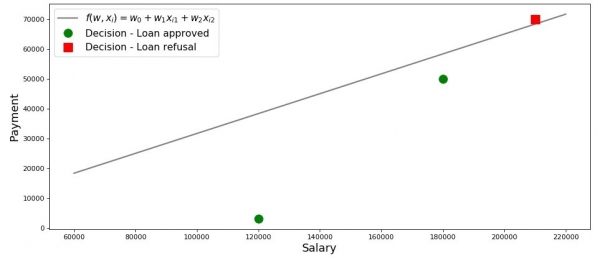
Să desenăm un grafic în acest caz.
Grafic 2 „Clasificarea împrumutătorilor”
Cod pentru desenarea graficului
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Decizie - Credit aprobat')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Decizie - Refuz credit')
plt.xlabel('Salariu', size = 16)
plt.ylabel('Plată', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Așadar, dreapta noastră, construită conform funcției  , separă împrumutătorii „răi” de cei „buni”. Cei care au dorințe ce nu coincid cu posibilitățile sunt deasupra dreptei (Lesha), iar cei care pot returna creditul conform parametrilor modelului nostru, se află sub dreaptă (Vasya și Fedya). Cu alte cuvinte, dreapta noastră împarte împrumutătorii în două clase. Să le denumim astfel: la clasa
 vom include împrumutătorii care cel mai probabil vor returna creditul, iar la clasa
 sau
 vom include împrumutătorii care cel mai probabil nu vor putea returna creditul.
Să generalizăm concluziile din acest exemplu simplu. Să luăm punctul  și, substituind coordonatele punctului în ecuația corespunzătoare a dreptei
 , să examinăm trei variante:
- Dacă punctul se află sub dreaptă, și noi îl clasificăm la clasa , atunci valoarea funcției va fi pozitivă în raport cu la . Așadar, putem considera că probabilitatea de rambursare a creditului se află în intervalul . Cu cât valoarea funcției este mai mare, cu atât probabilitatea este mai mare.
- Dacă punctul se află deasupra dreptei și noi îl clasificăm la clasa sau , atunci valoarea funcției va fi negativă în raport cu la . Atunci vom considera că probabilitatea de rambursare a datoriilor se află în intervalul și, cu cât valoarea funcției este mai mare ca modul, cu atât încrederea noastră este mai mare.
- Punctul se află pe dreaptă, la limita dintre cele două clase. În acest caz, valoarea funcției va fi egală cu și probabilitatea de rambursare a creditului este .
 , atunci valoarea funcției
 va fi pozitivă în raport cu
 la
 . Așadar, putem considera că probabilitatea de rambursare a creditului se află în intervalul
 . Cu cât valoarea funcției este mai mare, cu atât probabilitatea este mai mare.
 sau
 , atunci valoarea funcției va fi negativă în raport cu
 la
 . Atunci vom considera că probabilitatea de rambursare a datoriilor se află în intervalul
 și, cu cât valoarea funcției este mai mare ca modul, cu atât încrederea noastră este mai mare.
 va fi egală cu
 și probabilitatea de rambursare a creditului este
 .
Acum, să ne imaginăm că nu avem doar doi factori, ci zeci, împrumutătorii nu sunt trei, ci mii. Atunci, în loc de o dreaptă, vom avea m-dimensional plane and coefficients  we will take them not from thin air, but derived according to all rules, based on accumulated data about borrowers who have either repaid or not repaid their loans. And indeed, note that we are currently selecting borrowers with already known coefficients
 . In fact, the task of the logistic regression model is precisely to determine the parameters
 , at which the value of the loss function Logistic Loss will strive to reach a minimum. But we will learn how the vector is calculated
 , in the 5th section of the article. For now, let’s return to the promised land — to our banker and his three clients.
Thanks to the function  we know to whom we can lend money and to whom we need to refuse. But with such information, we cannot approach the director, as they wanted us to provide the probability of repayment for each borrower. What to do? The answer is simple — we need to transform the function
 , whose values lie in the range
 to a function, whose values will lie in the range
 . And such a function exists; it's called the logistic response function or inverse-logit transformation. Meet:

Let’s look step by step at how we derive the logistic response function. Note that we will be stepping backward, i.e., we will assume that we know the probability value that lies within the range from  la
 and then we will 'unfold' this value over the entire range of numbers from
 la
 .
03. We derive the logistic response function
Step 1. We will translate probability values into the range

During the transformation of the function  în funcției de răspuns logistic
 we will leave our credit analyst alone for a while, and instead, we will visit the bookmakers. No, of course, we won't be placing bets, everything that interests us there is the meaning of the expression, for example, odds of 4 to 1. Odds, familiar to everyone placing bets, represent the ratio of 'successes' to 'failures'. From a probability perspective, odds are the probability of an event occurring divided by the probability that the event does not occur. Let's write the formula for the odds of an event occurring
 :

, unde  — the probability of the event occurring,
 — the probability of the event NOT occurring.
De exemplu, dacă probabilitatea ca un cal tânăr, puternic și viguros numit «Viteză» să o depășească în curse pe o bătrână slabă numită «Matilda» este  , atunci șansele de succes ale lui «Viteză» vor fi
 la

 și invers, știind șansele, nu ne va fi greu să calculăm probabilitatea
 :

Astfel, am învățat să «traducem» probabilitatea în șanse, care iau valori de la  la
 . Să facem un alt pas și să învățăm să «traducem» probabilitatea pe întreaga linie numerică de la
 la
 .
Pasul 2. Vom traduce valorile probabilității în intervalul

Acest pas este foarte simplu — vom aplica logaritmul șanselor folosind baza numărului Euler  și vom obține:

Acum știm că dacă  , atunci calcularea valorii
 va fi foarte simplă și, mai mult, aceasta ar trebui să fie pozitivă:
 . Așa este.
De curiozitate, să verificăm, ce se întâmplă dacă  , atunci ne așteptăm să vedem o valoare negativă
 . Să verificăm:
 . Totul este corect.
Acum știm cum să traducem valoarea probabilității de la  la
 pe întreaga linie numerică de la
 la
 . În următorul pas vom face totul invers.
Până atunci, să subliniem că, conform regulilor de logaritmare, știind valoarea funcției  , putem calcula șansele:

Această metodă de determinare a șanselor ne va fi utilă în pasul următor.
Pasul 3. Vom deriva formula pentru determinare

Așadar, am învățat, cunoscând  , să găsim valorile funcției
 . Totuși, de fapt, ceea ce ne trebuie este exact pe dos — știind valoarea
 să găsim
 . Pentru aceasta, ne vom referi la conceptul de funcție inversă a șanselor, conform căreia:

În acest articol nu vom deriva formula menționată mai sus, ci vom verifica cu cifrele din exemplul anterior. Știm că pentru șansele egale cu 4 la 1 ( ), probabilitatea ca evenimentul să aibă loc este 0.8 (
 ). Să facem substituția:
 . Aceasta se potrivește cu calculele noastre efectuate anterior. Continuăm.
La pasul anterior am derivat că  , ceea ce înseamnă că putem face o substituție în funcția inversă a șanselor. Vom obține:

Vom împărți atât numărătorul, cât și numitorul la  , astfel:

Ca precauție, pentru a ne asigura că nu am greșit nicăieri, să facem încă o mică verificare. La pasul 2, am determinat pentru  că
 . Așadar, înlocuind valoarea
 în funcția de răspuns logistic, ne așteptăm să obținem
 . Facem substituția și obținem:

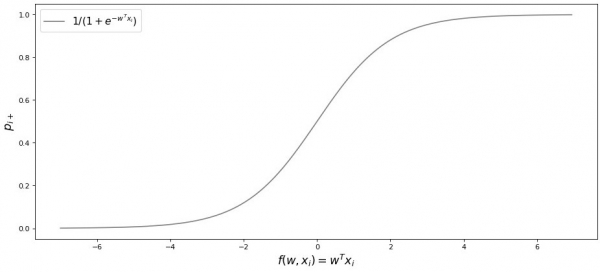
Felicitări, stimate cititor, tocmai am lansat și testat funcția de răspuns logistic. Să aruncăm o privire asupra graficului funcției.
Graficul 3 „Funcția de răspuns logistic”
Cod pentru desenarea graficului
import math

def logit(f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(f, p, color='grey', label='$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size=16)
plt.ylabel('$p_{i+}$', size=16)
plt.legend(prop={'size': 14})
plt.show()
În literatură, această funcție mai este cunoscută și sub denumirea de funcția sigmoidă. Din grafic este evident că principalul schimbare a probabilității de apartenență a unui obiect la o clasă se petrece pe un interval relativ restrâns  , undeva între
 la
 .
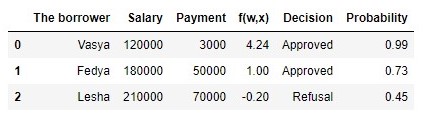
Vă propun să ne întoarcem la analistul nostru de credite și să-l ajutăm cu calcularea probabilității de rambursare a creditelor, altfel riscă să rămână fără premiu 🙂
Tabelul 2 „Împrumutătorii potențiali”
Cod pentru generarea tabelului
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i), 2))

df['Probabilitate'] = proba

df[['Împrumutătorul', 'Salariu', 'Plata', 'f(w,x)', 'Decizie', 'Probabilitate']]
Așadar, am determinat probabilitatea de rambursare a creditului. În general, aceasta pare a fi corect.
Într-adevăr, probabilitatea ca Vasya, cu un salariu de 120.000 R, să poată returna lunar 3.000 R băncii se apropie de 100%. Trebuie să înțelegem că banca poate oferi credit și lui Lesha, în cazul în care politica băncii prevede, de exemplu, să finanțeze clienții cu o probabilitate de rambursare a creditului mai mare de, să zicem, 0.3. Pur și simplu, în acest caz, banca va forma o rezervă mai mare pentru pierderile posibile.
De asemenea, trebuie menționat că raportul salariu-plată nu mai mic de 3 și cu un surplus de 5.000 R a fost ales arbitrar. Prin urmare, nu ne-a fost permis să folosim forma inițială a vectorului de ponderi.  . A trebuit să reducem semnificativ coeficienții și, în acest caz, am împărțit fiecare coeficient la 25.000, ceea ce, în esență, ne-a ajustat rezultatul. Dar acest lucru a fost făcut intenționat, pentru a simplifica înțelegerea materialului în etapa inițială. În viața reală, însă, nu trebuie să inventăm și să ajustăm coeficienții, ci să îi găsim. Exact în capitolele următoare ale articolului, vom obține ecuațiile prin care se determină parametrii.
 .
04. Metoda celor mai mici pătrate în determinarea vectorului de ponderi în funcția de răspuns logistic
 în funcția de răspuns logistic
Deja ne este cunoscută o astfel de metodă de ajustare a vectorului de ponderi  , precum metoda celor mai mici pătrate (MCP) și, prin urmare, de ce să nu-l folosim în sarcinile de clasificare binară? De fapt, nimic nu ne împiedică să folosim MNC, doar că această metodă în sarcinile de clasificare oferă rezultate mai puțin precise decât Logistic Loss. Acest lucru are o bază teoretică. Să privim mai întâi un exemplu simplu.
Să presupunem că modelele noastre (folosind MSE și Logistic Loss) au început deja să ajusteze vectorul de greutăți  și am oprit calculul la un anumit pas. Nu contează dacă este la mijloc, la sfârșit sau la început, important este că avem deja anumite valori ale vectorului de greutăți și să presupunem că, în acest pas, vectorii de greutăți
 pentru ambele modele nu au diferențe. Atunci să luăm greutățile obținute și să le introducem în funcției de răspuns logistic (
 ) pentru un anumit obiect care aparține clasei
 . Să examinăm două cazuri, când, conform vectorului de greutăți ales, modelul nostru greșește grav și invers — modelul este foarte încrezător că obiectul aparține clasei
 . Să vedem ce penalizări vor fi 'aplicate' în utilizarea MNC și Logistic Loss.
Cod pentru calcularea penalizărilor în funcție de funcția de pierdere utilizată
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Cazul de eroare gravă — modelul asociază obiectul cu clasa  cu o probabilitate de 0.01
Penalizarea utilizând MNC va fi:

Penalizarea utilizând Logistic Loss va fi:

Cazul de încredere mare — modelul asociază obiectul cu clasa  cu o probabilitate de 0.99
Penalizarea utilizând MNC va fi:

Penalizarea utilizând Logistic Loss va fi:

Acest exemplu ilustrează bine faptul că, în cazul unei erori grave, funcția de pierdere Log Loss penalizează modelul mult mai sever decât MSE. Să înțelegem acum care sunt premisele teoretice pentru utilizarea funcției de pierdere Log Loss în sarcinile de clasificare.
05. Metoda maximului verisimilitudinii și regresia logistică
Așa cum am promis la început, articolul abundă în exemple simple. În studio, un alt exemplu și vechii oaspeți — împrumutați de la bancă: Vasya, Fedya și Lesha.
Pentru orice eventualitate, înainte de a dezvolta exemplul, amintesc că în viața reală avem de-a face cu un set de antrenament din mii sau milioane de obiecte cu zeci sau sute de caracteristici. Cu toate acestea, aici cifrele sunt alese astfel încât să fie ușor de reținut de către un începător în data science.
Revenim la exemplul nostru. Să presupunem că directorul băncii a decis să acorde un credit tuturor celor care au nevoie, deși algoritmul sugera să nu i-l acorde lui Leșa. Și a trecut suficient timp pentru a afla cine dintre cei trei eroi a rambursat creditul și cine nu. Așa cum ne-am așteptat: Vasya și Fedya au rambursat creditul, iar Leșa - nu. Acum să ne imaginăm că acest rezultat va fi pentru noi un nou set de date de învățare și, în același timp, că toate informațiile despre factorii care influențează probabilitatea rambursării creditului (salariul împrumutului, suma plății lunare) au dispărut. Atunci, intuitiv, putem presupune că un împrumutător din trei nu returnează creditul băncii sau, cu alte cuvinte, probabilitatea ca următorul împrumutător să ramburseze creditul  . Această presupunere intuitivă are o confirmare teoretică și se bazează pe metoda maximelor probabilităților, care este adesea numită în literatură principiul maximelor probabilităților.
Pentru început, să ne familiarizăm cu aparatul conceptual.
Probabilitatea unei selecții este probabilitatea de a obține exact această selecție, obținând exact aceste observații / rezultate, adică produsul probabilităților de a obține fiecare dintre rezultatele selecției (de exemplu, rambursat sau nerambursat creditul de către Vasya, Fedya și Leșa simultan).
Funcția de probabilitate leagă probabilitatea selecției de valorile parametrelor distribuției.
În cazul nostru, selecția de învățare reprezintă un model generalizat Bernoulli, în care variabila aleatorie poate lua doar două valori:  sau
 . Prin urmare, probabilitatea selecției poate fi scrisă ca o funcție de probabilitate a parametrului
 în următorul mod:


Această formulare poate fi interpretată în felul următor. Probabilitatea comună ca Vasya și Fedya să ramburseze creditul este egală cu  , probabilitatea ca Leșa să NU ramburseze creditul este egală cu
 (deoarece a avut loc de fapt NERAMBURSAREA creditului), prin urmare, probabilitatea comună a tuturor celor trei evenimente este egală cu
 .
Metoda maximelor probabilităților este metoda de estimare a unui parametru necunoscut prin maximizarea funcției de probabilitate. În cazul nostru, trebuie să găsim o astfel de valoare  , la care
 atinge maximul.
De unde provine, de fapt, ideea de a căuta valoarea unui parametru necunoscut la care funcția de verosimilitate atinge maximul? Rădăcinile acestei idei derivă din conceptul că eșantionul este singura sursă de cunoștințe despre populația generală. Tot ceea ce știm despre populația generală este reprezentat în eșantion. Prin urmare, tot ceea ce putem afirma este că eșantionul este cea mai precisă reflectare a populației generale disponibilă pentru noi. Deci, trebuie să găsim un astfel de parametru pentru care eșantionul nostru devine cel mai probabil.
Este evident că ne confruntăm cu o problemă de optimizare în care trebuie să găsim punctul de extremum al funcției. Pentru a determina punctul de extremum, trebuie să luăm în considerare condiția de ordinul întâi, adică să egalăm derivata funcției cu zero și să rezolvăm ecuația în raport cu parametrul căutat. Cu toate acestea, căutarea derivatelor unei produse cu un număr mare de multiplicatori poate fi o activitate îndelungată; pentru a evita aceasta, există o tehnică specială - trecerea la logaritm. funcției de probabilitate. De ce este posibilă o astfel de trecere? Să observăm că nu căutăm extremumul funcției în sine , ci punctul de extremum, adică aceea valoare a parametrului necunoscut
 , la care
 care atinge maximul. Odată ce ne mutăm la logaritm, punctul de extremum nu se schimbă (deși extremumul în sine va fi diferit), deoarece logaritmul este o funcție monotonă.
Haideți să continuăm, conform celor menționate mai sus, să dezvoltăm exemplul nostru cu creditele lui Vasya, Fedya și Lesha. În primul rând, să trecem la logaritmul funcției de verosimilitate:

Acum putem să derivăm cu ușurință expresia în raport cu  :

Și, în cele din urmă, să examinăm condiția de ordinul întâi - egalăm derivata funcției cu zero:

Așadar, estimarea noastră intuitivă a probabilității de rambursare a creditului  a fost fundamentată teoretic.
Excelent, dar ce ar trebui să facem acum cu aceste informații? Dacă presupunem că fiecare al treilea împrumutat nu va returna banii băncii, atunci aceasta va falimenta inevitabil. Chiar așa este, dar atunci când evaluăm probabilitatea de rambursare a creditului ca fiind egală cu  nu am luat în considerare factorii care influențează rambursarea creditului: salariul împrumutatului și dimensiunea plății lunare. Să ne amintim că anterior am calculat probabilitatea de rambursare a creditului de către fiecare client, ținând cont de acești factori. Este logic că am obținut probabilități diferite de constantă.
 .
Haideți să definim verosimilitatea eșantioanelor:
Cod pentru calcularea verosimilității eșantioanelor
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Verosimilitatea eșantionului pentru valoarea constantă p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Verosimilitatea eșantionului pentru valoarea calculată p:', round(likelihood(y,p_log_response),3)
Verosimilitatea eșantionului pentru valoarea constantă  :

Verosimilitatea eșantionului în calculul probabilității de rambursare a creditului, ținând cont de factori  :


Verosimilitatea eșantionului cu probabilități calculate în funcție de factori s-a dovedit a fi mai mare decât verosimilitatea cu valoarea constantă a probabilității. Ce înseamnă asta? Înseamnă că cunoștințele despre factori au permis o estimare mai precisă a probabilității de rambursare a creditului pentru fiecare client. Așadar, la acordarea unui nou credit, este mai corect să utilizăm modelul de evaluare a probabilității de rambursare a creanței, propus la sfârșitul secțiunii 3 a articolului.
Dar atunci, dacă trebuie să maximizăm funcția verosimilității eșantionului, atunci de ce să nu folosim un algoritm care să ofere probabilități pentru Vasia, Fedia și Leșa, de exemplu, egale cu 0.99, 0.99 și 0.01, respectiv. Poate că un astfel de algoritm va funcționa bine pe eșantionul de antrenament, deoarece va apropia valoarea verosimilității eșantionului.  , dar, pe de o parte, un astfel de algoritm va avea, cel mai probabil, dificultăți în ceea ce privește capacitatea de generalizare; pe de altă parte, acest algoritm cu siguranță nu va fi liniar. Și dacă metodele de combatere a supraspecializării (la fel ca și capacitatea slabă de generalizare) nu fac parte din planul acestui articol, atunci să detaliem al doilea punct. În acest sens, este suficient să răspundem la o întrebare simplă. Poate probabilitatea rambursării creditului de către Vasya și Fedya să fie aceeași având în vedere factorii pe care îi cunoaștem? Din punct de vedere logic, cu siguranță nu poate. Astfel, Vasya va plăti 2,5% din salariul său pe lună pentru rambursarea creditului, în timp ce Fedya va plăti aproape 27,8%. De asemenea, pe graficul 2 „Clasificarea clienților”, vedem că Vasya se află semnificativ mai departe de linia care separă clasele decât Fedya. Și în final, știm că funcția
 pentru Vasya și Fedya ia valori diferite: 4,24 pentru Vasya și 1,0 pentru Fedya. Dacă Fedya, de exemplu, ar câștiga cu mult mai mult sau ar solicita un credit mai mic, atunci probabilitățile de rambursare a creditului pentru Vasya și Fedya ar fi similare. Cu alte cuvinte, o dependență liniară nu poate fi înșelată. Și dacă am fi calculat cu adevărat coeficientii
 , și nu i-am fi luat de pe cer, am putea susține fără ezitare că valorile noastre
 permit cel mai bine estimarea probabilității de rambursare a creditului de către fiecare împrumutat; dar, cum ne-am convenit să considerăm că determinarea coeficientilor
 a fost realizată conform tuturor regulilor, așa că o vom considera — coeficientii noștri permit cea mai bună estimare a probabilității 🙂
Cu toate acestea, ne-am distrat. În această secțiune, trebuie să ne dăm seama cum se determină vectorul greutăților  , care este necesar pentru a evalua probabilitatea de rambursare a creditului de către fiecare împrumutat.
Să rezumăm pe scurt, cu ce arsenal ne prezentăm pentru a căuta coeficienții  :
1. Presupunem că dependența dintre variabila țintă (valoarea estimativă) și factorul care influențează rezultatul este liniară. Din această cauză, se aplică funcția de regresie liniară de tipul  , linia căruia divide obiectele (clienții) în clase
 și
 sau
 (clienți capabili să ramburseze creditul și clienți incapabili). În cazul nostru, ecuația are forma
 .
2. Folosim funcția de transformare logit inversă de tipul  pentru a determina probabilitatea apartenenței unui obiect la clasă
 .
3. Considerăm eșantionul nostru de antrenament ca o realizare generalizată schemele Bernoulli, adică pentru fiecare obiect se generează o variabilă aleatoare, care cu o probabilitate  (a sa pentru fiecare obiect) ia valoarea 1 și cu o probabilitate
 – 0.
4. Știm că trebuie să maximizăm funcția verosimilității eșantionului ținând cont de factorii luați în considerare, astfel încât eșantionul existent să devină cel mai plauzibil. Cu alte cuvinte, trebuie să alegem astfel de parametrii, încât eșantionul să fie cea mai plauzibilă. În cazul nostru, parametrul ales este probabilitatea de rambursare a creditului  , care la rândul său depinde de coeficienții necunoscuți
 . Așadar, trebuie să găsim un astfel de vector de greutăți
 , pentru care plauzibilitatea eșantionului va fi maximă.
5. Știm că pentru maximizarea funcției de plauzibilitate a eșantionului se poate folosi metoda maximului de verosimilitate. Și știm toate trucurile pentru a lucra cu această metodă.
Asta e o mișcare în multe etape 🙂
Și acum să ne amintim că la începutul articolului am vrut să derivăm două tipuri de funcții de pierdere Logistic Loss în funcție de modul în care sunt denumite clasele de obiecte. Se obișnuiește ca, în sarcinile de clasificare cu două clase, clasele să fie denumite  și
 sau
 . În funcție de denumire, va rezulta funcția corespunzătoare de pierdere.
Cazul 1. Clasificarea obiectelor pe și
 și

Anterior, atunci când determinam plauzibilitatea eșantionului, în care probabilitatea de rambursare a datoriilor de către debitor era calculată pe baza factorilor și coeficientelor date  , am aplicat formula:

De fapt  — aceasta este valoarea funcției de răspuns logistic
 pentru un vector de greutăți dat

Atunci nu există nimic care să ne împiedice să scriem funcția de plauzibilitate a eșantionului astfel:

Se întâmplă uneori ca unor analiști începători să le fie greu să înțeleagă cum funcționează această funcție. Să examinăm 4 exemple scurte, care vor clarifica totul:
1. Dacă  (adică conform eșantionului de antrenament, obiectul aparține clasei +1), iar algoritmul nostru
 determină probabilitatea ca obiectul să aparțină clasei
 egală cu 0.9, atunci acest fragment al plauzibilității eșantionului se va calcula astfel:

2. Dacă  , iar
 , atunci calculul va fi astfel:

3. Dacă  , iar
 , atunci calculul va fi astfel:

4. Dacă  , iar
 , atunci calculul va fi astfel:

Evident, funcția de plauzibilitate va fi maximizată în cazurile 1 și 3 sau, în general, în cazul în care valorile probabilităților atribuite obiectului clasei sunt corecte  .
Întrucât, atunci când se determină probabilitatea că un obiect aparține clasei  nu cunoaștem doar coeficientii
 , așa că îi vom căuta. Așa cum s-a menționat anterior, aceasta este o sarcină de optimizare, în care la început trebuie să găsim derivata funcției de verosimilitate în raport cu vectorul de greutăți
 . Cu toate acestea, înainte de toate, are sens să ne simplificăm sarcina: vom căuta derivata logaritmului funcției de probabilitate.

De ce după logaritmizare, în funcția de eroare logistică, am schimbat semnul din  pe
 . Totul este simplu, deoarece în problemele de evaluare a calității modelului este obișnuit să minimizăm valoarea funcției, așa că am înmulțit partea dreaptă a expresiei cu
 și, prin urmare, în loc de maximizare, acum minimizăm funcția.
De fapt, acum, sub ochii voștri, a fost derivată cu trudă funcția de pierdere — Logistic Loss pentru un set de antrenament cu două clase:  și
 .
Acum, pentru a găsi coeficientii, va trebui doar să găsim derivata funcția de eroare logistică și apoi, folosind metode numerice de optimizare, precum coborârea gradientului sau coborârea gradientului stohastic, să alegem coeficientii cei mai optimi  . Dar, având în vedere volumul deja considerabil al articolului, se propune să efectuezi diferențierea de unul singur sau, poate, aceasta va fi tema următorului articol cu mai multă aritmetică și fără atât de multe exemple detaliate.
Cazul 2. Clasificarea obiectelor în și
 și

Abordarea va fi aceeași ca și cu clasele  și
 , dar drumul către derivarea funcției de pierdere Logistic Loss, va fi mai complicat. Începem. Vom folosi operatorul pentru funcția de verosimilitate „dacă..., atunci...”. Adică, dacă
 -ul obiect aparține clasei
 , atunci pentru calcularea verosimilității selecției folosim probabilitatea
 , dacă obiectul aparține clasei
 , atunci introducem în verosimilitate
 . Așa arată funcția de verosimilitate:

Să descriem în termeni simpli cum funcționează. Să luăm în considerare 4 cazuri:
1. Dacă  și
 , atunci verosimilitatea selecției va „merge”

2. Dacă  și
 , atunci verosimilitatea selecției va „merge”

3. Dacă  și
 , atunci verosimilitatea selecției va „merge”

4. Dacă  și
 , atunci verosimilitatea selecției va „merge”

Este evident că în cazul 1 și 3, când probabilitățile au fost corect determinate de algoritm, funcția de verosimilitate va fi maximizată, adică exact asta am dorit să obținem. Cu toate acestea, această abordare este destul de voluminoasă și vom analiza o scriere mai compactă. Dar mai întâi, logaritmizăm funcția de verosimilitate schimbând semnul, deoarece acum o vom minimiza.

Să substituim în loc de  expresia
 :

Să simplificăm termenul din dreapta logaritmului, folosind metode simple de aritmetică și obținem:

Acum este timpul să scăpăm de operatorul „dacă..., atunci...”. Observăm că atunci când obiectul  aparține clasei
 , în expresia de sub logaritm, la numitor,
 este ridicat la puterea
 , dacă obiectul aparține clasei
 , atunci $e$ este ridicat la puterea
 . Prin urmare, exprimarea puterii poate fi simplificată - combinând ambele cazuri într-unul:
 . Atunci funcția erorii logistice va avea forma:

Conform regulilor de logaritmare, vom întoarce fracția și vom scoate semnul " " (minus) în afara logaritmului, obținem:

În fața voastră se află funcția de pierdere logistic Loss, care se aplică în setul de antrenament cu obiecte aparținând claselor:  și
 .
Ei bine, la acest punct eu mă retrag și încheiem articolul.
Lucrarea anterioară a autorului - "Transformarea ecuației regresiei liniare în formă matrice"
Materiale auxiliare
1. Literatură
1) Analiza de regresie aplicată / N. Draper, G. Smith - ediția a 2-a - Moscova: Finanțe și statistică, 1986 (traducere din engleză)
2) Teoria probabilităților și statistica matematică / V.E. Gmurman - ediția a 9-a - Moscova: Școala superioară, 2003
3) Teoria probabilităților / N.I. Cernova - Novosibirsk: Universitatea de Stat Novosibirsk, 2007
4) Analiza de afaceri: de la date la cunoștințe / Paklin N.B., Oreshkov V.I. - ediția a 2-a - Sankt Petersburg: Peter, 2013
5) Data Science - Știința datelor de la zero / Joel Grass - Sankt Petersburg: BHV Petersburg, 2017
6) Statistică practică pentru specialiști în Data Science / P. Bruce, E. Bruce - Sankt Petersburg: BHV Petersburg, 2018
2. Lecții, cursuri (video)
1)
2)
3)
4)
5)
3. Surse pe internet
1)
2)
3)
4)
5)
6)
7)
8)
Sursa: habr.com
