

Codul produselor software pentru învățarea automată este adesea complex și destul de confuz. Identificarea și eliminarea erorilor din acesta este o sarcină consumatoare de resurse. Chiar și cele mai simple necessită o abordare serioasă în ceea ce privește arhitectura rețelei, inițializarea greutăților și optimizarea rețelei. O mică greșeală poate duce la apariția unor probleme neplăcute.
Acest articol este dedicat algoritmului de depanare a rețelelor neuronale.
Skillbox recomandă: Curs practic .
Vă reamintim: pentru toți cititorii „Habr” — reducere de 10.000 de ruble la înscrierea la orice curs Skillbox cu codul de promovare „Habr”.
Algoritmul constă în cinci etape:
- începere simplă;
- confirmarea pierderilor;
- verificarea rezultatelor intermediare și a conexiunilor;
- diagnosticarea parametrilor;
- monitorizarea funcționării.
Dacă ceva ți se pare mai interesant decât restul, poți să treci imediat la aceste secțiuni.
Începere simplă
Depanarea unei rețele neuronale cu o arhitectură complexă, regularizare și un planificator al vitezei de învățare este mai dificilă decât cea a unei rețele obișnuite. Ne folosin un pic de subtilitate aici, deoarece acest punct are o relație indirectă cu depanarea, dar este totuși o recomandare importantă.
Începerea simplă constă în crearea unui model simplificat și învățarea acestuia pe un singur set (punct) de date.
Primul pas este crearea unui model simplificat
Pentru a începe rapid, creăm o rețea mică cu un singur strat ascuns și ne asigurăm că totul funcționează corect. Apoi, complicăm treptat modelul, verificând fiecare nou aspect al structurii sale (strat suplimentar, parametru etc.) și continuăm.
Învățarea modelului pe un singur set (punct) de date
Ca verificare rapidă a funcționalității proiectului tău, poți folosi un sau două puncte de date pentru a confirma dacă sistemul funcționează corect. Rețeaua neuronală ar trebui să arate o precizie de 100% la învățare și testare. Dacă nu este așa, fie modelul este prea mic, fie deja există o eroare.
Chiar dacă totul este bine, pregătește modelul pentru a parcurge una sau mai multe epoci înainte de a merge mai departe.
Evaluarea pierderilor
Evaluarea pierderilor este metoda principală pentru a rafina performanța modelului. Trebuie să te asiguri că pierderea corespunde sarcinii și că funcțiile de pierdere sunt evaluate pe o scală corectă. Dacă folosești mai mult de un tip de pierdere, asigură-te că toate sunt de același ordin și corect scalate.
Este important să fii atent la pierderile inițiale. Verifică cât de aproape este rezultatul real de cel așteptat, dacă modelul a pornit de la o presupunere aleatoare. În : „Asigurați-vă că obțineți rezultatul așteptat atunci când începeți să lucrați cu un număr mic de parametrii. Cel mai bine este să verificați imediat pierderile de date (cu gradul de regularizare setat la zero). De exemplu, pentru CIFAR-10 cu clasificatorul Softmax, ne așteptăm ca pierderile inițiale să fie 2.302, deoarece probabilitatea difuză așteptată este de 0.1 pentru fiecare clasă (deoarece există 10 clase), iar pierderea Softmax este logaritmul negativ al probabilității clasei corecte, adică -ln(0.1) = 2.302”.
Pentru un exemplu binar, se face un calcul similar pentru fiecare dintre clase. Iată, de exemplu, datele: 20% 0’s și 80% 1’s. Pierderea inițială așteptată va fi până la -0,2ln(0,5) - 0,8ln(0,5) = 0,693147. Dacă rezultatul este mai mare de 1, acest lucru poate indica că greutățile rețelei neuronale nu sunt echilibrate corespunzător sau că datele nu sunt normalizate.
Verificăm rezultatele intermediare și conexiunile
Pentru a debuga rețeaua neuronală, este necesar să înțelegem dinamica proceselor din interiorul rețelei și rolul fiecărei straturi intermediare, deoarece acestea sunt interconectate. Iată greșelile tipice cu care s-ar putea să te confrunți:
- expresiile greșite pentru actualizările gradientului;
- nu se aplică actualizările greutății;
- gradienti care dispar sau explodând (exploding gradients).
Dacă valorile gradientului sunt zero, înseamnă că rata de învățare a optimizatorului este prea mică sau că te confrunți cu o expresie incorectă pentru actualizarea gradientului.
În plus, este necesar să monitorizăm valorile funcțiilor de activare, greutăților și actualizărilor fiecărei straturi. De exemplu, magnitudinea actualizărilor parametrilor (greutăților și biasurilor) .
Există un fenomen cunoscut sub numele de „Dying ReLU” sau , când neuronii ReLU vor returna zero după ce au învățat o valoare negativă mare (bias) pentru greutățile lor. Acești neuroni nu se mai activează niciodată în date.
Puteți folosi verificarea gradientului pentru a identifica aceste erori prin aproximarea gradientului utilizând o abordare numerică. Dacă este aproape de gradientele calculate, atunci propagarea inversă a fost implementată corect. Pentru a crea o verificare a gradientului, consultați aceste resurse minunate din CS231 și , precum și lui Andrew Ng pe această temă.
identifică trei metode principale de vizualizare a rețelelor neuronale:
- Vizualizări preliminare — metode simple care ne arată structura generală a modelului antrenat. Acestea includ ieșirea formelor sau a filtrelor straturilor individuale ale rețelei neuronale și parametrii din fiecare strat.
- Bazate pe activare. Acestea decodează activările neuronilor individuali sau ale grupurilor de neuroni pentru a înțelege funcțiile acestora.
- Bazate pe gradienti. Aceste metode tind să manipuleze gradientii formați din trecerea înainte și înapoi în timpul antrenării modelului (inclusiv hărțile de importanță și hărțile de activare pentru clasă).
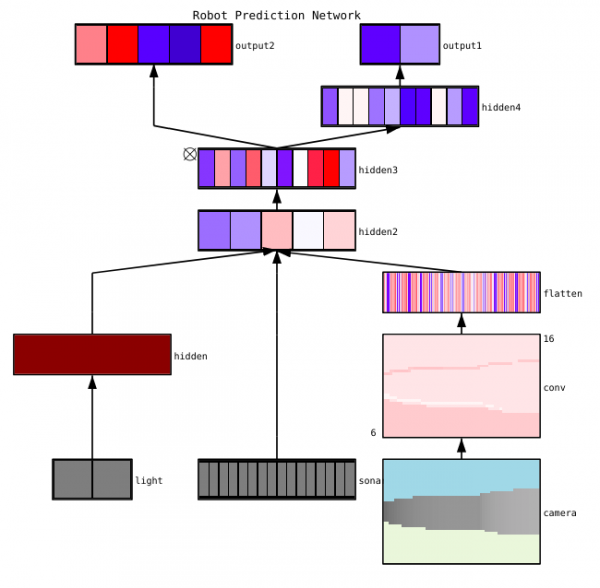
Există câteva instrumente utile pentru vizualizarea activărilor și conexiunilor din straturile individuale, cum ar fi și .
Diagnosticarea parametrilor
Rețelele neuronale au o mulțime de parametri care interacționează între ei, ceea ce complică optimizarea. De fapt, această secțiune este subiectul unor cercetări active, așa că recomandările de mai jos ar trebui considerate doar ca sfaturi, puncte de plecare de la care se poate porni.
Dimensiunea lotului (batch size) — este necesar ca dimensiunea lotului să fie suficient de mare pentru a obține estimări precise ale gradientului erorii, dar suficient de mică pentru ca gradientul stocastic descendent (SGD) să poată organiza rețeaua dumneavoastră. Dimensiunile mici ale lotului vor duce la o convergență rapidă din cauza zgomotului din procesul de antrenare și, ulterior, la dificultăți în optimizare. Aceasta este descrisă mai detaliat .
Rata de învățare — prea mică va duce la o convergență lentă sau va risca să rămână blocată în minime locale. În același timp, o rată de învățare mare va provoca divergența optimizării, deoarece riscați să "săriți" peste o parte adâncă, dar îngustă a funcției de pierdere. Încercați să folosiți planificarea ratei pentru a o reduce în timpul antrenării rețelei neuronale. În cursul CS231n .
Tăierea gradientului — tăierea parametrilor gradientului în timpul propagării invers cumulate la valoarea maximă sau norma limită. Este util pentru rezolvarea problemelor cu orice gradient exploziv cu care te poți confrunta în al treilea punct.
Normalizarea pe loturi — este folosită pentru normalizarea datelor de intrare ale fiecărei straturi, ajutând la rezolvarea problemei de deplasare a covarianței interne. Dacă folosești Dropout și Batch Normalization împreună, .
Învățarea gradientului stocastic (SGD) — există mai multe variante de SGD care utilizează impuls, viteze de învățare adaptative și metoda Nesterov. Cu toate acestea, nimeni dintre ele nu are un avantaj clar în ceea ce privește eficiența învățării sau generalizarea ().
Regularizare — este crucială pentru construirea unui model generalizabil, deoarece adaugă o penalizare pentru complexitatea modelului sau valorile extreme ale parametrilor. Este o modalitate de a reduce dispersia modelului fără a crește semnificativ prejudiciul acestuia. Mai .
Pentru a evalua totul singur, este necesar să dezactivezi regularizarea și să verifici gradientul pierderii datelor singur.
Dropout — este o altă metodă de organizare a rețelei tale pentru a preveni supraîncărcarea. În timpul antrenamentului, Dropout se realizează menținând activitatea neuronului cu o probabilitate p (un hiperparametru) sau stabilindu-l la zero în caz contrar. Ca urmare, rețeaua trebuie să utilizeze un alt subset de parametri pentru fiecare grupă de antrenament, ceea ce reduce variațiile unor parametri care devin dominanți.
Important: dacă folosești atât dropout, cât și normalizarea pe loturi, fii atent la ordinea acestor operații sau chiar la utilizarea lor împreună. Toate acestea sunt încă active în discuții și completări. Iată două discuții importante pe această temă și .
Monitorizarea performanței
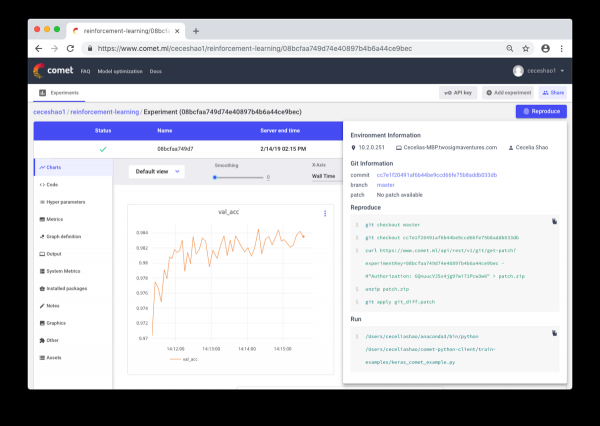
Este vorba despre documentarea proceselor de lucru și experimentelor. Dacă nu se documentează nimic, există riscul de a uita, de exemplu, care este viteza de învățare sau greutatea claselor. Datorită controlului, este posibil să vizualizați și să reproduceți fără probleme experimentele anterioare. Acest lucru ajută la reducerea numărului de experimente duplicate.
Adevărat, documentarea manuală poate deveni o sarcină complexă în cazul unui volum mare de muncă. Aici intervin instrumente precum Comet.ml, care ajută la logarea automată a seturilor de date, modificărilor de cod, istoricului experimentelor și modelelor de producție, inclusiv informații esențiale despre modelul dumneavoastră (hiperparametrii, măsurătorile performanței modelului și detalii despre mediu).
Rețelele neuronale pot fi foarte sensibile la mici modificări, ceea ce poate duce la o scădere a performanței modelului. Monitorizarea și documentarea funcționării sunt primul pas pe care ar trebui să îl faceți pentru a standardiza mediul și modelarea.
Sper că acest post poate deveni punctul de plecare de la care veți începe să debugați rețeaua dumneavoastră neurală.
Skillbox recomandă:
- Curs practic de doi ani .
- Curs online .
- Curs practic anual .
Sursa: habr.com
