

Spoločnosť Mozilla vyvíja nástroj na rozpoznávanie reči Whisperfile, ktorý obsahuje nezávislú vysoko výkonnú implementáciu modelu strojového učenia Whisper, vytvoreného a sprístupneného organizáciou OpenAI. Nástroj je postavený na základe whisper.cpp, implementácie modelu Whisper v C/C++, ktorú vytvoril Georgij Gerganov (autor llama.cpp). Kód je napísaný v jazyku C++ a je distribuovaný pod licenciou MIT.
Whisperfile vyvíja tím Mozilla Ocho a dopĺňa projekt llamafile, ktorý je určený na vytváranie univerzálnych spustiteľných súborov na spustenie veľkých jazykových modelov strojového učenia (LLM). Podobne ako llamafile, projekt whisperfile umožňuje na základe súboru s parametrami modelu strojového učenia vo formáte GGUF vygenerovať spustiteľný súbor, ktorý môže byť spustený v rôznych operačných systémoch na zariadeniach s procesormi AMD64 a ARM64. Kompilovaný kód sa môže prepojiť so štandardnou C knižnicou Cosmopolitan, čo umožňuje vytvárať zostavy aplikácií, ktoré sú spustiteľné v Linuxe, FreeBSD, macOS, OpenBSD, NetBSD a Windows.
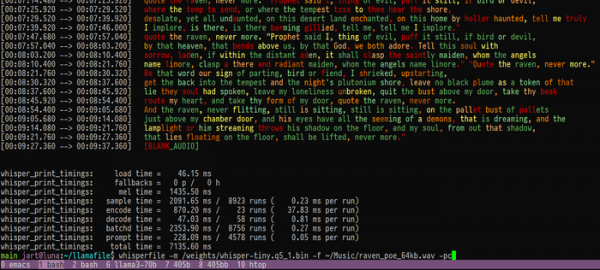
Pri spustení spustiteľného súboru sa ako vstupný parameter predáva súbor so zvukom reči vo formáte wav, mp3, ogg alebo flac, a výsledkom je uložený rozpoznaný text. V praxi sa projekt môže použiť na riešenie takých úloh, ako je generovanie textových titulkov pre videá, vytváranie protokolu hlasových a video hovorov, prevod nahraných hlasových materiálov na text a organizovanie hlasového vstupu. Pomocou Whisperfile môžu byť tieto úlohy vykonávané na lokálnom systéme bez nutnosti obracať sa na externé služby.
Ďalšie funkcie zahŕňajú prácu v úlohe HTTP servera, ktorý spracováva požiadavky na rozpoznávanie reči prostredníctvom Web API. Na urýchlenie práce s modelom môžu byť zapojené GPU a inštrukcie AVX. Nástroj tiež môže poskytovať koeficienty dôvery, ktoré umožňujú zvýrazniť rozpoznané slová v závislosti od presnosti ich určenia.
Model Whisper bola natrénovaná na 680 tisíc hodinách rečových dát, pokrývajúcich rôzne tematické oblasti a jazyky (2/3 dát je v anglickom jazyku). Model si dobre poradí s rozpoznávaním reči s prízvukom, rozpoznáva technický žargón, podporuje automatické určenie jazyka a dokáže pracovať aj za prítomnosti pozadia. Pri anglickej reči systém vykazuje úroveň spoľahlivosti a presnosti automatického rozpoznávania blízku rozpoznávaniu človekom. Okrem prepisovania reči na text môže byť model tiež použitý na preklad reči do iného jazyka.
Zdroj: opennet.ru
