

Po piatich mesiacoch vývoja bolo zverejnené vydanie projektu IncidentRelay 1.1, ktoré rozvíja otvorenú systém na organizovanie pohotovostí, smerovanie upozornení a správu incidentov, spúšťaný na vlastnom serveri (self-hosted). IncidentRelay 1.1 je označený ako prvé stabilné vydanie (vetva 1.0 mala status beta verzie). Projekt je zameraný na SRE, DevOps a infraštruktúrne tímy, ktoré potrebujú lokálne nasaditeľnú alternatívu k SaaS službám na správu pohotovostí (on-call management), uplatňovanie politík eskalácie a reagovanie na incidenty. Kód projektu je napísaný v Pythone a je distribuovaný pod licenciou MIT.
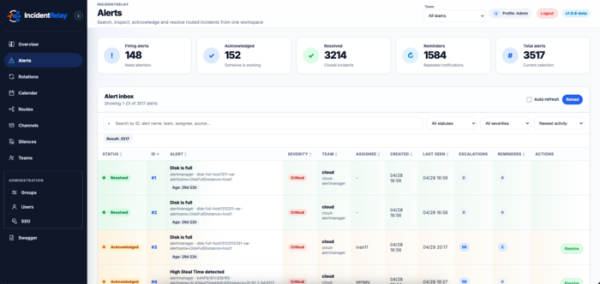
IncidentRelay prijíma udalosti zo systémov monitorovania, porovnáva ich so službou, tímom a rotáciou, po čom doručuje upozornenia zodpovedným pohotovostným pracovníkom alebo tímom. V systéme sú implementované rozvrhy pohotovostí, rotácie, predefinovanie smien, potvrdenie prijatia incidentu, stavy ACK/Resolve, pripomienky, eskalácie, dočasné náhrady pohotovostných pracovníkov, stanovenie času plánovaných prác a potlačenie hlučných upozornení.
Hlavnou výhodou projektu je úplná kontrola nad infraštruktúrou a logikou smerovania. IncidentRelay sa nasadzuje vo svojej prostredí, pracuje s vlastnou databázou a umožňuje jasne rozdeliť prichádzajúce trasy, tímy, rotácie a kanály doručovania. Prichádzajúce tokeny patria trasám, nie kanálom, čo uľahčuje pochopenie, ktorý externý zdroj má právo posielať udalosti konkrétnemu tímu.
V IncidentRelay sa podporuje prijímanie udalostí z Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch a akýchkoľvek webhook-ov. Na zasielanie upozornení sú k dispozícii kanály Mattermost, Slack, Telegram, Discord, Microsoft Teams, e-mail, webhooky, prehliadač/PWA push a poskytovatelia hlasových hovorov. V Mattermost a Telegrame môžu upozornenia obsahovať akcie na potvrdenie a vyriešenie problému, čo umožňuje spracovávať incident bez prechodu do samostatného rozhrania.
Projekt je možné spustiť pomocou Docker Compose, RPM balíka pre distribúcie podobné Red Hat, manuálne cez systemd, alebo aj v Kubernetes pomocou Helm chartu. Pre malé inštalácie je možné použiť SQLite, pre pracovné systémy a vyššie zaťaženie sa odporúča PostgreSQL.
V novej verzii sú navrhnuté nasledujúce zmeny:
- Pridali sa viacúrovňové on-call rotácie s časovými obmedzeniami, prioritami vrstiev a zohľadnením časových náhrad;
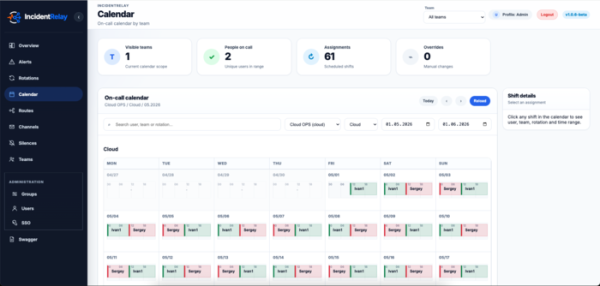
- Objavil sa kalendár pohotovostí, CalDAV a ICS predplatné pre externé kalendáre;
- Realizovali sa politiky eskalácie incidentov s viacstupňovými reťazcami zvyšovania úrovne;
- Pridali sa skupiny upozornení, skupinovanie udalostí, odložené oznámenia a ručné spojenie súvisiacich alertov;
- Objavili sa okná pre vykonávanie plánovaných prác a "tiché" alerty;
- Pridala sa možnosť pridávania komentárov k alertom;
- Pridali sa priority incidentov (P1-P5) a automatické zvyšovanie priority podľa úrovne dôležitosti;
- Realizoval sa servisný katalóg, závislosti služieb, SLI/SLO, história vplyvu na prevádzku systémov (Service Impact History) a biznis služby (Business Services);
- Objavil sa Explain Trace na rozbor trasovania: prečo alert bol alebo nebol zaradený do tímu, bol zoskupený, potlačený alebo odoslaný do konkrétneho kanála;
- Pridali sa kontroly (Heartbeats/dead-man-switch) pre watchdog, zálohu, ETL a ďalšie úlohy, kde problémom je nedostatok očakávaného signálu.
Zdroj: opennet.ru
