

Niekedy, aby vyriešili nejaký problém, je potrebné sa naň pozrieť z iného uhla. Aj keď sa v posledných desiatich rokoch podobné problémy riešili rovnakým spôsobom s rôznymi účinkami, nie je isté, že tento spôsob je jediný.
Existuje téma, ako odtok klientov. Je to nevyhnutné, pretože klienti akejkoľvek spoločnosti môžu z mnohých dôvodov prestať využívať jej produkty alebo služby. Pre spoločnosť je odtok - aj keď prirodzený - nie najžiadanejší jav, a preto sa všetci snažia tento odtok minimalizovať. Ešte lepšie je predpovedať pravdepodobnosť odtoku určitej kategórie používateľov alebo konkrétneho používateľa a navrhnúť nejaké kroky na udržanie.
Analyzovať a pokúsiť sa zadržať klienta, ak je to možné, je potrebné minimálne z týchto dôvodov:
- získanie nových klientov je drahšie než procesy udržania. Na získanie nových klientov je zvyčajne potrebné vynaložiť určité prostriedky (reklama), zatiaľ čo existujúcich klientov je možné aktivovať špeciálnou ponukou s osobitnými podmienkami;
- pochopenie dôvodov odchodu klientov je kľúčom k zlepšeniu produktov a služieb.
Existujú štandardné prístupy k predpovedaniu odtoku. No na jednom z majstrovstiev v AI sme sa rozhodli vyskúšať na tento účel Weibullovo rozdelenie. Často sa používa na analýzu prežitia, predpovedanie počasia, analýzu prírodných katastrof, v priemyselnej inžinierstve a podobne. Weibullovo rozdelenie je špeciálna distribuľačná funkcia, parametrizovaná dvoma parametrami.  a
 .
Wikipedia
Celkovo, zaujímavá téma, ale na predpovedanie odtoku a všeobecne vo fintechu sa nepoužíva tak často. Pod katom sa dozviete, ako sme to (Laboratórium inteligentnej analýzy dát) spravili, pričom sme získali zlato na Majstrovstvách v umelú inteligenciu v kategórii „AI v bankách.“
O odtoku vo všeobecnosti
Pojďme si trochu objasnit, co je to odliv zákazníků a proč je tak důležitý. Pro podnikání je důležitá zákaznická základna. Do této základny přicházejí noví zákazníci, například když se dozvědí o produktu nebo službě z reklamy, nějakou dobu existují (aktivně používají produkty) a po nějaké době přestanou používat. Tento časový úsek nazýváme „Životní cyklus zákazníka“ (angl. Customer Lifecycle) — to je termín, který popisuje fáze, kterými zákazník prochází, když se dozví o produktu, rozhodne se k nákupu, zaplatí, používá a stává se loajálním spotřebitelem, a nakonec přestane používat z různých důvodů produkty. Odpovídajícím způsobem odliv je závěrečná fáze životního cyklu zákazníka, kdy zákazník přestává využívat služby, a pro podnikání to znamená, že zákazník přestal přinášet zisk a jakoukoli jinou hodnotu.
Každý bankovní klient je konkrétní člověk, který si vybere určitou bankovní kartu přesně podle svých potřeb. Často cestuje — hodí se karta s mílemi. Hodně nakupuje — zdravím, karta s cashbackem. Hodně nakupuje ve specifických obchodech — a pro to už je tady speciální partnerský plast. Samozřejmě, někdy se karta vybírá i podle kritéria „Nejdražší údržba“. Obecně je tu dost proměnných.
A ještě si člověk vybírá banku — jaký má smysl vybírat si kartu banky, jejíž pobočky jsou pouze v Moskvě a okolí, když jsi z Chabarovsku? Ať je karta takové banky jakkoli výhodná, přítomnost poboček banky v blízkosti stále zůstává důležitým kritériem. Ano, 2019 je už tady a digitální technologie — to je vše, ale některé otázky u některých bank lze vyřešit pouze na pobočce. Plus, opět nějaká část populace mnohem více důvěřuje fyzické bance, a ne aplikaci ve smartphonu, to je také nutné vzít v úvahu.
Jak vyplývá, důvodů pro odmítnutí bankovních produktů (nebo samotné banky) může být mnoho. Změnil práci, a tarif karty se změnil z platového na „Pro obyčejné smrtelníky“, který je méně výhodný. Přestěhoval se do jiného města, kde nejsou pobočky banky. Nezamlouvalo se mu jednání s nekvalifikovaným operátorem na pobočce. To znamená, že důvodů pro uzavření účtu může být i mnohem více než pro používání produktu.
Zákazník nemusí len jasne vyjadriť svoj úmysel - prísť do banky a napísať žiadosť, ale jednoducho môže prestať používať produkty bez ukončenia zmluvy. Preto bolo rozhodnuté použiť strojové učenie a AI na pochopenie takýchto úloh.
Okrem toho môže odliv klientov nastávať v akejkoľvek oblasti (telekomunikácie, internetoví poskytovatelia, poisťovne, skrátka tam, kde existuje zákaznícka základňa a periodické transakcie).
Čo sme urobili
Predovšetkým bolo potrebné jasne vymedziť hranicu - od kedy začíname počítať klienta ako odídeného. Z pohľadu banky, ktorá nám poskytla údaje na spracovanie, bol stav aktivity klienta binárny - buď aktívny, alebo nie. V tabuľke 'Aktivita' bol flag ACTIVE_FLAG, ktorého hodnota mohla byť buď '0' alebo '1' (podľa toho 'Neaktívny' a 'Aktívny'). A všetko by bolo v poriadku, ale človek má tendenciu nejaký čas aktívne používať služby a potom na mesiac vypadnúť z aktívnych - ochorel, išiel do inej krajiny na dovolenku, alebo dokonca začal testovať kartu inej banky. Po dlhšej dobe neaktivity však môže opäť začať využívať služby banky.
Preto sme sa rozhodli nazývať obdobím neaktivity určitý nepřerušený časový úsek, počas ktorého bol pre neho flag nastavený ako '0'.
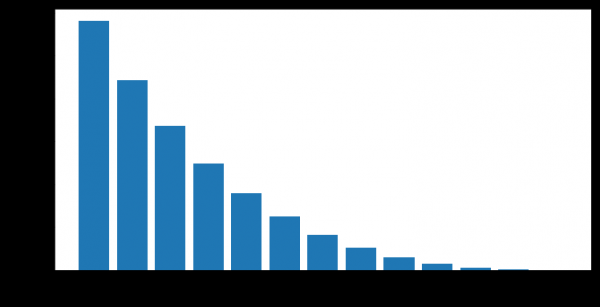
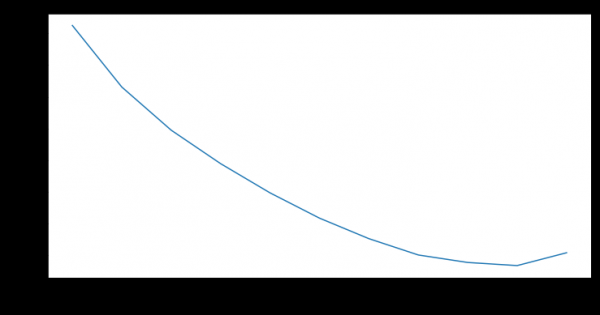
Klienti prechádzajú z neaktívnych na aktívnych po rôznych dĺžkach období neaktivity. Máme možnosť vypočítať empirickú veličinu 'spoľahlivosť období neaktivity' - teda pravdepodobnosť, že osoba opäť začne používať produkty banky po dočasnej neaktivite.
Napríklad, na tomto grafe je znázornené obnovenie aktivity (ACTIVE_FLAG=1) klientov po niekoľkých mesiacoch neaktivity (ACTIVE_FLAG=0).
Tu trochu objasníme súbor údajov, s ktorými sme začali pracovať. Banka poskytla agregované informácie za 19 mesiacov v nasledujúcich tabuľkách:
- 'Aktivita' - mesačné transakcie klientov (podľa kariet, v internetovom bankovníctve a mobilnej aplikácii), vrátane výplat a informácií o obrate.
- 'Karty' - údaje o všetkých kartách, ktoré má klient, s podrobnou tarifnou sieťou.
- „Zmluvy“ – informácie o zmluvách klienta (ako otvorených, tak aj uzavretých): úvery, vklady a iné, so uvedením parametrov každého z nich.
- „Klienti“ – súbor demografických údajov (pohlavie a vek) a dostupnosť kontaktných údajov.
Na našu prácu sme potrebovali všetky tabuľky, okrem „Kariet“.
Zložitost tu spočívala aj v tom, že banka v týchto údajoch neuvádzala, aká presne aktivita prebiehala na kartách. Teda pochopiť, či prebehli transakcie alebo nie, sme dokázali, ale určiť ich typ - už nie. Preto nebolo jasné, či klient vyberal hotovosť, dostával mzdu, alebo utrácal peniaze na nákupy. A navyše sme nemali údaje o zostatkoch na účtoch, čo by bolo užitočné.
Samotný výber bol nesliepaný - v tomto reze za 19 mesiacov banka neuplatnila žiadne pokusy o udržanie klientov a minimalizáciu odtoku.
Tak teda, o obdobiach neaktivity.
Na formulovanie definície odtoku je potrebné vybrať obdobie neaktivity. Aby sme vytvorili predpoveď odtoku v okamihu  , je potrebné mať históriu klientov minimálne na 3 mesiace v intervale
 . História bola obmedzená na 19 mesiacov, preto sme sa rozhodli zobrať obdobie neaktivity na 6 mesiacov, ak existuje. Ako minimálne obdobie pre kvalitnú predpoveď sme zobrali 3 mesiace. Čísla 3 a 6 mesiacov sme vybrali empíricky na základe analýzy správania týchto klientov.
Definíciu odtoku sme formulovali takto: mesiac odtoku klienta  je prvý mesiac s ACTIVE_FLAG=0, kde od tohto mesiaca nasleduje minimálne šesť núl za sebou v poli ACTIVE_FLAG, inými slovami, mesiac, počínajúc ktorým klient bol 6 mesiacov neaktívny.
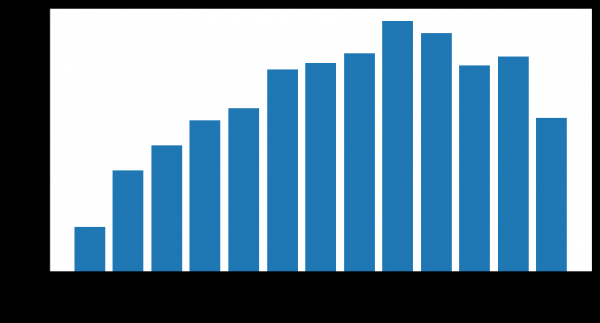
Počet odídených klientov
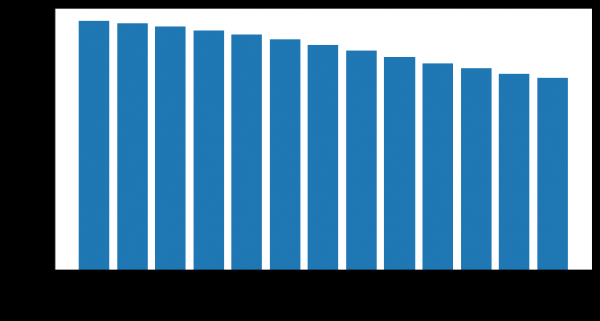
Počet zostávajúcich klientov
Ako sa predpokladá, odtok
V podobných súťažiach, a vo všeobecnosti na praxi, sa odtok celkom často predpovedá týmto spôsobom. Klient využíva produkty a služby v rôznych časových intervaloch, údaje o interakcii s ním sú predstavované vo forme vektora znakov pevných dĺžok n. Najčastejšie sa do tejto informácie zahrňuje:
- Charakterizujúce údaje o používateľovi (demografické údaje, marketingový segment).
- História používania bankových produktov a služieb (to sú akcie klientov, ktoré sú vždy viazané na konkrétny čas alebo požadovanú časovú periódu).
- Externé dáta, ak sa ich podarilo získať — napríklad recenzie zo sociálnych sietí.
A až po tom sa vypočíta definícia odchodu, vlastná pre každú úlohu. Potom sa používa algoritmus strojového učenia, ktorý predpovedá pravdepodobnosť odchodu zákazníka.  na základe vektora faktorov.
 Na tréning algoritmu sa využíva jeden z najznámejších rámcov na vytváranie ensemble rozhodovacích stromov, , , alebo ich modifikácie.
Samotný algoritmus nie je zlý, ale v oblasti predpovedania odchodu má niekoľko vážnych nedostatkov.
- Nemá takzvanú „pamäť“.Na vstup modelu prichádza stanovený počet znakov, ktoré zodpovedajú aktuálnemu časovému okamihu. Aby bolo možné zahrnúť informácie o histórii zmien parametrov, je potrebné vypočítavať špeciálne znaky, ktoré charakterizujú zmeny parametrov v čase, napríklad počet alebo súčet bankových transakcií za posledné 1, 2, 3 mesiace. Takýto prístup môže len čiastočne odrážať charakter časových zmien.
- Fixovaný horizont predpovedania. Model je schopný predpovedať odchod zákazníkov iba na vopred stanovené obdobie, napríklad predpoveď na jeden mesiac dopredu. Ak je potrebná predpoveď na iné obdobie, napríklad na tri mesiace, je potrebné znovu vytvoriť tréningovú vzorku a pretrénovať nový model.
Náš prístup
Rozhodli sme sa, že nebudeme používať štandardné prístupy. V súťaži sa okrem nás zaregistrovalo ďalších 497 ľudí, pričom každý z nich mal bohaté skúsenosti. Takže snažiť sa robiť niečo podľa štandardných schém v takýchto podmienkach — nie je najlepšia myšlienka.
A začali sme riešiť problémy, ktoré stoja pred modelom binárnej klasifikácie, pomocou predpovedania pravdepodobnostného rozdelenia času odchodu zákazníkov. Takýto prístup si môžete pozrieť, umožňuje flexibilnejšie predpovedať odchod a overovať zložitejšie hypotézy ako v klasickom prístupe. Ako rodinu rozdelení modelujúcich čas odchodu sme si vybrali rozdelenie pre jeho široké uplatnenie v analýze prežitia. Správanie zákazníka sa dá považovať za akýsi druh prežitia.
Tu sú príklady rozdelenia pravdepodobnostných hustôt Weibull v závislosti od parametrov.  a
 :
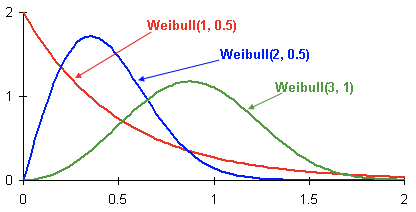
Toto je hustota rozdelenia pravdepodobnosti odtoku klienta troch rôznych klientov v priebehu času. Čas je zobrazený v mesiacoch. Inými slovami, tento graf ukazuje, kedy je najpravdepodobnejšie, že dôjde k odtoku klienta v nasledujúcich dvoch mesiacoch. Ako je vidieť, klient s rozdelením má väčší potenciál odísť skôr ako klienti s rozdeleniami Weibull(2, 0.5) a Weibull(3,1).
Nakoniec sa vytvorí model, ktorý predpovedá pre každého klienta pre akýkoľvek
mesiac parametre rozdelenia Weibull, ktoré najlepšie odrážajú pravdepodobnosť odtoku v priebehu času. Ak hovoríme podrobnejšie:
- Cieľové znaky na trénovacej vzorke — čas, ktorý zostáva do odtoku v konkrétnom mesiaci pre konkrétneho klienta.
- Ak ukazovateľ odtoku pre klienta nie je k dispozícii, predpokladáme, že čas odtoku je dlhší ako počet mesiacov od aktuálneho času do konca dostupnej histórie.
- Použitý model: rekurentná neurónová sieť s vrstvou LSTM.
- Ako funkciu straty používame negatívnu logaritmickú funkciu pravdepodobnosti pre rozdelenie Weibull.
Tu sú výhody tohto prístupu:
- Pravdepodobnostné rozdelenie, okrem zjavnej možnosti binárnej klasifikácie, umožňuje flexibilne predpovedať rôzne udalosti, napríklad, či prestane klient využívať služby banky v priebehu 3 mesiacov. Taktiež, ak je to potrebné, možno pri tomto rozdelení priemerovať rôzne metriky.
- Rekurentná neurónová sieť LSTM má pamäť a efektívne využíva celú dostupnú históriu. S rozšírením alebo objasnením histórie presnosť rastie.
- Prístup je možné bez problémov škálovať pri rozdelení časových intervalov na menšie (napríklad pri rozdelení mesiacov na týždne).
Ale nestačí len vytvoriť dobrý model, je potrebné aj správne posúdiť jeho kvalitu.
Ako sme hodnotili kvalitu
Ako metriku sme zvolili Lift Curve. Používa sa v podnikaní na podobné prípady kvôli zrozumiteľnej interpretácii, je dobre popísaná a . Ak by sme jednou vetou opísali význam tejto metriky, dostaneme: "O koľko viac algoritmus robí lepšiu predpoveď na prvých  % ako náhodne."
Trénujeme modely
Podmienkami súťaže nebola stanovená konkrétna metrika kvality, podľa ktorej by bolo možné porovnávať rôzne modely a prístupy. Navyše, definícia pojmu odtoku môže byť rôzna a môže závisieť od zadania úlohy, ktorá je opäť definovaná obchodnými cieľmi. Preto, aby sme zistili, ktorý prístup je lepší, vytrénovali sme dva modely:
- Často používaný prístup binárnej klasifikácie s použitím algoritmu strojového učenia zoskupenia rozhodovacích stromov ();
- Model Weibull-LSTM
Testovacia vzorka pozostávala z 500 vopred vybraných klientov, ktorí neboli v tréningovej vzorke. Pre model sa vykonalo ladenie hyperparameterov s použitím krížovej validácie rozdelenej podľa klientov. Pre tréning každého modelu sa používali rovnaké súbory znakov.
V súvislosti s tým, že model nemá pamäť, sa pre neho zohľadnili špeciálne znaky, ktoré ukazovali pomer zmeny parametrov jedného mesiaca k priemernej hodnote parametrov za posledné tri mesiace. Toto charakterizovalo rýchlosť zmeny hodnôt za posledné trojmesačné obdobie. Bez toho by bol model založený na Random Forest vopred v nevýhodnej pozícii v porovnaní s Weibull-LSTM.
Prečo je LSTM s Weibullovým rozdelením lepšie ako prístup založený na zoskupení rozhodovacích stromov
Tu je všetko jasné doslova pár obrázkami.
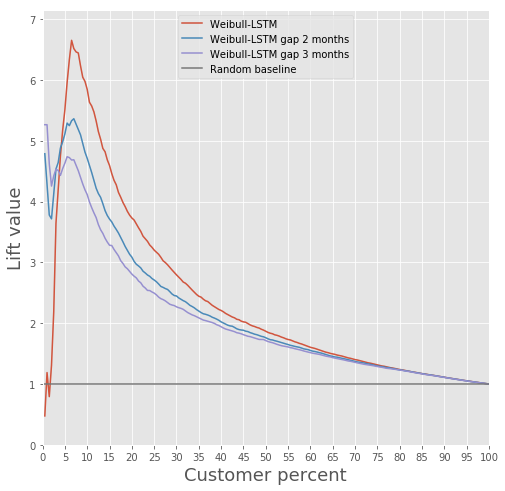
Porovnanie Lift Curve pre klasický algoritmus a Weibull-LSTM
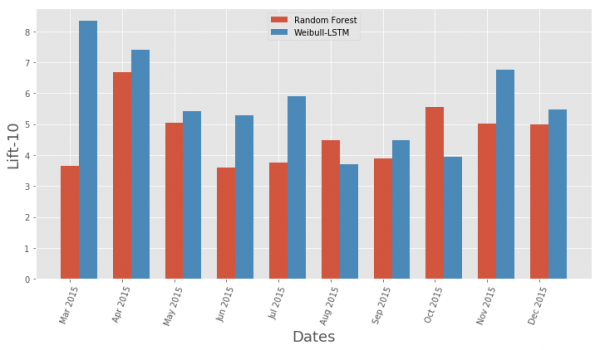
Porovnanie metriky Lift Curve podľa mesiacov pre klasický algoritmus a Weibull-LSTM
Vo všeobecnosti LSTM prekonáva klasický algoritmus takmer vo všetkých prípadoch.
Predpokladanie odtoku
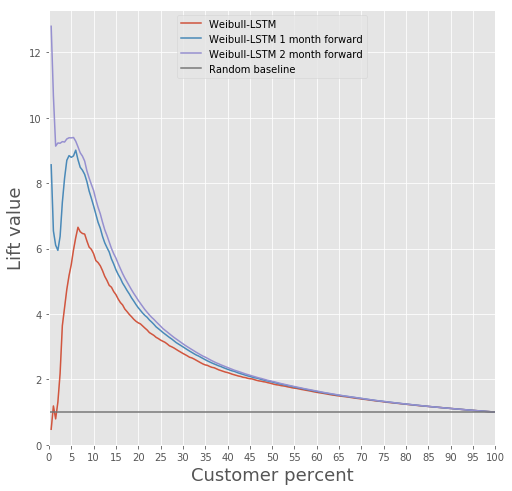
Model založený na rekurentnej neurónovej sieti s LSTM bunkami s Weibullovým rozdelením môže vopred predpovedať odtok, napríklad predpovedať odchod klienta v nasledujúcich n mesiacoch. Zvážme prípad pre n = 3. V tomto prípade by neurónová sieť mala správne určiť: či klient odíde od nasledujúceho mesiaca až po n. mesiac. Inými slovami, mala by správne určiť, či klient zostane po uplynutí n mesiacov. To možno považovať za predpoveď vopred: predpoveď okamihu, keď klient začal uvažovať o odchode.
Porovnajme Lift Curve pre Weibull-LSTM na 1, 2 a 3 mesiace pred odtokom:
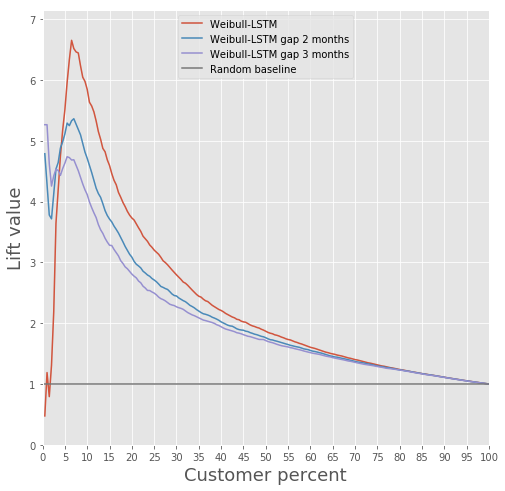
Ako sme už spomínali vyššie, dôležité sú aj predpovede pre klientov, ktorí na nejaký čas vypadnú z aktívneho používania. Preto do nášho výberu pridáme aj prípady, keď klient, ktorý odišiel, bol neaktívny jeden alebo dva mesiace a overíme, či Weibull-LSTM správne klasifikuje takéto prípady ako odchod. Keďže takéto prípady sa už vyskytli vo výbere, očakávame, že sieť s nimi dobre zaobchádza:
Udržanie klientov
Vlastne, to je hlavná vec, ktorú môžeme urobiť, keď máme informácie o tom, že niektorí klienti sa chystajú prestať používať produkt. Pri vytváraní modelu, ktorý by mohol ponúknuť niečo užitočné klientom s cieľom ich udržať - to nebude možné urobiť, ak máte len veľmi málo skúseností s podobnými pokusmi, ktoré skončili úspešne.
Nemali sme takúto históriu, a preto sme to rozhodli takto.
- Vytvárame model, ktorý určuje zaujímavé produkty pre každého klienta.
- Každý mesiac spúšťame klasifikátor a určujeme potenciálne odchádzajúcich klientov.
- Časti klientov ponúkame produkt podľa modelu z bodu 1 a zaznamenávame svoje akcie.
- Po niekoľkých mesiacoch sledujeme, ktorí z týchto potenciálne odchádzajúcich klientov odišli a ktorí zostali. Týmto spôsobom formujeme tréningový súbor.
- Trénujeme model na histórii získanej v bode 4.
- Voliteľne, opakujeme postup, vymieňajúc model z bodu 1 za model získaný v bode 5.
Kontrolou kvality takéhoto udržania môže byť bežné A/B testovanie - rozdelíme klientov, ktorí sú potenciálne odchádzajúci, do dvoch skupín. Jednej ponúkame produkty na základe nášho modelu udržania, druhej nenabízame nič. Rozhodli sme sa trénovať model, ktorý by mohol priniesť úžitok už v bode 1 nášho príkladu.
Chceli sme, aby bola segmentácia čo najviac interpretovateľná. Na tento účel sme vybrali niekoľko znakov, ktoré mohli byť ľahko interpretovateľné: celkový počet transakcií, plat, celkový obrat na účte, vek, pohlavie. Znaky z tabuľky „Karty“ sme nezohľadnili ako málo informatívne, a znaky z tabuľky 3 „Zmluvy“ - z dôvodu zložitosti spracovania, aby sa predišlo úniku údajov medzi validačným a tréningovým súborom.
Klastrácia bola vykonaná pomocou modelov Gaussian mixture. Informačné kritérium Akaike umožnilo určiť 2 optimá. Prvé optimum zodpovedá 1 klustru. Druhé optimum, menej vyjadrené, zodpovedá 80 klastrom. Z týchto výsledkov môžeme vyvodiť nasledujúci záver: je veľmi ťažké rozdeliť dáta do klastrov bez a priori zadaných informácií. Na kvalitnejšiu klasifikáciu sú potrebné dáta, ktoré podrobne opisujú každého klienta.
Preto bola zvážená úloha učenia pod dohľadom, aby sme každému jednotlivému klientovi ponúkli jeho vlastný produkt. Zvažovali sa nasledujúce produkty: „Termínovaný vklad“, „Kreditná karta“, „Ovdraf“, „Spotrebný úver“, „Autoúver“, „Hypotéka“.
V dátach bol prítomný ešte jeden typ produktu: „Bežný účet“. Ale ten sme nezvažovali kvôli nedostatočnej informatívnosti. Na základne používateľov, ktorí sú klientami banky, t.j. nezrušili používanie jej produktov, bola postavená model, ktorý predpovedá, aký produkt by ich mohol zaujímať. Ako model bola zvolená logistická regresia a ako metrika hodnotenia kvality sa používala hodnota Lift pre prvých 10 percentilov.
Kvalitu modelu je možné oceniť na obrázku.
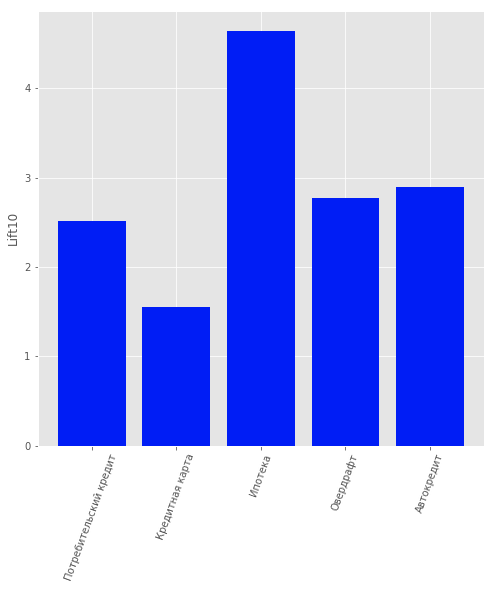
Výsledky modelu odporúčania produktov pre klientov
Záver
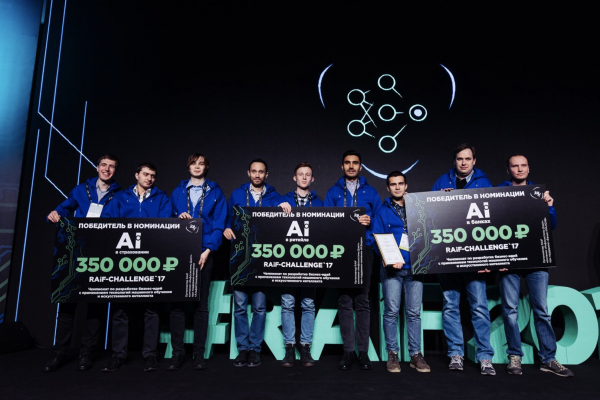
Tento prístup nám priniesol prvé miesto v kategórii „AI v bankách“ na Šampionáte AI RAIF-Challenge 2017.
Zjavne bolo najdôležitejšie pristúpiť k problému z menej tradičnej stránky a použiť metódu, ktorá sa zvyčajne používa v iných situáciách.
Aj keď hromadný odklon používateľov môže byť pre služby živelnou pohromou.
Túto metódu je možné vziať na vedomie aj pre akúkoľvek inú oblasť, kde je dôležité zohľadniť odliv, nielen v bankách. Napríklad sme ju použili aj na vypočítanie vlastného odlivu - v Sibirskom a Petersburgskom pobočke Rostelekom.
„Laboratórium inteligentnej analýzy dát“ spoločnosť „Vyhľadávací portál Sputnik“
Zdroj: habr.com
