

Ahoj, Habr!
Minulý rok na jeseň prebiehala na Kaggle súťaž v klasifikácii narýsovaných obrázkov Quick Draw Doodle Recognition, do ktorej sa okrem iných zapojil tím R-študentov v zložení , a . Podrobne nebudeme popisovať súťaž, to už bolo spravené v .
S farmom medailí sa tento raz nepodarilo uspeť, no získali sme mnoho cenných skúseností, a preto by sme sa chceli so spoločenstvom podeliť o niektoré z najzaujímavejších a najužitočnejších vecí na Kaggle a v bežnej práci. Medzi prerokovanými témami boli: ťažký život bez OpenCV, parsovanie JSON-ov (na týchto príkladoch sa zaoberáme integráciou kódu v C++ do skriptov alebo balíkov v R prostredníctvom Rcpp), parametrizácia skriptov a dockerizácia konečného riešenia. Celý kód z príspevku v prevádzkovom formáte je dostupný v .
Obsah:
1. Efektívne nahrávanie dát z CSV do databázy MonetDB
Dáta v tejto súťaži nie sú poskytované vo forme hotových obrázkov, ale ako 340 CSV-súborov (po jednom súbore na každú triedu), ktoré obsahujú JSON-y s koordinátami bodov. Spojením týchto bodov čiarami získavame konečný obraz s rozmermi 256x256 pixelov. Taktiež pre každý záznam je uvedená značka, či bol obrázok správne rozpoznaný klasifikátorom používaným v čase zberu súboru, dvojpísmenový kód krajiny, v ktorej autor obrázku žil, unikátne identifikačné číslo, časová pečiatka a názov triedy, ktorý zodpovedá názvu súboru. Zjednodušená verzia pôvodných dát váži 7.4 GB v archíve a približne 20 GB po rozbalení, plné dáta po rozbalení zaberajú 240 GB. Organizátori zaručili, že obe verzie reprodukujú rovnaké obrázky, teda, že plná verzia je nadbytočná. V každom prípade, ukladanie 50 miliónov obrázkov v grafických súboroch alebo v podobe polí bolo okamžite považované za neefektívne, a preto sme sa rozhodli zlúčiť všetky CSV-súbory z archívu train_simplified.zip do databázy s následnou generáciou obrázkov potrebného rozmeru "za behu" pre každú dávku.
Ako databázový systém bola zvolená dobre sa osvedčujúca MonetDB, konkrétne implementácia pre R vo forme balíka . Balík obsahuje embedded-verziu databázového servera a umožňuje spustiť server priamo z R relácie a pracovať s ním. Vytvorenie databázy a pripojenie k nej sa vykonáva jednou príkazom:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Budeme potrebovať vytvoriť dve tabuľky: jednu pre všetky dáta, druhú pre informačné údaje o nahratých súboroch (užitočné, ak niečo pôjde zle a proces sa bude musieť obnoviť po nahratí niekoľkých súborov):
Vytvorenie tabuliek
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Najrýchlejší spôsob nahrávania dát do DB sa ukázal byť priame kopírovanie CSV súborov pomocou SQL — príkaz COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',', 'n', '"' NULL AS '' BEST EFFORT, kde tablename — názov tabuľky a path — cesta k súboru. Pri práci s archívom sa zistilo, že zabudovaná implementácia unzip v R nesprávne funguje s niektorými súbormi z archívu, preto sme použili systémový unzip (pomocou parametra getOption("unzip")).
Funkcia na zápis do databázy
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Ak je potrebné transformovať tabuľku pred zápisom do DB, stačí odovzdať do argumentu preprocess funkciu, ktorá bude transformovať dáta.
Kód na sekvenčné nahrávanie dát do databázy:
Zápis dát do databázy
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Čas nahrávania dát sa môže líšiť v závislosti od rýchlostných charakteristík použitého úložiska. V našom prípade čítanie a zápis v rámci jedného SSD alebo z flash disku (pôvodný súbor) na SSD (DB) trvá menej ako 10 minút.
Ešte niekoľko sekúnd je potrebných na vytvorenie stĺpca s celočíselnou triedou a indexového stĺpca (ORDERED INDEX) s číslami riadkov, podľa ktorého sa bude vykonávať výber pozorovaní pri vytváraní dávok:
Vytvorenie ďalších stĺpcov a indexu
message("Generate lables")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Aby sme vyřešili úlohu vytváření dávky "na míru", museli sme dosiahnuť maximálnu rýchlosť extrakcie náhodných riadkov z tabuľky. doodles. Na to sme použili 3 triky. Prvý spočíval v znížení rozmeru typu, v ktorom sa uchováva ID pozorovania. V pôvodnom súbore dát vyžaduje uchovávanie ID typ bigint, ale počet pozorovaní nám umožňuje umiestniť ich identifikátory, ktoré sú rovné poradovému číslu, do typu int. Vyhľadávanie je pritom oveľa rýchlejšie. Druhým trikem bolo použitie ORDERED INDEX — k tomuto riešeniu sme dospeli empiricky, skúmaním všetkých dostupných . Tretí spočíval v použití parametrizeovaných dotazov. Podstatou metódy je jednorazové vykonanie príkazu PREPARE s následným použitím pripraveného výrazu pri vytváraní kopy rovnakých dotazov, no v skutočnosti bol zisk v porovnaní s jednoduchým SELECT v oblastí štatistickej chyby.
Proces načítania dát spotrebuje maximálne 450 MB RAM. To znamená, že opísaný prístup umožňuje manipulovať so súbormi dát o váhe desiatok gigabajtov prakticky na akomkoľvek rozpočtovom železe, vrátane niektorých jednodeskových počítačov, čo je celkom fajn.
Zostáva vykonať merania rýchlosti extrakcie (náhodných) dát a zhodnotiť škálovanie pri výbere dávok rôznej veľkosti:
Benchmarks databázy
library(ggplot2)

set.seed(0)
# Pripojenie k databáze
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funkcia na prípravu dotazu na straně servera
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funkcia na získavanie údajov
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Vykonanie merania
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametre benchmarku
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("medián čas, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 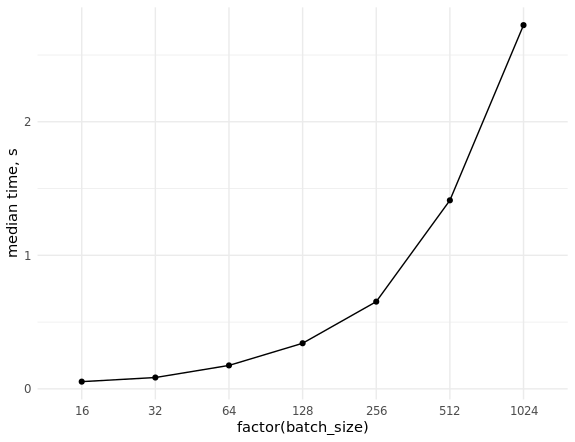
2. Príprava batčov
Celý proces prípravy batčov pozostáva z nasledujúcich fáz:
- Parsovanie viacerých JSON-ov, ktoré obsahujú vektory reťazcov s koordinátmi bodov.
- Nakreslenie farebných čiar podľa súradníc bodov na obrázku potrebnej veľkosti (napríklad 256×256 alebo 128×128).
- Transformácia získaných obrázkov na tenzor.
V rámci súťaže medzi kernelmi na Pythone sa úloha riešila prevažne prostriedkami OpenCV. Jeden z najjednoduchších a najjasnejších ekvivalentov v R by vyzeral nasledovne:
Realizácia transformácie JSON na tenzor v R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsovanie JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Odstránenie dočasného súboru po ukončení funkcie
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Prázdny graf
  plot.new()
  # Veľkosť okna grafu
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Farby čiar
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Premena obrázka na 3D pole
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Spojenie 3D polí obrázkov do 4D tenzora
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Kreslenie prebieha štandardnými prostriedkami R s uložením do dočasného PNG, ktoré sa uchováva v RAM (v systéme Linux sú dočasné adresáre R umiestnené v priečinku /tmp, pripojenom v RAM). Následne je tento súbor načítaný ako trojrozmerné pole s číslami v rozsahu od 0 do 1. To je dôležité, pretože bežnejší BMP by bol prečítaný ako surové pole s hex kódmi farieb.
Otestujme výsledok:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 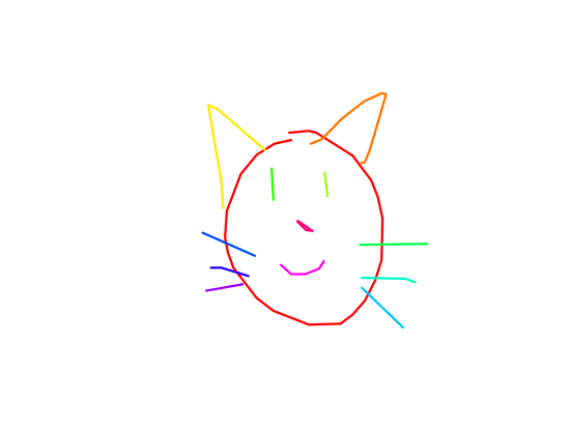
Samotný batch bude vytváraný nasledujúcim spôsobom:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Toto spracovanie sa nám zdalo neoptimálne, pretože vytváranie veľkých batchov trvá neprimerane veľa času, a tak sme sa rozhodli využiť skúsenosti kolegov a zapojiť mocnú knižnicu OpenCV. V tom čase neexistoval hotový balík pre R (ani teraz nie), takže bola napísaná minimálna implementácia požadovanej funkčnosti v C++ s integráciou do kódu v R pomocou Rcpp.
Na riešenie úlohy boli použité nasledujúce balíky a knižnice:
OpenCV na prácu s obrázkami a kreslenie čiar. Použili sme predtým nainštalované systémové knižnice a hlavičkové súbory, ako aj dynamické linkovanie.
xtensor pre prácu s viacerými rozmerovými poliami a tenzormi. Používali sme hlavičkové súbory zahrnuté v rovnomennom R balíku. Knižnica umožňuje prácu s viacerými rozmerovými poliami, a to ako v poradí row major, tak aj v column major.
ndjson na parsovanie JSON. Táto knižnica sa používa v xtensor automaticky pri jej prítomnosti v projekte.
RcppThread na organizáciu viacvláknového spracovania vektora z JSON. Používali sme hlavičkové súbory poskytované týmto balíkom. Od obľúbenejšieho RcppParallel balík okrem iného vyniká vstavaným mechanizmom prerušenia cyklu (interrupt).
Stojí za zmienku, že xtensor sa ukázal ako skutočný nález: okrem toho, že má rozsiahlu funkcionalitu a vysoký výkon, vývojári boli veľmi ochotní a promptne a podrobne odpovedali na vznikajúce otázky. S ich pomocou sa podarilo realizovať transformácie matíc OpenCV na tenzory xtensor, ako aj spôsob zlúčenia 3D tenzorov obrázkov do 4D tenzora správnej veľkosti (vlastne batch).
Materiály pre štúdium Rcpp, xtensor a RcppThread
Na kompiláciu súborov, ktoré používajú systémové súbory a dynamické prepojenie s nainštalovanými knižnicami v systéme, sme využili mechanizmus pluginov, implementovaný v balíku Rcpp. Na automatické nájdenie ciest a vlajok sme použili populárnu linuxovú utilitu pkg-config.
Implementácia Rcpp pluginu na použitie knižnice OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Možné názvy balíka
  pkg_config_name <- c("opencv", "opencv4")
  # Binárny súbor utility pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Kontrola prítomnosti utility v systéme
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Kontrola prítomnosti konfiguračného súboru OpenCV pre pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config pre pkg-config nebol nájdený", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
V dôsledku práce pluginu budú počas kompilácie zadané nasledujúce hodnoty:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Kód na implementáciu parsenia JSON a formovania dávky pre odovzdanie do modelu je uvedený pod spoljrom. Predtým pridajte lokálny adresár projektu na vyhľadávanie hlavičkových súborov (potrebné pre ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementácia prevodu JSON na tenzor v C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Tento kód je potrebné umiestniť do súboru src/cv_xt.cpp a skompilovať príkazom Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); na prácu bude potrebné nlohmann/json.hpp z . Kód je rozdelený na niekoľko funkcií:
to_xt— šablónová funkcia na prevod matice obrázku (cv::Mat) na tenzorxt::xtensor;parse_json— funkcia parsel JSON reťazec, extrahuje súradnice bodov, balí ich do vektora;ocv_draw_lines— z vektora bodov vykresľuje viacfarebné čiary;process— kombinuje vyššie uvedené funkcie a pridáva možnosť škálovania získaného obrázka;cpp_process_json_str— obálka nad funkciouprocess, ktorá exportuje výsledok do R objektu (viacdimenzionálny pole);cpp_process_json_vector— obálka nad funkcioucpp_process_json_str, ktorá umožňuje spracovať reťazec vektora v multithreadovom režime.
Na vykreslenie viacfarebných čiar sa používal farebný model HSV s následnou konverziou na RGB. Otestujme výsledok:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 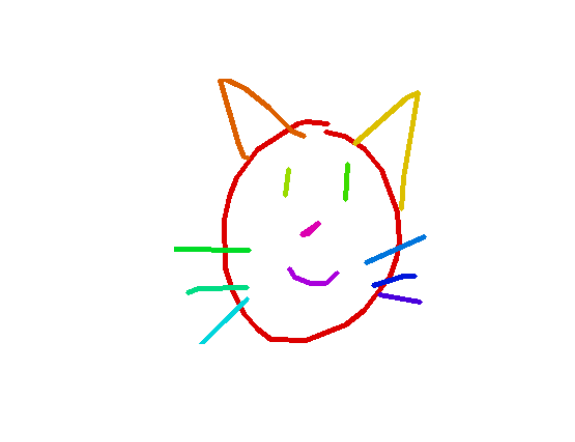
Porovnanie rýchlosti práce implementácií na R a C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parametre benchmarku
cols <- c("expression", "min", "median", "max", "itr/sek", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sek` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Meranie vykonania
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sek` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>        <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("medziansky čas, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "spodok") 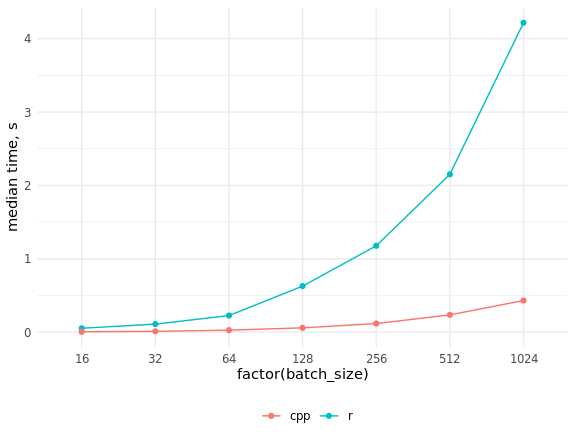
Ako vidíme, nárast rýchlosti bol veľmi významný a nie je možné dohnať kód v C++ pomocou paralelizácie kódu v R.
3. Iterátory na vyžarovanie dávok z DB
R má zaslouženou pověst jako jazyk pro zpracování dat umístěných v RAM, zatímco Python je charakterizován iterativním zpracováním dat, což umožňuje snadno a bezproblémově realizovat výpočty s externí pamětí. Příkladem takových výpočtů, které jsou klasické a aktuální v kontextu popisovaného úkolu, jsou hluboké neuronové sítě trénované metodou gradientního spádu s aproximací gradientu v každém kroku na malém vzorku pozorování, nebo mini-batche.
Rámce pro hluboké učení napsané v Pythonu mají speciální třídy implementující iterátory pro data: tabulky, obrázky ve složkách, binární formáty atd. Můžete použít hotové varianty nebo napsat vlastní pro specifické úkoly. V R můžeme využít všechny možnosti pythonní knihovny keras s jeho různými backendy pomocí stejnojmenného balíčku, který pracuje na vrchu balíčku reticulate. Ten si zaslouží samostatný a obsáhlý článek; nejenže umožňuje spouštět kód na Pythonu z R, ale také zajišťuje přenos objektů mezi R a Python sezeními, automaticky provádějící všechny potřebné konverze typů.
Od potřeby uchovávat všechna data v RAM jsme se zbavili díky použití MonetDBLite, veškerou "neuronovou" práci bude provádět originální kód v Pythonu, nám zbývá pouze napsat iterátor pro data, protože hotový pro takovou situaci není ani v R, ani v Pythonu. Požadavky na něj jsou v podstatě dva: musí vracet batche v nekonečné smyčce a uchovávat svůj stav mezi iteracemi (poslední v R se jednoduše realizuje pomocí uzávěrů). Dříve bylo nutné uvnitř iterátoru explicitně převádět pole R na numpy pole, ale aktuální verze balíčku keras to dělá sama.
Iterátor pro tréninková a validační data vypadá následovně:
Iterátor pro tréninková a validační data
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funkce přijímá jako vstupní proměnnou spojení s databází, čísla používaných řádků, počet tříd, velikost batch, škálu (scale = 1 odpovídá kreslení obrázků 256x256 pixelů, scale = 0.5 — 128x128 pixelů), indikátor barevnosti (color = FALSE nastavuje kreslení v odstínech šedi, při použití color = TRUE Každý ťah sa vykresľuje novou farbou) a indikátor predspracovania pre siete, ktoré boli predtrénované na imagenete. Ten je potrebný na škálovanie hodnôt pixelov z intervalu [0, 1] na interval [-1, 1], ktorý bol použitý pri tréningu dodávaných modelov. keras modelov.
Externá funkcia obsahuje kontrolu typov argumentov, tabuľku data.table s náhodne premiešanými číslami riadkov z samples_index a číslami dávok, čítačom a maximálnym počtom dávok, ako aj SQL výraz pre export údajov z databázy. Okrem toho sme definovali rýchlu alternatívu funkcie keras::to_categorical(). Pre tréning sme použili takmer všetky dáta, nechajúc pol percenta na validáciu, takže veľkosť epochy bola obmedzená parametrom steps_per_epoch pri volaní keras::fit_generator(), a podmienka if (i > max_i) sa spúšťala iba pre validačný iterátor.
Vo vnútornej funkcii sa vykonáva výber indexov riadkov pre ďalšiu dávku, export záznamov z databázy so zvyšovaním čítača dávok, parsovanie JSON-ov (funkcia cpp_process_json_vector(), napísaná v C++) a vytvorenie polí, ktoré zodpovedajú obrázkom. Následne sa vytvárajú one-hot vektory s označením tried, polia s hodnotami pixelov a s označením sa spoja do zoznamu, ktorý je výslednou hodnotou. Pre urýchlenie práce sa používalo vytváranie indexov v tabuľkách data.table a modifikácia odkazom — bez týchto „trikov“ balíka data.table je dosť ťažké predstaviť si efektívnu prácu so značnými objemami údajov v R.
Výsledky merania rýchlosti práce na prenosnom Core i5 vyzerajú nasledovne:
Benchmark iterátora
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indexes for training set
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indexes for validation set
val_ind <- ind[-train_ind]
rm(ind)
# Scale factor
scale <- 0.5

# Benchmarking
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 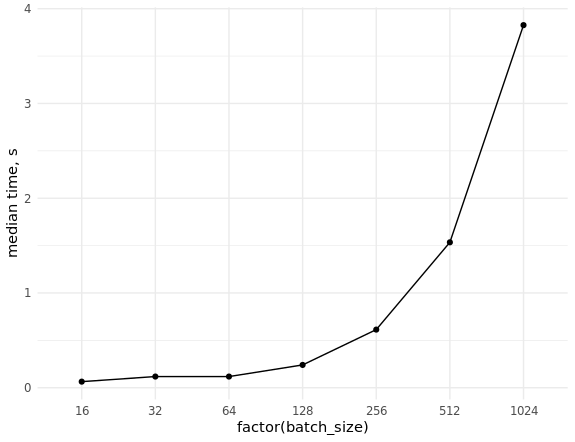
Ak máte dostatočný objem RAM, môžete výrazne urýchliť prácu databázy presunom do RAM (pre našu úlohu stačí 32 GB). Na Linuxe sa predvolene montuje oddiel /dev/shm, ktorý zaberá až polovicu objemu RAM. Môžete vyhradiť aj viac, upravením /etc/fstab, aby vznikol záznam vo forme tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Povinne reštartujeme a kontrolujeme výsledok vykonaním príkazu df -h.
Iterátor pre testovacie dáta vyzerá oveľa jednoduchšie, keďže celý testovací dataset sa zmestí do RAM:
Iterátor pre testovacie dáta
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Výber architektúry modelu
Prvou z použitých architektúr bola , ktorej špecifiká sú prebrané v správe. Je súčasťou štandardnej dodávky keras a je dostupná v rovnomennom balíku pre R. No pri pokuse o jej použitie s jednovrstvovými obrázkami sa ukázalo čudné: vstupný tenzor musí mať vždy rozmernosť (batch, height, width, 3), t.j. počet kanálov nemožno zmeniť. V Pythone nie sú také obmedzenia, takže sme sa ponáhľali a napísali svoju implementáciu tejto architektúry, riadiac sa pôvodným článkom (bez dropoutu, ktorý je v variante keras):
Architektúra mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Nevýhody tohto prístupu sú zrejmé. Chceme otestovať veľa modelov, a preto sa nám nechce prepisovať každú architektúru ručne. Taktiež sme boli zbavení možnosti použiť váhy modelov, ktoré boli predtým trénované na imagenete. Ako obvykle, pomohlo nám štúdium dokumentácie. Funkcia get_config() umožňuje získať popis modelu v editačnej forme (base_model_conf$layers — bežný R-ovský zoznam), a funkcia from_config() vykonáva spätné prevedenie na modelový objekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Teraz nie je problém napísať univerzálnu funkciu na získanie akejkoľvek z modelov dodávaných v súprave keras modelov s predtrénovanými váhami na imagenet-e alebo bez nich:
Funkcia na načítanie pripravených architektúr
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Kontrola argumentov
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Získanie objektu z balíčka keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Kontrola prítomnosti objektu v balíčku
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " nenájdený.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Ak obrázok nie je farebný, zmeníme rozmernosť vstupu
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Pri používaní jednofarebných obrázkov sa nepoužívajú predtrénované váhy. To by sa dalo opraviť: pomocou funkcie get_weights() získať váhy modelu vo forme zoznamu R-ovských polí, zmeniť rozmernosť prvého prvku tohto zoznamu (zobrať niektorý farebný kanál alebo priemer všetkých troch), a potom načítať váhy späť do modelu funkciou set_weights(). Tento funkčný prvok sme však nepridali, pretože v tom čase už bolo jasné, že je efektívnejšie pracovať s farebnými obrázkami.
Hlavná časť experimentov bola vykonaná pomocou verzií mobilenet 1 a 2, ako aj resnet34. V tejto súťaži sa osvedčili modernejšie architektúry, ako je SE-ResNeXt. Bohužiaľ, nemali sme k dispozícii hotové implementácie a svoje vlastné sme nenapísali (ale určite ich napíšeme).
5. Parametrizácia skriptov
Pre pohodlie bol celý kód na spustenie učenia upravený do podoby jediného skriptu, ktorý je parametrizovaný pomocou nasledovne:
doc <- '
Použitie:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Možnosti:
  -h --help                   Zobraziť túto správu.
  -l --list-models            Zoznam dostupných modelov.
  -m --model=          Názov modelu neurónovej siete [predvolené: mobilenet_v2].
  -b --batch-size=      Veľkosť dávky [predvolené: 32].
  -s --scale-factor=   Množiteľ mierky [predvolené: 0.5].
  -c --color                  Použiť farebné línie [predvolené: FALSE].
  -d --db-dir=          Cesta k databáze [predvolené: Sys.getenv("db_dir")].
  -r --validate-ratio= Množiteľ vzorky na validáciu [predvolené: 0.995].
  -n --n-gpu=         Počet GPU [predvolené: 1].
'
args <- docopt::docopt(doc)
Balík docopt predstavuje implementáciu pre R. S jeho pomocou sa skripty spúšťajú jednoduchými príkazmi vo forme Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db alebo ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, ak je súbor train_nn.R spustiteľný (tento príkaz spustí učenie modelu resnet50 na trojfarebných obrázkoch o rozmere 128x128 pixelov, databáza by mala byť umiestnená v priečinku /home/andrey/doodle_db). Do zoznamu je možné pridať rýchlosť učenia, typ optimizátora a akékoľvek ďalšie nastaviteľné parametre. Počas prípravy publikácie sa zistilo, že architektúru mobilenet_v2 z aktuálnej verzie keras v R použiť kvôli nezohľadneným zmenám v R balíku — čakáme, kým to opraví.
Tento prístup umožnil značne urýchliť experimenty s rôznymi modelmi v porovnaní s tradičným spúšťaním skriptov v RStudio (ako možnú alternatívu spomíname balík ). Ale hlavná výhoda spočíva v možnosti ľahko spravovať spúšťanie skriptov v dockeri alebo jednoducho na serveri, bez nutnosti inštalovať RStudio.
6. Dockerizácia skriptov
Použili sme docker na zabezpečenie prenosnosti prostredia pre učenie modelov medzi členmi tímu a na rýchle nasadenie v cloude. Začnite spoznávať tento relatívne nezvyčajný nástroj pre R programátorov s rôznymi publikáciami alebo s .
Docker umožňuje vytvořit vlastní obrazy „od nuly“ nebo použít jiné obrazy jako základ pro jejich vytvoření. Při analýze dostupných možností jsme dospěli k závěru, že instalace ovladačů NVIDIA, CUDA+cuDNN a pythonových knihoven je poměrně obsáhlou částí obrazu, a rozhodli jsme se vzít jako základ oficiální obraz tensorflow/tensorflow:1.12.0-gpu, přidáním potřebných balíčků R.
Konečný dockerfile vypadá takto:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Pro usnadnění byly používané balíčky vyčleněny do proměnných; většina napsaných skriptů se při sestavování kopíruje do kontejnerů. Také jsme změnili příkazovou šelmu na /bin/bash pro usnadnění používání obsahu /etc/os-release. To umožnilo vyhnout se nutnosti uvádět verzi OS v kódu.
Dále byl napsán malý bash skript, který umožňuje spouštět kontejner s různými příkazy. Například to mohou být skripty pro trénink neuronových sítí, které byly dříve umístěny do kontejneru, nebo příkazová šelma pro ladění a monitorování práce kontejneru:
Skript pro spuštění kontejneru
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Ak sa tento bash skript spustí bez parametrov, vo vnútri kontajnera sa spustí skript train_nn.R s predvolené hodnoty; ak je prvým pozičným argumentom „bash“, kontajner sa spustí v interaktívnom režime s príkazovým shellom. Vo všetkých ostatných prípadoch sa vykoná substitúcia hodnôt pozičných argumentov: CMD="Rscript /app/train_nn.R $@".
Je potrebné si všimnúť, že adresáre s pôvodnými údajmi a databázou, ako aj adresár na uloženie naučených modelov, sú namontované do kontajnera z hostiteľského systému, čo umožňuje prístup k výsledkom práce skriptov bez zbytočných manipulácií.
7. Použitie viacerých GPU v cloude Google Cloud
Jednou z vlastností súťaže boli veľmi hlučné údaje (pozri úvodný obrázok, prevzatý od @Leigh.plt z ODS Slacku). Bojovať s tým pomáhajú batche veľkej veľkosti, a po experimentoch na PC s 1 GPU sme sa rozhodli zvládnuť učenie modelov na viacerých GPU v cloude. Použili sme GoogleCloud () kvôli veľkému výberu dostupných konfigurácií, prijateľným cenám a bonusu $300. Z chamtivosti bol objednaný inštanc s 4xV100 s SSD a množstvom RAM, a to bola veľká chyba. Peniaze taký stroj rýchlo spotrebuje, na experimentoch bez vykladeného pipeline sa môžete zruinovať. Na vzdelávacie účely je lepšie zobrať K80. A veľké množstvo RAM sa hodilo — cloudový SSD ma neohromil rýchlosťou, takže databázu sme pri každom spustení inštancie presúvali na dev/shm.
Najväčší záujem predstavuje fragment kódu, ktorý zodpovedá za použitie viacerých GPU. Najprv sa model vytvorí na CPU s použitím manažéra kontextu, presne ako v Pythone:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Následne sa nekompilovaný (to je dôležité) model skopíruje na zadaný počet dostupných GPU, a až potom sa skompiluje:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Klasický postup s mrazením všetkých vrstiev okrem poslednej, učením poslednej vrstvy, rozmrazením a opätovným učením modelu celkom pre niekoľko GPU sa nepodarilo realizovať.
Na učenie sme dohliadali bez použitia tensorboard, obmedziac sa na zapisovanie protokolov a ukladanie modelov s informatívnymi názvami po každej epoše:
Kallbacky
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Namiesto záveru
Rada problémov, s ktorými sme sa stretli, sa nám zatiaľ nepodarilo prekonať:
- v keras neexistuje hotová funkcia na automatické hľadanie optimálnej rýchlosti učenia (analog
lr_finderv knižnici fast.ai); so znalosťou niektorých techník je možné portovať alternatívne implementácie na R, napríklad, ; - ako dôsledok predchádzajúceho bodu sa nepodarilo nastaviť správnu rýchlosť učenia pri použití viacerých GPU;
- chýbajú moderné architektúry neurónových sietí, najmä predtrénované na imagenet-e;
- neexistuje one cycle policy a diskriminačné rýchlosti učenia (cosine annealing na našu žiadosť bol , ďakujem ).
Čo užitočné sa podarilo z tohto súťaženia vyťažiť:
- Na relatívne slabom hardvéri je možné bez problémov pracovať s primeranými (mnohými prevyšujúcimi veľkosť RAM) objemami dát. Balík data.table šetří pamäť pomocou in-place modifikácie tabuliek, čo umožňuje vyhnúť sa ich kopírovaniu, a pri správnom využití jeho možností prakticky vždy demonštruje najväčšiu rýchlosť medzi všetkými známych nástrojov pre skriptovacie jazyky. Uloženie dát do DB umožňuje v mnohých prípadoch vôbec nemyslieť na potrebu natlačiť celý dataset do RAM.
- Pomalé funkcie na R môžeme nahradiť rýchlymi na C++ pomocou balíka Rcpp. Ak navyše použijeme RcppThread alebo RcppParallel, dostaneme multiplatformové viacvláknové implementácie, takže kód na úrovni R nie je potrebné paralelizovať.
- Balík Rcpp môžete používať bez hlbokých znalostí C++, potrebné minimum je vystavené . Hlavičkové súbory pre množstvo skvelých C knižníc sú dostupné na CRAN, teda sa formuje infraštruktúra pre realizáciu projektov, ktoré integrujú do R hotový vysoko výkonný kód na C++. Ďalšie pohodlie — syntax highlighting a statický analyzátor kódu na C++ v RStudio. xtensor umožňuje spúšťať samostatné skripty s parametrami. To je užitočné na využitie na vzdialenom serveri, vrátane pod dockerom. V RStudio je nepraktické vykonávať hodinové experimenty s učením neurónových sietí, a inštalácia IDE na serveri nie je vždy opodstatnená.
- docopt umožňuje spúšťať samostatné skripty s parametrami. To je pohodlné pre použitie na vzdialenom serveri, vrátane pod dockerom. V RStudio je nepraktické vykonávať hodinové experimenty s učením neurónových sietí, a samotná inštalácia IDE na serveri nie je vždy ospravedlniteľná.
- Docker zaisťuje prenosnosť kódu a reprodukovateľnosť výsledkov medzi vývojármi s rôznymi verzami OS a knižníc, ako aj jednoduchú spúšťanie na serveroch. Celý pipeline na učenie je možné spustiť jedným príkazom.
- Google Cloud je cenovo výhodný spôsob, ako experimentovať na drahom hardvéri, avšak je potrebné starostlivo vyberať konfigurácie.
- Meranie rýchlosti práce jednotlivých fragmentov kódu je veľmi užitočné, najmä pri kombinácii R a C++, a s balíkom bench — je to navyše veľmi jednoduché.
Celkovo bola táto skúsenosť veľmi užitočná a naďalej pracujeme na riešení niektorých z uvedených problémov.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish