

Pokračujeme v zoznamovaní vás s hyperkonvergovaným systémom Cisco HyperFlex.
V apríli 2019 spoločnosť Cisco opäť organizuje sériu demonštrácií nového hyperkonvergovaného riešenia Cisco HyperFlex v regiónoch Ruska a Kazachstanu. Na demonštráciu sa môžete prihlásiť prostredníctvom formulára spätnej väzby, prejdite na odkaz. Pripojte sa!
Predtým sme publikovali článok o záťažových testoch, ktoré vykonala nezávislá laboratória ESG Lab v roku 2017. V roku 2018 sa výkonnostné charakteristiky riešenia Cisco HyperFlex (verzia HX 3.0) významne zlepšili. Okrem toho aj konkurenčné riešenia sa naďalej vylepšujú. Preto publikujeme novú, aktuálnejšiu verziu porovnávacích záťažových testov od ESG.
V lete 2018 laboratórium ESG vykonalo opätovné porovnanie Cisco HyperFlex s konkurentmi. Vzhľadom na súčasný trend v používaní softvérovo definovaných riešení boli do porovnávacej analýzy zahrnutí aj výrobcovia podobných platforiem.
Testovacie konfigurácie
V rámci testovania bol HyperFlex porovnávaný s dvoma plne softvérovými hyperkonvergovanými systémami, ktoré sú inštalované na štandardných x86 serveroch, ako aj s jedným softvérovo-hardwareovým riešením. Testovanie prebiehalo s využitím štandardného softvéru pre hyperkonvergované systémy – HCIBench, ktorý využíva nástroj Oracle Vdbench a automatizuje proces testovania. V частности, HCIBench automaticky vytvára virtuálne stroje, koordinuje záťaž medzi nimi a generuje prehľadné a jasné správy.
Na klaster bolo vytvorených 140 virtuálnych strojov (35 na uzol clustra). Každý virtuálny stroj používal 4 vCPU a 4 GB RAM. Lokálny disk VM bol 16 GB a dodatočný disk 40 GB.
V testovaní sa zúčastnili nasledujúce konfigurácie klastrov:
- klaster zo štyroch uzlov Cisco HyperFlex 220C 1 x 400 GB SSD pre cache a 6 x 1,2 TB SAS HDD pre dáta;
- klaster konkurenta Dodávateľa A zo štyroch uzlov 2 x 400 GB SSD pre cache a 4 x 1 TB SATA HDD pre dáta;
- klaster konkurenta Dodávateľa B zo štyroch uzlov 2 x 400 GB SSD pre cache a 12 x 1,2 TB SAS HDD pre dáta;
- klaster konkurenta Dodávateľa C zo štyroch uzlov 4 x 480 GB SSD pre cache a 12 x 900 GB SAS HDD pre dáta.
Procesory a operačná pamäť všetkých riešení boli identické.
Test na počet virtuálnych strojov
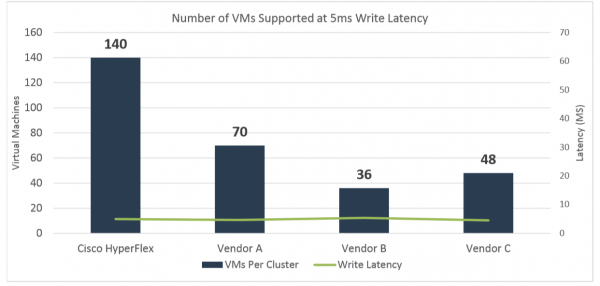
Testovanie začalo s pracovnou záťažou navrhnutou na emuláciu štandardného OLTP testu: čítanie/zápis (RW) 70%/30%, 100% FullRandom s cieľovou hodnotou 800 IOPS na jeden virtuálny stroj (VM). Test sa uskutočnil na 140 VM v každom klastri po dobu troch až štyroch hodín. Cieľom testu bolo udržať latenciu pri zápise na maximálnom počte VM na úrovni 5 milisekúnd alebo menej.
Výsledkom testu (pozri graf nižšie) sa HyperFlex ukázal ako jediná platforma, ktorá dokončila tento test s počiatočnými 140 VM a latenciami pod 5 ms (4,95 ms). Pre každú z ostatných klastrov bol test znova spustený, aby sa empiricky v niekoľkých iteráciách prispôsobilo počet VM na cieľovú latenciu 5 ms.
Vendor A sa úspešne vysporiadal so 70 VM so strednou dobou odozvy 4,65 ms.
Vendor B zabezpečil požadované latencie 5,37 ms iba so 36 VM.
Vendor C dokázal udržať 48 virtuálnych strojov so časom odozvy 5,02 ms.
Emulácia záťaže SQL Servera
ESG Lab následne emuloval záťaž SQL Servera. V teste sa používali rôzne veľkosti blokov a pomery čítania/zápisu. Test bol taktiež spustený na 140 virtuálnych strojoch.
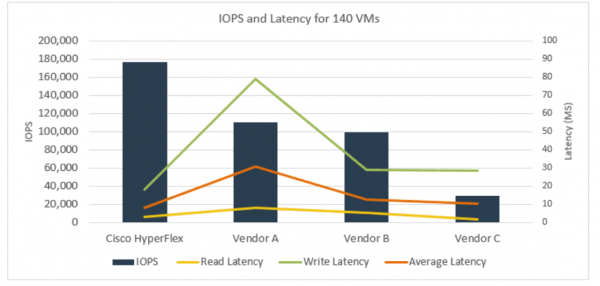
Ako je znázornené na obrázku nižšie, klaster Cisco HyperFlex takmer zdvojnásobil IOPS v porovnaní s vendorom A a B, a s vendorom C viac ako päťkrát. Priemerná doba odozvy Cisco HyperFlex bola 8,2 ms. Pre porovnanie, priemerná doba odozvy vendora A bola 30,6 ms, vendora B — 12,8 ms, a vendora C — 10,33 ms.
Zaujímavé pozorovanie bolo učinené počas všetkých testov. Vendor B ukázal významný rozptyl priemernej výkonnosti v IOPS na rôznych VM. Teda záťaž sa rozdeľovala mimoriadne nerovnomerne, niektoré VM pracovali so strednou hodnotou 1000 IOPS+, zatiaľ čo niektoré so 64 IOPS. Cisco HyperFlex v tomto prípade vyzeral oveľa stabilnejšie, všetkých 140 VM získavalo v priemere 600 IOPS od subsystému ukladania dát, teda záťaž medzi virtuálnymi strojmi bola rozdelená veľmi rovnomerne.
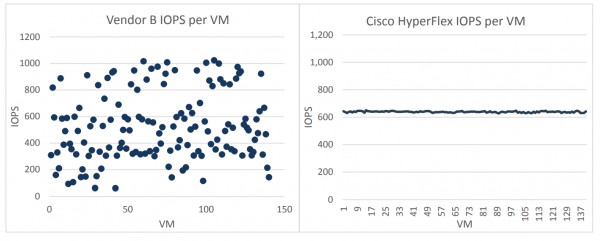
Je dôležité poznamenať, že také nerovnomerné rozdelenie IOPS medzi virtuálnymi strojmi u vendora B sa pozorovalo v každej iterácii testovania.
V reálnom produkčnom prostredí môže byť takéto správanie systému veľkým problémom pre administrátorov, pretože jednotlivé virtuálne stroje náhodne začínajú „zamŕzať“ a prakticky neexistuje žiadny spôsob, ako tento proces kontrolovať. Jediným, nie veľmi efektívnym spôsobom vyvažovania zaťaženia pri použití riešenia od dodávateľa B, je nasadenie určitej implementácie QoS alebo vyváženia zaťaženia.
Záver
Zamyslime sa nad tým, čo znamená 140 virtuálnych strojov v Cisco Hyperflex na 1 fyzický uzol v porovnaní so 70 alebo menej v iných riešeniach? Pre podnik to znamená, že na udržanie rovnakého počtu aplikácií na Hyperflex potrebujeme dvakrát menej uzlov ako pri konkurentoch, t.j. konečný systém bude výrazne lacnejší. Ak k tomu pridáme aj úroveň automatizácie všetkých operácií správy siete, serverov a platformy skladovania HX Data Platform, je jasné, prečo riešenia Cisco Hyperflex tak rýchlo získavajú popularitu na trhu.
Celkovo laboratórium ESG potvrdilo, že hybridné verzie Cisco HyperFlex 3.0 poskytujú vyšší a stabilnejší výkon ako iné podobné riešenia.
Hybridné clustre HyperFlex navyše prekonávali konkurentov v parametroch IOPS a latencie. Rovnako dôležité je, že výkon HyperFlex bol zabezpečený pri veľmi dobrej distribúcii zaťaženia na celom úložisku.
Pripomíname, že riešenie Cisco Hyperflex si môžete pozrieť a presvedčiť sa o jeho možnostiach už teraz. Systém je dostupný na predvedenie všetkým záujemcom:
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish