

Oznámenie
Kolíga, v polovici leta plánujem uverejniť ďalší cyklus článkov o navrhovaní systémov hromadného obsluhovania: “Experiment VTrade” — pokus o vytvorenie rámca pre obchodné systémy. V cykle sa bude rozoberať teória a prax budovania burzy, aukcie a obchodu. Na konci článku navrhujem hlasovať za témy, ktoré sú vám najzaujímavejšie.
Toto je záverečný článok cyklu o distribuovaných reaktívnych aplikáciách na Erlang/Elixir. V možno nájsť teoretické základy reaktívnej architektúry. ilustruje základné vzory a mechanizmy budovania podobných systémov.
Dnes sa zameriame na otázky rozvoja kódovej základne a projektov ako celku.
Organizácia služieb
V reálnom živote pri vývoji služby často musíme kombinovať niekoľko vzorov interakcie v jednom controllere. Napríklad služba users, ktorá rieši úlohy správy profilov používateľov projektu, musí reagovať na požiadavky req-resp a informovať o aktualizáciách profilov cez pub-sub. Tento prípad je pomerne jednoduchý: za messagingom stojí jeden controller, ktorý implementuje logiku služby a publikuje aktualizácie.
Situácia sa komplikuje, keď potrebujeme implementovať odolnú distribuovanú službu. Predstavme si, že požiadavky na users sa zmenili:
- teraz musí služba spracovávať požiadavky na 5 uzloch klastera,
- mať možnosť vykonávať pozadové úlohy spracovania,
- a taktiež musí byť schopná dynamicky spravovať zoznamy predplatného na aktualizácie profilov.
Poznámka: Otázku konzistentného ukladania a replikácie údajov neberieme do úvahy. Predpokladajme, že tieto otázky boli riešené skôr a v systéme už existuje spoľahlivá a škálovateľná vrstva ukladania, a spracovatelia majú mechanizmy interakcie s ňou.
Formálne opísanie služby users sa skomplikovalo. Z pohľadu programátora, vďaka používaniu messagingu, sa zmeny minimálne. Aby sme splnili prvú požiadavku, musíme nastaviť vyrovnávanie za bodom výmeny req-resp.
Požiadavka na spracovanie pozadí úloh sa často vyskytuje. V používateľoch to môžu byť overovania dokumentov, spracovanie nahratého multimédia alebo synchronizácia údajov so sociálnymi sieťami. Tieto úlohy je potrebné nejakým spôsobom distribuovať v rámci klastra a sledovať priebeh vykonávania. Preto máme dve možnosti: buď použiť šablónu rozdelenia úloh z predchádzajúceho článku, alebo, ak to nevyhovuje, napísať vlastný plánovač úloh, ktorý bude riadiť skupinu spracovateľov podľa našich potrieb.
Bod 3 vyžaduje rozšírenie šablóny pub-sub. A na realizáciu, po vytvorení výmenného bodu pub-sub, musíme dodatočne spustiť ovládač tohto bodu v rámci našej služby. Týmto spôsobom akoby presúvame logiku spracovania prihlásenia a odhlásenia zo layer messaging do implementácie používateľov.
Výsledkom dekompozície úlohy sa ukázalo, že na splnenie požiadaviek potrebujeme spustiť na rôznych uzloch 5 inštancií služby a vytvoriť dodatočnú entitu – ovládač pub-sub, ktorý je zodpovedný za prihlásenie.
Na spustenie 5 spracovateľov nie je potrebné meniť kód služby. Jediným dodatočným krokom je nastavenie pravidiel vyvažovania na výmennom mieste, o čom si povieme o chvíľu.
Objavila sa aj dodatočná zložitost: ovládač pub-sub a vlastný plánovač úloh musia fungovať v jedinom inštanci. Opäť, služba messaging, ako základná, musí poskytnúť mechanizmus na výber lídra.
Výber lídra
Vo distribuovaných systémoch je výber lídra procedúra menovania jedinečného procesu, ktorý je zodpovedný za plánovanie distribuovaného spracovania určitého zaťaženia.
V systémoch, ktoré nie sú náchylné na centralizáciu, sa aplikujú univerzálne algoritmy a algoritmy založené na konsenze, ako napríklad paxos alebo raft.
Keďže messaging je broker a centrálny prvok, pozná všetkých ovládačov služby – kandidátov na lídrov. Messaging môže určovať lídra bez hlasovania.
Všetky služby po štarte a pripojení k výmennému bodu dostanú systémovú správu #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. V prípade, že LeaderPid sa zhoduje s pid aktuálneho procesu, je určený za lídra a zoznam Servers zahŕňa všetky uzly a ich parametre.
Pri vytváraní nového a vypínaní fungujúceho uzla klastra všetci kontroléry služby dostávajú #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} a #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} prípadne.
Takže všetky komponenty s určitosťou vedia o všetkých zmenách a v klastri je v každom okamihu zabezpečený jeden líder.
Proxy
Na implementáciu zložitých distribuovaných procesov spracovania, ako aj na optimalizáciu už existujúcej architektúry je pohodlné používať proxy.
Aby sme nemuseli meniť kód služieb a riešiť napríklad úlohy dodatočného spracovania, smerovania alebo logovania správ, môžeme pred službou vložiť proxy spracovateľa, ktorý vykoná všetku dodatočnú prácu.
Klasickým príkladom optimalizácie pub-sub je distribuovaná aplikácia s obchodným jadrom, ktoré generuje udalosti aktualizácií, napríklad zmeny cien na trhu, a prístupová vrstva — N serverov poskytujúcich websocket API pre webových klientov.
Ak sa rozhodneme „udrieť na to priamo“, obsluha klienta vyzerá nasledovne:
- klient vytvára spojenie s platformou. Na strane servera, ktorý ukončuje prichádzajúcu prevádzku, sa spúšťa proces, ktorý obsluhuje toto pripojenie.
- v kontexte obsluhujúceho procesu prebieha autorizácia a prihlásenie sa na aktualizácie. Proces volá metódu subscribe pre témy.
- po generovaní udalosti v jadre sa doručí procesom, ktoré obsluhujú pripojenia.
Predstavme si, že máme 50000 prihlásených na tému "novinky". Prihlásení sú rovnomerne rozdelení medzi 5 serverov. Nakoniec každá aktualizácia, ktorá príde na výmenný bod, bude replikovaná 50000-krát: 10000-krát na každý server, podľa počtu prihlásených na ňom. Nie je to práve efektívne, že?
Aby sme zlepšili situáciu, zavedieme proxy, ktorá má rovnaké meno ako výmenný bod. Registrátor globálnych mien by mal byť schopný vrátiť najbližší proces podľa mena, to je dôležité.
Spustíme túto proxy na serveroch prístupovej vrstvy a všetky naše procesy obsluhujúce websocket API sa prihlásia na ňu, nie na pôvodný pub-sub výmenný bod v jadre. Proxy sa prihlasuje na jadro iba v prípade jedinečnej registrácie a replikovaná dostatá správa medzi všetkých svojich prihlásených.
Nakoniec bude medzi jadrom a prístupovými servermi prenesených 5 správ, namiesto 50000.
Smerovanie a vyvažovanie
Req-Resp
V aktuálnom spracovaní messaging existuje 7 stratégií na distribúciu požiadaviek:
default. Dotaz se předává všem kontrolérům.round-robin. Provedení cyklického rozdělení dotazů mezi kontroléry.consensus. Kontroléry, které spravují službu, se dělí na vůdce a podřízené. Dotazy se předávají pouze vůdci.consensus & round-robin. Ve skupině je vůdce, ale dotazy se rozdělují mezi všechny členy.sticky. Vypočítá se hash funkce a připojí se k určitému zpracovateli. Následující dotazy se stejnou signaturou přijdou k tomuto zpracovateli.sticky-fun. Při inicializaci výměnného bodu se ještě předává funkce pro výpočet hash prostickyvyvažování.zábava. Podobně jako sticky-fun, ale navíc je možné ho přesměrovat, odmítnout nebo předzpracovat.
Strategie rozdělení se nastavuje při inicializaci výměnného bodu.
Kromě vyvažování messaging umožňuje tagování entit. Podívejme se na typy tagů v systému:
- Tag připojení. Umožňuje pochopit, přes jaké připojení přišly události. Používá se, když se proces kontroléru připojuje k jednomu výměnnému bodu, ale s různými klíči směrování.
- Tag služby. Umožňuje pro jednu službu sdružovat zpracovatele do skupin a rozšiřovat možnosti směrování a vyvažování. Pro vzor req-resp je směrování lineární. Posíláme dotaz na výměnný bod, ten ho následně předává službě. Pokud však potřebujeme rozdělit zpracovatele do logických skupin, provádí se rozdělení pomocí tagů. Při uvedení tagu bude dotaz směřován na konkrétní skupinu kontrolérů.
- Tag dotazu. Umožňuje odlišit odpovědi. Protože náš systém je asynchronní, je pro zpracování odpovědí služby nutné mít možnost uvést RequestTag při odesílání dotazu. Podle něj budeme schopni pochopit, na který dotaz jsme obdrželi odpověď.
Pub-sub
Pro pub-sub je to o něco jednodušší. Máme výměnný bod, na který se publikují zprávy. Výměnný bod rozděluje zprávy mezi odběrateli, kteří se přihlásili k potřebným klíčům směrování (dá se říci, že to je analogie témat).
Škálovatelnost a odolnost proti chybám
Škálovatelnost systému jako celku závisí na míře škálovatelnosti vrstev a komponent systému:
- Služby sa škálujú pridaním ďalších uzlov so spracovateľmi tejto služby do clustera. Počas odbornej prevádzky je možné zvoliť optimálnu politiku vyvažovania.
- Služba messaging sa v rámci samostatného clustera zvyčajne škáluje buď presunutím vyťažených výmenných bodov na samostatné uzly clustera, alebo pridaním proxy procesov do najviac zaťažených zón clustera.
- Škálovateľnosť celého systému ako charakteristika závisí od flexibility architektúry a možnosti spájania jednotlivých clusterov do jedného logického celku.
Úspech projektu často závisí od jednoduchosti a rýchlosti škálovania. Messaging v aktuálnom vydaní rastie spolu s aplikáciou. Aj keď nám chýba cluster s 50-60 strojmi, môžeme siahnuť po federácii. Bohužiaľ, téma federácie presahuje rámec tohto článku.
Zálohovanie
Pri analýze vyvažovania záťaže sme už hovorili o rezervácii kontrolérov služieb. Messaging by však tiež mal byť rezervovaný. V prípade zlyhania uzla alebo stroja sa messaging musí automaticky obnoviť, a to v najkratšom možnom čase.
Vo svojich projektoch používam ďalšie uzly, ktoré preberajú záťaž v prípade zlyhania. V Erlangu existuje štandardná implementácia distribuovaného režimu pre aplikácie OTP. Distribuovaný režim zabezpečuje obnovenie v prípade poruchy spustením spadnutej aplikácie na inom predtým spustenom uzle. Proces je transparentný, po zlyhaní sa aplikácia automaticky presunie na failover uzol. O tejto funkcií si môžete prečítať viac. .
Výkon
Skúsme aspoň približne porovnať výkon rabbitmq a nášho vlastného messagingu.
Našiel som testovania rabbitmq od tímu openstack.
V bode 6.14.1.2.1.2.2 originálneho dokumentu je uvedený výsledok RPC CAST:
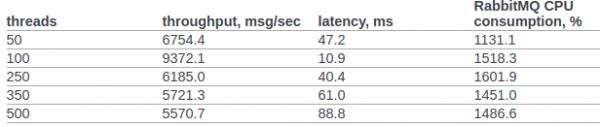
Predbežne nebudeme robiť žiadne dodatočné nastavenia do jadra OS alebo erlang VM. Podmienky pre testovanie:
- erl opts: +A1 +sbtu.
- Test v rámci jedného uzla erlang sa spúšťa na notebooku so starším i7 v mobilnom prevedení.
- Clusterové testy prebiehajú na serveroch s 10G sieťou.
- Kód funguje v docker kontajneroch. Sieť v režime NAT.
Kód testu:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenár 1: Test sa vykonáva na staršom laptobe so starým i7 mobilným procesorom. Test, messaging a služba sa vykonávajú na jednom uzle v jednom docker kontajneri:
Sekvenčné 10000 cyklov za ~0 sekúnd (26987 cyklov/s)
Sekvenčné 20000 cyklov za ~1 sekundu (26915 cyklov/s)
Sekvenčné 100000 cyklov za ~4 sekundy (26957 cyklov/s)
Paralelne 2 100000 cyklov za ~2 sekundy (44240 cyklov/s)
Paralelne 4 100000 cyklov za ~2 sekundy (53459 cyklov/s)
Paralelne 10 100000 cyklov za ~2 sekundy (52283 cyklov/s)
Paralelne 100 100000 cyklov za ~3 sekundy (49317 cyklov/s)
Scenár 2: 3 uzly spustené na rôznych strojoch pod docker (NAT).
Sekvenčné 10000 cyklov za ~1 sekundu (8684 cyklov/s)
Sekvenčné 20000 cyklov za ~2 sekundy (8424 cyklov/s)
Sekvenčné 100000 cyklov za ~12 sekúnd (8655 cyklov/s)
Paralelne 2 100000 cyklov za ~7 sekúnd (15160 cyklov/s)
Paralelne 4 100000 cyklov za ~5 sekúnd (19133 cyklov/s)
Paralelne 10 100000 cyklov za ~4 sekundy (24399 cyklov/s)
Paralelne 100 100000 cyklov za ~3 sekundy (34517 cyklov/s)
V všetkých prípadoch využitie CPU neprekročilo 250%
Zhrnutie
Dúfam, že tento cyklus nevyzerá ako dump vedomia a moja skúsenosť prinesie skutočný prínos ako výskumníkom distribuovaných systémov, tak aj praktikom, ktorí sú na začiatku cesty budovania distribuovaných architektúr pre svoje obchodné systémy a zaujímajú sa o Erlang/Elixir, ale pochybujú, či by mali…
Foto
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Aké témy by som mal podrobne osvetliť v rámci cyklu 'Experiment VTrade'?
Teória: Trhy, objednávky a ich platnosť: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Kniha objednávok. Teória a prax zavádzania knihy s grupovaním
Vizualizácia obchodovania: Tiky, bary, rezolúcie. Ako uchovávať a ako skladovať
Backoffice. Plánovanie a vývoj. Kontrola zamestnancov a vyšetrenie incidentov
API. Rozoberáme, aké rozhrania sú potrebné a ako ich zrealizovať
Uloženie informácií: PostgreSQL, Timescale, Tarantool v obchodných systémoch
Reaktivita v obchodných systémoch
Iné. Napíšem v komentároch
Hlasovalo 6 používateľov. Zdržali sa 4 používatelia.
Zdroj: habr.com
