

V rámci tohto článku by sme chceli prerozprávať o vlastnostiach fungovania All Flash polí AccelStor s jednou z najpopulárnejších virtualizačných platforiem – VMware vSphere. Konkrétne sa zameriame na parametre, ktoré pomôžu dosiahnuť maximálny efekt z používania takého výkonného nástroja, ako je All Flash.
All Flash polia AccelStor NeoSapphire™ sú alebo zariadenia založené na SSD úložiskách s principiálne iným prístupom k realizácii konceptu ukladania dát a organizácii prístupu k nim pomocou vlastnej technológie namiesto veľmi populárnych algoritmov RAID. Polia poskytujú blokový prístup pre hostiteľov cez rozhrania Fibre Channel alebo iSCSI. Je potrebné objasniť, že modely s ISCSI rozhraním majú aj súborový prístup ako príjemný bonus. Ale v rámci tohto článku sa zameriame na použitie blokových protokolov ako najvýkonnejších pre All Flash.
Celý proces nasadenia a následného nastavenia spolupráce poľa AccelStor a virtualizačného systému VMware vSphere možno rozdeliť na niekoľko krokov:
- Realizácia topológie pripojenia a nastavenie SAN siete;
- Nastavenie All Flash poľa;
- Nastavenie hostiteľov ESXi;
- Nastavenie virtuálnych strojov.
Na ilustračné účely boli použité polia AccelStor NeoSapphire™ s rozhraním Fibre Channel a s rozhraním iSCSI. Základným softvérom bolo VMware vSphere 6.7U1.
Pred nasadením v článku popísaných systémov sa dôrazne odporúča oboznámiť sa s dokumentáciou od VMware týkajúcou sa otázok výkonu ( ) a nastavení iSCSI ()
Topológia pripojenia a nastavenie SAN siete
Hlavnými komponentmi SAN siete sú HBA adaptéry v hostiteľoch ESXi, SAN prepínače a nody poľa. Typická topológia tejto siete by mala vyzerať takto:
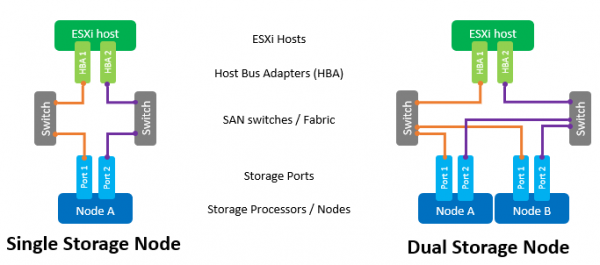
Pod termínom Switch sa tu rozumie ako samostatný fyzický prepínač alebo súbor prepínačov (Fabric), tak aj zdieľané zariadenie medzi rôznymi službami (VSAN v prípade Fibre Channel a VLAN v prípade iSCSI). Použitie dvoch nezávislých prepínačov/Fabric umožní vylúčiť možnú jedinú bod poruchy.
Pripojenie hostiteľov priamo k poli, aj keď je podporované, sa veľmi neodporúča. Výkon All Flash polí je dostatočne vysoký. A na dosiahnutie maximálnej rýchlosti je potrebné využiť všetky porty poľa. Preto je prítomnosť aspoň jedného prepínača medzi hostiteľmi a NeoSapphire™ nevyhnutná.
Přítomnost dvou portů na HBA hostitele je také povinným požadavkem pro dosažení maximální výkonnosti a zajištění odolnosti vůči poruchám.
V případě použití rozhraní Fibre Channel je třeba nastavit zónování, aby se vyloučily možné kolize mezi iniciátory a cíli. Zóny se budují na principu "jeden port iniciátora – jeden nebo více portů pole".
Pokud sa však používa pripojenie cez iSCSI a zdieľaný prepínač s inými službami, je nevyhnutné izolovať iSCSI prevádzku v rámci samostatného VLAN. Taktiež sa veľmi odporúča zapnúť podporu Jumbo Frames (MTU = 9000) na zvýšenie veľkosti paketov v sieti a tým zníženie množstva ovládacích informácií pri prenose. Je však potrebné si uvedomiť, že na správnu funkčnosť je potrebné zmeniť parameter MTU na všetkých komponentoch siete v reťazci "iniciátor-prepínač-cieľ".
Nastavenie All Flash poľa
Pole je dodávané zákazníkom s už vytvorenými skupinami . Preto nie sú potrebné žiadne kroky na zlúčenie úložných zariadení do jednej štruktúry. Stačí len vytvoriť objemy požadovanej veľkosti a v požadovanom množstve.
Pre pohodlie je k dispozícii funkcia hromadného vytvárania viacerých objemov určenej veľkosti. Predvolene sa vytvárajú "tenké" objemy, pretože to umožňuje efektívnejšie využívať dostupný úložný priestor (vrátane podpory Space Reclamation). Z hľadiska výkonu rozdiel medzi "tenkými" a "hrubými" objemami nepresahuje 1%. Avšak ak je potrebné "vytiahnuť všetko z poľa", vždy je možné skonvertovať akýkoľvek "tenký" objem na "hrubý". Ale treba mať na pamäti, že takáto operácia je nezvratná.
Potom zostáva „publikovať“ vytvorené zväzky a nastaviť prístupové práva k nim zo strany hostiteľov pomocou ACL (IP adresy pre iSCSI a WWPN pre FC) a fyzického rozdelenia podľa portov poľa. Pre modely iSCSI sa to robí vytvorením Target.
Pre modely FC publikácia prebieha vytvorením LUN pre každý port poľa.
Na urýchlenie procesu nastavenia je možné hostiteľov združovať do skupín. Ak sa na hostiteľovi používa viacportová FC HBA (čo je v praxi najčastejšie), systém automaticky rozpozná, že porty takejto HBA patria k jedinému hostiteľovi vďaka WWPN, ktoré sa líšia o jednotku. Pre obidva rozhrania sa tiež podporuje hromadné vytváranie Target/LUN.
Dôležitou poznámkou v prípade použitia iSCSI rozhrania je vytvorenie pre zväzky niekoľkých cieľov súčasne kvôli zvýšeniu výkonu, pretože frontu na cieľovej adrese nie je možné zmeniť, a v skutočnosti bude úzkym miestom.
Nastavenie hostiteľov ESXi
Z pohľadu hostiteľov ESXi sa základné nastavenie vykonáva podľa celkom očakávaného scenára. Postup pre iSCSI pripojenie:
- Pridanie Softvérového iSCSI adaptéra (nie je potrebné, ak už bol pridaný, alebo v prípade použitia Hardvérového iSCSI adaptéra);
- Vytvorenie vSwitch, cez ktorý bude prechádzať iSCSI prenos, a pridanie fyzických uplink a VMkernal;
- Pridanie adries poľa do Dynamic Discovery;
- Vytvorenie Datastore
Niektoré dôležité poznámky:
- Vo všeobecnosti je možné použiť aj existujúci vSwitch, ale v prípade samostatného vSwitch bude správa nastavení hostiteľa výrazne jednoduchšia.
- Je potrebné rozdeľovať Management prenos a iSCSI po oddelených fyzických linkách a/alebo VLAN, aby sa predišlo problémom s výkonom.
- IP adresy VMkernal a príslušných portov All Flash poľa musia byť v rámci jednej podsiete opäť z dôvodu otázok výkonu.
- Na zabezpečenie odolnosti proti poruchám podľa pravidiel VMware musí mať vSwitch aspoň dva fyzické uplink.
- Ak sa používajú Jumbo Frames, je potrebné zmeniť MTU ako na vSwitch, tak aj na VMkernal.
- Nebude zbytočné pripomenúť, že podľa odporúčaní VMware je pre fyzické adaptéry, ktoré budú používané na prácu s iSCSI trafikom, nevyhnutné nastaviť Teaming and Failover. Konkrétne, každý VMkernal by mal pracovať len cez jeden uplink, druhý uplink je potrebné nastaviť do režimu unused. Pre zabezpečenie vysokodostupnosti je potrebné pridať dva VMkernal, z ktorých každý bude pracovať cez svoj uplink.
VMkernel Adapter (vmk#)
Fyzický sieťový adaptér (vmnic#)
vmk1 (Storage01)
Aktívne adaptéry
vmnic2
Nepoužité adaptéry
vmnic3
vmk2 (Storage02)
Aktívne adaptéry
vmnic3
Nepoužité adaptéry
vmnic2
Pre pripojenie cez Fibre Channel nie sú potrebné žiadne predchádzajúce kroky. Môžete okamžite vytvoriť Datastore.
Po vytvorení Datastore je potrebné sa uistiť, že sa používa politika Round Robin pre cesty k Target/LUN ako najvýkonnejšia.
Predvolené nastavenia VMware predpokladajú používanie tejto politiky podľa schémy: 1000 požiadaviek cez prvú cestu, ďalších 1000 požiadaviek cez druhú cestu atď. Takéto interakcie hostiteľa s dvojkontrolérovým úložiskom budú nevyvážené. Preto odporúčame nastaviť parameter Round Robin policy = 1 cez Esxcli/PowerCLI.
Parametre
Pre Esxcli:
- Zobraziť dostupné LUN
esxcli storage nmp device list
- Skopírovať názov zariadenia
- Zmeniť Round Robin Policy
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
Väčšina moderných aplikácií je navrhnutá na výmenu paketov veľkých dát s cieľom maximalizovať využitie priepustnosti a znížiť záťaž na centrálny procesor. Preto ESXi predvolene prenáša požiadavky vstupu/výstupu na úložné zariadenie po častiach až do 32767KB. Avšak pre niektoré scenáre bude výmena menšími časťami výkonnejšia. V súvislosti s modelmi AccelStor sú to nasledujúce scenáre:
- Virtuálny stroj používa UEFI namiesto Legacy BIOS
- Používa sa vSphere Replication
Pre takéto scenáre sa odporúča zmeniť hodnotu parametra Disk.DiskMaxIOSize na 4096.
Pre iSCSI pripojenia sa odporúča nastaviť parameter Login Timeout na 30 (predvolene 5) na zvýšenie stability pripojenia a vypnúť oneskorenie potvrdení posielaných paketov DelayedAck. Obe možnosti sa nachádzajú vo vSphere Client: Host → Configure → Storage → Storage Adapters → Advanced Options pre iSCSI adaptér.
Dostatočne tenkým momentom je počet používaných zväzkov pre datastore. Je jasné, že pre jednoduché riadenie vzniká túžba vytvoriť jeden veľký zväzok na celý objem poľa. Avšak existencie viacerých zväzkov a, v súlade s tým, datastore má priaznivý vplyv na celkový výkon (viac o frontách nižšie v texte). Preto odporúčame vytvorenie aspoň dvoch zväzkov.
Ešte relatívne nedávno VMware odporúčala obmedziť počet virtuálnych strojov na jednom datastore opäť s cieľom dosiahnuť maximálny možný výkon. Avšak dnes, zvlášť s rozšírením VDI, tento problém už nie je tak akútny. To však neodstraňuje dávne pravidlo — rozdeľovať virtuálne stroje, ktoré vyžadujú intenzívny IO, po rôznych datastore. Pre určenie optimálneho počtu virtuálnych strojov na jeden zväzok nie je nič lepšie, ako vykonať v rámci svojej infraštruktúry.
Nastavenie virtuálnych strojov
Pri nastavovaní virtuálnych strojov nie sú žiadne osobitné požiadavky, presnejšie sú celkom bežné:
- Použitie maximálne možnej verzie VM (kompatibilita)
- Opatrne nastaviť veľkosť RAM pri tesnom umiestnení virtuálnych strojov, napríklad v VDI (keďže pri štarte sa vytvára súbor na swapovanie rovnateľného s veľkosťou RAM, čo spotrebováva užitočnú kapacitu a ovplyvňuje konečný výkon)
- Použiť najvýkonnejšie z hľadiska IO verzie adaptérů: sieťové typu VMXNET 3 a SCSI typu PVSCSI
- Použiť typ disku Thick Provision Eager Zeroed pre maximálny výkon a Thin Provisioning pre maximálne efektívne využitie úložného priestoru
- Pokúsiť sa obmedziť činnosť strojov, ktoré nie sú kritické na vstup/výstup pomocou Virtual Disk Limit
- Nezabudnúť nainštalovať VMware Tools
Poznámky o frontách
Čakáreň (alebo Outstanding I/O) je počet požiadaviek na vstup/výstup (SCSI príkazov), ktoré čakajú na spracovanie v každom okamihu na konkrétnom zariadení/aplikácii. V prípade preťaženia frontu sa vydávajú chyby QFULL, čo sa nakoniec prejaví na náraste latencie. Pri použití diskových (točivých) systémov na ukladanie údajov teoreticky platí, že čím vyšší je front, tým vyšší je ich výkon. Avšak nemali by ste to preháňať, pretože sa môžete ľahko stretnúť s QFULL. V prípade systémov All Flash je to z jednej strany jednoduchšie: matice majú oneskorenia rádovo nižšie, a preto vo väčšine prípadov nie je potrebné osobitne regulovať veľkosť frontov. Na druhej strane v niektorých scenároch (výrazný prebytok požiadaviek na IO pre konkrétne virtuálne stroje, testy na maximálny výkon atď.) je potrebné nielen zmeniť parametre frontov, ale aspoň pochopiť, akých ukazovateľov je možné dosiahnuť a, čo je najdôležitejšie, akými spôsobmi.
Na samotnej All Flash matici AccelStor neexistujú žiadne obmedzenia týkajúce sa zväzkov alebo portov vstup/výstup. Prípadne aj jediný zväzok môže získať všetky zdroje matice. Jediné obmedzenie na fronty sa nachádza pri iSCSI cieľoch. Práve z tohto dôvodu sa vyššie uvádzala potreba vytvoriť niekoľko (ideálne až 8) cieľov pre každý zväzok na prekonanie tohto obmedzenia. Rovnako opakujeme, že matice AccelStor sú veľmi výkonné riešenia. Preto je potrebné využiť všetky rozhrania systému na dosiahnutie maximálnej rýchlosti.
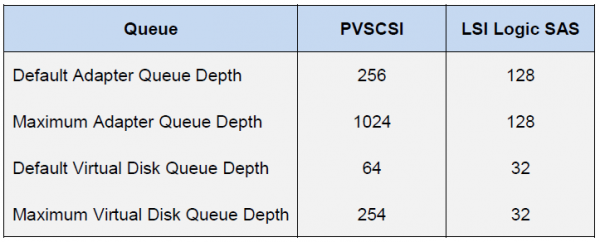
Z pohľadu hostiteľa ESXi je situácia úplne iná. Samotný hostiteľ aplikuje prax rovného prístupu k zdrojom pre všetkých účastníkov. Preto existujú samostatné fronty IO pre hosťujúci operačný systém a HBA. Fronty pre hosťujúci operačný systém sa kombinujú z frontov na virtuálny SCSI adaptér a virtuálny disk:
Fronta k HBA závisí od konkrétneho typu/výrobcu:
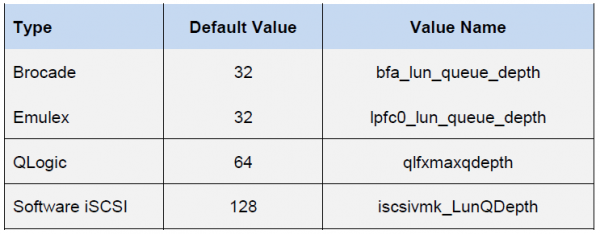
Celkový výkon virtuálneho stroja bude určený najnižšou hodnotou ukazovateľa frontu (Queue Depth limit) medzi komponentmi hostiteľa.
Vďaka týmto hodnotám je možné posúdiť výkonnostné parametre, ktoré môžeme dosiahnuť v rôznych konfiguráciách. Napríklad, ak chceme zistiť teoretickú výkonnosť virtuálneho stroja (bez viazania na blok) pri latencii 0,5 ms. Potom jej IOPS = (1 000 / latencia) * Outstanding I / Os (limit hĺbky frontu)
Príklady
Príklad 1
- FC Emulex HBA adaptér
- Jeden VM na datastore
- VMware Paravirtual SCSI adaptér
Tu je limit hĺbky frontu určený Emulex HBA. Preto IOPS = (1000 / 0,5) * 32 = 64K
Príklad 2
- VMware iSCSI Softvérový adaptér
- Jeden VM na datastore
- VMware Paravirtual SCSI adaptér
Tu je limit hĺbky frontu určený už Paravirtual SCSI adaptérom. Preto IOPS = (1000 / 0,5) * 64 = 128K
Najvyššie modely All Flash polí AccelStor (napríklad, ) sú schopné zabezpečiť výkonnosť 700K IOPS pri zápise pri bloku 4K. Pri tejto veľkosti bloku je úplne zrejmé, že jediný virtuálny stroj nie je schopný zaťažiť také pole. Na to bude potrebných 11 (pre príklad 1) alebo 6 (pre príklad 2) virtuálnych strojov.
Nakoniec, pri správnom nastavení všetkých uvedených komponentov virtuálneho dátového centra je možné dosiahnuť veľmi pôsobivé výsledky z hľadiska výkonu.
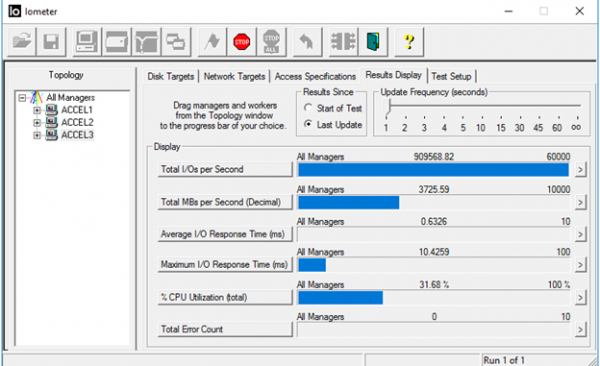
4K náhodné, 70% čítanie / 30% zápis
V skutočnosti je skutočný svet omnoho zložitejší, ako ho popísať jednoduchým vzorcom. Na jednom hostiteľovi je vždy množstvo virtuálnych strojov s rôznymi konfiguráciami a požiadavkami na IO. A spracovanie vstupu / výstupu zabezpečuje procesor hostiteľa, ktorého výkon nie je neobmedzený. Tak, na to, aby sa odhalil plný potenciál toho istého v realite bude potrebných minimálne tri hostitelia. Navyše aplikácie, ktoré bežia vo virtuálnych strojoch, prispievajú svojimi korekciami. Preto na presné určenie veľkosti odporúčame All Flash polí v rámci infraštruktúry zákazníka na reálnych aktuálnych úlohách.
Zdroj: habr.com
