

V tomto príspevku by sme sa radi podelili o zaujímavý spôsob riešenia konfigurácie distribuovaného systém.
Konfigurácia je priamo reprezentovaná v jazyku Scala bezpečne typovo. Príklad implementácie je podrobne opísaný. Rôzne aspekty návrhu sú prediskutované, vrátane vplyvu na celkový proces vývoja.
()
Introduction
Výstavba robustných distribuovaných systémov si vyžaduje správne a koherentné konfigurácie na všetkých uzloch. Typickým riešením je použiť textový popis nasadenia (terraform, ansible alebo niečo podobné) a automaticky generované konfiguračné súbory (často — určené pre každý uzol/úlohu). Chceme tiež, aby na všetkých komunikujúcich uzloch boli použité rovnaké protokoly tej istej verzie (inak budeme čeliť problémom s nekompatibilitou). Vo svete JVM to znamená, že aspoň knižnica správy správ by mala byť rovnakej verzie na všetkých komunikujúcich uzloch.
A čo testovanie systému? Samozrejme, mali by sme mať jednotkové testy pre všetky komponenty predtým, než prejdeme na integračné testy. Aby sme mohli extrapolovať výsledky testov na runtime, mali by sme zabezpečiť, že verzie všetkých knižníc sú vo runtime aj testovacom prostredí identické.
Pri vykonávaní integračných testov je často oveľa jednoduchšie mať rovnaký classpath na všetkých uzloch. Musíme len zabezpečiť, aby sa rovnaký classpath použil pri nasadení. (Je možné použiť rôzne classpathy na rôznych uzloch, ale je ťažšie túto konfiguráciu reprezentovať a správne ju nasadiť.) Takže, aby sme udržali veci jednoduché, budeme zvažovať len identické classpathy na všetkých uzloch.
Konfigurácia má tendenciu vyvíjať sa spolu s softvérom. Zvyčajne používame verzie na identifikáciu rôznych
fázy evolúcie softvéru. Zdá sa rozumné pokryť konfiguráciu správou verzií a identifikovať rôzne konfigurácie pomocou niektorých štítkov. Ak existuje len jedna konfigurácia v produkcii, môžeme použiť jednu verziu ako identifikátor. Niekedy môžeme mať viacero produkčných prostredí. A pre každé prostredie môžeme potrebovať samostatnú vetvu konfigurácie. Takže konfigurácie môžu byť označené vetvou a verziou na jedinečné identifikovanie rôznych konfigurácií. Každý štítok vetvy a verzia zodpovedá jednej kombinácii distribuovaných uzlov, portov, externých zdrojov a verzií knižníc na každom uzle. Tu sa budeme venovať len jednej vetve a identifikovať konfigurácie trojkomponentnou desiatkovou verziou (1.2.3), rovnakým spôsobom ako iné artefakty.
V moderných prostrediach sa konfiguračné súbory už nemodifikujú manuálne. Typicky generujeme
konfiguračné súbory v čase nasadenia a potom. Takže by sa mohol niekto opýtať, prečo ešte používame textový formát pre konfiguračné súbory? Udržateľnou možnosťou je umiestniť konfiguráciu do jednotky kompilácie a profitovať z validácie konfigurácie v čase kompilácie.
V tomto príspevku preskúmame myšlienku uchovávania konfigurácie v skompilovanom artefakte.
Kompilovateľná konfigurácia
V tejto časti prediskutujeme príklad statickej konfigurácie. Dva jednoduché služby — echo služba a klient echo služby sú konfigurované a implementované. Potom sú inštantované dva rôzne distribuované systémy s oboma službami. Jeden je pre konfiguráciu s jedným uzlom a druhý pre konfiguráciu s dvoma uzlami.
Typický distribuovaný systém pozostáva z niekoľkých uzlov. Uzly môžu byť identifikované pomocou nejakého typu:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
alebo jednoducho
case class NodeId(hostName: String)alebo dokonca
object Singleton
type NodeId = Singleton.type
Tieto uzly vykonávajú rôzne úlohy, bežia niektoré služby a mali by byť schopné komunikovať s ostatnými uzlami prostredníctvom TCP/HTTP spojení.
Na TCP pripojenie je potrebné aspoň číslo portu. Chceme tiež zabezpečiť, že klient a server komunikujú rovnakým protokolom. Aby sme modelovali pripojenie medzi uzlami, deklarujme nasledujúcu triedu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])kde Port je jednoduchý Int v rámci povoleného rozsahu:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Detailnejšie typy
Pozrite sa na knižnicu. Jednoducho povedané, umožňuje pridávať obmedzenia v čase kompilácie na iné typy. V tomto prípade Int má iba 16-bitové hodnoty, ktoré môžu reprezentovať číslo portu. Na tento konfiguračný prístup nie je potrebné používať túto knižnicu. Zjavne sa však veľmi dobre hodí.
Pre HTTP (REST) môžeme potrebovať aj cestu k službe:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantómový typ
Na identifikáciu protokolu počas kompilácie používame funkciu Scala na deklarovanie typového argumentu Protokol ktorý nie je použitý v triede. Je to takzvaný fantómový typ. Počas behu zriedka potrebujeme inštanciu identifikátora protokolu, preto ho nielenže neukladáme. Počas kompilácie tento fantómový typ poskytuje dodatočnú typovú bezpečnosť. Nemôžeme prenášať port s nesprávnym protokolom.
Jedným z najpoužívanejších protokolov je REST API s Json serializáciou:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]kde RequestMessage je základný typ správ, ktoré klient môže poslať serveru a ResponseMessage je odpovedná správa od servera. Samozrejme, môžeme vytvoriť aj iné popisy protokolu, ktoré špecifikujú komunikačný protokol s požadovanou presnosťou.
Na účely tohto príspevku použijeme jednoduchšiu verziu protokolu:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]V tomto protokole je správna požiadavka pridaná k url a odpověď zprávy je vracaná ako obyčajný reťazec.
Konfigurácia služby by mohla byť popísaná názvom služby, zbierkou portov a niektorými závislosťami. Existuje niekoľko možných spôsobov, ako reprezentovať všetky tieto prvky v Scale (napríklad, HList, algebraické dátové typy). Na účely tohto príspevku použijeme vzor Cake a reprezentujeme kombinovateľné časti (moduly) ako trait. (Poloha Cake nie je požiadavkou pre tento konfiguračný prístup. Je to len jedna možná implementácia myšlienky.)
Závislosti by mohli byť reprezentované pomocou vzoru Cake ako koncové body iných uzlov:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo služba potrebujú iba nakonfigurovaný port. A deklarujeme, že tento port podporuje echo protokol. Všimnite si, že v tomto momente nemusíme špecifikovať konkrétny port, pretože trait umožňuje deklarácie abstraktných metód. Ak použijeme abstraktné metódy, kompilátor bude vyžadovať implementáciu v konfiguračnej inštancii. Tu sme poskytli implementáciu (8081) a bude použitá ako predvolená hodnota, ak ju v konkrétnej konfigurácii vynecháme.
Môžeme deklarovať závislosť v konfigurácii klienta echo služby:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Závislosť má rovnaký typ ako echoService. Osobitne vyžaduje rovnaký protokol. Preto si môžeme byť istí, že ak prepojíme tieto dve závislosti, budú fungovať správne.
Implementácia služieb
Služba potrebuje funkciu na spustenie a decentné vypnutie. (Možnosť vypnúť službu je kritická pre testovanie.) Opäť existuje niekoľko možností na špecifikovanie takejto funkcie pre danú konfiguráciu (napríklad, mohli by sme použiť typové triedy). Pre tento príspevok opäť použijeme vzor Cake. Môžeme reprezentovať službu pomocou cats.Resource ktorý už poskytuje rámcové a uvoľnenie zdrojov. Na získanie zdroja by sme mali poskytnúť konfiguráciu a nejaký behový kontext. Takže funkcia na spustenie služby môže vyzerať takto:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
kde
Konfigurácia— typ konfigurácie, ktorý je vyžadovaný týmto štartérom službyAddressResolver— behový objekt, ktorý má schopnosť získať skutočné adresy iných uzlov (pokračujte čítaním pre detaily).
ostatné typy prichádzajú z cats:
F[_]— efektový typ (v najjednoduchšom prípadeF[A]môže byť len() => A. Pre tento príspevok použijemecats.IO.)Reader[A,B]— je viac-menej synonymom pre funkciuA => Bcats.Resource— má spôsoby na získanie a uvoľnenieTimer— umožňuje spať / merať časContextShift— analógExecutionContextApplicative— obal funkcií v efekte (takmer monáda) (možno to nakoniec nahradíme niečím iným)
Použitím tohto rozhrania môžeme implementovať niekoľko služieb. Napríklad službu, ktorá nič nerobí:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Pozri na ďalšie implementácie služieb — ,
a .)
Uzol je jediný objekt, ktorý spúšťa niekoľko služieb (spúšťanie reťazca zdrojov je povolené vzorom Cake):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Všimnite si, že v uzle špecifikujeme presný typ konfigurácie, ktorý je potrebný pre tento uzol. Kompilátor nám nedovolí zostaviť objekt (Cake) s nedostatočným typom, pretože každý trait služby vyhlasuje obmedzenie na Konfigurácia typ. Taktiež nebudeme môcť spustiť uzol bez poskytnutia kompletného nastavenia.
Riešenie adresy uzla
Na to, aby sme nadviazali spojenie, potrebujeme skutočnú hostiteľskú adresu pre každý uzol. Môže byť známa neskôr ako iné časti konfigurácie. Preto potrebujeme spôsob, ako poskytnúť mapovanie medzi ID uzla a jeho skutočnou adresou. Toto mapovanie je funkcia:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Existuje niekoľko možných spôsobov, ako takúto funkciu implementovať.
- Ak poznáme skutočné adresy pred nasadením, počas vytvárania hostiteľov uzlov, môžeme vygenerovať kód v Scalě so skutočnými adresami a následne spustiť zostavenie (ktoré vykonáva kontroly pri kompilácii a potom spúšťa integračné testy). V tomto prípade je naša mapovacia funkcia známa staticky a dá sa zjednodušiť na niečo ako
Map[NodeId, NodeAddress]. - Niekedy získavame skutočné adresy až neskôr, keď je uzol skutočne spustený, alebo nemáme adresy uzlov, ktoré ešte neboli spustené. V tomto prípade môžeme mať službu na objavovanie, ktorá je spustená pred všetkými ostatnými uzlami a každý uzol môže inzerovať svoju adresu v tejto službe a prihlásiť sa k závislostiam.
- Ak môžeme upraviť
/etc/hosts, môžeme použiť preddefinované názvy hostiteľov (akomy-project-main-nodeaecho-backend) a jednoducho asociovať tento názov s IP adresou počas nasadenia.
V tomto príspevku tieto prípady podrobnejšie nekontrolujeme. V skutočnosti v našom hračkovom príklade budú všetky uzly mať rovnakú IP adresu — 127.0.0.1.
V tomto príspevku budeme zvažovať dve rozloženia distribuovaného systému:
- Rozloženie s jedným uzlom, kde sú všetky služby umiestnené na jednom uzle.
- Rozloženie s dvoma uzlami, kde je služba a klient na rôznych uzloch.
Konfigurácia pre rozloženie je nasledovná:
Konfigurácia jedného uzla
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikátor jediného uzla
  \/\/ konfigurácia servera
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Typovo bezpečná špecifikácia portu služby. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfigurácia klienta

  \/** Použijeme službu poskytnutú tým istým hostiteľom. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfigurácia ovládača životného cyklu
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ ďalších 0,5 sekundy, aby sa uskutočnilo 10 požiadaviek, nie 9.
}
Tu vytvárame jedinú konfiguráciu, ktorá rozširuje konfigurácie servera a klienta. Taktiež konfigrujeme riadiacu jednotku životného cyklu, ktorá normálne ukončí klienta a server po uplynutí lifetime intervalu.
Tento istý súbor implementácií služieb a konfigurácií sa môže použiť na vytvorenie rozloženia systému s dvoma samostatnými uzlami. Musíme len vytvoriť s príslušnými službami:
Konfigurácia dvoch uzlov
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! špecifikácia závislosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ ďalších 0.5 sekundy, aby sa uskutočnilo 10 požiadaviek, nie 9.

    def testMessage: String = "dolly"
  }
Pozrite sa, ako špecifikujeme závislosť. Spomíname službu poskytovanú iným uzlom ako závislosť súčasného uzla. Typ závislosti sa kontroluje, pretože obsahuje fantómový typ, ktorý opisuje protokol. A pri behu budeme mať správne ID uzla. Toto je jeden z dôležitých aspektov navrhnutého prístupového konfiguračného prístupu. Poskytuje nám možnosť nastaviť port iba raz a uistiť sa, že odkazujeme na správny port.
Implementácia dvoch uzlov
Pre túto konfiguráciu používame presne rovnaké implementácie služieb. Žiadne zmeny vôbec. Avšak vytvárame dve rôzne implementácie uzlov, ktoré obsahujú rôznu sadu služieb:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvý uzol implementuje server a potrebuje iba konfiguráciu servera. Druhý uzol implementuje klienta a potrebuje inú časť konfigurácie. Obe uzly vyžadujú špecifikáciu životnosti. Na účely tohto príspevku bude servisný uzol mať nekonečnú životnosť, ktorá by mohla byť ukončená pomocou SIGTERM, zatiaľ čo echo klient ukončí po nastavenom konečnom trvaní. Pozrite sa na pre detaily.
Celkový proces vývoja
Pozrime sa, ako tento prístup mení spôsob, akým pracujeme s konfiguráciou.
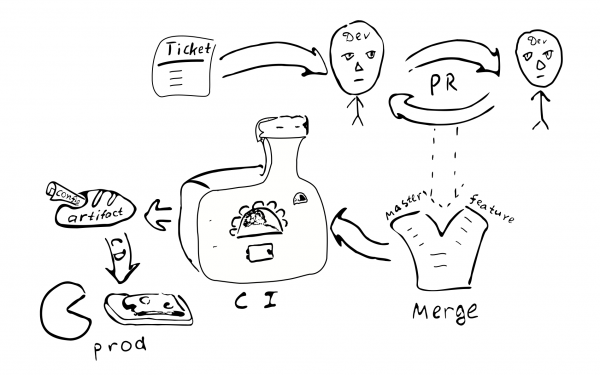
Konfigurácia ako kód bude skompilovaná a vytvorí artefakt. Zdá sa rozumné oddeliť artefakt konfigurácie od iných kódových artefaktov. Často môžeme mať množstvo konfigurácií na rovnakom kódovom základe. A samozrejme, môžeme mať viacero verzií rôznych pobočiek konfigurácie. V konfigurácii môžeme vybrať konkrétne verzie knižníc a to zostane konštantné kedykoľvek nasadíme túto konfiguráciu.
Zmena konfigurácie sa stane zmenou kódu. Takže by mala byť pokrytá rovnakým procesom zabezpečenia kvality:
Ticket -> PR -> recenzia -> zlúčenie -> kontinuálna integrácia -> kontinuálne nasadenie
S týmto prístupom existujú nasledujúce dôsledky:
- Konfigurácia je konzistentná pre konkrétnu inštanciu systému. Zdá sa, že nie je možné mať nesprávne pripojenie medzi uzlami.
- Nie je jednoduché zmeniť konfiguráciu iba v jednom uzle. Zdá sa iracionálne prihlásiť sa a zmeniť niektoré textové súbory. Tak sa stáva, že odchýlka konfigurácie je menej možná.
- Malé zmeny konfigurácie nie sú ľahké na vykonanie.
- Väčšina zmien konfigurácie bude nasledovať rovnaký proces vývoja a prejde istou kontrolou.
Potrebujeme samostatný repozitár pre produkčnú konfiguráciu? Produkčná konfigurácia môže obsahovať citlivé informácie, ktoré by sme chceli udržať mimo dosahu mnohých ľudí. Preto by stálo za to udržať samostatný repozitár s obmedzeným prístupom, ktorý bude obsahovať produkčnú konfiguráciu. Môžeme rozdeliť konfiguráciu na dve časti — jednu, ktorá obsahuje väčšinu verejných parametrov produkcie, a druhú, ktorá obsahuje tajnú časť konfigurácie. To by umožnilo prístup väčšine vývojárov k väčšine parametrov, pričom by sa obmedzil prístup k skutočne citlivým informáciám. Je to ľahké dosiahnuť pomocou medzistupňových vlastností s predvolenými hodnotami parametrov.
Variácie
Pozrime sa na výhody a nevýhody navrhovaného prístupu v porovnaní s ostatnými technikami správy konfigurácie.
Najprv uvedieme niekoľko alternatív k rôznym aspektom navrhnutého spôsobu riešenia konfigurácie:
- Textový súbor na cieľovom stroji.
- Centralizované úložisko kľúč-hodnota (ako napríklad
etcd/zookeeper). - Podprocesy, ktoré by sa mohli konfigurovať/preštartovať bez reštartovania procesu.
- Konfigurácia mimo artefaktu a verziového riadenia.
Textový súbor poskytuje určitú flexibilitu, pokiaľ ide o ad-hoc opravy. Správca systému sa môže prihlásiť do cieľového uzla, vykonať zmenu a jednoducho reštartovať službu. Toto nemusí byť také dobré pre väčšie systémy. Nezostávajú žiadne stopy po zmene. Zmena nie je kontrolovaná inými očami. Môže byť ťažké zistiť, čo spôsobilo zmenu. Nebola testovaná. Z pohľadu distribuovaného systému môže správca jednoducho zabudnúť aktualizovať konfiguráciu v jednom z ostatných uzlov.
(Mimochodom, ak nakoniec vznikne potreba začať používať textové konfiguračné súbory, stačí nám pridať parser + validator, ktorý by mohol produkovať rovnaký Konfigurácia typ a to by stačilo na začatie používania textových konfigurácií. To tiež ukazuje, že zložitosti konfigurácie za kompilácie je trochu menšia ako zložitosť textových konfigurácií, pretože v textovej verzii potrebujeme nejaký dodatočný kód.)
Centralizované úložisko kľúč-hodnota je dobrý mechanizmus na distribúciu meta parametrov aplikácie. Tu musíme premýšľať o tom, čo považujeme za hodnoty konfigurácie a čo je len dáta. Vzhľadom na funkciu C => A => B zvyčajne nazývame zriedka menené hodnoty C «konfigurácia», zatiaľ čo často menené dáta A – len vstupné dáta. Konfigurácia by mala byť poskytnutá funkcii skôr ako dáta. A. Vzhľadom na túto myšlienku môžeme povedať, že očakávaná frekvencia zmien by mohla byť použitá na rozlíšenie konfiguračných dát od obyčajných dát. Tiež dáta typicky pochádzajú z jedného zdroja (používateľ) a konfigurácia pochádza z iného zdroja (administrátor). Riešenie parametrov, ktoré je možné meniť po inicializácii procesu, vedie k zvýšeniu zložitosti aplikácie. Pre takéto parametre budeme musieť zvládnuť ich mechanizmus dodania, parsovanie a validáciu, zaobchádzanie so nesprávnymi hodnotami. Preto, aby sme znížili zložitosti programu, bolo by lepšie znížiť počet parametrov, ktoré môžu byť menené počas behu (alebo ich dokonca úplne eliminovať).
Z pohľadu tohto príspevku by sme mali rozlišovať medzi statickými a dynamickými parametrami. Ak logika služby vyžaduje zriedkavú zmenu niektorých parametrov počas behu, môžeme ich nazvať dynamickými parametrami. Inak sú statické a môžu byť konfigurované pomocou navrhovaného prístupu. Na dynamickú rekonfiguráciu môžu byť potrebné iné prístupy. Napríklad, časti systému môžeme reštartovať s novými konfiguračnými parametrami spôsobom podobným reštartovaniu samostatných procesov distribuovaného systému.
(Môj pokorný názor je vyhnúť sa rekonfigurácii za behu, pretože to zvyšuje zložitosti systému.
Mohlo by byť jednoduchšie spoliehať sa na podporu OS pri reštartovaní procesov. Hoci to nemusí byť vždy možné.)
Dôležitý aspekt používania statickej konfigurácie, ktorý niekedy vedie ľudí k zvažovaniu dynamickej konfigurácie (bez iných dôvodov), je prestoj služby počas aktualizácie konfigurácie. Skutočne, ak musíme vykonať zmeny v statickej konfigurácii, musíme reštartovať systém, aby nové hodnoty nadobudli účinnosť. Požiadavky na prestoje sa líšia pre rôzne systémy, takže to nemusí byť také kritické. Ak je to kritické, potom musíme vopred plánovať akékoľvek reštarty systému. Napríklad, môžeme implementovať . V tomto scenári, keď potrebujeme reštartovať systém, najprv spustíme nový inštanciu systému paralelne, potom prepíname ELB naň, pričom starý systém necháme dokončiť obsluhu existujúcich pripojení.
Čo takto udržiavať konfiguráciu vo verzii artefaktu alebo mimo nej? Uchovávanie konfigurácie vo vnútri artefaktu väčšinou znamená, že táto konfigurácia prešla rovnakým procesom zabezpečenia kvality ako ostatné artefakty. Takže si môže človek byť istý, že konfigurácia je kvalitná a dôveryhodná. Na druhej strane, konfigurácia v samostatnom súbore znamená, že neexistujú stopy o tom, kto a prečo vykonal zmeny v tomto súbore. Je to dôležité? Veríme, že pre väčšinu produkčných systémov je lepšie mať stabilnú a kvalitnú konfiguráciu.
Verzia artefaktu umožňuje zistiť, kedy bola vytvorená, aké hodnoty obsahuje, ktoré funkcie sú povolené/zakázané, kto bol zodpovedný za vykonanie každej zmeny v konfigurácii. Môže to vyžadovať určitú námahu udržiavať konfiguráciu vo vnútri artefaktu a ide o dizajnovú voľbu.
Výhody a nevýhody
Tu by sme chceli zdôrazniť niektoré výhody a prediskutovať niektoré nevýhody navrhovaného prístupu.
Výhody
Funkcie kompilovateľnej konfigurácie plného distribuovaného systému:
- Statická kontrola konfigurácie. To poskytuje vysokú úroveň dôvery, že konfigurácia je správna vzhľadom na typové obmedzenia.
- Bohatý jazyk konfigurácie. Typicky sú iné prístupy ku konfigurácii obmedzené maximálne na substitúciu premenných.
Používaním Scaly možno využiť širokú škálu jazykových funkcií na zlepšenie konfigurácie. Napríklad môžeme použiť triedy na poskytovanie predvolených hodnôt, objekty na nastavenie rôzneho rozsahu, môžeme sa odvolať navals definovanými iba raz vo vonkajšom rozsahu (DRY). Je možné použiť literárne sekvencie alebo inštancie určitých tried (Seq,Mapa, atď.). - DSL. Scala má slušnú podporu pre autorov DSL. Tieto funkcie možno využiť na zabezpečenie jazyka konfigurácie, ktorý je pohodlnejší a priateľskejší pre koncových používateľov, takže konečná konfigurácia je aspoň čitateľná pre doménových používateľov.
- Integrita a koherencia medzi uzlami. Jedným z prínosov mať konfiguráciu pre celý distribuovaný systém na jednom mieste je, že všetky hodnoty sú presne definované raz a potom sa opakujú na všetkých miestach, kde ich potrebujeme. Tiež deklarácie portov bez chýb zabezpečujú, že vo všetkých možných správnych konfiguráciách budú uzly systému hovoriť rovnakým jazykom. Existujú explicitné závislosti medzi uzlami, čo sťažuje zabudnúť poskytnúť niektoré služby.
- Vysoká kvalita zmien. Celkový prístup k absolvovaniu zmien konfigurácie prostredníctvom normálneho procesu PR stanovuje vysoké štandardy kvality aj v konfigurácii.
- Simultánne zmeny konfigurácie. Kedykoľvek vykonáme zmeny v konfigurácii, automatické nasadenie zabezpečuje aktualizáciu všetkých uzlov.
- Zjednodušenie aplikácie. Aplikácia nemusí analyzovať a validovať konfiguráciu a zaoberať sa nesprávnymi hodnotami konfigurácie. To zjednodušuje celkovú aplikáciu. (Niekedy sa zložitosti mierne zvýšia v samotnej konfigurácii, ale je to vedomý obchod v prospech bezpečnosti.) Je pomerne jednoduché vrátiť sa k bežnej konfigurácii — stačí pridať chýbajúce kusy. Je jednoduchšie začať s kompilovanou konfiguráciou a oneskoriť implementáciu ďalších častí na neskoršie.
- Verzovaná konfigurácia. Vzhľadom na to, že zmeny konfigurácie prebiehajú rovnakým vývojovým procesom, nakoniec dostaneme artefakt s jedinečnou verziou. Umožňuje nám to v prípade potreby prepnúť konfiguráciu späť. Môžeme dokonca nasadiť konfiguráciu, ktorá bola používaná pred rokom, a bude fungovať presne rovnakým spôsobom. Stabilná konfigurácia zvyšuje predvídateľnosť a spoľahlivosť distribuovaného systému. Konfigurácia je fixná v čase kompilácie a nemôže byť ľahko zmenená na produkčnom systéme.
- Modularita. Navrhnutý rámec je modulárny a moduly môžu byť kombinované rôznymi spôsobmi na
podporu rôznych konfigurácií (nastavení/položiek). Najmä je možné mať malé jednodeskové usporiadanie a veľké viacuzlové nastavenie. Je rozumné mať viacero produkčných usporiadaní. - Testovanie. Na testovacie účely je možné implementovať mock službu a použiť ju ako závislosť bezpečným spôsobom. Môže sa udržiavať niekoľko rôznych testovacích usporiadaní s rôznymi časťami nahradenými mockmi súčasne.
- Integračné testovanie. Niekedy je v distribuovaných systémoch ťažké realizovať integračné testy. Použitím opísaného prístupu k typovo bezpečnej konfigurácii celého distribuovaného systému môžeme spustiť všetky distribuované časti na jednom serveri kontrolovaným spôsobom. Je jednoduché napodobniť situáciu
keď sa jedna z služieb stane nedostupnou.
Nevýhody
Prístup kompilovaných konfigurácií sa líši od „normálnych“ konfigurácií a nemusí vyhovovať všetkým potrebám. Tu sú niektoré nevýhody kompilovanej konfigurácie:
- Statická konfigurácia. Nemusí byť vhodná pre všetky aplikácie. V niektorých prípadoch je potrebné rýchlo opraviť konfiguráciu v produkcii s obídením všetkých bezpečnostných opatrení. Tento prístup to sťažuje. Po vykonaní akýchkoľvek zmien v konfigurácii je potrebná kompilácia a opätovné nasadenie. To je zároveň výhodou a záťažou.
- Generovanie konfigurácie. Keď je konfigurácia generovaná niektorým automatizovaným nástrojom, tento prístup vyžaduje následnú kompiláciu (ktorá môže zlyhať). Môže to vyžadovať ďalšie úsilie na integráciu tohto dodatočného kroku do systému zostavovania.
- Nástroje. V súčasnosti existuje množstvo nástrojov, ktoré sa spoliehajú na textové konfigurácie. Niektoré z nich
nebudú aplikovateľné, keď je konfigurácia kompilovaná. - Je potrebná zmena myslenia. Vývojári a DevOps sú oboznámení s textovými konfiguračnými súbormi. Myšlienka kompilácie konfigurácie sa im môže zdať zvláštna.
- Pred zavedením kompilovateľnej konfigurácie je potrebný kvalitný proces vývoja softvéru.
Existujú isté obmedzenia implementovaného príkladu:
- Ak poskytneme dodatočnú konfiguráciu, ktorá nie je požadovaná implementáciou uzla, kompilátor nám nepomôže odhaliť chýbajúcu implementáciu. Toto by sa dalo vyriešiť pomocou
HListalebo ADTs (case classes) pre konfiguráciu uzlov namiesto traits a Cake Pattern. - Musíme poskytnúť určitý základný kód v súboroch konfigurácie: (
package,import,objectvyhlásenia;
override def's pre parametre, ktoré majú predvolené hodnoty). To môže byť čiastočne vyriešené pomocou DSL. - V tomto príspevku sa nezaoberáme dynamickou rekonfiguráciou klastrov podobných uzlov.
Záver
V tomto príspevku sme diskutovali o myšlienke priamo reprezentovať konfiguráciu v zdrojovom kóde bezpečným spôsobom. Tento prístup by sa mohol využiť v mnohých aplikáciách ako náhrada za konfigurácie založené na xml a iných textových formátoch. Napriek tomu, že náš príklad bol implementovaný v Scalě, mohol by sa tiež preniesť do iných kompilovateľných jazykov (ako Kotlin, C#, Swift atď.). Tento prístup by ste mohli vyskúšať v novom projekte a v prípade, že sa nepodarí dobre prispôsobiť, prejsť na staromódny spôsob.
Samozrejme, kompilovateľná konfigurácia vyžaduje vysokokvalitný vývojový proces. Na oplátku sľubuje zabezpečiť rovnako vysokokvalitnú robustnú konfiguráciu.
Tento prístup by sa dal rozšíriť rôznymi spôsobmi:
- Je možné použiť makrá na vykonávanie validácie konfigurácie a zlyhať pri kompilácii v prípade akýchkoľvek porúch obchodnej logiky.
- Mohol by sa implementovať DSL, ktorý by reprezentoval konfiguráciu v používateľsky prívetivom formáte pre doménu.
- Dynamické spravovanie zdrojov s automatickými úpravami konfigurácie. Napríklad, keď upravíme počet uzlov v clustre, chceme (1) aby uzly získali mierne upravenú konfiguráciu; (2) aby správca clustra dostal informácie o nových uzloch.
Ďakujem
Chcel by som sa poďakovať Andrey Saksonov, Pavel Popov, Anton Nehaev za inšpiratívnu spätnú väzbu k návrhu tohto príspevku, ktorá mi pomohla urobiť ho jasnejším.
Zdroj: habr.com
