

19. septembra v Bratislave prvý tematický meetup HUG (Highload++ User Group), ktorý bol venovaný mikroslužbám. Na ňom zaznel príspevok "Prevádzka mikroslužieb: veľkosť je dôležitá, aj keď máte Kubernetes", v ktorom sme sa podelili o rozsiahle skúsenosti spoločnosti "Flant" v oblasti prevádzky projektov s mikroslužbovou architektúrou. V prvom rade bude užitočný všetkým vývojárom, ktorí uvažujú o aplikácii tohto prístupu vo svojom aktuálnom alebo budúcom projekte.
Predstavujeme (50 minút, oveľa informatívnejšie ako článok), ako aj hlavný prehľad z neho v textovej podobe.
NB: Video a prezentácia sú dostupné aj na konci tejto publikácie.
Úvod
Zvyčajne má dobrý príbeh úvod, hlavnú zápletku a záver. Táto prednáška viac pripomína úvod, a to tragický. Taktiež je dôležité poznamenať, že v nej je predostretý pohľad na mikroslužby z pohľadu využití.
Začnem takýmto grafom, autorom ktorého (v roku 2015) Martin Fowler:
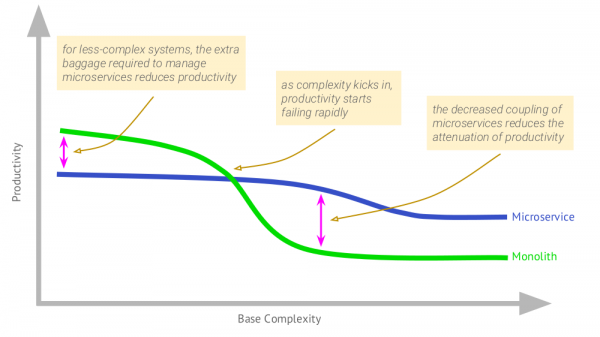
Na ňom je vidieť, ako v prípade monolitickej aplikácie, ktorá dosiahla určitú veľkosť, začína klesať produktivita práce. Mikroslužby sa vyznačujú tým, že počiatočná produktivita s nimi je nižšia, ale s rastom komplexnosti nie je degradácia efektivity taká výrazná.
Doplním tento graf pre prípad využitia Kubernetes:
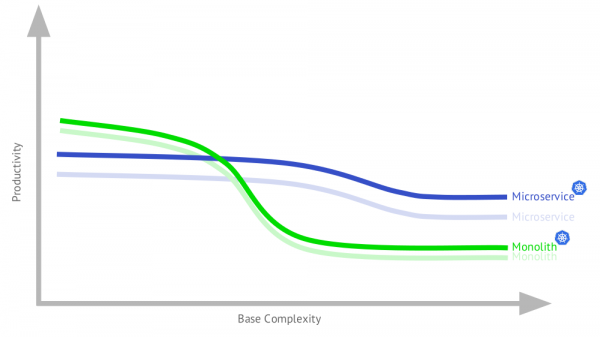
Prečo sa aplikácii s mikroslužbami darí lepšie? Pretože taká architektúra kladie vážne požiadavky na architektúru, ktoré sú zároveň výborne pokryté možnosťami Kubernetes. Na druhej strane, časť tejto funkčnosti bude užitočná aj pre monolit, najmä z dôvodu, že typický dnešný monolit nie je úplne monolit (podrobnosti budú ďalej v prednáške).
Ako je vidno, konečný graf (keď sú monolitické aj mikroslužbové aplikácie v infraštruktúre s Kubernetes) sa veľmi nelíši od pôvodného. Ďalej bude reč o aplikáciách, ktoré sa prevádzkujú s využitím Kubernetes.
Užitočná a škodlivá mikroslužbovosť
A tu je hlavná myšlienka:
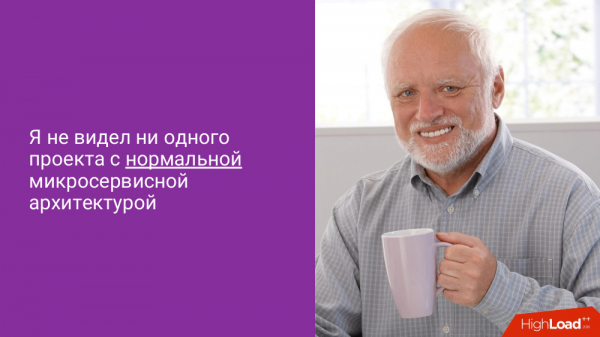
Čo vlastne znamená normálna mikroslužbová architektúra? Mala by vám prinášať skutočný prospech, zvyšovaním efektivity práce. Ak sa vrátim k grafu, tak tu je ona:
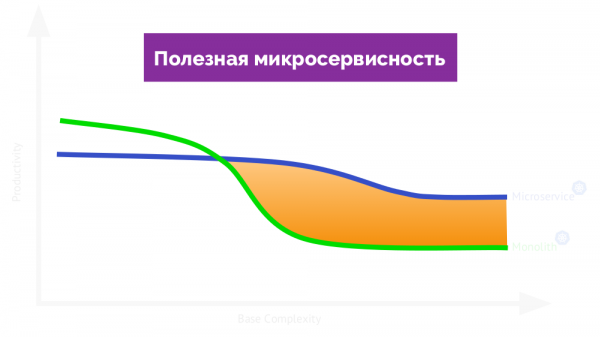
Ak by sme ju nazvali užitočný, tak na druhej strane grafu by bola škodlivá mikroslužbovosť (bráni práci):
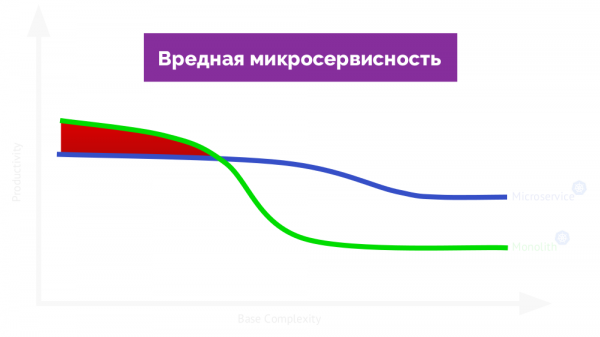
Vraciac sa k „hlavnej myšlienke“: máme vôbec dôverovať mojim skúsenostiam? Od začiatku tohto roku som sa pozrel na 85 projektov. Nie všetky mali mikroslužobnú architektúru (takouto architektúrou disponovalo približne od jednej tretiny do polovice z nich), ale aj tak je to veľké číslo. My (spoločnosť „Flant“) ako outsourcingoví zamestnanci máme možnosť vidieť široké spektrum aplikácií vyvíjaných ako malými spoločnosťami (s 5 vývojármi), tak aj veľkými (~500 vývojármi). Ďalším plusom je, že vidíme, ako tieto aplikácie žijú a vyvíjajú sa počas mnohých rokov.
Prečo mikroslužby?
Na otázku o výhodách mikroslužieb existuje od už spomenutého Martina Fowlera:
- jasné hranice modularity;
- nezávislé nasadzovanie;
- sloboda výberu technológií.
Veľa som hovoril s architektmi a vývojármi softvéru a pýtal som sa, prečo potrebujú mikroslužby. Vytvoril som svoj zoznam ich očakávaní. Tu je to, čo vyšlo:
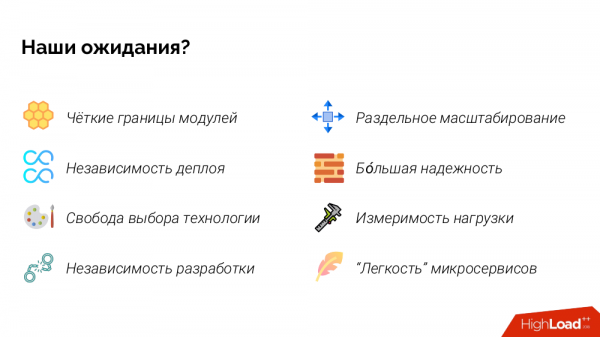
Ak by som popísal „v pocitoch“ niektoré z bodov, tak:
- jasné hranice modulov: máme tu zlý monolit, a teraz bude všetko úhľadne usporiadané v Git-repozitároch, v ktorých je všetko „po poličkách“, nemieša sa teplé so studeným;
- nezávislosť nasadzovania: budeme môcť nasadzovať služby nezávisle, aby sa vývoj urýchlil (paralelne môžeme publikovať nové funkcie);
- nezávislosť vývoja: tento mikroslužba môže byť pridelená jednomu tímu/vývojárovi, a ten druhý ďalšiemu, čo nám umožní rýchlejšie vyvíjať;
- bovyššia spoľahlivosť: ak dôjde k čiastočnej degradácii (spadne jedna mikroslužba z 20), tak prestane fungovať iba jedno tlačidlo, zatiaľ čo systém ako celok bude pokračovať v činnosti.
Typová (škodlivá) mikroslužobná architektúra
Aby som vysvetlil, prečo je v skutočnosti všetko iné, než očakávame, predstavím syntetický obraz mikroslužobnej architektúry, založený na skúsenostiach z množstva rôznych projektov.
Príkladom bude abstraktný internetový obchod, ktorý sa chystá konkurovať Amazone alebo aspoň OZON-u. Jeho mikroslužobná architektúra vyzerá takto:
Z množstva dôvodov sú tieto mikroslužby písané na rôznych platformách:

Keďže každá mikroslužba musí byť autonómna, mnohé z nich potrebujú vlastnú databázu a cache. Konečná architektúra vyzerá takto:
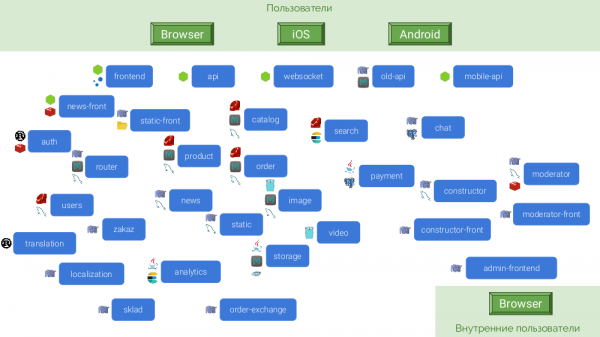
Aké sú jej následky?
U Fowler'a a na tento účet o "platbe" za používanie mikroslužieb:
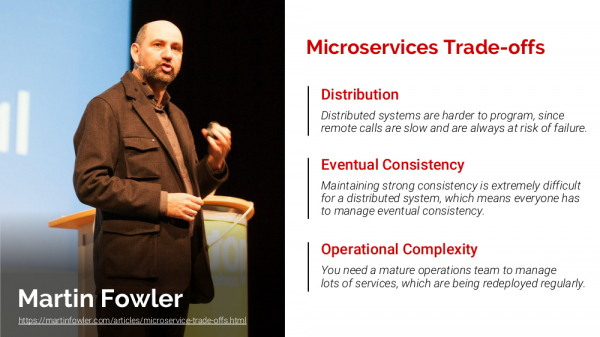
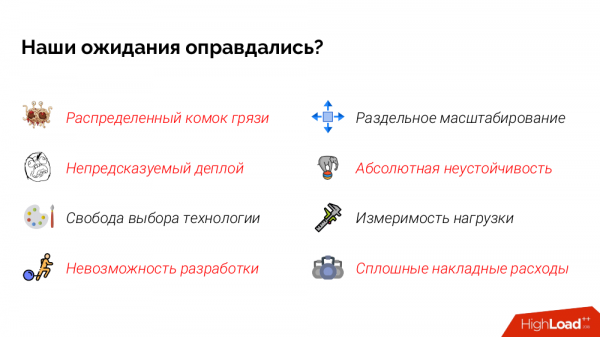
Pozrieme sa, či sa naše očakávania splnili.
Jasné hranice modulov…
Ale koľko mikroslužieb musíme naozaj opraviť, aby sme zaviedli zmenu? Môžeme vôbec pochopiť, ako to všetko funguje, bez distribuovaného trasovača (veď každú požiadavku spracováva polovica mikroslužieb)?
Existuje vzor "", a tu sa získala skutočne distribuovaná guča špiny. Na potvrdenie je tu približná ilustrácia toho, ako prechádzajú požiadavky:
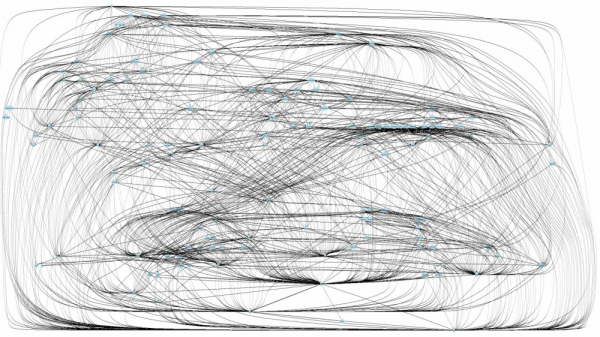
Nezávislosť nasadenia…
Technicky je dosiahnutá: môžeme nasadiť každú mikroslužbu osobitne. Ale v praxi je potrebné mať na pamäti, že sa vždy nasadí množstvo mikroslužieb, pričom musíme zohľadniť poradie ich nasadenia.V ideálnom prípade by sme mali testovať v samostatnom prostredí, či nasadzujeme verziu v správnom poradí.
Sloboda výberu technológie…
Existuje. Len si treba pamätať, že často sloboda hraničí s anarchiou. Je veľmi dôležité nevyberať technológie len preto, aby sme si s nimi "hrali".
Nezávislosť vývoja…
Ako vytvoriť testovacie prostredie pre celú aplikáciu (z takého množstva komponentov)? A zároveň ho treba udržiavať v aktuálnom stave. To všetko vedie k tomu, že skutočný počet testovacích prostredí, ktoré môžeme vôbec udržiavať, je minimálny..
A čo lokalne rozbehnúť všetko? Ukazuje sa, že mnohokrát vývojár vykonáva svoju prácu nezávisle, ale "na slepo", pretože je nútený čakať, kým sa uvoľní prostredie na testovanie.
Oddelené škálovanie…
Áno, ale je obmedzené v oblasti použitých DBMS. V uvedenom príklade architektúry nebudú problémy s Cassandrou, ale budú s MySQL a PostgreSQL.
Veľkáospoľahlivosť…
Nielenže v skutočnosti zlyhanie jedného mikroslužby často narúša správne fungovanie celého systému, existuje aj nový problém: robiť odolným každú mikroslužbu je veľmi ťažké. Pretože v mikroslužbách sa používajú rôzne technológie (memcache, Redis a pod.), pre každú treba všetko premyslieť a realizovať, čo je samozrejme možné, ale vyžaduje obrovské zdroje.
Mieriteľnosť zaťaženia...
S týmto je naozaj všetko v poriadku.
„Ľahkosť“ mikroservisov...
Nemáme len to, že sa objavili obrovské sieťové režijné náklady (zvýšujú sa požiadavky na DNS a podobne), ale aj kvôli množstvu podžiadostí sme začali replikovať dáta (uchovávať cache), čo viedlo k značnému objemu úložiska.
A taký je výsledok splnenia našich očakávaní:
Ale to ešte nie je všetko!
Pretože:
- Pravdepodobne budeme potrebovať správu správ.
- Ako urobiť konzistentnú zálohu v požadovanom čase? Jediná reálna možnosť — vypnúť prenos na to. Ale ako to urobiť v produkcii?
- Ak hovoríme o podpore viacerých regiónov, organizovanie odolnosti v každom z nich je veľmi náročná úloha.
- Objavuje sa problém centralizovaných zmien. Napríklad, ak potrebujeme aktualizovať verziu PHP, bude potrebné urobiť commit do každého repozitára (a tých je desiatky).
- Rast operačnej zložitosti sa na pohľad zdá exponenciálny.
Čo s tým všetkým robiť?
Začnite s monolitnou aplikáciou. Skúsenosti Fowlersa o tom, že takmer všetky úspešné mikroservisné aplikácie začínali ako monolit, ktorý sa stal príliš veľkým a potom bol rozdelený. Zároveň takmer všetky systémy, ktoré boli postavené ako mikroservisy od začiatku, skôr či neskôr čelili vážnym problémom.
Ďalšia cenná myšlienka — aby bol projekt s mikroservisnou architektúrou úspešný, musíte veľmi dobre poznať a predmetnú oblasť, a ako robiť mikroservisy. A najlepší spôsob, ako sa dozvedieť o predmetnej oblasti — je spraviť monolit.
Ale čo robiť, ak sme už v takej situácii?
Prvý krok k riešeniu akéhokoľvek problému — súhlasiť s ním a pochopiť, že je to problém, že už viac nechceme trpieť.
Ak v prípade rozšíreného monolitu (keď sme už vyčerpali možnosti na jeho zakúpenie) ho rozdelíme, v tomto prípade ide o opačný príbeh: keď nadmerná mikroservisnosť už nepomáha, ale prekáža — odstráňte nadbytočné a zväčšite!
Napríklad, pre vyššie uvedený súhrnný obraz...
Zbavte sa najproblematičkejších mikroservisov:
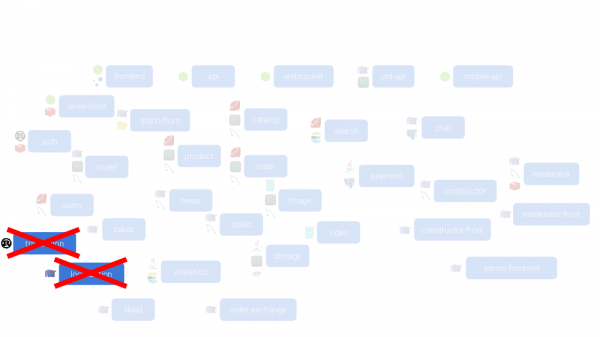
Spojte všetky mikroservisy zodpovedajúce za generovanie frontendu:
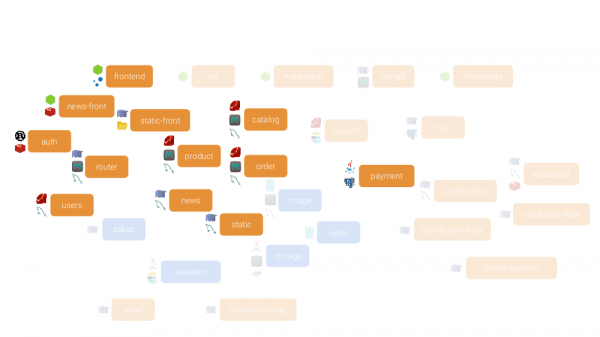
… do jedného mikroslužby, napísaného v jednom (modernom a normálnom, ako si sami myslíte) jazyku/frameworku:
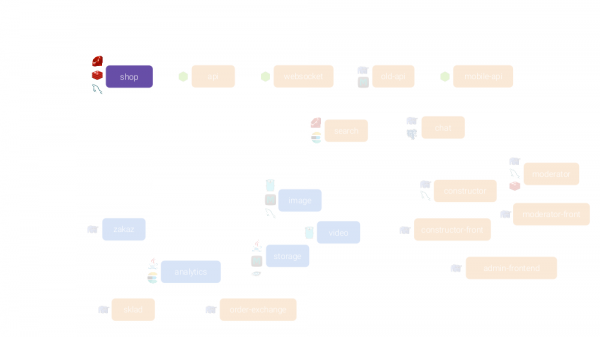
Bude mať jeden ORM (jednu DB) a spočiatku pár aplikácií:
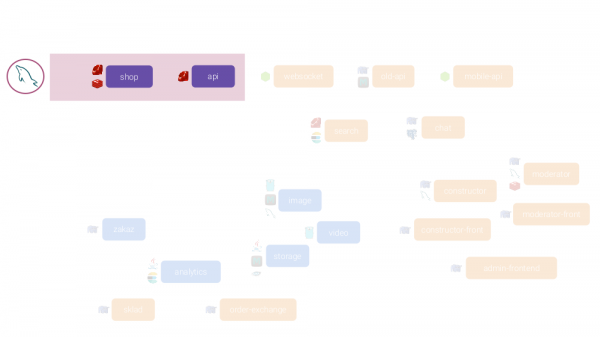
… ale vôbec tam môžete presunúť oveľa viac, pričom získate takýto výsledok:
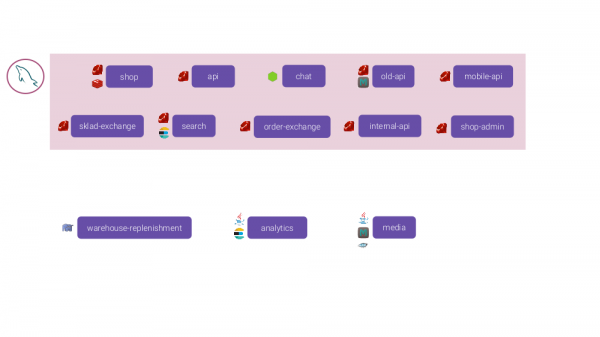
Navyše, v Kubernetes to spúšťame ako samostatné instance, a preto môžeme stále merať zaťaženie a samostatne ich škálovať.
Zhrňujúc
Pozrite sa na situáciu širšie. Veľmi často všetky tieto problémy s mikroslužbami vznikajú z toho, že niekto vzal svoju úlohu, ale chcel "hrať sa s mikroslužbami".
V slove "mikroslužby" je časť „mikro“ nadbytočná.. Sú „mikro“ iba preto, že sú menšie ako obrovský monolit. Ale nemyslite na nich ako na niečo malé.
A pre konečnú myšlienku sa vráťme k pôvodnému grafu:
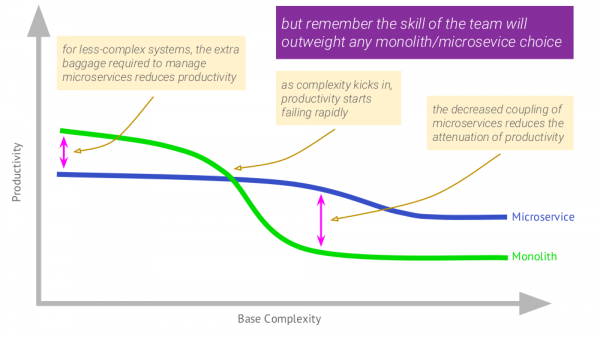
Napísaná k nemu poznámka (vpravo hore) sa zameriava na to, že zručnosti tímu, ktorý robí váš projekt, sú vždy primárne — práve oni zohrávajú kľúčovú úlohu vo vašej voľbe medzi mikroslužbami a monolitom. Ak tím nemá dostatok schopností, ale začne robiť mikroslužby, história bude určite fatálna.
Video a snímky
Video z vystúpenia (~50 minút; bohužiaľ, nie prenáša množstvo emócií návštevníkov, čo vo veľkej miere určovalo náladu prednášky, ale tak je to):
Prezentácia prednášky:
P.S.
Iné prednášky v našom blogu:
- «» (Dmitrij Stoljaro; 28. mája 2018 na RootConf);
- «» (Dmitrij Stoljaro; 7. novembra 2017 na HighLoad++);
- «» (Dmitrij Stoljaro; 6. júna 2017 na RootConf);
- «» (Dmitrij Stoljaro; 8. novembra 2016 na HighLoad++);
- «» (Dmitrij Stoljaro; 31. mája 2016 na RootConf).
Možno vás budú zaujímať aj nasledujúce publikácie:
- «»;
- «»;
- «».
Zdroj: habr.com
