

Naša spoločnosť sa od roku 2008 zaoberá predovšetkým správou infraštruktúr a profesionálnou technickou podporou webových projektov: máme viac ako 400 klientov, čo predstavuje približne 15 % elektronického obchodu v Rusku. Preto je naša technická podpora veľmi rôznorodá. Ak niečo spadne, sme povinní to opraviť do 15 minút. Avšak, aby sme pochopili, že došlo k havárii, je potrebné monitorovať projekt a reagovať na incidenty. Ako to však robiť?
Myslím si, že v organizácii správneho systému monitorovania nastáva problém. Keby problém neexistoval, môj prejav by sa skladal z jedného výroku: „Nainštalujte prosím Prometheus + Grafana a pluginy 1, 2, 3.“ Bohužiaľ, dnes to tak nefunguje. A hlavný problém spočíva v tom, že všetci naďalej veria niečomu, čo existovalo v roku 2008, pokiaľ ide o softvérové komponenty.
Pokiaľ ide o organizovanie systému monitorovania, riskujem, že poviem, že... projekty s rozumným monitorovaním neexistujú. A situácia je taká zlá, že ak niečo spadne, existuje riziko, že to zostane bez povšimnutia — všetci sú presvedčení, že "všetko je monitorované".
Možno, že všetko je monitorované. Ale ako?
Všetci sme sa stretli s príbehom podobným tomuto: pracuje nejaký devops, nejaký administrátor, a k nim prichádza tím vývojárov a hovorí: „Urobili sme release, teraz to zamonitoruj.“ Čo zamonitoruj? Ako to funguje?
Dobre. Monitorujeme starým spôsobom. A ono sa to už mení a zistíš, že si monitoroval službu A, ktorá sa stala službou B, ktorá interaguje so službou C. Ale tím vývojárov ti hovorí: „Nainštaluj softvér, ten by mal všetko zamonitorovať!“
Tak čo sa zmenilo? — Všetko sa zmenilo!
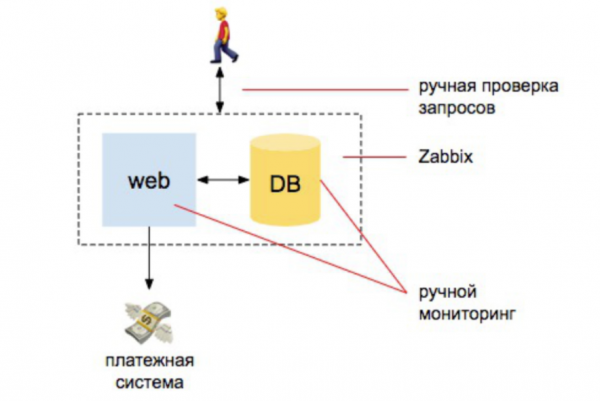
Rok 2008. Všetko je skvelé.
Sú tu dvaja vývojári, jeden server, jeden databázový server. Odtiaľ to všetko začína. Máme nejaké informácie, nainštalujeme Zabbix, Nagios, Cacti. A potom nastavíme jasné alerty na CPU, na prácu diskov, na miesto na diskoch. Ešte robíme pár manuálnych kontrol, že stránka reaguje, že objednávky prichádzajú do databázy. A to je všetko – sme viac-menej chránení.
Ak porovnáme objem práce, ktorú administrátor robil na zabezpečenie monitorovania, bola na 98 % automatizovaná: človek, ktorý sa zaoberá monitorovaním, musí pochopiť, ako nastaviť Zabbix, ako ho nakonfigurovať a nastaviť upozornenia. A 2 % sú na externé kontroly: či stránka odpovedá a robí dotazy do databázy, že nové objednávky prišli.
Rok 2010. Rastie zaťaženie.
Začína sa škálovanie webov, pridávame vyhľadávací engine. Chceme si byť istí, že katalóg produktov obsahuje všetky produkty. A že vyhľadávanie produktov funguje. Či databáza funguje, či sa objednávky robia, či stránka odpovedá zvonku a odpovedá z dvoch. serverov a používateľa nevykopne zo stránky, kým sa neprebalancuje na iný server atď. Entít pribúda.
A entita spojená s infraštruktúrou stále zostáva najväčšia v hlave manažéra. Stále v hlave zostáva myšlienka, že človek, ktorý sa zaoberá monitorovaním, je ten, ktorý nainštaluje Zabbix a dokáže ho konfigurovať.
Ale objavujú sa aj úlohy na vykonanie externých kontrol, na vytvorenie súboru skriptov pre požiadavky vyhľadávacieho indexátora, súboru skriptov na kontrolu toho, že vyhľadávanie sa mení v procese indexovania, súboru skriptov, ktoré kontrolujú, že sa predmety odovzdávajú službe doručenia atď.
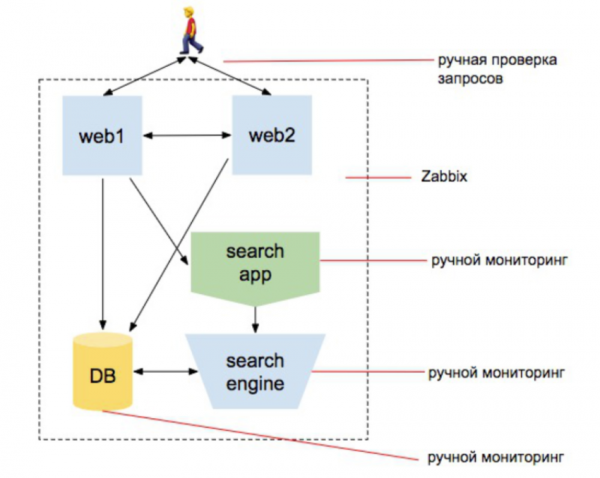
Všimnite si: trikrát som napísal "súbor skriptov". To znamená, že zodpovedným za monitorovanie už nie je ten, kto len inštaluje Zabbix. Je to človek, ktorý začína kódovať. Ale v hlavách tímu zatiaľ nič nemení.
Ale svet sa mení a stáva sa stále zložitejším. Pribudol vrstva virtualizácie, niekoľko nových systémov. Začínajú spolu komunikovať. Kto povedal "cítim mikroservisy?" Ale každý servis stále vyzerá ako samostatná stránka. Môžeme sa na to odvolať a pochopiť, že poskytuje potrebné informácie a funguje sám o sebe. A ak si administrátor, ktorý sa neustále zaoberá projektom, ktorý sa vyvíja 5-7-10 rokov, tieto poznatky sa hromadia: objavuje sa nová úroveň — uvedomíš si to, objaví sa ďalšia úroveň — uvedomíš si to...
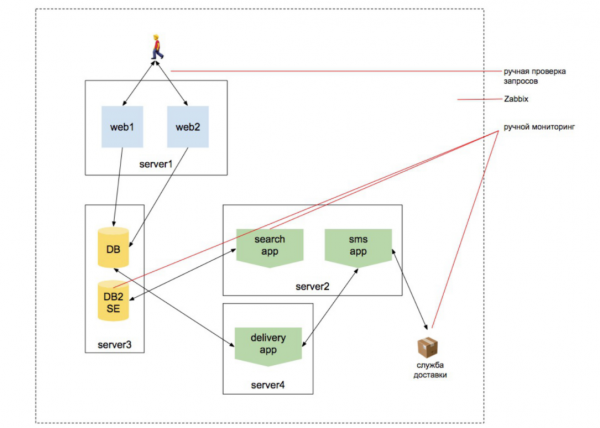
Ale zriedka sa niekto snaží udržiavať projekt 10 rokov.
Zhrnutie monitorovania
Predpokladajme, že ste prišli do nového startupu, ktorý rýchlo nabral 20 vývojárov, napísal 15 mikroslužieb a vy ste administrátor, ktorému hovoria: „Postav CI/CD. Prosím.“ Vy ste vybudovali CI/CD a zrazu počujete: „Ťažko sa nám pracuje s produkciou v 'kube', keď nevieme, ako v ňom bude fungovať aplikácia. Urob nám pieskovisko v tomto 'kube'.
Vy vytvárate pieskovisko v tomto kube. Ihneď vám povedia: „Chceme staging databázu, ktorá sa každý deň aktualizuje z produkcie, aby sme chápali, že to funguje na databáze, ale pritom nepoškodilo produkčnú databázu.“
Žijete vo všetkom tomto. Zostávajú 2 týždne do vydania, hovoria vám: „Teraz by to všetko bolo dobré monitorovať…“ T.j. monitorovať klastrovú infraštruktúru, monitorovať mikroslužbovú architektúru, monitorovať prácu s vonkajšími službami…
A kolegovia vytiahnu z hlavy obvyklú schému a hovoria: „Veď tu je všetko jasné! Nainštaluj program, ktorý to všetko monitoruje.“ Áno-ád: Prometheus + Grafana + pluginy.
A pridávajú: „Máš dva týždne, urob to tak, aby to bolo spoľahlivé.“
V množstve projektov, ktoré vidíme, je na monitorovanie vyčlenený jeden človek. Predstavte si, že chceme na 2 týždne zamestnať osobu, ktorá sa bude zaoberať monitorovaním, a zostavujeme jej životopis. Aké zručnosti by mala táto osoba mať — ak zohľadníme všetko, čo sme predtým povedali?
- Musí rozumieť monitorovaniu a špecifike fungovania hardvérovej infraštruktúry.
- Musí rozumieť špecifikám monitorovania Kubernetes (všetci chcú do 'kube', pretože sa dá abstrahovať od všetkého, schovať sa, veď s ostatným si poradí administrátor) — samotného o sebe, jeho infraštruktúry a chápať, ako monitorovať aplikácie vnútri.
- Musí chápať, že služby medzi sebou komunikujú špeciálnymi spôsobmi a poznať špecifiká interakcie služieb medzi sebou. Celkom reálne je vidieť projekt, kde časť služieb komunikuje synchronne, pretože inak to nejde. Napríklad, backend ide cez REST, cez gRPC k službe katalógu, získa zoznam produktov a vráti späť. Tu sa nedá čakať. A s inými službami pracuje asynchrónne. Preniesť objednávku do služby doručenia, poslať e-mail atď.
Už ste sa asi od všetkého tohto zamotali? A administrátor, ktorému je to potrebné monitorovať, sa zamotal ešte viac. - Musí byť schopný plánovať a plánovať správne — pretože práce pribúda stále viac a viac.
- Musí teda vytvoriť stratégiu z vytvoreného servisu, aby pochopil, ako to konkrétne monitorovať. Potrebuje rozumieť architektúre projektu a jeho rozvoju + porozumeniu technológií používaných pri vývoji.
Spomeňme si na úplne bežný prípad: časť servisov na PHP, časť servisov na Go, časť servisov na JS. Nejakým spôsobom medzi sebou spolupracujú. Odtiaľ pochádza pojem „mikroslužba“: oddelených systémov sa stalo toľko, že vývojári nedokážu pochopiť projekt ako celok. Jedna časť tímu píše služby na JS, ktoré fungujú samostatne a nevedia, ako funguje zvyšok systému. Druhá časť píše služby na Pythone a nezaujíma sa o to, ako fungujú iné služby, sú izolované vo svojej oblasti. Tretia — píše služby na PHP alebo niečom inom.
Všetkých týchto 20 ľudí je rozdelených do 15 služieb a je len jeden administrátor, ktorý to všetko musí pochopiť. Stop! práve sme rozdelili systém na 15 mikroslužieb, pretože 20 ľudí nemôže pochopiť celú systém.
Ale je potrebné to nejakým spôsobom monitorovať…
A čo nakoniec? Nakoniec je tu jeden človek, do ktorého sa dostáva všetko, čo celá tím vývojárov nemôže pochopiť, a pritom by mal tiež vedieť a ovládať to, čo sme uviedli vyššie — hardvérovú infraštruktúru, infraštruktúru Kubernetes atď.
Čo tu povedať… Houston, máme problém.
Monitorovanie moderného softvérového projektu je samo o sebe softvérový projekt.
Z falošnej istoty, že monitorovanie je len softvér, sa u nás objavuje viera v zázraky. A zázraky sa, žiaľ, nekonajú. Není možné nasadiť Zabbix a čakať, že všetko začne fungovať. Nie je zmysel nasadiť Grafanu a dúfať, že všetko bude v poriadku. Väčšina času bude strávená organizovaním kontrol práce služieb a ich vzájomnej interakcie, kontrolovaním, ako fungujú externé systémy. Fakticky 90% času pôjde nie na písanie skriptov, ale na vývoj softvéru. A tím, ktorý rozumie práci projektu, by sa mal touto činnosťou zaoberať.
Ak v tejto situácii hodíme jedného človeka na monitorovanie, stane sa tragédia. A to sa deje všade.
Napríklad existuje niekoľko služieb, ktoré medzi sebou komunikujú cez Kafka. Prišiel objednávka, poslali sme správu o objednávke do Kafky. Existuje služba, ktorá počúva informácie o objednávke a realizuje dodávku tovaru. Existuje služba, ktorá počúva informácie o objednávke a posiela email používateľovi. A potom sa objaví ešte množstvo služieb a začneme sa v tom zamotávať.
A ak to ešte odovzdáte adminovi a vývojárom v etape, keď do vydania zostáva krátky čas, človek bude musieť pochopiť celý tento protokol. T.j. projekt takejto veľkosti zaberá značný čas a pri vývoji systému by to malo byť zohľadnené.
Ale veľmi často, najmä v startupoch, vidíme, ako sa monitorovanie odkladá na neskôr. "Teraz spravíme Proof of Concept, s ním sa spustíme, nech sa to rozpadne – sme ochotní obetovať. A potom to všetko monitorujeme." Keď (alebo ak) projekt začne prinášať peniaze, biznis chce pridať ešte viac funkcií — pretože to začalo fungovať, znamená to, že treba pridávať ďalej! A vy ste na mieste, kde je najprv potrebné monitorovať všetko predchádzajúce, čo nezaberá 1% času, ale oveľa viac. A mimochodom na monitorovanie budú potrební vývojári, a tých je jednoduchšie pustiť na nové funkcie. Nakoniec sa píšu nové funkcie, všetko sa zvyšuje a vy ste v nekonečnom deadlocku.
Ako teda monitorovať projekt od začiatku a čo robiť, ak dostanete projekt, ktorý treba monitorovať, a neviete, odkiaľ začať?
Po prvé, treba plánovať.
Lyrická poznámka: veľmi často začínajú s monitorovaním infraštruktúry. Napríklad máme Kubernetes. Začneme s tým, že nainštalujeme Prometheus s Grafanou, nainštalujeme pluginy na monitorovanie "kocky". Nie len u vývojárov, ale aj u adminov existuje smutná prax: "Nainštalujeme tento plugin, a plugin asi vie, ako to urobiť." Ľudia radi začínajú s jednoduchými a zrozumiteľnými, nie s dôležitými činnosťami. A monitorovanie infraštruktúry je jednoduché.
Na začiatok sa rozhodnite, čo a ako chcete monitorovať, a potom vyberte nástroj, pretože iní ľudia za vás nemôžu myslieť. A mali by? Iní ľudia mysleli na seba, na univerzálny systém — alebo vôbec nemysleli, keď tento plugin písali. A to, že tento plugin má 5000 používateľov, neznamená, že má nejakú hodnotu. Možno sa stanete 5001. len preto, že predtým tam už bolo 5000 ľudí.
Ak ste začali monitorovať infraštruktúru a backend vašej aplikácie prestal odpovedať, všetci používatelia stratia spojenie s mobilnou aplikáciou. Vyskytne sa chyba. Prídu k vám a povedia: „Aplikácia nefunguje, čo tu robíte?“ — „Monitorujeme.“ — „Ako monitorujete, ak nevidíte, že aplikácia nefunguje?!“
- Myslím si, že sledovať treba začať presne od vstupného bodu používateľa. Ak používateľ nevidí, že aplikácia funguje — všetko, to je zlyhanie. A systém monitorovania by mal na to varovať predovšetkým.
- A len potom môžeme monitorovať infraštruktúru. Alebo to urobiť paralelne. S infraštruktúrou je to jednoduchšie — konečne môžeme jednoducho nainštalovať Zabbix.
- A teraz je potrebné ísť do koreňov aplikácie, aby sme pochopili, kde niečo nefunguje.
Hlavná myšlienka je, že monitorovanie by malo prebiehať súčasne s procesom vývoja. Ak odtrhnete tím na monitorovanie na iné úlohy (tvorba CI/CD, pieskovisko, reorganizácia infraštruktúry), monitorovanie začne zaostávať a možno ho už nikdy nedobehnete (alebo nakoniec budete musieť zastaviť vývoj).
Všetko na úrovniach
Takto vidím organizáciu systému monitorovania.
1) Úroveň aplikácie:
- monitorovať biznis logiku aplikácie;
- monitorovať health metriky služieb;
- integračné monitorovanie.
2) Úroveň infraštruktúry:
- monitorovať úroveň orchestrace;
- monitorovať systémový softvér;
- monitorovať úroveň „hardvéru“.
3) Opäť úroveň aplikácie — ale už ako inžinierskeho produktu:
- zbierať a sledovať denníky aplikácie;
- APM;
- trasovanie.
4) Upozornenie:
- organizovať systém upozornení;
- organizovať systém pohotovosti;
- organizovať „základňu poznania“ a workflow spracovania incidentov.
Dôležité: Prejdeme k alertingu nie až potom, ale hneď! Nespúšťajte monitoring a potom si nejakým spôsobom nechať vymyslieť, komu budú prichádzať alerty. Veď v čom spočíva úloha monitoringu: pochopiť, kde v systéme niečo nefunguje, a informovať o tom potrebných ľudí. Ak to necháte na koniec, tak potrební ľudia sa dozvedia, že niečo nefunguje, iba keď zaznie telefonát: "u nás nič nefunguje".
Úroveň aplikácie — monitoring biznis logiky
Tu ide o kontrolu samotnej skutočnosti, že aplikácia funguje pre používateľa.
Táto úroveň by mala byť vytvorená už v etape vývoja. Napríklad, máme hypotetického Promethea: ten sa pripojí k serveru, ktorý sa zaoberá kontrolami, zavolá endpoint a endpoint ide a kontroluje API.
Keď často žiadajú monitorovať hlavnú stránku, aby sa ubezpečili, že web funguje, programátori poskytujú endpoint, ktorý môžu zavolať zakaždým, keď si chcú overiť, že API funguje. A programátori pritom ešte napíšu /api/test/helloworld.
Je jediný spôsob, ako sa uistiť, že všetko funguje? — Nie!
- Vytvorenie takýchto kontrol je v podstate úlohou vývojárov. Unit testy by mali písať programátori, ktorí píšu kód. Pretože, ak to zveríte adminovi: "Kamarád, tu máš zoznam protokolov API všetkých 25 funkcií, prosím ťa, monitoruj všetko!" — nič z toho nevzišlo.
- Ak spravíte print "hello world", nikto sa nikdy nedozvie, že API by malo a skutočne funguje. Každá zmena API by mala viesť k zmene kontrol.
- Ak máte už taký problém — zastavte funkcie a vyčleňte vývojárov, ktorí napíšu tieto kontroly, alebo sa zmierte so stratami, zmierte sa s tým, že nič sa nekontroluje a bude padať.
Technické tipy:
- Nezabudnite zorganizovať externý server pre vykonávanie kontrol — musíte si byť istí, že váš projekt je prístupný pre svet vonku.
- Organizujte kontrolu cez celý protokol API, a nie iba cez jednotlivé endpointy.
- Vytvorte prometheus-endpoint s výsledkami kontrol.
Úroveň aplikácie — monitoring health metrik
Teraz hovoríme o externých health metrikách služieb.
Rozhodli sme sa, že všetky "páčky" aplikácie monitorujeme pomocou externých kontrol, ktoré voláme z externého monitorovacieho systému. Ale to sú práve "páčky", ktoré "vidí" používateľ. Chceme si byť istí, že naše služby fungujú. V tomto prípade je to lepšie: v K8s sú health checky, aby sa aspoň "kocka" uistila, že služba funguje. Ale polovica checkov, ktoré som videl, je len ten istý print "hello world". T.j. volá sa jedenkrát po nasadení, dostane odpoveď, že všetko je v poriadku — a hotovo. A ak služba poskytuje svoj API cez REST, existuje obrovské množstvo vstupných bodov tohto API, ktoré tiež potrebujeme monitorovať, pretože chceme vedieť, že funguje. A ten monitorujeme už vo vnútri.
Ako to správne technicky realizovať: každá služba vystavuje endpoint o svojej aktuálnej funkčnosti a v grafoch Grafana (alebo akéhokoľvek iného aplikácie) vidíme stav všetkých služieb.
- Každá zmena API by mala viesť k zmene kontrol.
- Novú službu vytvárajte hneď s health metrikami.
- Admin môže prísť k vývojárom a požiadať "napíšte mi pár funkcií, aby som všetko chápal a do svojej monitorovacej systém pridal informácie o tom". Ale vývojári zvyčajne odpovedajú "Dva týždne pred vydaním nič nepridáme".
Nech manažéri vývoja vedia, že budú takéto straty, nech vedenie manažérov vývoja tiež vie. Pretože, keď všetko padne, niekto sa aj tak ozve a bude požadovať monitorovať "neustále padajúcu službu". - Mimochodom, vyčleňte vývojárov na písanie pluginov pre Grafanu — to bude dobrá pomoc pre adminov.
Úroveň aplikácie — Integračné monitorovanie
Integračné monitorovanie sa zameriava na monitorovanie komunikácie medzi kritickými pre biznis systémami.
Napríklad existuje 15 služieb, ktoré medzi sebou komunikujú. Už to nie sú samostatné weby. T.j. nemôžeme zavolať službu samostatne, získať /helloworld a pochopiť, že služba funguje. Pretože webová služba na spracovanie objednávok musí odoslať informácie o objednávke do zbernice — z zbernice musí služba správy skladu túto správu získať a ďalej s ňou pracovať. A služba na odosielanie e-mailov to musí ďalej spracovať, atď.
Preto nemôžeme pochopiť, keď sa snažíme každému jednotlivému servisu, či všetko funguje. Pretože máme akúsi zbernicu, cez ktorú všetko komunikuje a interaguje.
Tento krok by preto mal predstavovať testovací proces služieb na interakciu s inými službami. Nie je možné monitorovať messaging broker a organizovať monitorovanie komunikácie. Ak existuje služba, ktorá poskytuje dáta, a služba, ktorá ich prijíma, pri monitorovaní brokera uvidíme len dáta, ktoré prechádzajú z jednej strany na druhú. Aj keď sa nám nejakým spôsobom podarí monitorovať interakciu týchto dát, - že nejaký producent posiela dáta, niekto ich číta, tento tok pokračuje do Kafka - aj tak nám to nedá informáciu, ak jedna služba odovzdala správu v jednej verzii, zatiaľ čo druhá služba nečakala túto verziu a vynechala ju. O tom sa nedozvieme, pretože nám služby povedia, že všetko funguje.
Tu je moje odporúčanie:
- Pre synchronnú komunikáciu: endpoint vykonáva požiadavky na súvisiace služby. T.j. vezmeme tento endpoint, spustíme skript vo vnútri služby, ktorý prechádza všetkými bodmi a hovorí: "Môžem tu dotiahnuť, a tam dotiahnuť, môžem tam dotiahnuť..."
- Pre asynchrónnu komunikáciu: prichádzajúce správy - endpoint kontroluje zbernicu na existenciu testovacích správ a vydáva stav spracovania.
- Pre asynchrónnu komunikáciu: odchádzajúce správy - endpoint posiela testovacie správy na zbernicu.
Ako to obvykle prebieha: máme službu, ktorá posiela dáta na zbernicu. Prídeme do tejto služby a požiadať ju, aby nám povedala o jej integračnom zdraví. A ak služba musí poslať nejakú správu ďalej (WebApp), tak túto testovaciu správu pošle. Ak však dotiahujeme službu na strane OrderProcessing, najprv posiela to, čo môže poslať nezávisle, a ak existujú nejaké závislé veci - číta zo zbernice súbor testovacích správ, pochopí, čo môže spracovať, oznámi to a, ak je to potrebné, posiela ich ďalej a hovorí o tom - všetko v poriadku, som živý.
Veľmi často počujeme otázku „ako môžeme testovať na reálnych dátach?“ Napríklad ide o tú istú službu objednávok. Objednávka posiela správy do skladu, kde sú tovaru odpočítané: nemôžeme to testovať na reálnych dátach, pretože „produkty sa mi budú odpočítavať!“ Riešenie: v počiatočnej fáze naplánovať celý tento test. Predsa máte unit testy, ktoré robia mocky. Takže, urobte to na hlbšej úrovni, kde vám prebieha komunikačný kanál, ktorý neohrozí fungovanie podnikania.
Úroveň infraštruktúry
Monitorovanie infraštruktúry – to je už dávno považované za samotné monitorovanie.
- Monitorovanie infraštruktúry je možné a treba spustiť ako samostatný proces.
- Nepočíta sa začínať s monitorovaním infraštruktúry na fungujúcom projekte, aj keď to veľmi láka. To je problém pre všetkých devops. „Najprv monitorujem klaster, monitorujem infraštruktúru“ – t.j. najprv sa monitoruje to, čo je na spodku, a do aplikácie sa nepozerá. Pretože aplikácia je pre devopsa nejasná. Dostali to a nerozumejú, ako to funguje. A infraštruktúru chápe a začína od nej. Ale nie – vždy je potrebné na začiatku monitorovať aplikáciu.
- Nepreháňajte to s počtom upozornení. Vzhľadom na zložitosti moderných systémov, upozornenia prichádzajú neustále a s touto hromadou upozornení treba nejako žiť. A človek on-call, keď sa pozrie na stovku ďalších upozornení, si povie „nechcem nad tým rozmýšľať“. Upozornenia by mali informovať len o kritických veciach.
Úroveň aplikácie ako obchodnej jednotky
Kľúčové body:
- ELK. To je priemyselný štandard. Ak z nejakého dôvodu nezlučujete logy, okamžite s tým začnite.
- APM. Externé APM ako spôsob rýchlo uzavrieť monitorovanie aplikácie (NewRelic, BlackFire, Datadog). Môžete dočasne nasadiť tento nástroj, aby ste mali aspoň niečo o tom, čo sa u vás deje.
- Tracing. V desiatkach mikroslužieb musíte všetko sledovať, pretože požiadavka už nežije sama o sebe. Neskôr je veľmi ťažké pridávať, preto je lepšie hneď naplánovať sledovanie pri vývoji – je to práca a nástroj vývojárov. Ak ste to ešte nezaviedli – zavádzajte! Pozrite sa na Jaeger/Zipkin
Upozorňovanie
- Organizácia systému upozornení: v podmienkach monitorovania množstva vecí by mala existovať jednotná systém zasielania upozornení. Môže to byť v Grafane. Na Západe všetci používajú PagerDuty. Upozornenia by mali byť zrozumiteľné (napríklad, odkiaľ prišli...). A bolo by dobré kontrolovať, či upozornenia vôbec prichádzajú.
- Organizácia systému pohotovostí: upozornenia by nemali prichádzať všetkým (alebo sa všetci zhluknú do reakcie, alebo nikto nebude reagovať). On-call musia byť aj vývojári: určite definujte oblasti zodpovednosti, vypracujte jasný návod a v ňom presne uveďte, komu presne telefonovať v pondelok a stredu, a komu — v utorok a piatok (inak nebudú nikomu telefonovať ani v prípade vážnej nehody — boja sa prebudiť, vyrušiť: ľudia vo všeobecnosti nemajú radi, keď musia budovať iných, najmä v noci). A vysvetlite, že požiadať o pomoc nie je znak nekompetentnosti („žiadam o pomoc — znamená to, že som zlý zamestnanec“), povzbudzujte žiadosti o pomoc.
- Organizácia „základne poznatkov“ a workflow spracovania incidentov: na každý vážny incident by mal byť naplánovaný postmortem, ako dočasné opatrenie by mali byť zdokumentované kroky, ktoré vyriešia incident. A zaveďte prax, že opakujúce sa upozornenia sú hriech; mali by sa opravovať v kóde alebo infraštruktúrnych prácach.
Technologický stack
Predstavme si, že náš stack je nasledovný:
- zbieranie údajov — Prometheus + Grafana;
- analýza logov — ELK;
- pre APM alebo Tracing — Jaeger (Zipkin).

Výber možností nie je kritický. Pretože ak ste na začiatku pochopili, ako monitorovať systém a naplánovali ste plán, potom už začnete vyberať nástroje podľa svojich požiadaviek. Otázka je v tom, čo ste sa rozhodli monitorovať najprv. Pretože nástroj, ktorý ste si vybrali na začiatku — vôbec nemusí vyhovovať vašim požiadavkám.
Niekoľko technických aspektov, ktoré vidím všade v poslednom čase:
Prometheus sú nasadzovaný dovnútra Kubernetes — kto to vymyslel?! Ak vám padne klastra, čo budete robiť? Ak máte zložitý klaster vo vnútri, mala by fungovať nejaká monitorovacia systém vo vnútri klastra, a nejaká — z vonku, ktorá bude zbierať dáta z vnútra klastra.
Vo vnútri klastra zbierame logy a všetko ostatné. Ale monitorovací systém by mal byť umiestnený zvonku. Veľmi často v clustri, kde je Prometheus nainštalovaný dovnútra, sú zároveň aj systémy, ktoré vykonávajú externé kontroly fungovania webovej stránky. A čo ak vám padli spojenia do vonkajšieho sveta a aplikácia nefunguje? Vnútri máte všetko v poriadku, ale používateľom to nijako nepomáha.
Zhrnutie
- Vývoj monitorovania nie je inštalácia utilít, ale vývoj softvérového produktu. 98% dnešného monitorovania je kódovanie. Kódovanie v službách, kódovanie externých kontrol, kontroly externých služieb, a všetkého možného.
- Nešetrte čas programátorov na monitorovanie: môže to zabrať až 30% ich práce, ale stojí to za to.
- DevOps, nebojte sa, že sa vám nedarí niečo monitorovať, pretože niektoré veci vyžadujú úplne iný spôsob myslenia. Neboli ste programátorom a práca monitorovania je práve ich úlohou.
- Ak projekt už funguje a nie je monitorovaný (a ste manažér) — vyčleňte prostriedky na monitorovanie.
- Ak je produkt už v prevádzke a ste devops, ktorému povedali „nastaviť monitorovanie“ — pokúste sa vysvetliť vedeniu to, o čom som to všetko napísal.
Toto je rozšírená verzia prezentácie na konferencii Saint Highload++.
Ak vás zaujímajú moje myšlienky a úvahy na tému IT a okolo nej, môžete si pozrieť 🙂
Zdroj: habr.com
